

Apache Parquet
Apache Parquet – open-source колоночно-ориентированный формат хранения данных, который может работать с различными схемами кодирования и сжатия, что позволяет оптимизировать его для эффективной работы с Big Data.
Apache Parquet - колоночно-ориентированный формат хранения данных с открытым исходным кодом, разработанный компанией Cloudera, который предназначен для быстрой обработки сложных данных. Изначально он был создан для обмена данными в экосистеме Apache Hadoop, но затем стал частью и других проектов с открытым исходным кодом, таких как Delta Lake, Apache Iceberg и InfluxDB, а также системами Big Data, такими как Hive, Drill, Impala, Presto, Spark, Kudu, Redshift, BigQuery, Snowflake, Clickhouse и т.д. Многие из этих проектов работают с файлами Parquet.
Parquet поддерживает различные схемы кодирования и сжатия на основе каждого столбца, что позволяет эффективно хранить и извлекать данные в большом количестве. Также поддерживаются словари и кодирование по длине строки (RLE) и широкий спектр типов данных, таких как числовые, текстовые и структурированные данные, например JSON. Parquet позволяет включать метаданные (такие как схема, минимальные/максимальные значения и фильтры Блума) на основе каждого столбца. Это помогает планировщику и исполнителю запросов оптимизировать то, что нужно прочитать и декодировать из файла Paquet.
Кроме того, он построен на вложенных структурах данных с использованием алгоритма сборки, впервые описанного в рамках Dremel от Google.
Apache Parquet является частью проекта Apache Arrow, поэтому он поддерживает большое количество языков, включая Java, C++, Python, R, Ruby, JavaScript, Rust и Go.
Основные преимущества Parquet
- Высокая производительность — количество операций I/O и вычислений минимизировано, поскольку при выполнении запросов сканируется подмножество столбцов используя необходимые данные.
- Компрессия — организация хранения однородных данных в столбцах обеспечивает лучшее сжатие. Словари и кодирование длины строки обеспечивают эффективное хранение повторяющихся значений.
- Open Source — надежная экосистема с открытым исходным кодом, которая постоянно совершенствуется благодаря активному сообществу.
Как Parquet хранит данные
Давайте на конкретном примере посмотрим, как Parquet хранит данные в столбцах. Ниже представлен простой набор данных, касательно 3 датчиков, с информацией об их идентификаторах, типе и местоположении. Хранение данных в формате, основанном на строках, например csv или Arvo, будет выглядеть следующим образом:
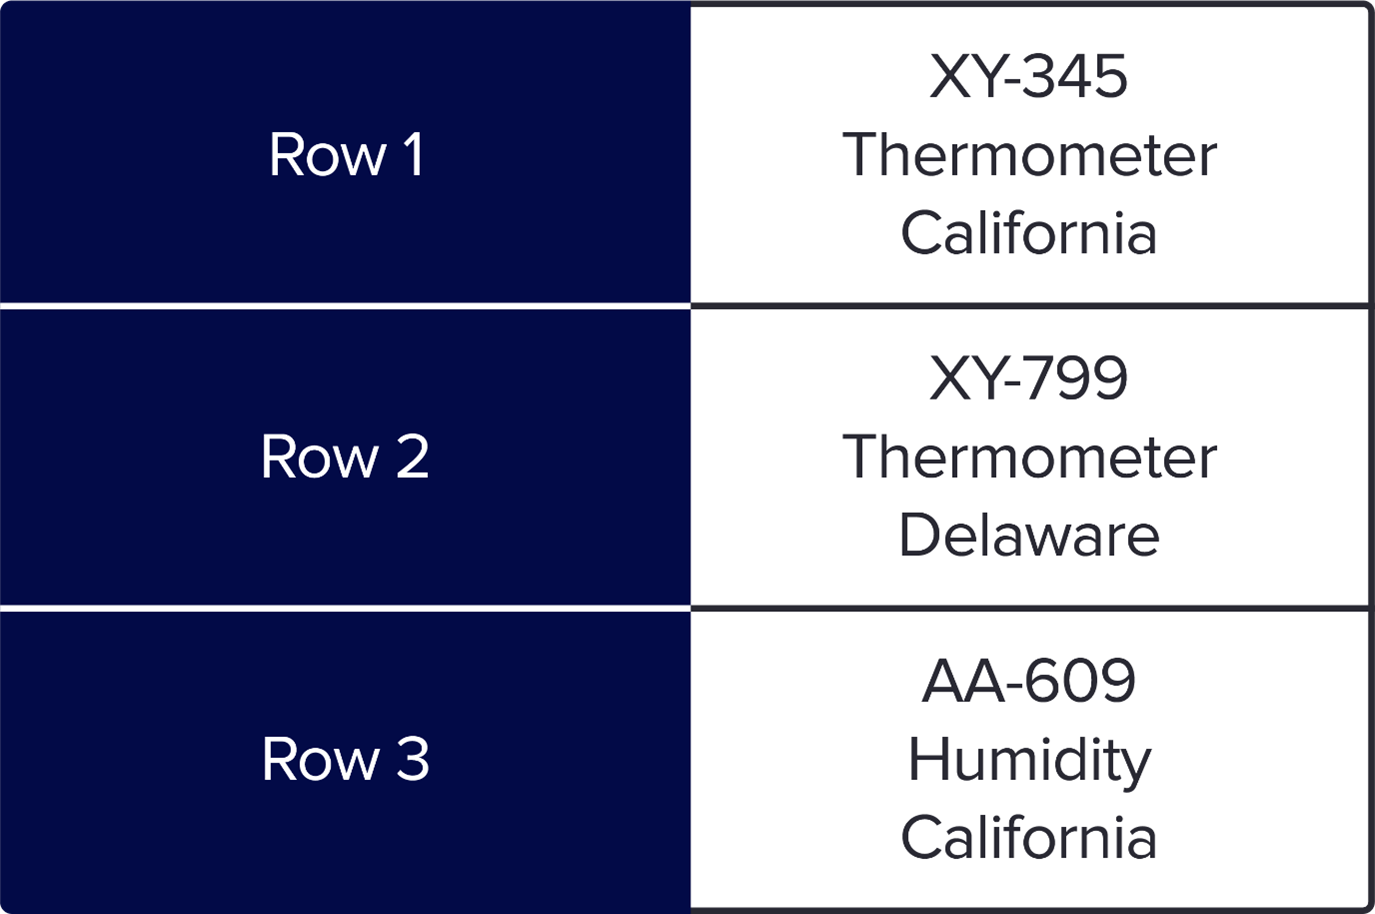
При хранении данных колоночно-ориентированного формата, которым является рассматриваемый нами Parquet, данные организованы следующим образом:
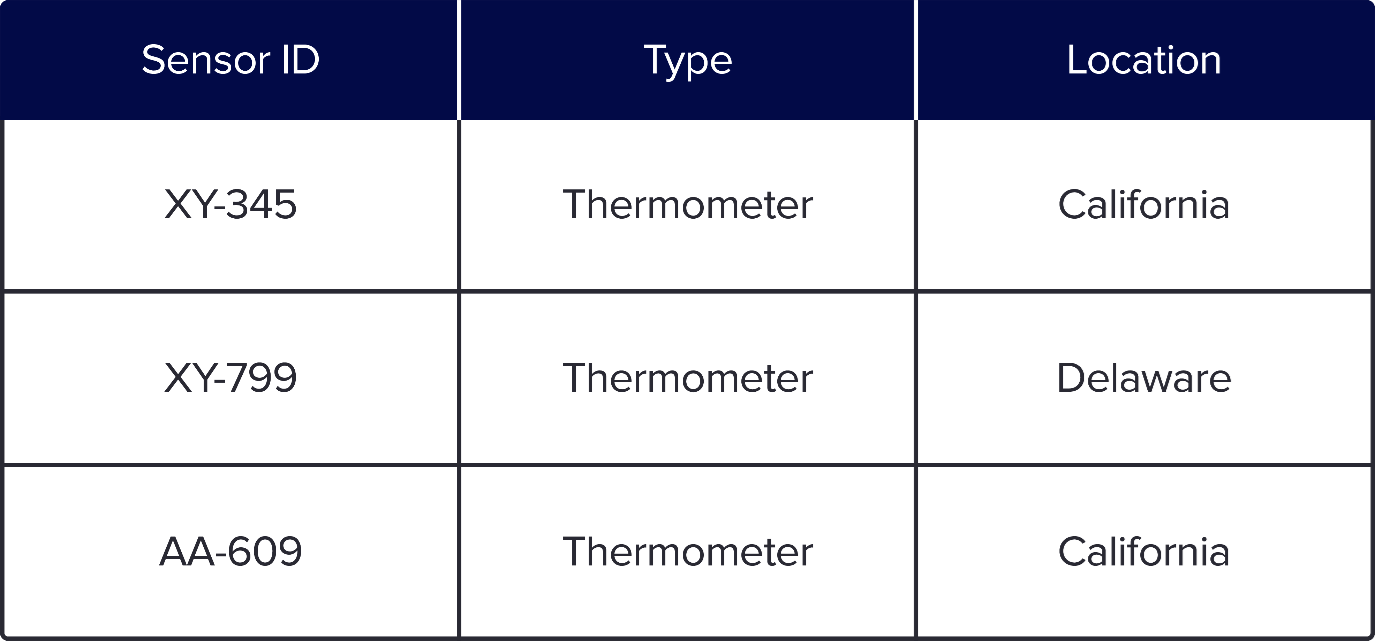
Колоночно-ориентированный формат хранения данных более удобен для восприятия, поскольку это типичный способ организации данных в электронных таблицах. Кроме того, хранение данных более экономично, поскольку хранилища на основе строк, такие как CSV, не сжимают данные так эффективно, как Parquet.
InfluxDB и формат Parquet
Вот пример, с помощью которого мы постараемся продемонстрировать то, как InfluxDB хранит данные временных рядов в формате файлов Parquet.
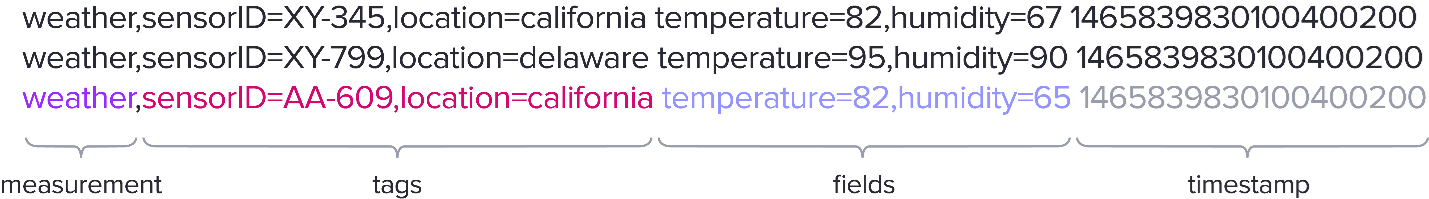
Измерение отображается на один или несколько файлов Parquet, а теги, поля и временные метки - на отдельные столбцы, использующие различные схемы кодирования для достижения наилучшего сжатия файлов.
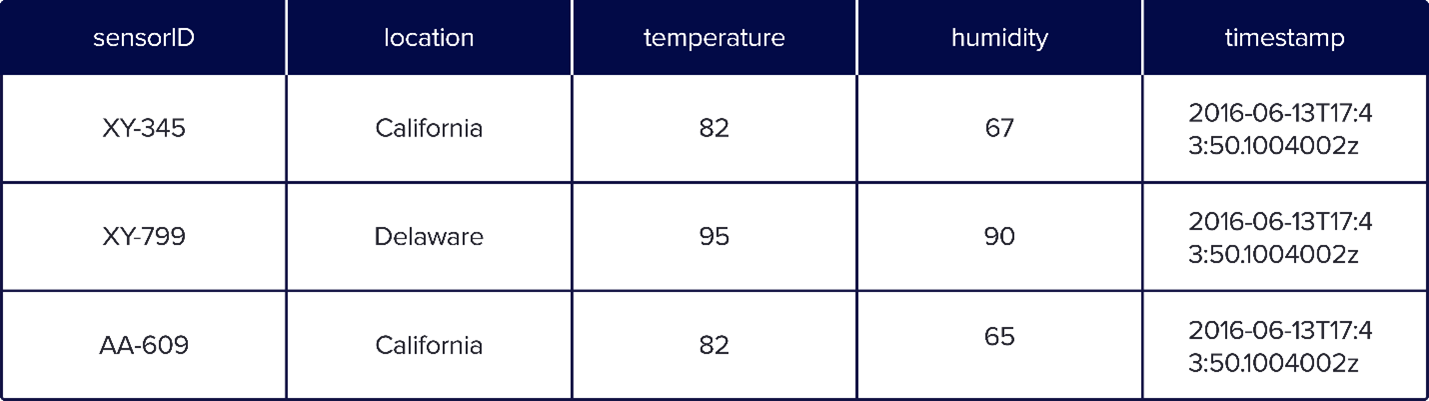
Кроме того, данные организованы в непересекающиеся временные диапазоны. Ниже представлены 3 примера файлов Parquet для одного и того же измерения, но в трех разных временных группах.
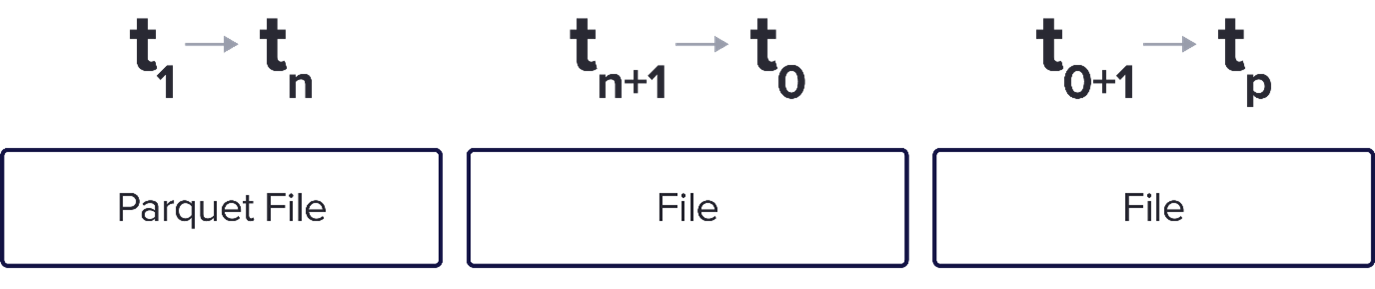
Такой запрос выполняется быстрее, поскольку позволяет пользователю собрать данные за фиксированный промежуток времени. Кроме того, хранение данных временных рядов таким образом позволяет при необходимости легко удалять данные и экономить драгоценное место.
Parquet и функциональная совместимость
Открытый исходный код Parquet и его широкое распространение в других технологиях и экосистемах означает, что пользователи Apache Parquet могут использовать данные временных рядов, хранящиеся в файлах Parquet, в других приложениях. Это позволяет пользователям расширить возможности работы с данными временных рядов и применять их в тех областях и приложениях, которые ранее были недоступны.


