

Apache Kafka: Введение
В эру Big Data компании оперируют огромными объемами данных, что сопряжено с рядом трудностей. Первая из них заключается в том, как собрать большой объем данных, вторая - в том, как его проанализировать. Для решения этих задач необходима система обмена сообщениями, продуманная до мелочей.
Kafka предназначена для распределенных систем с высокой пропускной способностью. Платформа отлично подходит для замены традиционных брокеров сообщений. По сравнению с другими системами обмена сообщениями, Kafka имеет лучшую пропускную способность, встроенные разделение, репликацию и более эффективную отказоустойчивость, что делает ее незаменимым решением для создания крупномасштабных приложений обработки сообщений.
Что такое система обмена данными?
Система обмена сообщениями отвечает за передачу данных от одного приложения к другому, чтобы они могли сосредоточиться на данных и «не думать» о том, как именно их передавать. Распределенный обмен сообщениями основан на концепции надежной очереди сообщений. Сообщения ставятся в очередь асинхронно между клиентскими приложениями и системой обмена сообще
ниями. Существует два типа схем обмена сообщениями - точка-точка и публикация-подписка (pub-sub). Большинство моделей обмена сообщениями используют pub-sub.
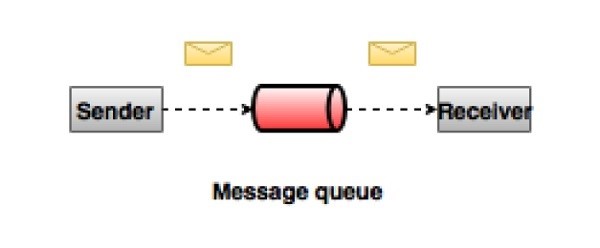
Система обмена сообщениями «точка-точка»
В системе "точка-точка" сообщения хранятся в очереди. Один или несколько консьюмеров могут потреблять сообщения в очереди, но конкретное сообщение может быть потреблено только одним консьюмером. Как только консьюмер прочитал сообщение в очереди, оно исчезает из нее. Типичным примером такой системы является система обработки заказов, где каждый заказ обрабатывается только одним процессором, при этом одновременно могут работать несколько процессоров.
Система обмена сообщениями «публикация-подписка»
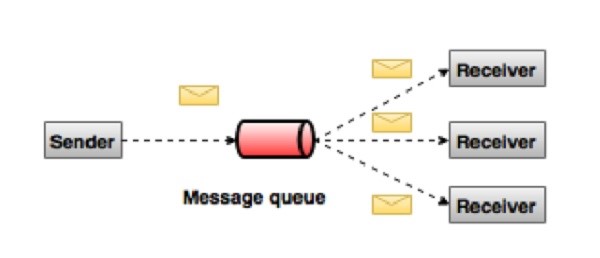
В этой системе сообщения хранятся в топике. В отличие от системы "точка-точка", консьюмеры могут подписаться на один или несколько топиков и потреблять все сообщения, содержащиеся в них. В системе «публикация – подписка» продюсеры сообщений называются издателями, а консьюмеры - подписчиками. В качестве примера можно привести Dish TV, который имеет различные каналы, такие как спортивные, кино, музыкальные и т. д., и каждый может подписаться на свой собственный набор каналов и смотреть интересующие их передачи, транслируемые в эфире.
Что такое Kafka?
Apache Kafka - это распределенная система обмена сообщениями по принципу "публикация-подписка", способная обрабатывать большие объемы данных и позволяющая передавать сообщения от одной конечной точки к другой. Kafka подходит как для автономного, так и для онлайн-потребления сообщений. Сообщения Kafka сохраняются на диске и реплицируются внутри кластера в целях предотвращения потери данных. Платформа построена на базе службы синхронизации ZooKeeper. Она отлично интегрируется с Apache Storm и Spark для анализа потоковых данных в режиме реального времени.
Преимущества
Основные преимущества платформы Kafka:
- Надежность − Kafka является распределенной, разделенной, реплицируемой и отказоустойчивой платформой;
- Масштабируемость − Система обмена сообщениями Kafka легко масштабируется без каких-либо простоев.
- Долговечность − Kafka использует распределенный журнал фиксации, что означает, что сообщения сохраняются на диске так быстро, как это возможно, поэтому они долговечны.
- Производительность − Kafka обладает высокой пропускной способностью как при публикации, так и при подписке на сообщения. Она обспечивает стабильную и достаточно высокую производительность даже при хранении большого количества сообщений, измеряемых в ТБ.
Kafka работает очень быстро и гарантирует отсутствие каких-либо простоев и потери данных.
В каких случаях пригодится Kafka?
Наиболее распространенные области применения Kafka:
- Метрики − Очень часто Kafka используется для оперативного мониторинга данных, что подразумевает агрегирование статистики из распределенных приложений для получения централизованных потоков оперативных данных;
- Решение по агрегации журналов − Kafka можно использовать с целью сбора журналов с различных сервисов и предоставления их в стандартном формате сразу нескольким консьюмерам
- Потоковая обработка данных − Такие популярные фреймворки, как Storm и Spark Streaming, считывают данные из одного топика, обрабатывают их и записывают обработанные данные в новый топик, где они становятся доступными для консьюмеров и приложений. Надежность и долговечность Kafka чрезвычайно полезна в контексте потоковой обработки данных.
Незаменимость Kafka
Kafka - это унифицированная платформа для работы со всеми данными, поступающими в режиме реального времени. Она поддерживает доставку сообщений с низкой задержкой и обеспечивает отказоустойчивость при сбоях в работе оборудования. Платформа способна работать с большим количеством разнообразных косьюмеров. Kafka работает очень быстро, она способно обрабатывать около 2 миллионов записей в секунду. Все данные сохраняются на диск, что в разы повышает эффективность передачи данных из страничного кэша в сетевой сокет.


