

Введение в Apache Kafka
Обзор
В этом руководстве мы поговорим о базовых понятиях Kafka – случаях использования и ключевых концептов, которые должны быть известны каждому пользователю, желающему прокачать свои навыки в области управления данными.
Kafka – это что?
Kafka - это платформа обработки потоков данных с открытым исходным кодом, разработанная Apache Software Foundation. Она может быть использована как система обмена сообщениями, но по сравнению с «классическими» системами, такими как ActiveMQ, она предназначена для обработки потоков данных в режиме реального времени и является распределенной, отказоустойчивой и высокомасштабируемой системой обработки и хранения данных.
В каких случаях целесообразно использовать данную технологию:
- Обработка и анализ данных в режиме реального времени;
- Агрегация событий
- Мониторинг и сбор метаданных
- Анализ данных Clickstream
- Выявление фактов мошенничества
- Обработка Big Data в стриминговом режиме
Настройка локальной среды
Если Вы сталкиваетесь с Kafka впервые, вполне возможно, что для того, чтобы познакомиться со всеми возможностями данного решения поближе, Вам захочется настроить локальную среду. В таком случае лучше всего сделать это c помощью Docker.
Установка Kafka
Скачиваем архив и запускаем образ контейнера с помощью следующей команды:
docker run -p 9092:9092 -d bashj79/kafka-kraftCopy
Данная команда запустит брокер Kafka, использующий порт 9092. Далее необходимо подключиться к брокеру с помощью клиента (клиентов может быть несколько).
Использование приложение Kafka CLI
Kafka CLI – часть процесса установки Kafka, которую можно заполучить из контейнера.
Узнаем имя контейнера, используя следующую команду:
docker ps

CONTAINER ID   IMAGE                    COMMAND                  CREATED        STATUS       PORTS                    NAMES
7653830053fa   bashj79/kafka-kraft      "/bin/start_kafka.sh"    8 weeks ago    Up 2 hours   0.0.0.0:9092->9092/tcp   awesome_aryabhataCopy
В данном случае контейнера - awesome_aryabhata. Далее подключаемся к bash:
docker exec -it awesome_aryabhata /bin/bashCopy
Теперь мы можем создать топик (чуть позже мы расскажем об этом понятии подробнее) и перечислить все существующие топики:
cd /opt/kafka/bin

# create topic 'my-first-topic'
sh kafka-topics.sh --bootstrap-server localhost:9092 --create --topic my-first-topic --partitions 1 --replication-factor 1

# list topics
sh kafka-topics.sh --bootstrap-server localhost:9092 --list

# send messages to the topic
sh kafka-console-producer.sh --bootstrap-server localhost:9092 --topic my-first-topic
>Hello World
>The weather is fine
>I love KafkaCopy
Использование Offset Explorer
Offset Explorer (ранее Kafka Tool) – это приложение для управления Kafka. Загружаем его. Затем создаем соединение и уточняем host и порт брокера Kafka:
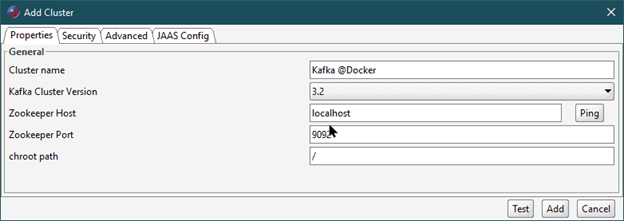
Изучаем структуру:
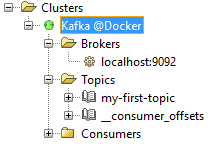
Использование Kafka UI
UI для Apache Kafka (Kafka UI) – веб-сервис, реализованный совместно с Spring Boot и React. Поставляется в виде контейнера Docker. Устанавливаем с помощью следующей команды:
docker run -it -p 8080:8080 -e DYNAMIC_CONFIG_ENABLED=true provectuslabs/kafka-uiCopy
Открываем UI в браузере с помощью http://localhost:8080, уточняем контейнер:

Поскольку брокер Kafka работает в не в бэкенде Kafka UI, у него не будет доступа к localhost:9092. Вместо этого можно обратиться к хост-системе, используя host.docker.internal:9092.
К сожалению, Kafka снова перенаправит нас на localhost:9092. Если мы не хотим настраивать Kafka (потому что это нарушит работу других клиентов), нам придется создать переадресацию порта с порта 9092 контейнера Kafka UI на порт 9092 хост-системы:
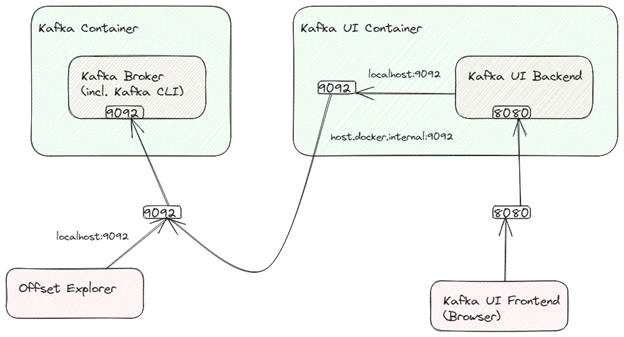
Мы можем настроить port-forwarding, например, с помощью socat. Установим его внутри контейнера (Alpine Linux), подключаемся к bash контейнера с правами root:
# Connect to the container's bash (find out the name with 'docker ps')
docker exec -it --user=root <name-of-kafka-ui-container> /bin/sh

# Now, we are connected to the container's bash.
# Let's install 'socat'
apk add socat

# Use socat to create the port forwarding
socat tcp-listen:9092,fork tcp:host.docker.internal:9092

# This will lead to a running process that we don't kill as long as the container's runningCopy
К сожалению, запускать socat придется каждый раз при запуске контейнера.
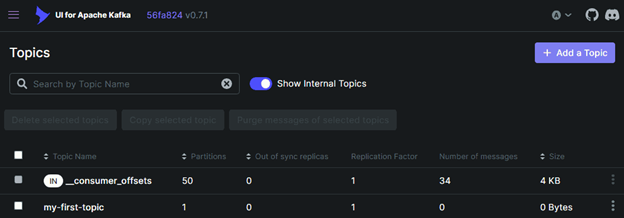
В качестве загрузочного сервера в UI Kafka указываем localhost:9092. Теперь мы можем просматривать и создавать топики, как показано ниже:
Использование клиента Kafka Java
Теперь необходимо добавить в наш проект следующую зависимость Maven :
<dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-clients</artifactId>
    <version>3.5.1</version>
</dependency>Copy
Затем мы можем подключиться к Kafka и использовать сообщения, которые мы создали ранее:
// specify connection properties
Properties props = new Properties();
props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
props.put(ConsumerConfig.GROUP_ID_CONFIG, "MyFirstConsumer");
props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
// receive messages that were sent before the consumer started
props.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
// create the consumer using props.
try (final Consumer<Long, String> consumer = new KafkaConsumer<>(props)) {
    // subscribe to the topic.
    final String topic = "my-first-topic";
    consumer.subscribe(Arrays.asList(topic));
    // poll messages from the topic and print them to the console
    consumer
      .poll(Duration.ofMinutes(1))
      .forEach(System.out::println);
}
Безусловно, существует интеграция Kafka с Spring.
Базовые понятия Kafka
Продюсеры & консюмеры
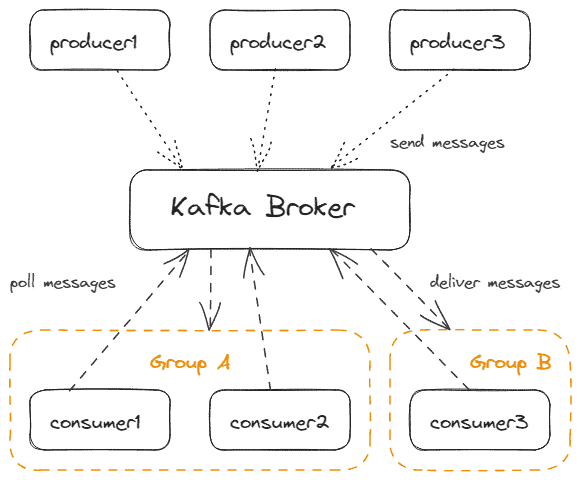
Клиентов Kafka традиционно подразделяют на продюсеров и консюмеров. Продюсеры отправляют сообщения в Kafka, а консюмеры получают их из Kafka. Они получают сообщения только путем активного опроса Kafka. Сам Kafka действует пассивно.
Одновременно может существовать несколько продюсеров и несколько консюмеров. И, конечно, одно приложение может содержать как продюсеров, так и консюмеров.
Консюмеры являются частью группы конюмеров, которую Kafka идентифицирует по имени. Только один консюмер из группы консюмеров может получать сообщения из Kafka.
На рисунке ниже отображен процесс взаимодействия нескольких продюсеров и нескольких консюмеров с Kafka:
Сообщения
Сообщение (запись/событие) - это основополагающая единица данных, которую обрабатывает Kafka. Оно может иметь любой двоичный формат, а также текстовые форматы, такие как Avro, XML или JSON.
Для преобразования сообщения в двоичный формат каждый продюсер должен указать сериализатор. Для преобразования формата обратно в сообщение в каждый консюмер должен указать соответствующий десериализатор. Как правило, эти компоненты коротко называются SerDes. Существуют встроенные SerDes, но мы можем реализовать и собственные SerDes.
На следующем рисунке показан процесс сериализации и десериализации:
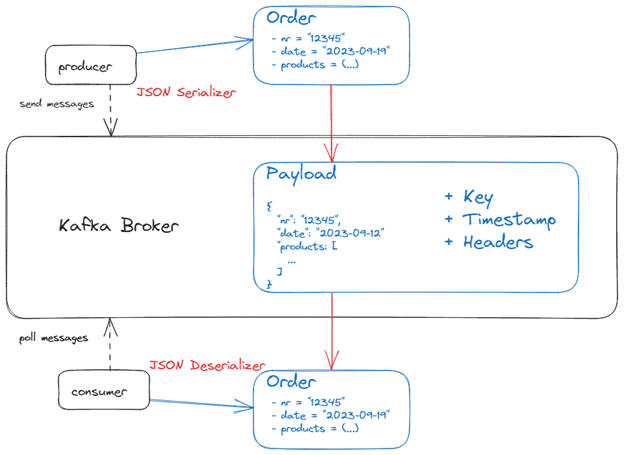
Кроме того, у сообщения могут быть следующие атрибуты (необязательно):
- Ключ, который также может иметь любой двоичный формат. Если мы используем ключи, нам понадобится SerDes. Kafka использует их для реализации партиционирования;
- Временная метка указывает на то, когда сообщение было создано. Kafka использует временные метки для упорядочивания сообщений, а также для реализации политик хранения;
- Помимо всего прочего можно применять заголовки. Так, Spring добавляет заголовки типов для сериализации и десериализации по умолчанию.
Топики & Партиции
Топик - это категория, объединяющая сообщения, которые публикуются продюсерами. Консюмеры подписываются на тот или иной топик и читают интересующие их сообщения.
По умолчанию сообщения, входящие в топик, хранятся в течение 7 дней. Иными словами по истечении 7 дней Kafka автоматически удаляет сообщения, независимо от того, были ли они доставлены они консюмерам или нет. При необходимости этот параметр может быть изменен.
Топики состоят из партиций (по крайней мере, одной). Если быть точнее, то сообщения хранятся в одной из партиций топика. В пределах одной партиции сообщению партиции присваивается порядковый номер (смещение). Это позволяет гарантировать то, что сообщения будут доставлены консюмеру в том же порядке, в котором они были сохранены в партиции. Кроме того, храня смещения, которые группа потребителей уже получила, Kafka гарантирует то, что сообщения будут доставлены только один раз.
Как только один консюмер подписывается на топик, он сразу же «привязывается» к одной определенной партиции, например, с помощью API клиента Java Kafka:
String topic = "my-first-topic";
consumer.subscribe(Arrays.asList(topic));Copy
При этом для потребителя можно выбрать сразу несколько партиций, из которых он хочет получать сообщения:
TopicPartition myPartition = new TopicPartition(topic, 1);
consumer.assign(Arrays.asList(myPartition));
И все же в идеале число консюмеров должно совпадать с числом партиций - каждый консюмер может быть назначен ровно одной из партиций:
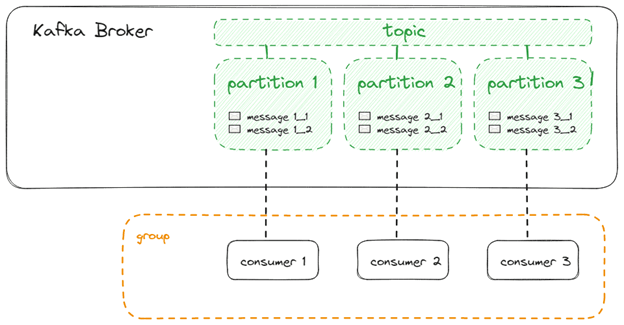
Если консюмеров больше, чем партиций, «лишние» консюмеры не смогут получать сообщения:
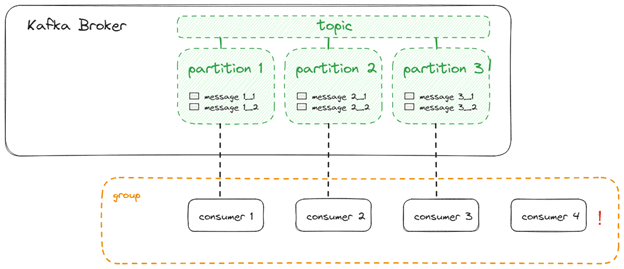
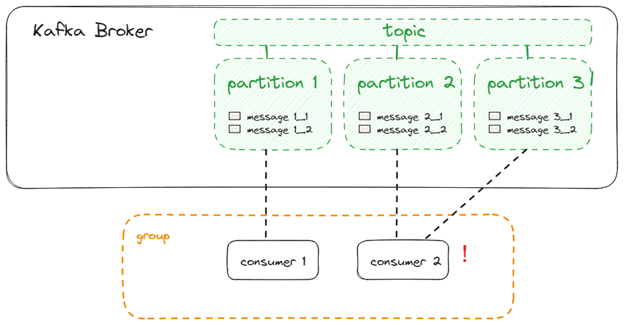
Если консюмеров меньше, чем партиций, консюмеры будут получать сообщения сразу из нескольких партицию, что противоречит принципу оптимального распределения нагрузки:
Продюсеры могут отправлять сообщения сразу в несколько партиций. Каждое опубликованное сообщение автоматически назначается одной партиции. Правила назначения партиций следующие:
- Продюсеры могут сами указать партицию в своем сообщении;
- Если в сообщении есть ключ, партиционирование осуществляется путем вычисления хэша ключа. Ключи с одинаковым хэшем будут храниться в одной партиции. В идеале количество хэшей и количество партиций должно совпадать.
- В противном случае сообщения по разделам распределяет Sticky Partitioner (липкий разделитель).
Опять же, хранение сообщений в одной партиции обеспечивает их упорядоченность. Хранение сообщений в разных партициях не может обеспечить их упорядоченность, однако дает возможность обрабатывать их параллельно.
Если партиционирование, осуществляемое по умолчанию, не соответствует Вашим ожиданиям, Вы всегда можете реализовать свое собственное решение с помощью интерфейса Partitioner, который должен быть зарегистрирован во время инициализации продюсера:
Properties producerProperties = new Properties();
// ...
producerProperties.put(ProducerConfig.PARTITIONER_CLASS_CONFIG, MyCustomPartitioner.class.getName());
KafkaProducer<String, String> producer = new KafkaProducer<>(producerProperties);
На следующем рисунке отображены продюсеры и консюмеры, а также их связи с партициями:
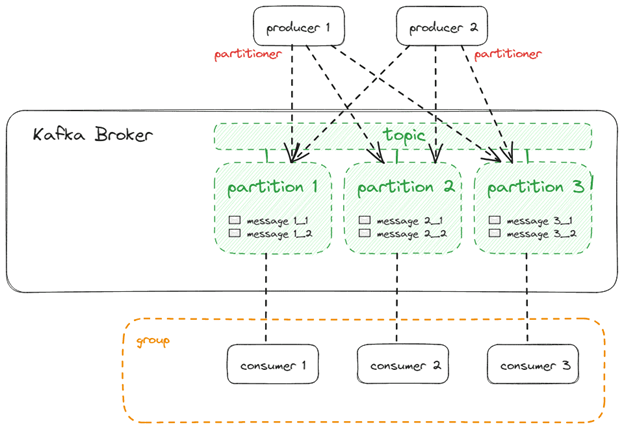
У каждого продюсера есть свой собственный разделитель, поэтому, если мы хотим обеспечить последовательное разделение сообщений в топике, мы должны убедиться в том, что разделители всех продюсеров работают одинаково, в обратном случае мы должны работать только с одним производителем.
Партиции хранят сообщения в том порядке, в котором они поступают к брокеру Kafka. Как правило, продюсер не отправляет каждое сообщение в виде отдельного запроса – отправляется сразу несколько сообщений. Если нам нужно обеспечить строгую последовательность сообщений и их единовременную доставку, нам нужны продюсеры и консюмеры, умеющие работать с транзакциями.
Кластеры & Реплики партиций
Как мы уже поняли, для параллельной доставки сообщений и распределения нагрузки между консюмерами Kafka использует партиции топиков. Однако для обеспечения масштабируемости системы мы должны использовать не один брокер Kafka, а кластер из нескольких брокеров. На каждого из них возлагаются специальные задачи, которые в случае, если один брокер выйдет из строя, могут быть переданы другим действующим брокерам.
Для того, чтобы лучше разобраться в этом вопросе, нам нужно чуть глубже погрузиться в тему топиков. При создании топиков мы указываем не только количество партиций, но и количество брокеров, которые совместно управляют партициями с помощью синхронизации. Мы называем это фактором репликации. Напримерс помощью Kafka CLI мы можем создать топик с 6 партициями, каждая из которых синхронизируется на 3 брокерах:
sh kafka-topics.sh --bootstrap-server localhost:9092 --create --topic my-replicated-topic --partitions 6 --replication-factor 3Copy
Так, коэффициент репликации, равный 3, означает, что кластер устойчив к отказам до 2 реплик (устойчивость N-1). Мы должны убедиться в том, что у нас есть по крайней мере столько брокеров, сколько мы указали в качестве коэффициента репликации. В противном случае Kafka не будет создавать топик до тех пор, пока количество брокеров не увеличится.
Для достижения наибольшей эффективности репликация партиции происходит только в одном направлении. Это достигается за счет объявления одного из брокеров лидером партиции. Продюсеры отправляют сообщения только лидеру партиции, который затем синхронизируется с другими брокерами. Консюмеры запрашивают сообщения также у лидера партиции.
Лидер партиции распределяется между несколькими брокерами. Для разных партиций Kafka пытается найти разных брокеров. Рассмотрим пример с 4 брокерами и 2 партициями с коэффициентом репликации, равным 3:
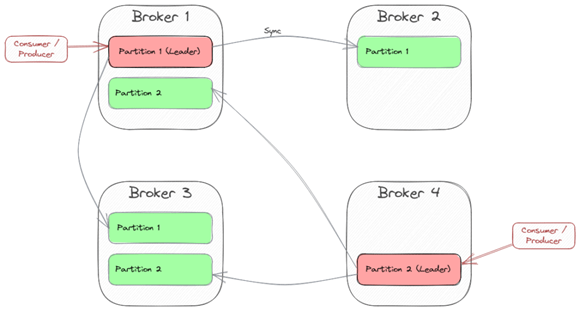
Брокер 1 является лидером партиции 1, а брокер 4 - лидером партиции 2. Таким образом, при отправке сообщений из этих партиций каждый клиент будет подключаться к этим брокерам. Для получения информации о лидерах партиций и доступных брокерах (метаданные) существует специальный механизм загрузки. Таким образом, можно сказать, что каждый брокер может предоставлять метаданные кластера, поэтому клиент может инициализировать соединение с каждым из этих брокеров, а затем перенаправляться к лидерам партиций. Именно поэтому мы можем указать сразу несколько брокеров в качестве загрузочных серверов.
Если один из брокеров-лидеров выйдет из строя, Kafka объявит одного из работающих брокеров новым лидером партиций. Затем все клиенты должны подключиться к этому новому лидеру. В нашем примере, если брокер 1 вышел из строя, новым лидером партиции 1 становится брокер 2. Тогда клиенты, которые были подключены к брокеру 1, должны переключиться на брокера 2.
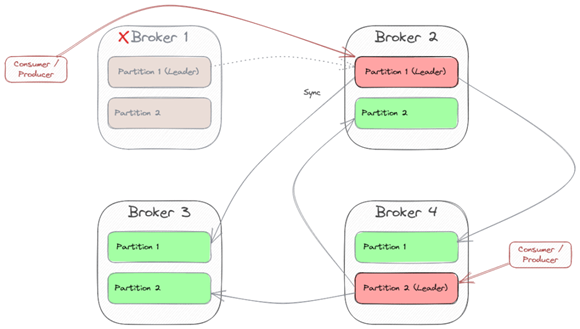
Для управления всеми брокерами в рамках одного кластера Kafka использует Kraft (ранее Zookeeper).
Соединяем все компоненты воедино
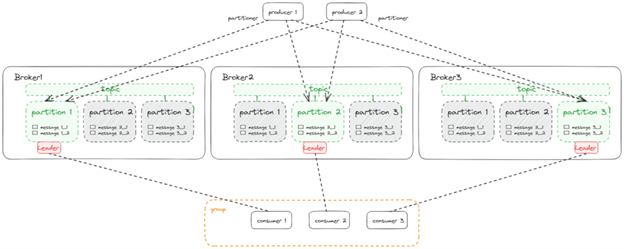
Если мы объединим всех продюсеров и консюмеров вместе с кластером, состоящим из трех брокеров, которые объединены 1 топиком с з партициями и коэффициентом репликации = 3, мы получим следующую архитектуру:
Экосистема
Мы уже знаем, что для подключения к Kafka существует множество клиентов, таких как CLI, клиент на базе Java с интеграцией в приложения Spring, а также множество GUI-инструментов. Конечно, существуют и другие клиентские API для многих языков программирования (C/C++, Python или Javascript), но они не являются частью проекта Kafka.
Kafka Connect
Kafka Connect - это API по обмену данными со сторонними системами. Для обмена данными с AWS S3, JDBC или для организации передачи данных между несколькими кластерами Kafka существуют различные коннекторы. Конечно, можно создать и свои собственные коннекторы.
Kafka Streams
Kafka Streams – это решение по реализации приложений потоковой обработки данных, которое получает входные данные из одного топика Kafka и сохраняет результаты их обработки в другом топике Kafka.
KSQL
KSQL - это надстройка над Kafka Streams, позволяющая вместо написания Java кода использовать SQL-подобный язык. Для организации потоковой обработки сообщений, которыми обменивается Kafka, используется SQL-подобный синтаксис и платформа ksqlDB, которая подключается к кластеру Kafka с помощью нескольких инструментов и приложений.
Прокси-сервер REST для Kafka
Прокси-сервер REST для Kafka предоставляет REST-интерфейс к кластеру Kafka. Таким образом, нам не нужны клиенты Kafka или родной протокол Kafka. Прокси-сервер позволяет веб-фронтендам подключаться к Kafka. Кроме того, с его помощью мы можем использовать различные сетевые компоненты, такие как API-шлюзы или брандмауэры.
Операторы Kafka для Kubernetes (Strimzi)
Strimzi - это проект с открытым исходным кодом, который предоставляет возможность запуска Kafka на таких платформах, как Kubernetes и OpenShift. В нем представлены пользовательские ресурсы Kubernetes, что упрощает управление ресурсами, связанными с Kafka, на основе Kubernetes. В нем используется паттерн Operator , автоматизирующий выполнение таких задач, как инициализация, масштабирование, обновление и мониторинг кластеров Kafka.
Заключение
В этой статье мы поговорили об Apache Kafka, подчеркнув высокую масштабируемость и исключительную отказоустойчивость данной системы; обсудили продюсеров сообщений, топики, которые в свою очередь делятся на партиции, консюмеров сообщений, а также механизмы обеспечения стабильной и эффективной работы одного из самых востребованных брокеров сообщений.


