

Ускорение работы дашбордов Apache Superset с помощью материализованных представлений
Интерактивная аналитика - краеугольный камень современной бизнес-аналитики (BI), позволяющий командам принимать решения на основе данных в режиме реального времени. Apache Superset является лидером в этой области, предоставляя широкие возможности для создания дашбордов и изучения данных. Однако обеспечение стабильной производительности может оказаться сложной задачей по мере роста сложности и масштаба наборов данных.
В этом блоге мы расскажем о типичных проблемах, с которыми могут столкнуться пользователи при ускорении работы дашюордов в Apache Superset, а также о том, как последние достижения в области материализованных представлений могут существенно улучшить работу пользователей.
Современные конвейеры предварительных вычислений не предназначены для современного BI
Конвейеры предварительных вычислений традиционно являются предпочтительным методом ускорения OLAP-запросов. Эти конвейеры минимизируют дорогостоящие операции «на лету», создавая денормализованные и предварительно агрегированные таблицы с помощью таких инструментов, как Apache Spark. Однако такой подход имеет ряд недостатков, которые делают его не самым подходящим вариантом для современных рабочих процессов BI:
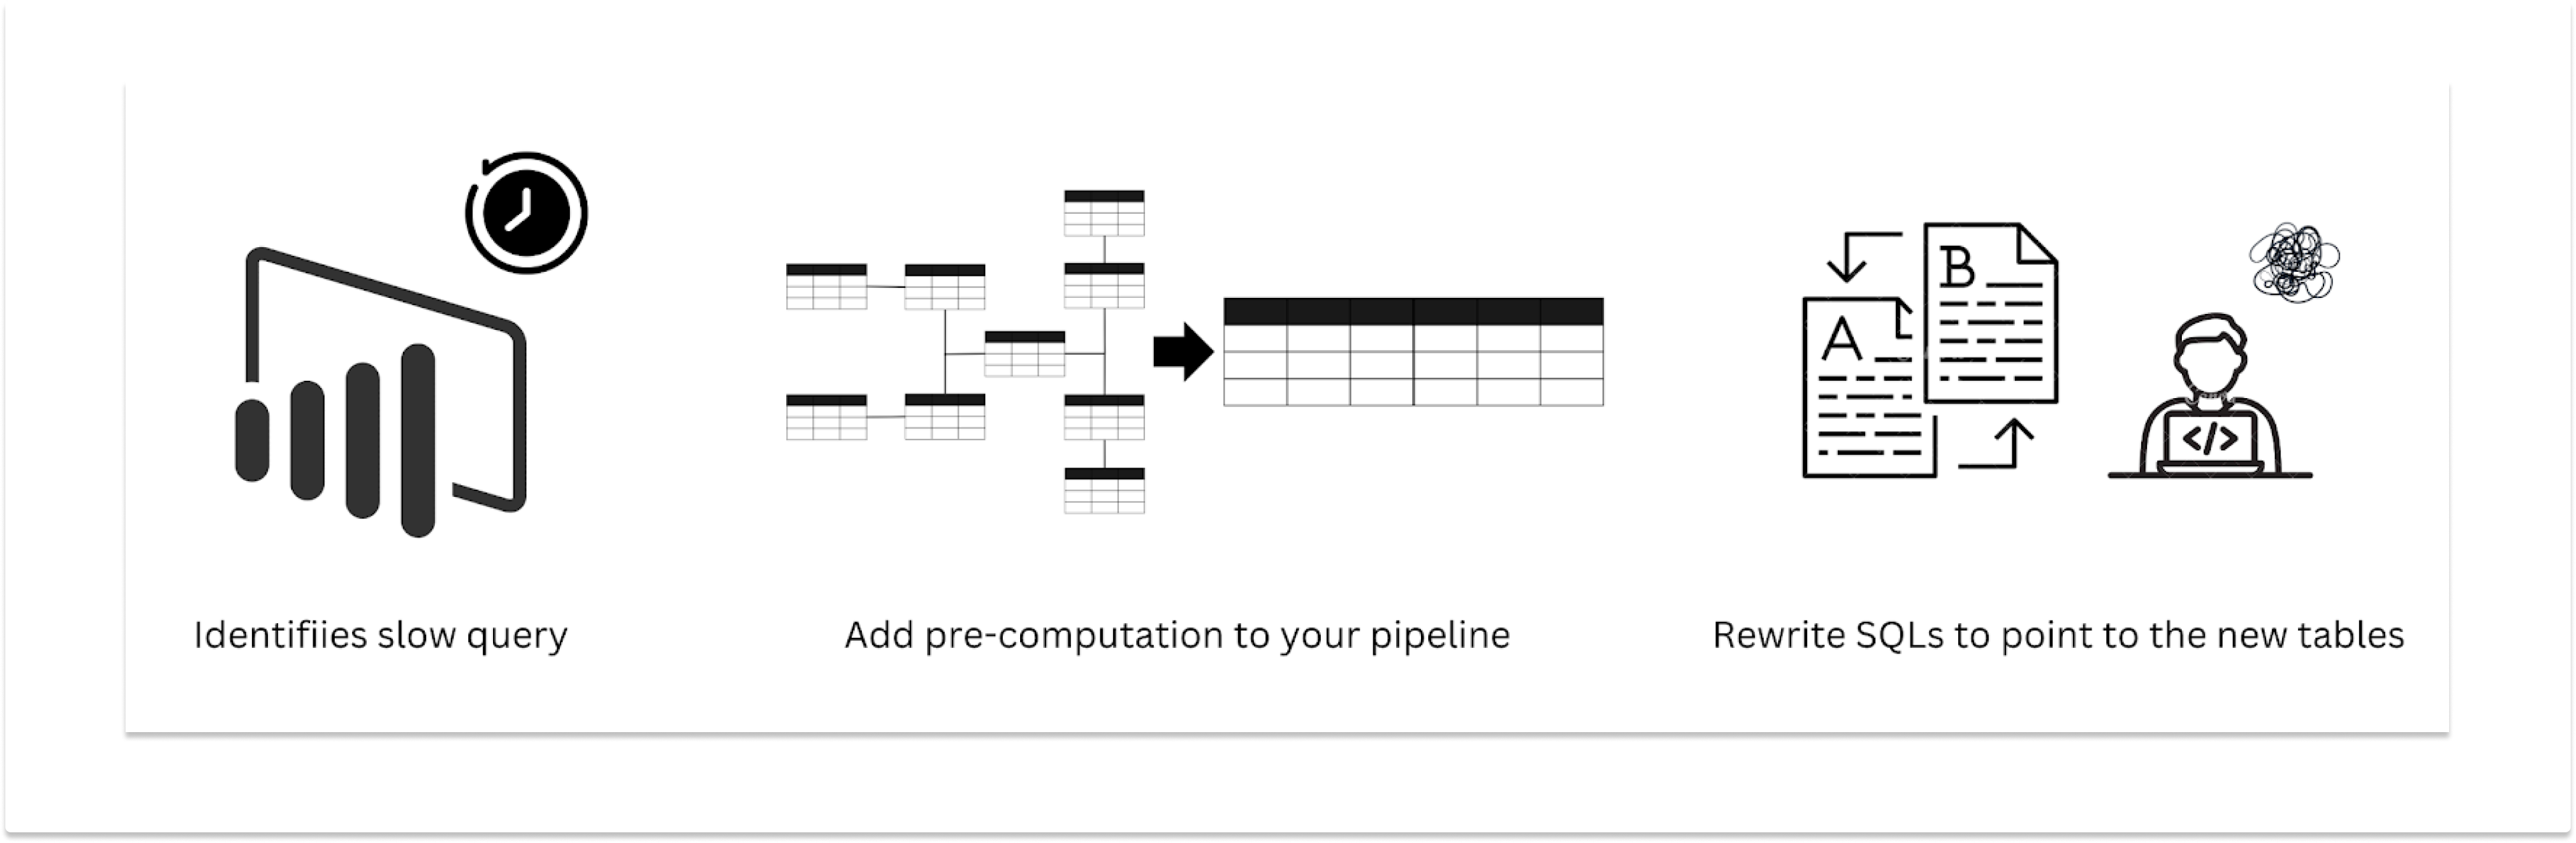
- Сложность для потребителей данных: Пользователи данных вынуждены переписывать SQL-запросы или изменять конфигурацию дашбордов для доступа к предварительно вычисленным таблицам, что вносит дополнительные сложности в рабочий процесс в целом.
- Большая нагрузка на инженеров: Инженеры платформы должны разрабатывать и поддерживать конвейеры до создания приложений, что часто приводит к неиспользованию предварительно вычисленных таблиц и напрасной трате ресурсов.
- Замедление циклов разработки: Конвейеры предварительных вычислений значительно удлиняют сроки разработки и увеличивают затраты, что приводит к задержке предоставления ценности.
Ускорение запросов Apache Superset с помощью материализованных представлений StarRocks
Проблемы с традиционными конвейерами предварительных вычислений подчеркивают острую необходимость в новом подходе к ускорению запросов - таком, который упрощает рабочие процессы, снижает инженерные издержки и динамически адаптируется к требованиям современных BI-инструментов, таких как Apache Superset.
Что такое StarRocks?
Именно здесь на помощь приходит StarRocks. StarRocks - это высокопроизводительная, векторная OLAP-база данных нового поколения MPP (Massively Parallel Processing), предназначенная для интерактивной аналитики. Она обеспечивает субсекундную производительность запросов для BI-дашбордов, даже при работе со сложными наборами данных или высококонкурентными рабочими нагрузками.
Что такое материализованное представление StarRocks
Материализованные представления StarRocks предназначены для ускорения запросов по требованию, обеспечивая высокую производительность как во внутренних таблицах, так и во внешних источниках, таких как Apache Hive, Apache Hudi, Apache Iceberg и Delta Lake. Отличительной особенностью этих материализованных представлений является возможность беспрепятственной перезаписи запросов, благодаря чему дашборды и рабочие процессы остаются неизменными.
Используя оптимизатор StarRocks на основе затрат (CBO), перезапись запросов динамически определяет и применяет наиболее эффективное материализованное представление во время выполнения запроса. Это избавляет пользователей от необходимости вручную переписывать SQL или вносить коррективы для повышения производительности. С помощью StarRocks повышение производительности полностью автоматизировано и легко интегрируется в существующие рабочие процессы BI.
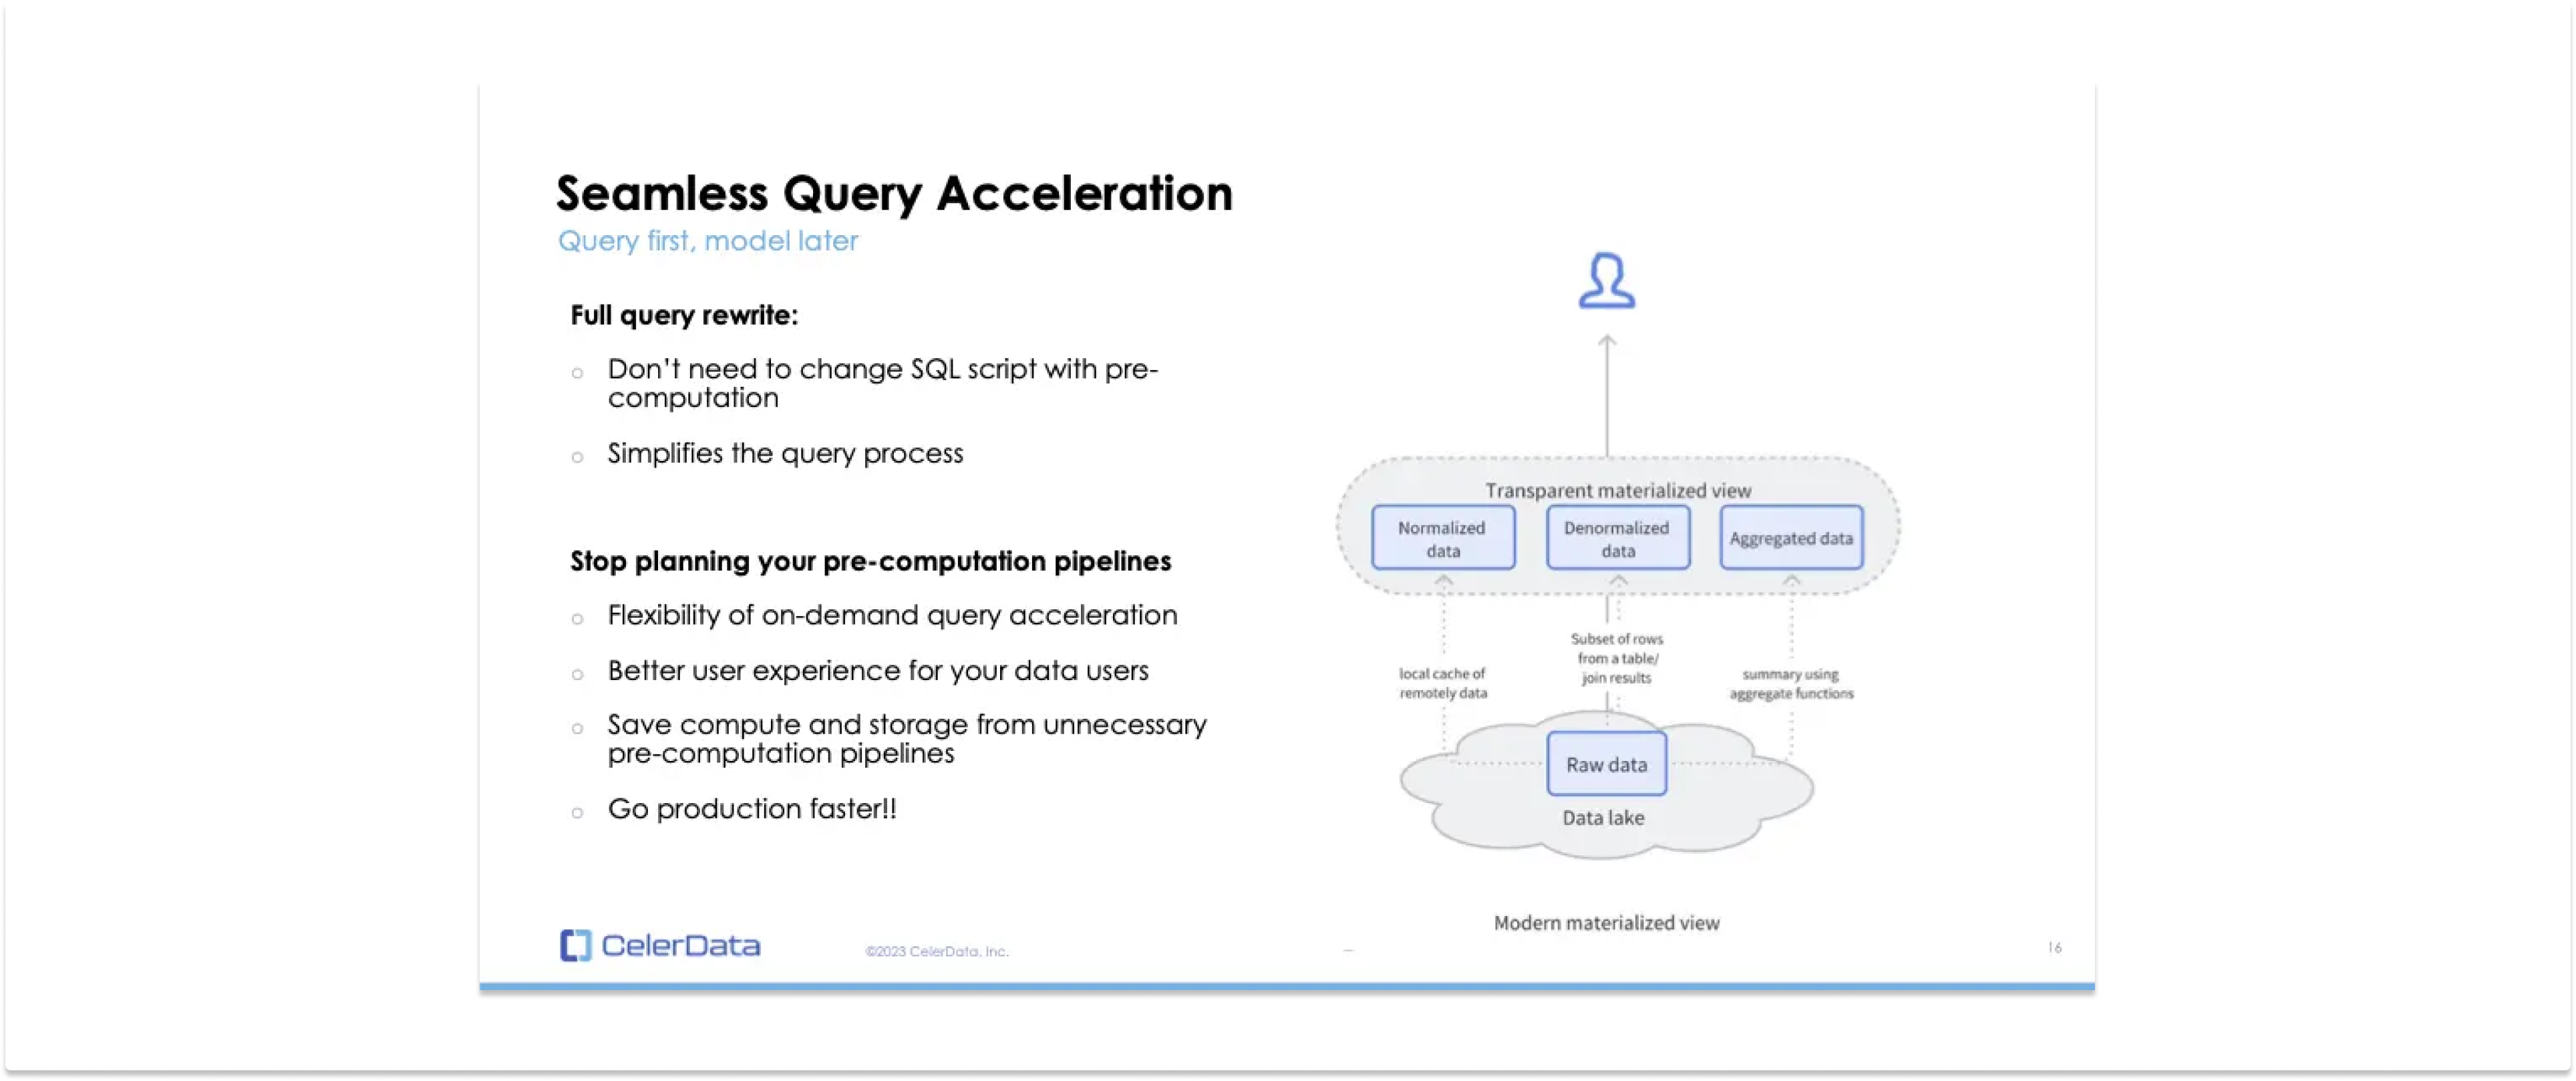
Устраняя ограничения традиционных конвейеров предварительных вычислений, материализованное представление StarRocks позволяет сделать следующее:
- Построение дашбордов непосредственно на основе необработанных данных: Пользователям не нужны предварительно вычисленные таблицы.
- Оптимизация запросов по требованию: Добавление материализованных представлений по требованию и немедленное повышение производительности.
- Ускоренные циклы разработки: Снижает сложность и накладные расходы на проектирование конвейера, позволяя командам сосредоточиться на быстром предоставлении информации.
Практические решения и лучшие практики
В реальных сценариях Apache Superset данные часто подвергаются предварительной обработке, которая включает в себя очистку или денормализацию данных, чтобы обеспечить их готовность к работе с дашбордами. Как правило, такая обработка осуществляется одним из двух способов:
- Хранятся в виде представлений: Логика и преобразования хранятся в виде представлений в базовом движке или базе данных, что обеспечивает возможность повторного использования и согласованность данных.
- Определяются как виртуальные наборы данных: Superset позволяет пользователям определять виртуальные наборы данных, которые выступают в качестве уровня абстракции для логики запросов, что упрощает создание информационных панелей без прямого обращения к исходным таблицам.
Оба подхода используются в рабочих процессах Superset, StarRocks обеспечивает ускорение запросов для любого из вариантов, не требуя изменений в архитектуре или дашбордах.
Перезапись на основе представлений

Для предварительно обработанных данных, хранящихся в виде представлений в базовой базе данных, материализованные представления StarRocks могут значительно ускорить работу Ваших дашбордов:
- Модульная конструкция: Инкапсулируйте логику запросов в стандартные представления StarRocks, обеспечивая гибкость и ремонтопригодность рабочих процессов.
- Прозрачная оптимизация: Когда Вы преобразуете эти представления в материализованные представления StarRocks, функция перезаписи запросов системы будет автоматически оптимизировать запросы, выполняемые на этих представлениях.
- Никаких изменений в дашборде: Дашборды, ссылающиеся на представления, автоматически получат преимущества от повышения производительности, даже вне ограничений SPJG (Select-Project-Join-GroupBy).
Перезапись текста с использованием виртуальных наборов данных Superset
Когда Apache Superset генерирует SQL из виртуального набора данных, он напрямую передает его базовому движку. Для виртуальных наборов данных, определенных в Superset, переписывание запросов на основе текста может обеспечить такую же бесшовную оптимизацию:
- Настраивается только один раз: поскольку дашборды Superset строятся на основе виртуальных наборов данных, базовый SQL обычно остается неизменным.
- Эффективная интеграция: StarRocks может применять материализованные представления для ускорения запросов, связанных с виртуальными наборами данных, не изменяя рабочие процессы Superset или пользовательскую логику.
- Никаких изменений дашбордов: Как и в случае с представлениями баз данных, дашборды, ссылающиеся на виртуальные наборы данных, автоматически получают преимущества от ускорения выполнения запросов, обеспечивая бесперебойную работу пользователей.
Демо-версия: Ускорение работы дашбордов с помощью StarRocks и Apache Superset
Чтобы увидеть эти приемы в действии, давайте рассмотрим демонстрационный пример с использованием CelerData Cloud BYOC (от StarRocks) вместе с Preset (от Apache Superset).
Наборы данных:
- TPC-H (100Гб)
- SSB (1Тб)
Основные моменты:
- Ускорение работы дашбордов по требованию: Узнайте, как выявлять и устранять медленные запросы к дашбордам с помощью материализованных представлений.
- Перезапись на основе представлений в действии: Узнайте, как плавное преобразование представлений в материализованные представления позволяет ускорить выполнение запросов без модификации SQL, даже при использовании запросов, не содержащих spjg.
Видео
https://youtu.be/rHZTBbZOgWM?t=2258
Попробуйте StarRocks + Preset прямо сейчас!
Интерактивная аналитика не должна быть ограничена низкой производительностью запросов или громоздкими рабочими процессами. Благодаря материализованным представлениям StarRocks и интеграции с Apache Superset Вы сможете раскрыть весь потенциал своих BI-дашбордов без изменения конфигурации архитектуры или переписывания SQL.


