

Что такое Apache Parquet и зачем он нужен
Apache Parquet — это открытый колоночный формат хранения данных, который часто используют в Data Lake, Big Data-платформах, облачных хранилищах и аналитических пайплайнах. В отличие от CSV и других строковых форматов, Parquet хранит данные по столбцам, поэтому аналитические системы могут читать только нужные колонки и быстрее выполнять запросы.
Parquet помогает уменьшать объем хранения за счет эффективного сжатия, сохраняет схему и метаданные внутри файла, хорошо подходит для Spark, Hadoop, Amazon S3, Athena, DWH и lakehouse-архитектур. В статье разберем, что такое Apache Parquet, чем он отличается от CSV, Avro и ORC, какие преимущества дает для аналитики и в каких сценариях его стоит использовать.
Что внутри:
- что такое Apache Parquet простыми словами;
- почему Parquet называют колоночным форматом;
- чем Parquet отличается от CSV, Avro и ORC;
- как колоночное хранение ускоряет аналитические запросы;
- сжатие файлов и экономия места;
- схема и метаданные внутри Parquet-файла;
- применение Parquet в Data Lake;
- Parquet в Amazon S3, Athena, Spark и Hadoop;
- когда стоит выбирать Parquet;
- ограничения и ситуации, где Parquet может быть не лучшим выбором.
С момента своего появления в 2013 году Apache Parquet стал одним из самых популярных и востребованных форматов хранения данных с открытым исходным кодом. Когда AWS объявила об экспорте данных из Data Lake, cспециалисты компании подчеркнули, что «по сравнению с текстовыми форматами Parquet в 2 раза быстрее при выгрузке и потребляет в 6 раз меньше места для хранения в Amazon S3». Преобразование данных в колоночные форматы хранения, такие как Parquet или ORC, также способствует повышению производительности Amazon Athena.
Очевидно, что Apache Parquet незаменим при работе с Data Lake.
Parquet - один из основных форматов файлов, поддерживаемых Upsolver, мощной платформой для преобразования данных, работающей на базе SQL. Она может вводить и выводить файлы Parquet и использует данный формат хранения по умолчанию.
Теперь давайте подробнее рассмотрим, что такое Parquet и почему он так важен для хранения и анализа Big Data.
Основное определение: что такое Apache Parquet?
Apache Parquet - это формат хранения данных, разработанный для быстрой обработки сложных данных и обладающий несколькими основными особенностями:
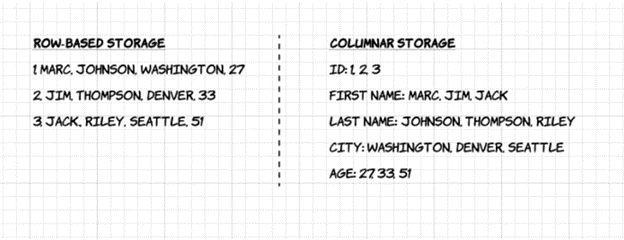
- Колоночно-ориентированный формат: в отличие от форматов хранения по строкам, таких как CSV или Avro, Apache Parquet ориентирован на столбцы - это означает то, что значения каждого столбца таблицы хранятся рядом друг с другом:
- Open-source проект: Parquet имеет открытый исходный код в соответствии с лицензией Apache Hadoop и совместим с большинством фреймворков обработки данных Hadoop. Согласно информации, размещенной на официальном сайте, “Apache Parquet … применим абсолютно для любого проекта… независимо от выбора фреймворка обработки данных, модели данных или языка программирования.”
- Содержит метаданные: помимо самих данных, файл Parquet содержит метаданные, включая схему и структуру. В каждом файле хранятся как данные, так и стандарты, используемые для доступа к каждой записи, что упрощает разделение служб, которые записывают, хранят и читают файлы Parquet.
Преимущества формата хранения данных Parquet – почему я должен выбрать именно его?
Вышеперечисленные характеристики формата файлов Apache Parquet обуславливают ряд преимуществ, незаменимых при организации хранения и анализе больших объемов данных. Давайте рассмотрим некоторые из них более подробно.
- Сжатие файлов
Сжатие файла - это процесс, в результате которого файл становится меньше. В Parquet сжатие выполняется по столбцам. Данный формат поддерживает гибкие варианты сжатия и расширяемые схемы кодирования для каждого типа данных - например, для сжатия целочисленных и строковых данных могут использоваться разные кодировки. Данные Parquet могут быть сжаты с помощью следующих методов кодирования:
- Кодирование словаря: включается автоматически для данных с небольшим количеством уникальных значений.
- Упаковка бит: для хранения целых чисел обычно выделяется 32 или 64 бита на целое число. Это позволяет более эффективно хранить небольшие целые числа.
- Кодирование длиной длины (RLE): когда одно и то же значение встречается несколько раз, оно сохраняется один раз вместе с количеством повторений. В Parquet реализована комбинированная версия упаковки бит и RLE, в которой мед кодировки меняется в зависимости от того, какой из них дает наилучшие результаты сжатия.
- Производительность
В отличие от форматов файлов, ориентированных на строки, таких как CSV, Parquet оптимизирован для повышения производительности. Выполняя запросы к файловой системе на основе Parquet, Вы сможете сосредоточиться только на нужных Вам данных. Более того, объем сканируемых данных будет гораздо меньше, что приведет к снижению затрат на операции I/O. Чтобы лучше понять этот принцип, давайте немного углубимся в то, как устроены файлы Parquet.
Как мы уже говорили, Parquet содержит как данные, так и метаданные. Файлы Parquet состоят из групп строк, заголовка и нижнего колонтитула. Каждая группа строк содержит данные из одних и тех же столбцов. Одинаковые столбцы хранятся вместе в каждой группе строк:

Такая структура оптимизирована как для быстрого выполнения запросов, так и для небольшого количества операций I/O. Например, если у Вас есть таблица с 1000 столбцами, в которой Вы обычно запрашиваете только небольшое подмножество столбцов. Использование Parquet позволит Вам получить только необходимые столбцы и их значения, быстро загрузить их в память и оперативно ответить на запрос. Если бы мы использовали формат файла, основанный на строках, например CSV, нам пришлось бы загружать в память всю таблицу, что привело бы к увеличению объема операций ввода-вывода и снижению производительности в целом.
- Развитие схемы
При использовании колоночно-ориентированных форматов хранения пользователи могут начать с простой схемы и постепенно добавлять в нее новые столбцы по мере необходимости. Таким образом, у пользователя может оказаться несколько файлов Parquet с разными, но взаимно совместимыми схемами. В таких случаях реализована поддержка автоматического объединения схем этих файлов.
- Open-source и свободное решение
Apache Parquet является частью экосистемы Apache Hadoop. Его разработка ведется весьма активно, он постоянно совершенствуется и поддерживается сильным и чрезвычайно активным сообществом пользователей и разработчиков.
Хранение данных в открытых форматах позволяет избежать привязки к поставщику и повысить гибкость по сравнению с проприетарными форматами файлов, используемыми во многих современных высокопроизводительных базах данных. Это означает, что Вы можете использовать различные механизмы запросов, такие как Amazon Athena, Qubole и Amazon Redshift Spectrum, в рамках одной архитектуры Data Lake, а не привязываться к какому-то одному поставщику баз данных.

Колоночное хранение vs строковое хранение в рамках выполнения аналитических запросов
Данные часто формируются и легче осмысливаются в виде строк. Мы привыкли мыслить в терминах электронных таблиц Excel, где все данные, относящиеся к конкретной записи, можно увидеть в одной аккуратной и упорядоченной строке. Однако для крупномасштабных аналитических запросов целесообразнее выбирать колоночное хранение.
Сложные данные, такие как журналы и потоки событий, должны быть представлены в виде таблицы с сотнями или тысячами столбцов и многими миллионами строк. Хранение такой таблицы в формате, основанном на строках, например CSV, означало бы следующее:
- Запросы будут выполняться гораздо дольше, поскольку нужно будет просканировать больше данных, а не запрашивать только подмножество столбцов, необходимых для ответа на тот или иной запрос (что обычно требует агрегирования по размеру или категории).
- Хранение будет более дорогостоящим, поскольку CSV файлы сжимаются не так эффективно, как Parquet
Колоночные форматы хранения обеспечивают лучшее сжатие и повышенную производительность, а также позволяют запрашивать данные по вертикали - столбец за столбцом.
В каких случаях нужно использовать Apache Parquet?
Parquet совершенно точно стоит использовать в следующих случаях:
- Когда Вы работаете с очень большими объемами данных. Parquet создан для обеспечения производительности и эффективного сжатия файлов. Различные бенчмарки, сравнивавшие время обработки SQL-запросов в Parquet с такими форматами, как Avro или CSV (в том числе описанный в этой статье), показали, что запросы в Parquet выполняются гораздо быстрее.
- Когда набор данных содержит множество столбцов, но Вам нужно получить доступ только к определенному подмножеству. В связи с растущей сложностью и объемом записываемых данных в определенный момент времени Вы можете увидеть, что вместо 20 полей для каждого события Вы теперь собираете более 100. Хотя эти данные легко хранить в Data Lake, для запроса к ним потребуется просканировать значительный объем данных, если они хранятся в форматах, основанных на строках. Колоночная природа Parquet позволяет извлекать только те столбцы, которые действительно необходимы для ответа на конкретный запрос.
- Когда появляется необходимость в том, чтобы несколько сервисов могли использовать одни и те же данные из объектного хранилища. В то время как поставщики баз данных, такие как Oracle и Snowflake, предпочитают хранить данные в проприетарном формате, который могут читать только их инструменты, современная архитектура данных склоняется к отделению хранения от вычислений. Если Вы хотите работать с несколькими аналитическими службами для решения различных задач, Вам следует хранить данные в формате Parquet.
На самом деле, данный список не является исчерпывающим, случаях, для которых больше всего подходит Parquet, гораздо больше.
Parquet vs ORC
Apache Parquet и Optimized Row Columnar (ORC) – два наиболее популярных формата хранения Big Data. Выбор наиболее подходящего формата зависит от того, что Вы хотите получить.
- Эффективность записи: ORC лучше подходит для операций, требующих больших объемов записи. Он обеспечивает более высокую скорость записи по сравнению с Parquet, особенно при работе с развивающимися схемами.
- Эффективность чтения: Parquet отлично подходит для WORM аналитических сценариев, обеспечивая высокоэффективную компрессию и декомпрессию данных. Он поддерживает пропуск данных, что позволяет запросам возвращать определенные значения столбцов, пропуская всю строку данных, что приводит к минимизации операций ввода-вывода. Совместимость: ORC хорошо совместим с экосистемой Hive, обеспечивая такие преимущества, как поддержка транзакций ACID при работе с Apache Hive. Однако Parquet предлагает более широкие возможности, поддерживая множество языков программирования, таких как Java, C++ и Python, что делает его пригодным для использования практически в любой среде Big Data. Кромего, данный формат хранения широко используется в различных механизмах запросов, таких как Amazon Athena, Amazon Redshift Spectrum, Qubole, Google BigQuery, Microsoft Azure Data Explorer и Apache Drill.
- Сжатие: И ORC, и Parquet предлагают множество вариантов сжатия и поддерживают эволюцию схемы. Однако, когда главным критерием является сжатие, как правило, выбирают Parquet, поскольку именно он позволяет получить файлы меньшего размера благодаря чрезвычайно эффективным схемам сжатия и кодирования. Он также может поддерживать конкретные схемы сжатия на основе отдельных столбцов, что еще больше оптимизирует хранение данных.
Пример: запись файлов Parquet в S3
Для наглядной демонстрации преимуществ использования колоночных форматов хранения данных рассмотрим случай использования Amazon Athena для запроса данных, хранящихся на Amazon S3.
Используя Upsolver, мы перенесли CSV-набор данных журналов сервера в S3. В обычной архитектуре Data Lake в AWS Athena используется для запросов к данным непосредственно из S3. Затем эти запросы можно визуализировать с помощью таких интерактивных инструментов визуализации данных, таких как Tableau или Looker.
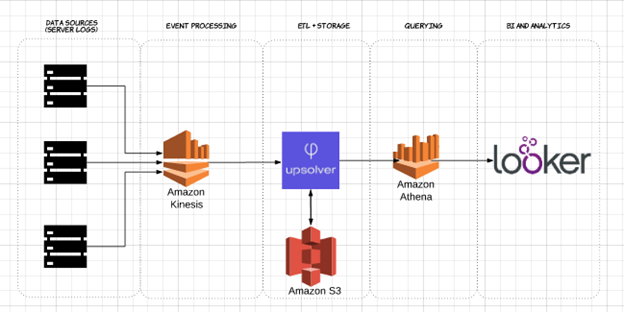
Мы протестировали Athena с одним и тем же набором данных, хранящимся в сжатом виде CSV и в виде Apache Parquet.
Вот запрос, который мы выполнили в Athena:
SELECT tags_host AS host_id, AVG(fields_usage_active) as avg_usage
FROM server_usage
GROUP BY tags_host
HAVING AVG(fields_usage_active) > 0
LIMIT 10
Результаты:
|
CSV |
Parquet |
Столбцы |
|
|
Время обработки запроса (секунды) |
735 |
211 |
18 |
|
Объем отсканированных данных (Гб) |
372.2 |
10.29 |
18 |
- Сжатые файлы CSV: сжатый CSV имеет 18 столбцов и весит 27 ГБ. Athena должна просканировать весь CSV-файл, чтобы ответить на запрос, поэтому мы будем платить за 27 ГБ отсканированных данных. При увеличении объемов данных это негативно скажется на производительности в целом.
- Parquet: преобразовав наши сжатые CSV-файлы в Apache Parquet, Вы получите аналогичный объем данных в S3. Однако, поскольку Parquet является колоночно-ориентированным, Athena нужно читать только те столбцы, которые имеют отношение к выполняемому запросу – это сравнительно небольшое подмножество данных. В нашем случае Athena просканировала 0,22 ГБ данных, поэтому вместо оплаты за 27 ГБ отсканированных данных мы платим только за 0,22 ГБ.
Достаточно ли использовать только Parquet?
Использование Parquet - это хорошее и разумное начало, но оптимизация запросов к данным Data Lake этим не ограничивается. Для получения быстрого и экономически эффективного ответа на запросы необходимо очищать, обогащать и преобразовывать данные, выполнять соединения с высокой степенью кардинальности и внедрять лучшие практики, которые выходят далеко за рамки формата Parquet.
FAQ
Вопрос: Что такое Apache Parquet?
Ответ: Apache Parquet — это открытый колоночный формат хранения данных, оптимизированный для аналитических запросов, сжатия и обработки больших объемов данных.
Вопрос: Чем Parquet отличается от CSV?
Ответ: CSV хранит данные построчно и не содержит строгой схемы. Parquet хранит данные по колонкам, поддерживает схему и метаданные, лучше сжимается и обычно быстрее работает в аналитических запросах.
Вопрос: Почему Parquet используют в Data Lake?
Ответ: Parquet хорошо подходит для Data Lake, потому что экономит место, ускоряет чтение нужных колонок, поддерживается многими инструментами обработки данных и удобен для больших аналитических наборов данных.
Вопрос: Какие инструменты поддерживают Parquet?
Ответ: Parquet поддерживают Apache Spark, Hadoop, Hive, Presto, Trino, Amazon Athena, многие облачные DWH, lakehouse-платформы и инструменты data engineering.
Вопрос: Когда Parquet не подходит?
Ответ: Parquet не всегда удобен для частых точечных обновлений, маленьких файлов, транзакционных сценариев и простого ручного просмотра данных. Для таких задач могут подойти другие форматы или базы данных.
- Apache Spark: что это и где используют
- ETL и ELT: 5 основных отличий
- DWH: зачем компании хранилище данных
- Что такое витрина данных и зачем она бизнесу
- ClickHouse для новичков


