

Интеграция ClickHouse и совместимого с S3 объектного хранилища
Интеграция с объектными хранилищами, совместимыми с S3, в разы расширяет возможности ClickHouse - от базовых операций импорта/экспорта данных до многогранной функциональности таблиц MergeTree.
ClickHouse - это БД - «полиглот», которая благодаря специальным движкам или табличным функциям может эффективно взаимодействовать с самыми разными внешними системами. На сегодняшний момент одной из самых востребованных внешних систем является объектное хранилище. Во-первых, в нем можно хранить необработанные данные (Data Lake). Во-вторых, оно может предложить дешевое и надежное хранение табличных данных. Сегодня ClickHouse поддерживает оба варианта использования объектного хранилища, совместимого с S3.
Первые попытки объединить ClickHouse и объектное хранилище были предприняты более года назад. С тех пор многое изменилось в лучшую сторону - в дополнение к базовой функциональности импорта/экспорта ClickHouse теперь может использовать объектное хранилище для таблиц MergeTree. Хотя этот функционал по большому счету до сих пор является неким экспериментом, он уже привлек внимание многих ведущих специалистов в сфере работы с данными. В этой статье мы подробно расскажем Вам о том, как работает эта интеграция.
Табличная функция S3
В ClickHouse реализован мощный метод интеграции с внешними системами, который называется «табличные функции». Табличные функции позволяют пользователям экспортировать/импортировать данные в другие системы/источники, коих существует огромное множество. Например, это может быть сервер MySQL, соединение ODBC или JDBC, файл, URL, а с недавних пор и S3-совместимое хранилище. Табличная функция S3 входит в основной список функций Clickhouse, базовый синтаксис выглядит следующим образом:
s3(path, [aws_access_key_id, aws_secret_access_key,] format, structure, [compression])
Входные данные:
- path — URL-адрес бакета. Путь к файлу. Поддерживает следующие знаки в режиме чтения *, ?, {abc,def} и {N..M} где N, M — числа, а ’abc’, ‘def’ — строки.
- format — формат данных
- structure — структура таблицы. Формат ‘column1_name column1_type, column2_name column2_type, …’
- compression — параметр не является обязательным, В настоящее время единственным вариантом является gzip’, но в самое ближайшее время будут добавлены и другие утилиты.
INSERT INTO tripdata
SELECT *
FROM s3('https://s3.us-east-1.amazonaws.com/altinity-clickhouse-data/nyc_taxi_rides/data/tripdata/data-20*.csv.gz',
'CSVWithNames',
'pickup_date Date, id UInt64, vendor_id String, tpep_pickup_datetime DateTime, tpep_dropoff_datetime DateTime, passenger_count UInt8, trip_distance Float32, pickup_longitude Float32, pickup_latitude Float32, rate_code_id String, store_and_fwd_flag String, dropoff_longitude Float32, dropoff_latitude Float32, payment_type LowCardinality(String), fare_amount Float32, extra String, mta_tax Float32, tip_amount Float32, tolls_amount Float32, improvement_surcharge Float32, total_amount Float32, pickup_location_id UInt16, dropoff_location_id UInt16, junk1 String, junk2 String',
'gzip');

0 rows in set. Elapsed: 238.439 sec. Processed 1.31 billion rows, 167.39 GB (5.50 million rows/s., 702.03 MB/s.)

Обратите внимание на подстановочные знаки! Они позволяют импортировать несколько файлов за один вызов функции. Например, наш любимый набор данных о поездках на такси в Нью-Йорке который хранится в одном файле, можно импортировать с помощью всего лишь одной команды SQL.
Несколько важных советов:
- Начиная с версии 20.10 ClickHouse пути с подстановочными знаками с «общими» URL-адресами бакетов S3 перестали работать должным образом. Теперь необходимо указывать конкретный регион. Поэтому нужно использовать https://s3.us-east-1.amazonaws.com/altinity-clickhouse-data/, а не https://altinity-clickhouse-data.s3.amazonaws.com/
- С другой стороны, для загрузки одного файла можно использовать удобные URL-адреса бакетов.
- Производительность импорта S3 сильно зависит от уровня параллелизма на стороне клиента. В режиме glob несколько файлов могут обрабатываться параллельно. В приведенном выше примере использовалось 32 потока вставки. Если Ваш сервер меньше, попробуйте установить более высокие значения параметра max_insert_threads. Это можно сделать с помощью команды set , например: set max_threads=32, max_insert_threads=32;
С другой стороны настройка параметра input_format_parallel_parsing может привести к превышению объема памяти, поэтому лучше отключите его.
Функцию таблицы S3 можно использовать не только для импорта, но и для экспорта. Вот как можно загрузить набор данных ontime в S3:
INSERT INTO FUNCTION s3('https://altinity-clickhouse-data.s3.amazonaws.com/airline/data/ontime2/2019.csv.gz', '*****', '*****', 'CSVWithNames', 'Year UInt16, <other 107 columns here>, Div5TailNum String', 'gzip') SELECT *
FROM ontime_ref
WHERE Year = 2019

Ok.

0 rows in set. Elapsed: 43.314 sec. Processed 7.42 million rows, 5.41 GB (171.35 thousand rows/s., 124.93 MB/s.)
Загрузка происходит довольно медленно, поскольку мы не можем воспользоваться параллелизмом. ClickHouse не может автоматически разбивать данные на несколько файлов, поэтому за один раз можно загрузить только один файл. Кроме того, немного раздражает то, что ClickHouse требует предоставить структуру таблицы в табличную функцию S3. Это будет учтено при разработке новых версий системы.
Архитектура хранилища данных ClickHouse
Функция таблиц S3 – это достаточно удобный инструмент для экспорта или импорта данных, но его нельзя использовать для серьезных рабочих нагрузках вставки/выбора. В этом случае необходима более тесная интеграция с системой хранения ClickHouse. Давайте подробнее рассмотрим архитектуру системы хранения ClickHouse.
ClickHouse предоставляет несколько уровней абстракции:
- Политики хранения определяют, какие тома можно использовать и как данные мигрируют из одного тома в другой;
- Тома позволяют объединить несколько diskов;
- disk представляет собой физическое устройство или точку монтирования.
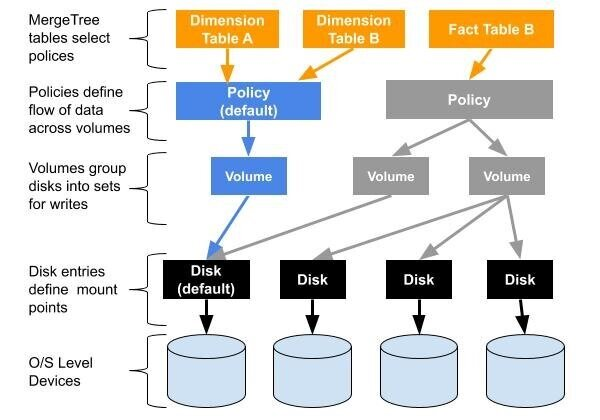
Когда этот проект архитектуры хранилища была реализован впервые (это было в начале 2019 года), ClickHouse поддерживал только один тип. Несколько месяцев спустя команда разработчиков ClickHouse добавила дополнительный уровень абстракции внутри самого диска, который позволял подключать диски разных типов. Основанием для такого решения послужила интеграция объектного хранилища. Вскоре после этого был добавлен новый тип диска S3. Он инкапсулировал специфику взаимодействия с S3-совместимым объектным хранилищем. Теперь мы можем настраивать S3-диски в ClickHouse и хранить все или некоторые данные в объектном хранилище.
Настройка объектного хранилища
Диски, тома и политики хранения можно определить в основном файле конфигурации ClickHouse config.xml или, что еще лучше, в пользовательском файле в папке /etc/clickhouse-server/config.d. Для начала определим диск S3:
config.d/storage.xml:
<yandex>
  <storage_configuration>
    <disks>
      <s3>
        <type>s3</type>
        <endpoint>http://s3.us-east-1.amazonaws.com/altinity/taxi9/data/</endpoint>
        <access_key_id>*****</access_key_id>
        <secret_access_key>*****</secret_access_key>
      </s3>

  </disks>
...
</yandex>
Это базовая конфигурация. В целом, ClickHouse поддерживает довольно много различных конфигураций, некоторые из которых мы обсудим чуть позже.
После того, как мы настроили S3-диск, мы можем использовать его для настройки томов и политик хранения:
- Том S3 в политике рядом с другими томами. Его можно использовать для TTL или ручного перемещения разделов таблицы.
- Том S3 в политике без других томов. Это подход актуален исключительно для S3.
<yandex>
  <storage_configuration>
...
    <policies>
      <tiered>
        <volumes>
          <default>
            <disk>default</disk>
          </default>
          <s3>
            <disk>s3</disk>
          </s3>
        </volumes>
      </tiered>
      <s3only>
        <volumes>
          <s3>
            <disk>s3</disk>
          </s3>
        </volumes>
      </s3only>
    </policies>
  </storage_configuration>
</yandex>
Теперь давайте попробуем создать несколько таблиц и переместить в них данные.
Добавление данных
В нашем примере мы будем использовать набор данных ontime. Вы можете загрузить его из Руководства по работе с ClickHouse или из бакета Altinity S3. Таблица содержит 193 М строк и 109 столбцов - поэтому интересно посмотреть, как она работает с S3, где файловые операции достаточно дорогие. Имя ссылочной таблицы - ontime_ref, она использует стандартный том EBS. Теперь мы можем использовать ее в качестве шаблона для наших экспериментов с S3.
CREATE TABLE ontime_tiered AS ontime_ref
ENGINE = MergeTree
PARTITION BY Year
ORDER BY (Carrier, FlightDate)
TTL toStartOfYear(FlightDate) + interval 3 year to volume 's3'
SETTINGS storage_policy = 'tiered';

CREATE TABLE ontime_s3 AS ontime_ref
ENGINE = MergeTree
PARTITION BY Year
ORDER BY (Carrier, FlightDate)
SETTINGS storage_policy = 's3only';
Таблица ontime_tiered настроена на хранение данных, накопленных за за полные 3 года в блочном хранилище, а также на перемещение более ранних данных в S3. ontime_s3 - это таблица, предназначенная исключительно для S3.
Теперь давайте вставим данные. В нашей ссылочной таблице есть данные вплоть до 31 марта 2020 года.
INSERT INTO ontime_tiered SELECT * from ontime_ref WHERE Year=2020;

0 rows in set. Elapsed: 0.634 sec. Processed 1.83 million rows, 1.33 GB (2.89 million rows/s., 2.11 GB/s.)
Вставка произошла практически мгновенно. Данные по-прежнему поступают на обычный диск. А что насчет таблицы S3?
INSERT INTO ontime_s3 SELECT * from ontime_ref WHERE Year=2020;

0 rows in set. Elapsed: 15.228 sec. Processed 1.83 million rows, 1.33 GB (120.16 thousand rows/s., 87.59 MB/s.)
Для вставки того же количества строк требуется в 25 раз больше времени!
INSERT INTO ontime_tiered SELECT * from ontime_ref WHERE Year=2015;

0 rows in set. Elapsed: 16.701 sec. Processed 7.21 million rows, 5.26 GB (431.92 thousand rows/s., 314.89 MB/s.)


INSERT INTO ontime_s3 SELECT * from ontime_ref WHERE Year=2015;

0 rows in set. Elapsed: 15.098 sec. Processed 7.21 million rows, 5.26 GB (477.78 thousand rows/s., 348.33 MB/s.)
Как только данные поступают в таблицу S3, начинает снижаться производительность insert. Это, конечно, совсем нежелательно для многоуровневой таблицы, поэтому существует специальная настройка уровня тома, которая полностью отключает ttl для insert и запускает его только в фоновом режиме. Вот как это можно настроить::
<policies>
  <tiered>
    <volumes>
      <default>
        <disk>default</disk>
      </default>
      <s3>
        <disk>s3</disk>
        <perform_ttl_move_on_insert>0</perform_ttl_move_on_insert>
      </s3>
    </volumes>
  </tiered>
При такой настройке insert всегда будет выполняться на первом диск в рамках политики хранения.ttl перемещается на соответствующий том и выполняется в фоновом режиме. Теперь давайте очистим таблицу ontime_tiered и выполним полную вставку таблицы (NB: усечение занимает много времени).
INSERT INTO ontime_tiered SELECT * from ontime_ref;

0 rows in set. Elapsed: 32.403 sec. Processed 194.39 million rows, 141.25 GB (6.00 million rows/s., 4.36 GB/s.)
Операция прошла довольно быстро, поскольку все данные были помещены на быстрый диск. Теперь мы можем проверить, как данные расположены в хранилище:
select disk_name, part_type, sum(rows), sum(bytes_on_disk), uniq(partition), count() from system.parts where active and database='ontime' and table='ontime_tiered' group by table, disk_name, part_type order by table, disk_name, part_type;

┌─disk_name─┬─part_type─┬─sum(rows)─┬─sum(bytes_on_disk)─┬─uniq(partition)─┬─count()─┐
│ default   │ Wide      │  16465330 │         1348328157 │               3 │       8 │
│ s3        │ Compact   │      8192 │             678411 │               1 │       1 │
│ s3        │ Wide      │ 177912114 │        12736193777 │              31 │     147 │
└───────────┴───────────┴───────────┴────────────────────┴─────────────────┴─────────┘
Таким образом, данные были перемещены в S3 фоновым процессом. Только 10 % данных хранятся на локальной файловой системе, а все остальное было перемещено в объектное хранилище. Похоже, это действенный способ работы с дисками S3, поэтому в дальнейшем мы будем использовать ontime_tiered.
Обратите внимание на столбец part_type. Таблица MergeTree может данные в разных форматах. Формат wide используется по умолчанию, он оптимизирован для обеспечения производительности запросов. Однако он требует не менее 2 файлов на 1 столбец. Таблица ontime содержит 109 столбцов или 227 файлов в каждой части. Это является основной причиной низкой производительности S3 при выполнении операций INSERT и DELETE.
С другой стороны, части compact хранят все данные в 1 файле, поэтому вставка данных происходит гораздо быстрее (мы проверяли), но при этом страдает производительность запросов. Поэтому ClickHouse использует их только для небольших частей. По умолчанию порог составляет 10 МБ (см. настройки min_bytes_for_wide_part и min_rows_for_wide_part).
Проверка производительности запросов
Для проверки производительности запросов предлагаю выполнить несколько запросов для таблиц ontime_tiered и ontime_ref,запрашивающие исторические данные. Мы также выполним запрос со смешанным диапазоном для того, чтобы подтвердить возможность совместного использования данных S3 и не-S3. Далее сравним результаты с эталонной таблицей. Это даст нам общее представление о различиях в производительности запросов. Из бенчмарка были выбраны только четыре репрезентативных запроса. Полный список можно найти в официальном Руководстве по работе с ClickHouse .
/* Q4 */

SELECT
    Carrier,
    count(*)
FROM ontime_tiered
WHERE (DepDelay > 10) AND (Year = 2007)
GROUP BY Carrier
ORDER BY count(*) DESC
Для ontime_ref запрос, описанный выше, выполняется за 0.015 секунд, а для ontime_tiered - 0.318/ 0.142 секунд.
/* Q6 */

SELECT
    Carrier,
    avg(DepDelay > 10) * 100 AS c3
FROM ontime_tiered
WHERE (Year >= 2000) AND (Year <= 2008)
GROUP BY Carrier
ORDER BY c3 DESC
Для ontime_ref этот запрос выполняется за 0.063 секунд, а для ontime_tiered - за 0.766/0.518 секунд.
/* Q8 */

SELECT
    DestCityName,
    uniqExact(OriginCityName) AS u
FROM ontime_tiered
WHERE Year >= 2000 and Year <= 2010
GROUP BY DestCityName
ORDER BY u DESC
LIMIT 10
Для ontime_ref этот запрос выполняется за 0.319 секунд, а для ontime_tiered – за 1.016/0.988 секунд.
/* Q10 */

SELECT
    min(Year),
    max(Year),
    Carrier,
    count(*) AS cnt,
    sum(ArrDelayMinutes > 30) AS flights_delayed,
    round(sum(ArrDelayMinutes > 30) / count(*), 2) AS rate
FROM ontime_tiered
WHERE (DayOfWeek NOT IN (6, 7)) AND (OriginState NOT IN ('AK', 'HI', 'PR', 'VI')) AND (DestState NOT IN ('AK', 'HI', 'PR', 'VI'))
GROUP BY Carrier
HAVING (cnt > 100000) AND (max(Year) > 1990)
ORDER BY rate DESC
LIMIT 10
Для ontime_ref этот запрос выполняется за 0.436 секунд, а для ontime_tiered - за 2.493/2.241 секунд. На этот раз в одном запросе к многоуровневой таблице использовалось как блочное, так и объектное хранилище.
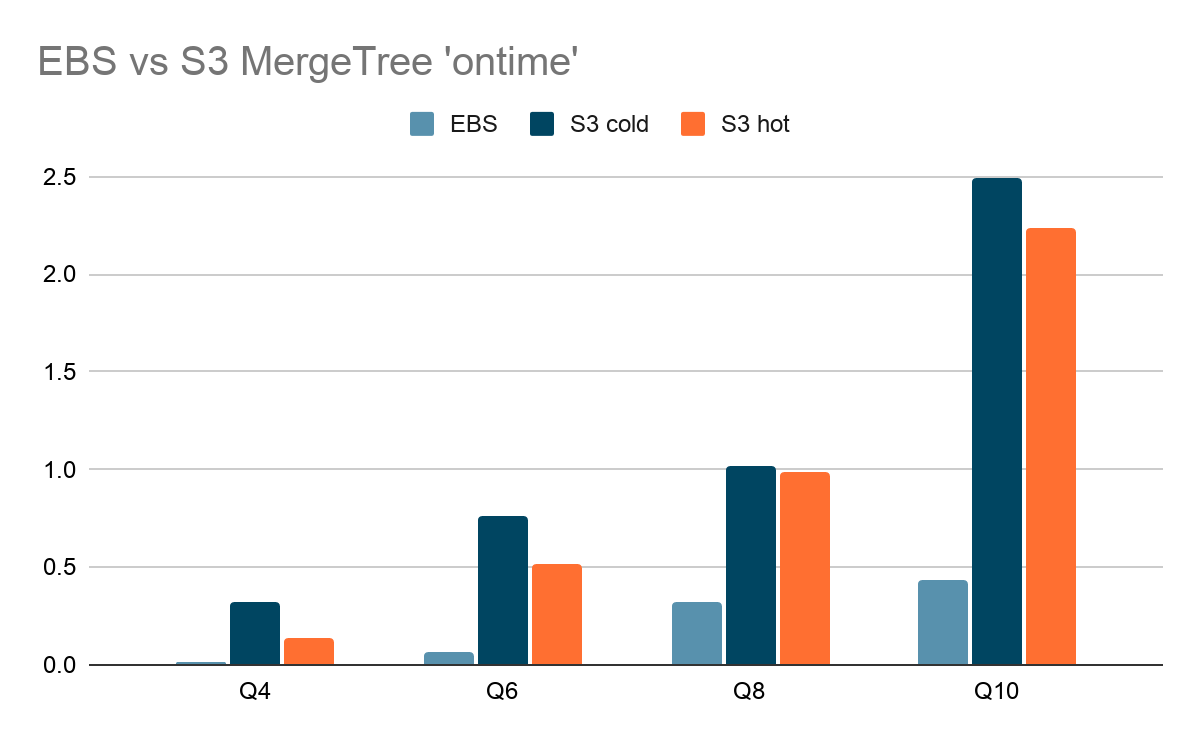
Таким образом, производительность запросов с диска S3 однозначно снижается, но она достаточна для выполнения интерактивных запросов. Обратите внимание и на улучшение производительности во время второго прогона. В то время как кэш страниц Linux не может использоваться для данных S3, ClickHouse локально кэширует индексные файлы для хранения S3, что дает заметный прирост производительности при получении данных из S3.
Попробуем набор данных посерьезнее
Давайте попробуем сравнить производительность запросов с более крупным набором данных о поездках на такси в Нью-Йорке. Теперь набор данных содержит 1,3 миллиарда строк. Как отмечалось выше, его можно загрузить из S3 с помощью табличной функции S3. Для начала создадим многоуровневую таблицу:
CREATE TABLE tripdata_tiered AS tripdata
ENGINE = MergeTree
PARTITION BY toYYYYMM(pickup_date)
ORDER BY (vendor_id, pickup_location_id, pickup_datetime)
TTL toStartOfYear(pickup_date) + interval 3 year to volume 's3'
SETTINGS storage_policy = 'tiered';
Добавим данные:
INSERT INTO tripdata_tiered SELECT * FROM tripdata

0 rows in set. Elapsed: 52.679 sec. Processed 1.31 billion rows, 167.40 GB (24.88 million rows/s., 3.18 GB/s.)
Это произошло практически мгновенно благодаря производительности хранилища EBS. Теперь давайте рассмотрим размещение данных:
select disk_name, part_type, sum(rows), sum(bytes_on_disk), uniq(partition), count() from system.parts where active and table='tripdata_tiered' group by table, disk_name, part_type order by table, disk_name, part_type;

┌─disk_name─┬─part_type─┬──sum(rows)─┬─sum(bytes_on_disk)─┬─uniq(partition)─┬─count()─┐
│ s3        │ Compact   │     235509 │            6933518 │               8 │       8 │
│ s3        │ Wide      │ 1310668454 │        37571786040 │              96 │     861 │
└───────────┴───────────┴────────────┴────────────────────┴─────────────────┴─────────┘
Судя по всему, самые последние данные, содержащаяся в нашем наборе данных, датируются 31 декабря 2016 года, так что все наши данные отправятся в S3. При этом мы видим достаточно много частей, поэтому ClickHouse потребуется некоторое время, чтобы объединить их. Если проверить тот же запрос через 10 минут, количество частей уменьшится до трех-четырех на партицию. Чтобы узнать не только производительность S3, но и влияние количества частей, запустим эталонные запросы дважды: первый раз с 441 частью в таблице S3, а второй - с оптимизированной таблицей, которая содержит только 96 частей после OPTIMIZE FINAL. Обратите внимание на то, что OPTIMIZE FINAL работает с таблицей S3 очень медленно; для завершения нашей настройки потребовалось около 1 часа.
На графике ниже представлено сравнение 3 лучших результата трех запусков для пяти тестовых запросов:
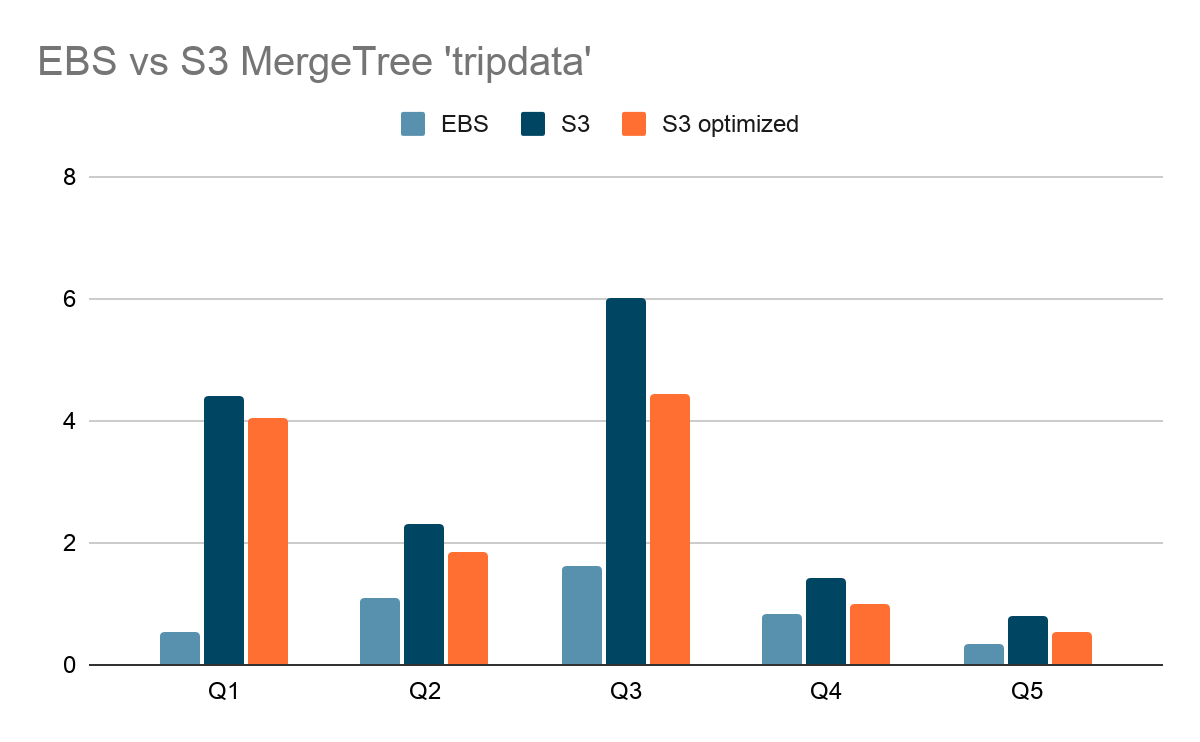
Как видите, разница в производительности запросов между EBS и S3 MergeTree не столь существенна по сравнению с меньшим набором данных ontime, при этом она уменьшается по мере увеличения сложности запросов.
А что там под капотом?
Изначальная архитектура ClickHouse не предусматривала объектное хранилище. Поэтому в систем очень часто используются некоторые специфические для блокчейн-хранилищ функции, например жесткие ссылки. Как же работает для хранилища S3? Для ответа на этот вопрос давайте посмотрим на каталог данных ClickHouse.
В случае таблиц, отличных от, ClickHouse хранит части данных в /var/lib/clickhouse/data/<database>/<table>.
В случае S3 таблиц данные хранятся здесь:/var/lib/clickhouse/disks/s3/data/<database>/<table>. (расположение может быть настроено на уровне диска):
#/ cat /var/lib/clickouse/disks/s3/data/ontime/ontime_tiered/1987_123_123_0/ActualElapsedTime.bin

1 530583
530583 lhtilryzjomwwpcbisxxqfjgrclmhcnq
Это не сами данные, это ссылка на файл S3. Мы можем найти соответствующий объект S3, заглянув в консоль AWS:
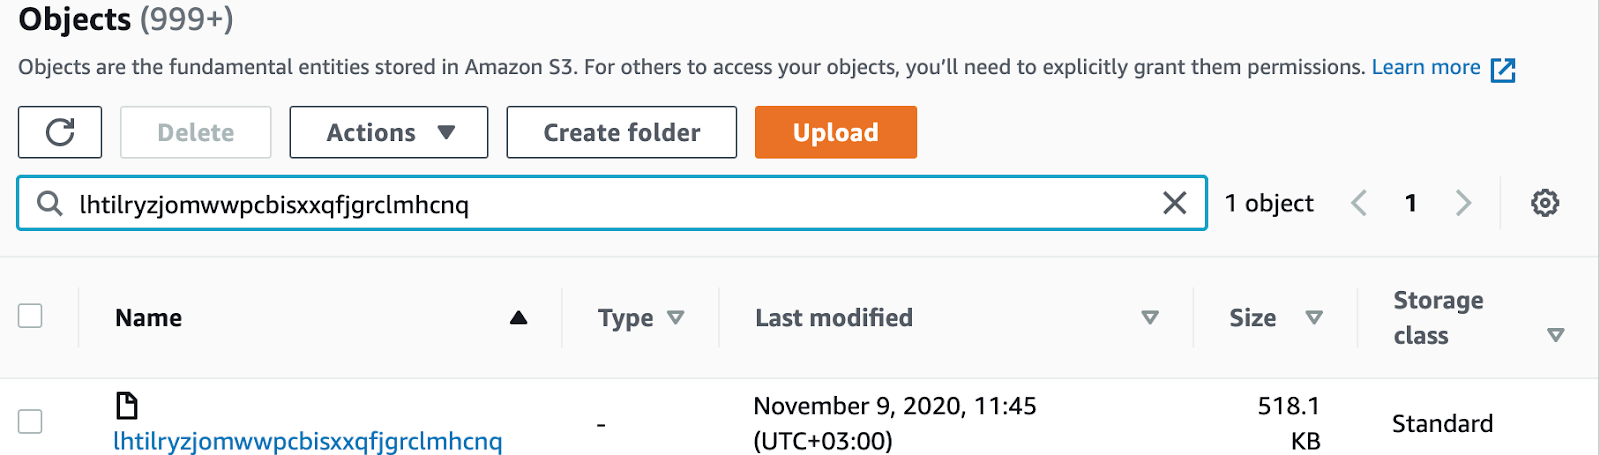
Для каждого столбца ClickHouse генерирует уникальные файлы, хэширует их имена и хранит ссылки в локальной файловой системе. Операции слияния или переименования, требующие жестких ссылок в блочном хранилище, реализуются на уровне ссылок, данные S3 не затрагиваются от слова совсем. Безусловно, такой подход решает множество проблем, но при этом создает еще одну: все файлы для всех столбцов всех таблиц хранятся с одним префиксом.
Слабые места и ограничения
S3 хранилище для таблиц MergeTree до сих является экспериментальным. У него есть несколько недостатков, которые должны быть скоректированы в самое ближайшее время. Одно из основных ограничений – это репликация. Предполагается, что объектное хранилище уже реплицируется облачным провайдером, поэтому нет необходимости использовать репликацию ClickHouse и хранить несколько копий данных. ClickHouse должен быть достаточно умным, чтобы не реплицировать таблицы S3. Это становится еще сложнее, если таблица использует многоуровневое хранение.
Еще один недостаток - производительность вставки и слияния. Часть оптимизаций, например, параллельная загрузка нескольких частей, уже реализована. Многоуровневые таблицы можно использовать для быстрой локальной вставки, но мы не можем изменить законы физики – процесс слияния может быть довольно медленным. Однако на практике ClickHouse будет выполнять большинство слияний на быстрых дисках до того, как данные попадут в объектное хранилище. Также есть настройка, позволяющая полностью отключить слияние в объектном хранилище, чтобы защитить исторические данные от ненужных изменений.
Структура данных в объектном хранилище также нуждается в оптимизации. В частности, если бы каждая таблица имела отдельный префикс, можно было бы перемещать таблицы из одного места в другое. Добавление метаданных позволило бы восстановить таблицу из копии объектного хранилища, если все остальное было утеряно.
Еще одна проблема связана с безопасностью данных. В приведенных выше примерах нам приходилось указывать ключи доступа к AWS в конфигурации SQL или хранилища ClickHouse. Это крайне неудобно, не говоря уже о безопасности данных. Есть два варианта, которые облегчают жизнь пользователям. Во-первых, можно предоставлять учетные данные или заголовок авторизации на уровне конфигурации сервера, например:
<yandex>
    <s3>
       <my_endpoint>
           <endpoint>https://my-endpoint-url</endpoint>
           <access_key_id>ACCESS_KEY_ID</access_key_id>
           <secret_access_key>SECRET_ACCESS_KEY</secret_access_key>
           <header>Authorization: Bearer TOKEN</header>
       </my_endpoint>
   </s3>
</yandex>
Во-вторых, поддержка ролей IAM находится в разработке. Когда она будет реализована, управление доступом будет передано администраторам учетных записей AWS.
Все эти ограничения учтены в текущих разработках, в самое ближайшее время мы планируем оптимизировать процесс реализации MergeTree S3.
Заключение
ClickHouse постоянно адаптируется к потребностям пользователей. Многие функции создаются на основе отзывов сообщества, и поддержка объектных хранилищ - не исключение. Эта функция является одной из самых востребованных, поэтому к разработке адекватного решения приступили специалисты команд Yandex.Cloud и Altinity.Cloud. Хотя на данный момент оно все еще несовершенно, но уже сейчас значительно расширяет возможности ClickHouse. Оптимизация и совершенствование системы – процесс постоянный, каждая новая функция способствует тому, чтобы ClickHouse всегда оставался на плаву и не терял лидерских позиций в своей отрасли.


