

Прокачайте свои навыки работы с Big Data: расширенные возможности исследования данных с помощью GreenplumPython 1.1.0 + расширенный поиск по эмбеддингам в PostgreSQL и Greenplum
Открываем новые горизонты анализа данных с помощью расширенного поиска по эмбеддингам
GreenplumPython, Python API, позволяет пользователям обрабатывать большие объемы данных, от терабайт до петабайт, в базах данных Greenplum/PostgreSQL с помощью Python данных, не прибегая к экспорту данных на локальные машины. Данное решение было выпущено в качестве первой версии GA в феврале 2023 года.

Основы GreenplumPython
Эта библиотека Python позволяет Data Scientistам писать код в привычном для них стиле Pythonic. Она в разы упрощает процесс преобразования данных, обучения моделей машинного обучения и интерактивного анализа больших наборов данных - и все это происходит в рамках безопасной и надежной платформы Greenplum.
Эволюция до версии 1.1.0: поиск по эмбеддингам
Перенесемся в 5 января 2024 года, ведь именно тогда в релизе GreenplumPython 1.1.0 впервые появилась инновационная функция - поиск по эмбеддингам. Эмбеддинги, генерируюемые моделями искусственного интеллекта, обеспечивают компактное и осмысленное представление объектов в числовом векторном пространстве и отражают семантические отношения между объектами.
В быстро развивающейся сфере искусственного интеллекта и машинного обучения эмбеддинги играют очень важную роль, так как помогают эффективно извлекать из данных значимую информацию, необходимую для понимания закономерностей, корреляций данных и глубинных структур. Управление эмбеддингами оказалось довольно сложной задачей, но это просто необходимо для перехода на качественно новый уровень работы с данными.
Важность поиска по эмбеддингам
GreenplumPython 1.1.0 решает проблему управления эмбеддингами с помощью расширения pgvector. С этой новой функцией изучение неструктурированных данных в базе данных становится не только доступной, но и неотъемлемой частью процесса изучения данных.
Давайте разберемся в том, как же работает эта новая функция и почему она выводит GreenplumPython на лидерские позиции в области интеллектуального исследования данных.
NB: Функция, представленная в этом руководстве, в настоящее время является экспериментальной и не дает никаких гарантий стабильной работы API.
Установка пакета
Установите самую последнюю версию GreenplumPython:
python3 -m pip install --upgrade greenplum-python
Подключение к БД
После установки GreenplumPython необходимо установить подключение к Greenplum.
import greenplumpython as gp
db = gp.database(uri="postgres://localhost:7000")
Исследование набора данных
В этой статье мы будем использовать набор данных wikimedia, содержащих копию википроектов Wikimedia в виде викитекста и метаданных в XML. Этот набор данных хранится в таблице wiki_small, которая содержит 6 столбцов (pub_date, label, id,category_id, title и body),
wiki = db.create_dataframe("wiki_small")
wiki.order_by("id", ascending=False)[:2]
и 100 000 строк.
import greenplumython.builtins.functions as F
wiki.apply(lambda _: F.count())

Для повышения эффективности сгенерированные вкрапления хранятся в ориентированном на столбцы подходе, т. е. отдельно от входного DataFrame. Входной DataFrame должен иметь уникальный ключ для идентификации кортежей в результатах поиска. Поэтому перед созданием индекса вкраплений необходимо сохранить DataFrame в базе данных и проверить, что DataFrame имеет уникальный ключ.
wiki = wiki.check_unique(columns={"id"})
Генерация эмбеддинов и индексирование
После проверки уникального ключа мы можем создать индекс встраивания тела столбца, используя модель all-MiniLM-L6-v2 от HuggingFace с новым модулем встраивания. Расширение pgvector теперь поддерживает два типа индексов, HNSW и IVFFLAT. Тип индекса по умолчанию - HNSW, но мы можем изменить его на IVFFLAT, указав method=«ivfflat»:
import greenplumpython.experimental.embedding

wiki = wiki.embedding().create_index(column="body", model_name="all-MiniLM-L6-v2")
wiki.order_by("id", ascending=False)[:2]
Семантический поиск по эмбеддингам
С помощью индекса мы можем осуществлять поиск на основе семантического сходства:
wiki.embedding().search(column="body", query="artificial intelligence", top_k=1)
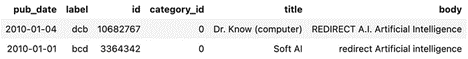
Это очень эффективный способ, поскольку нам не нужно сканировать все данные.
Генерация эмбеддингов без индексирования
Если мы хотим просто сгенерировать эмбеддинги без создания векторного индекса, мы можем использовать функцию create_embedding() из модуля embedding:
from greenplumpython.experimental.embedding import create_embedding
Поскольку мы не индексируем векторы, DataFrame не нужно хранить в базе данных в виде таблицы. И нам не нужно указывать уникальный ключ в случае, если эмбеддинги находятся в одном датафрейме.
Более того, если мы хотим сохранить эмбеддинги в виде векторного типа с размерностью эмбеддинга, чтобы впоследствии их можно было индексировать, нам нужно привести результат к типу gp.type_(«vector», modifier=<embedding_dimension>).
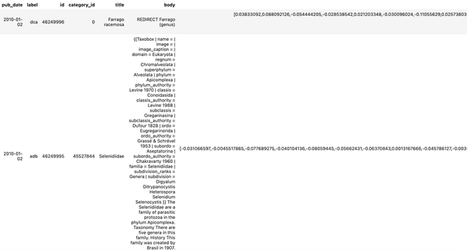
wiki.order_by("id", ascending=False)[:2].assign(
    embedding_col=lambda t: (
        gp.type_("vector", modifier=384)(create_embedding(t["body"], "all-MiniLM-L6-v2"))
    ),
)
Единовременная полная очистка
Для удобства управления комбинация индекса и базовой таблицы записывается в базу данных.
Попытка уничтожить только базовую таблицу будет неудачной:
%reload_ext sql
%sql postgresql://localhost:7000
%sql DROP TABLE wiki_small
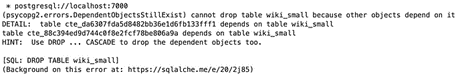
Чтобы уничтожить базовую таблицу, нам также нужно уничтожить и индекс. Этого можно добиться с помощью CASCADE:
%%sql
DROP TABLE wiki_small CASCADE;

SELECT oid, relname
FROM gp_dist_random('pg_class')
WHERE relname = 'cte_88c394ed9d744c0f8e2fcf78be806a9a';
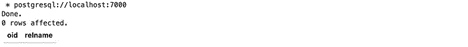
Как видите, после DROP CASCADE индекс также удаляется для всех сегментов.
Заключение
В этой статье мы показали Вам, как специалисты по изучению данных могут использовать GreenplumPython для управления генерацией и поиском эмбеддингов непосредственно в Greenplum с помощью простых команд на языке Python. Это выгодно и удобно для специалистов, которые хотят изучать большие объемы неструктурированных данных и использовать Greenplum в качестве векторной базы данных. Кроме того, это обеспечивает большую гибкость в управлении развертыванием и использованием моделей с открытым исходным кодом в Greenplum.


