

Введение в Greenplum
В этой статье я расскажу о Greenplum, БД на базе PostgreSQL. По ряду причин она не очень известна на рынке MPP-баз данных, по крайней мере в Европе (подробнее о причинах мы поговорим позже). В этой статье я хотел бы поговорить об этой СУБД, ее истории, уникальных особенностях и причинах, по которым она заслуживает нашего с Вами внимания.
Общая информация
Greenplum - это распределенная база данных с открытым исходным кодом, предназначенная для массивно-параллельной обработки данных (MPP), разработанная компанией Pivotal Software, которая впоследствии сначала была приобретена компанией Dell, а затем - VMware. База данных была выпущена в 2005 году.
Это open-source решение, имеющее огромное количество поклонников.
Изначально оно было разработано для хранилищ данных, которые предполагают хранение и поиск больших объемов данных, но в дальнейшем оно стало поддерживать и аналитику больших данных, машинное обучение и другие приложения, требующие высокоскоростной обработки больших массивов данных.

В каких случаях Greenplum незаменима
База данных предназначена для аналитических нагрузок при работе с огромными объемами данных, я бы сказал, больше 1 ТБ. Почему именно 1 ТБ? Да потому, что начиная с именно с этой отметки использование MPP становится наиболее эффективно с точки зрения производительности/стоимости, если сравнивать с классическими СУБД.
Кроме того, Greenplum незаменима в том случае, если у Вас уже есть хранилище данных на базе традиционной СУБД, например Oracle или Postgres, но пользователи регулярно жалуются на медленную обработку запросов/отчетов. Особенно если Вам нужно хранить большие объемы данных, но Вы еще не знаете, как именно весь этот объем будет использоваться.
Общая архитектура
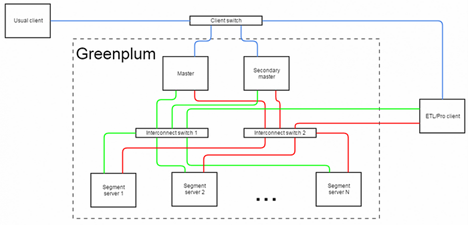
Прежде чем подробно описывать архитектуру, давайте познакомимся с некоторыми основными понятиями:
- Мастер - экземпляр (он же «мастер») - экземпляр Postgres, который является координатором и точкой входа для пользователей в кластер.
- Мастер-хост («мастер-сервер») - сервер, на котором запущен мастер-экземпляр.
- Вторичный мастер-экземпляр - экземпляр Postgres, который является резервным мастером; активируется в случае недоступности основного мастера.
- Экземпляр первичного сегмента («сегмент») - экземпляр Postgres, который хранит данные, выполняет над ними операции и возвращает результаты мастеру. Фактически, сегмент - это экземпляр PostgreSQL с настроенной WAL-репликацией на другом сервере.
- Хост сегмента («сервер сегмента») - сервер, на котором работает один или несколько сегментов и/или зеркал.
Как правило, кластер GP состоит из нескольких серверов-сегментов, одного мастер-сервера и одного зеркального сервера, соединенных одной или несколькими быстрыми сетями, как правило, взаимосвязанными.
При выборе количества серверов-сегментов важно правильно подобрать соотношение «количество процессоров/ТБ данных» в зависимости от планируемого профиля нагрузки на базу данных - чем больше процессорных ядер на единицу данных, тем быстрее кластер будет выполнять тяжелые операции, а также эффективнее работать со сжатыми таблицами.
При выборе количества сегментов в кластере (которое в общем случае не привязано к количеству серверов) следует помнить следующее:
- Все ресурсы сервера делятся между всеми сегментами на сервере (нагрузкой зеркал, если они расположены на одних и тех же серверах, можно условно пренебречь);
- Каждый запрос в одном сегменте не может потреблять больше ресурсов процессора, чем одно процессорное ядро. Это означает, что если, к примеру, кластер состоит из 32-ядерных серверов с 4 GP-сегментами на борту и используется в среднем для обработки 3-4 одновременных тяжелых CPU-запросов, то CPU в среднем будет использоваться не оптимально. В такой ситуации лучше увеличить количество сегментов на сервере до 6-8 штук;
- Кластер работает со скоростью самого медленного сервера, поэтому следует выбирать однородные серверы и равномерно распределять данные между ними. Иногда один или несколько медленных серверов, подключенных к кластеру, могут привести к резкому падению производительности кластера. Это происходит потому, что мастер - узел должен дождаться ответа от всех сегментов и только после этого отправить ответ.
Хранение
Greenplum реализует классическую архитектуру шардинга данных: каждая таблица представляет N+1 таблиц на всех сегментах кластера, где N - количество сегментов (+1 в данном случае - это таблица на мастере, в ней нет данных). На каждом сегменте хранится 1/N строк таблицы. Логика разбиения таблицы на сегменты задается ключом распределения (полем), так что любая строка может быть отнесена к одному из сегментов.
Ключ распределения - очень важная концепция, хотя она и схожа с другими распределенными базами данных MPP. Как уже упоминалось выше, Greenplum работает со скоростью самого медленного сегмента, а это значит, что любой перекос в объеме данных (как внутри одной таблицы, так и во всей базе данных) между сегментами приводит к снижению производительности кластера. Именно поэтому следует тщательно выбирать поле для распределения - количество вхождений значений в него должно быть как можно более равномерным. О том, правильно ли вы выбрали ключ распределения, подскажет служебное поле gp_segment_id, которое есть в каждой таблице - оно содержит номер сегмента, на котором хранится конкретная строка.
Если в таблице нет подходящих полей для использования в качестве ключа распределения, можно применить случайное распределение.
Greenplum выполняет наиболее оптимальные JOIN между ключами распределения: если столбцы, по которым выполняется JOIN, являются ключами распределения в обеих таблицах, то JOIN выполняется локально на сегменте. Если это условие не верно, то GP придется либо перераспределить обе таблицы по нужному полю, либо полностью распределить одну из таблиц по каждому сегменту (операция BROADCAST), а затем локально соединить таблицы на сегментах.
Взаимодействие с клиентами БД
Взаимодействие клиента с кластером осуществляется только через мастера, обычные клиенты-пользователи не имеют сетевого доступа к серверам сегментов.
Для ускорения загрузки данных в кластер используется массово- параллельная загрузка данных от клиентов одновременно в несколько сегментов. Обычно такими клиентами являются ETL-серверы и другие системы, которым необходимо загружать большие объемы данных (в архитектурной схеме они обозначены как ETL/Pro client).
В старых версиях Greenplum существовал специальный интеграционный протокол, более известный как «Greenplum Hadoop File System» (GPHDFS). Он позволял Greenplum напрямую обращаться к данным, хранящимся в HDFS, и запрашивать их. Однако у него был ряд ограничений в плане производительности и поддержки различных форматов данных.
С появлением PXF (Platform Extension Framework) Greenplum предложил своим пользователям одну из ключевых функций для более продвинутого и гибкого подхода к интеграции внешних источников данных, включая HDFS. PXF стал предпочтительным методом подключения Greenplum к внешним системам по нескольким причинам:
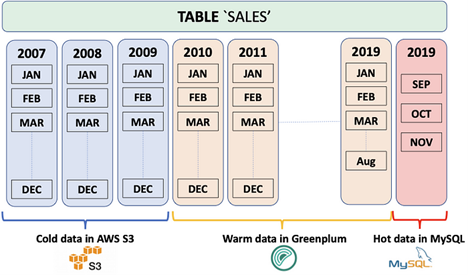
- Расширенная поддержка источников данных: В отличие от GPHDFS, PXF не ограничивается HDFS, а поддерживает более широкий спектр внешних источников данных, таких как Amazon S3, Hive, HBase, подключение через JDBC и другие. Это позволяет получать доступ и анализировать данные из самых разных систем, а не только из Hadoop.
- Гибкость форматов данных: PXF поддерживает различные форматы данных, включая структурированные, полуструктурированные и неструктурированные данные, такие как CSV, JSON, Avro, Parquet и другие, и все это в рамках одного экземпляра Greenplum.
- Параллельная обработка и производительность: PXF использует параллельную обработку для распределения задач поиска данных и запросов между несколькими сегментами Greenplum.
- Обрезка данных и вытеснение проекций: PXF оптимизирует выполнение запросов, перенося операции фильтрации и проецирования на внешний источник данных. Это минимизирует перемещение данных и улучшает время отклика запросов.
Greenplum по праву заслуживает большего внимания
Обычно при внедрении новой системы наибольшее беспокойство вызывает ее стоимость - не так уж много компаний могут позволить себе собственный дата-центр или собственное аппаратное обеспечение. Фактически, любая база данных MPP требует большого количества вычислительных ресурсов, и организации часто боятся доводить ее даже до уровня доказательства концепции только из-за начальной цены.
Однако в долгосрочной перспективе гораздо эффективнее хранить и обрабатывать данные в собственной инфраструктуре и инвестировать в собственный опыт. Конечно, это имеет смысл только при работе с большими объемами данных и постоянных высоких рабочих нагрузках.


