

От MySQL до Greenplum: уроки и выводы, извлеченные в процессе реализации задачи по миграции ETL-конвейера
Урок 1: Влияние команд DDL на базовые представления и зависимости в Greenplum
Задача: В MySQL, когда мы переименовываем определенную таблицу, это не приводит к изменению имени таблицы в представлениях, использующих эту таблицу. Однако в Greenplum, если Вы переименуете таблицу, все соответствующие представления также будут отражать обновленное имя таблицы. Это означает, что если Вам нужно создать новую таблицу с тем же именем, что и раньше, но с другой структурой, Вам придется либо сбросить текущее представление, либо использовать оператор CREATE или REPLACE VIEW для создания представления, использующего таблицу с новой структурой.
Причина этого различия заключается в том, как каждая база данных поддерживает целостность структуры базы данных и управляет зависимостями между таблицами и представлениями. MySQL позволяет более гибко управлять представлениями, рассматривая представление и связанные с ним таблицы как отдельные сущности. При этом Greenplum автоматически обновляет изменения в названиях таблиц в представлениях для поддержания согласованности, что позволяет избежать возможных проблем с тем, что представления становятся недействительными, когда ссылаются на несуществующие таблицы.

То же самое происходит, когда Вам нужно уничтожить таблицу. В MySQL действие по удалению таблицы не зависит от представлений, связанных с этой таблицей. Однако в Greenplum вы не можете уничтожить таблицу, пока существуют зависимые представления для этой таблицы. Вам придется сначала удалить представления, а затем удалить таблицу, чтобы обеспечить правильное удаление.
Урок 2: Обработка агрегированных запросов: MySQL vs Greenplum
Задача: MySQL позволяет группировать данные без явного включения всех неагрегированных столбцов, в то время как Greenplum DB требует, чтобы все неагрегированные столбцы были включены в предложение GROUP BY. Неправильно структурированный запрос может привести к ошибкам в Greenplum.
Предположим, у нас есть таблица Sales, содержащая данные о продаже трех различных продуктов:
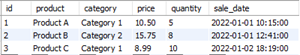
Расшифровка каждого столбца:
- id: идентификационной номер каждой строки
- product: наименование товара
- category: идентификатор категории, к которой принадлежит каждый товар.
- price: цена за единицу товара
- quantity: количество приобретенного товара.
- sale_date : дата и время транзакции
Предположим, мы хотим найти общую выручку от продаж по каждому продукту.
В Greenplum DB мы можем использовать следующий запрос:
SELECT product,
SUM(price * quantity) AS total_revenue
FROM sales
GROUP BY product;
Приведенный выше запрос не только дает ожидаемый результат, но и является логически корректным.
Однако в MySQL есть режим несоответствия, который при активном состоянии позволяет включать в оператор SELECT столбцы, не являющиеся частью предложения GROUP BY или агрегатной функции. Например:
SELECT product, category, SUM(price * quantity) AS total_revenue
FROM sales
GROUP BY product;
В MySQL этот запрос выполнится без ошибок и даст нужный нам результат, но столбец «category», который не является частью предложения GROUP BY, не обязательно будет представлять правильную категорию продукта. Добавление в таблицу-1 записей из всех категорий для каждого товара приведет к тому, что в столбце «category» для каждого товара будет указано случайное название категории.
Eсли мы попытаемся написать запрос, используя аналогичный подход к Greenplum, мы получим следующую ошибку:

Причина в том, что в Greenplum мы не можем группировать таким же образом. Это вынуждает пользователя следовать практике SQL-совместимости и использовать все неагрегированные столбцы из запроса в предложении GROUP BY.
Урок 3: Навигация по различиям в функциональности: Отсутствие общих функций MySQL в Greenplum
Задача: Функции, которые очень часто встречаются в MySQL, к сожалению, недоступны в Greenplum. Например, очень распространенной функцией, которая постоянно используется в MySQL, является DATEDIFF(date1, date2), которая возвращает количество дней между двумя значениями даты. Оказалось, что в Greenplum DB аналогичной функции нет.
В качестве обходного пути можно воспользоваться практикой создания собственных пользовательских функций с логикой, лежащей в основе встроенной функции MySQL, которую мы использовали ранее. Вот пример пользовательской функции для функцииDATEDIFF() из MySQL для Greenplum:
CREATE OR REPLACE FUNCTION my_schema.datediff($1 timestamp,$2 timestamp)
RETURNS int4
LANGUAGE sql
VOLATILE
AS $$
SELECT CAST($1 AS date) - CAST($2 AS date) as DateDifference
$$
EXECUTE ON ANY;
Урок 4: Назначение прав на новые таблицы
Задача: Допустим, у нас есть пользователь A и пользователь B. В MySQL, пока оба пользователя имеют доступ к определенной схеме, они могут получить доступ к таблице, созданной другим пользователем. Однако в GreenplumDB, если пользователь A создает таблицу, ему необходимо индивидуально назначить права CRUD на имя пользователя USER B для предоставления ему доступа.
Причина в том, что Greenplum следует принципу наименьших привилегий, она не назначает автоматически другим пользователям права CRUD (Create, Read, Update, Delete) для таблицы, созданной конкретным пользователем. Такой подход обеспечивает более жесткий контроль над доступом к данным. В отличие от этого, когда пользователь создает таблицу в MySQL, по умолчанию все остальные пользователи имеют доступ к этой таблице в рамках той же схемы. Это происходит потому, что MySQL предоставляет необходимые привилегии всем аутентифицированным пользователям по умолчанию.
Урок 5: Упрощенная фильтрация / дедупликация в Greenplum: использование оконных функций для более эффективной очистки данных
Хотя с момента появления оконных функций в MySQL прошло уже пять лет, если Вы переходите с версии MySQL 5.7 или более ранеей версии, Вы будете приятно удивлены тем, что такие шаги по очистке данных, как дедупликация, могут быть легко выполнены с помощью методологии row_number в нескольких строках кода в Greenplum по сравнению с ручными методами в MySQL.
Давайте рассмотрим пример, обратившись к таблице Sales (на этот раз с большим количеством записей):
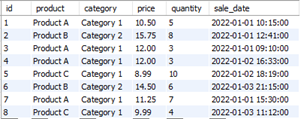
Просматривая данные, мы видим, что у нас есть несколько продаж продукта A на дату 2022-01-01. Допустим, мы хотим просмотреть только последнюю продажу для каждого продукта на определенную дату. В MySQL нам придется реализовать технику номеров строк вручную с помощью определенных пользователем переменных, таких как:
-- шаг 1: инициализация переменных
SET @rown := 0, @rk1 := '', @rk2 :='';

-- шаг 2: создание временной таблицы для хранения дедуплицированных данных
DROP TEMPORARY TABLE IF EXISTS my_schema.dedup_data;
CREATE TEMPORARY TABLE IF NOT EXISTS my_schema.dedup_data
SELECT *,
       @rown := CASE WHEN @rk1 = product AND @rk2 = DATE(sale_date) THEN @rown + 1 ELSE 1 END AS rownum,
       @rk1 := product AS dummy_rn1,
       @rk2 := sale_date AS dummy_rn2
FROM my_schema.sales
ORDER BY product, sale_date DESC;

-- шаг 3: Очистка таблицы от неактуальных столбцов и записей
DELETE FROM dedup_data
WHERE rownum > 1;

ALTER TABLE my_schema.dedup_data
DROP COLUMN dummy_rk1,
DROP COLUMN dummy_rk2;

-- шаг 4: выборка дедуплицированных данных
SELECT *
FROM my_schema.dedup_data;
В отличие от этого, в Greenplum тот же самый процесс занимает всего несколько строк кода с использованием оконной функции ROW_NUMBER():
CREATE TEMPORARY TABLE IF NOT EXISTS gp_dedup_data AS (
    WITH cte_data AS (
        SELECT *,
        ROW_NUMBER() OVER (PARTITION BY product, DATE(sale_date) ORDER BY sale_date DESC) AS rn
        FROM sales
    )
    SELECT *
    FROM cte_data
    WHERE rn = 1
);

SELECT *
FROM gp_dedup_data;
Урок 6: Скрытый нюанс: преобразования времени в MySQL и Greenplum
В MySQL столбец datetime может непреднамеренно получить фиктивную дату при вставке в него значения, относящегося только ко времени, без возникновения ошибки. Это приводит к тому, что значение ассоциируется со строкой даты по умолчанию «01-01-1970».
Однако в Greenplum загрузка таких данных не позволяет выполнить неявное преобразование, поскольку принудительно проверяется достоверность значения времени.
Для решения этой проблемы существует обходной путь, заключающийся в конкатенации фиктивной даты со значением времени и использовании функции Greenplum to_timestamp() для преобразования конкатенированной строки в действительное значение времени.
Эти различия требуют особого внимания и должны быть учтены в процессе миграции базы данных.


