

Greenplum для Data Science: Масштабируемое ML и NLP в базе данных с помощью PL/Python
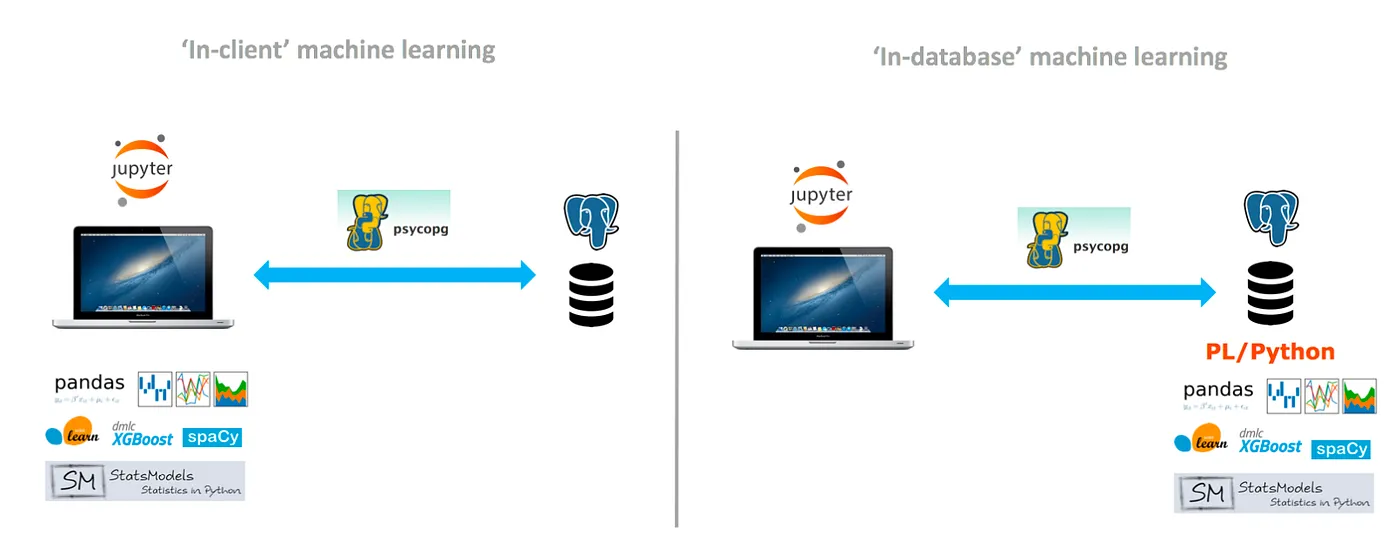
На рисунке ниже показана крайне важная смена парадигмы при обучении и выводе ML-моделей на больших массивах данных.
- In-Client машинное обучение требует перемещения данных из источника данных в вычислительную среду, но такой подход становится непомерно дорогим при больших объемах данных (например, 10 000 ГБ ~ ПБ).
- In-database машинное обучение переносит вычисления в источник данных, исключая необходимость перемещения данных и значительно повышая масштабируемость и производительность в целом.

Установка и подключение
1. Установка пакетов
pip install ipython-sql pandas numpy sqlalchemy plotly-express sql_magic pgspecial
2. Импорт пакетов
import pandas as pd
import numpy as np
import os
import sys
import plotly_express as px
# For DB Connection
from sqlalchemy import create_engine
import psycopg2
import pandas.io.sql as psql
import sql_magic
3. Подключение к БД
Существует несколько способов установить соединение с Greenplum. В блокноте Jupyter можно использовать «магию» SQL. Это позволит выполнять SQL-запросы в ячейке Jupyter. Ссылка на документацию: https://pypi.org/project/ipython-sql/ Установка на клиенте:
pip install ipython-sql
Для использования на уровне ноутбука достаточно установить соединение следующим образом:
%load_ext _ sql
%sql postgresql://<user>:<password>@<IP_address>:<port>/<database_name>
Затем выполните следующие SQL команды:
%%sql
SELECT version ();

Вы также можете использовать коннектор psycopg2 или pyodbc (есть и другие варианты, например, через JDBC)
Обзор набора данных
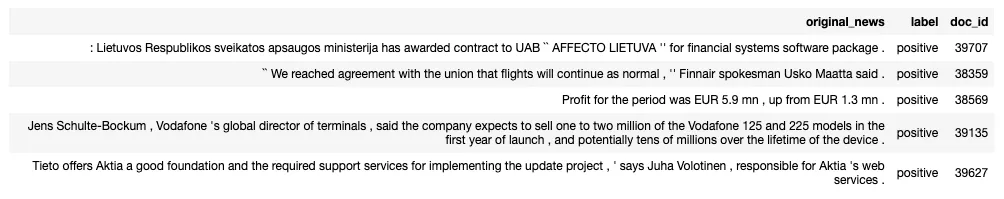
Набор данных состоит из 1967 финансовых новостей фондового рынка, написанных на английском языке и классифицированных по тональности.
Поля данных:
- docid: идентификатор финансовых новостей
- original_news: текст новостей
- label: метка, соответствующая классу, в виде строки: положительная или отрицательная
%%sql
SELECT * FROM ds_demo.sentiment_news
LIMIT 5;
%sql SELECT count(*) FROM ds_demo.sentiment_news;

NLP — анализ тональности с помощью PL/Python
Анализ тональности направлен на определение настроения по текстовому источнику , влияющего на принятие решений; он широко используется в финансовых компаниях для прогнозирования того, могут ли новости положительно или отрицательно повлиять на будущую цену акций.
Сначала мы изучим и визуализируем наш набор данных, сочетая SQL с Python-пакетами Pandas и Plotly.
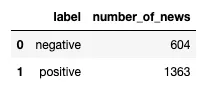
1. Распределение классов тональности нашего набора данных:
%%read_sql df_count_sentiment
SELECT label, count(*) AS number_of_news
FROM ds_demo.sentiment_news
GROUP BY 1
ORDER BY 2 ASC
color_discrete_map = {'negative': 'rgb(255,0,0)',
                      'positive': 'rgb(0,255,0)' }

px.pie(df_count_sentiment,
        values = 'number_of_news',
        names = 'label',
        color = 'label',
        color_discrete_map=color_discrete_map)
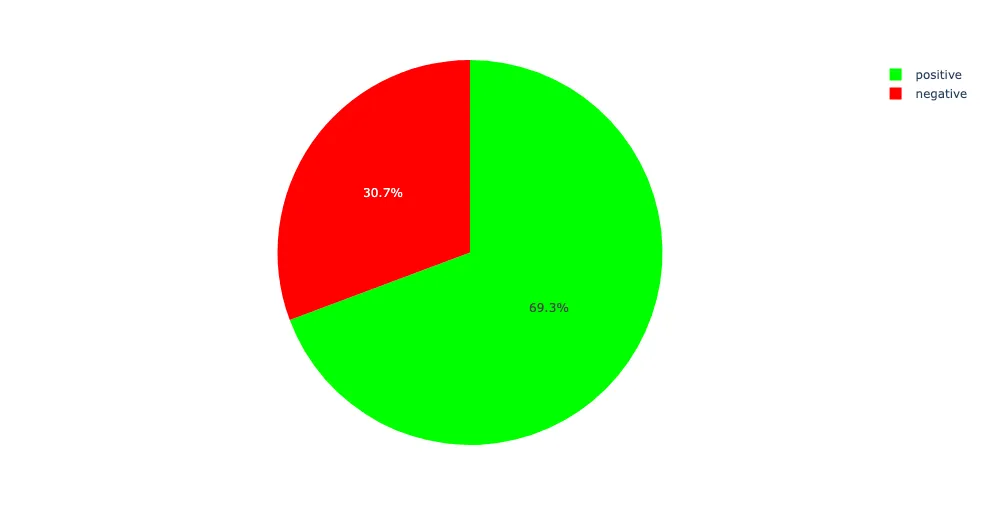
На графике видно, что наш набор данных несбалансирован: положительных новостей в два раза больше, чем отрицательных. Это может повлиять на производительность нашей модели.
2. Количество символов
%%read_sql df_max_length
SELECT max(length(original_news))
FROM ds_demo.sentiment_news;

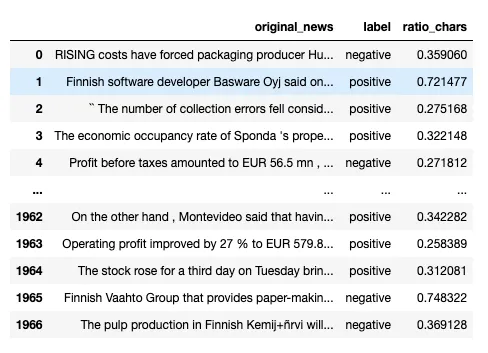
Самая длинная новость в нашем наборе данных содержит менее 300 символов, что означает, что тональность может быть определена исходя из короткого и синтетического текста.
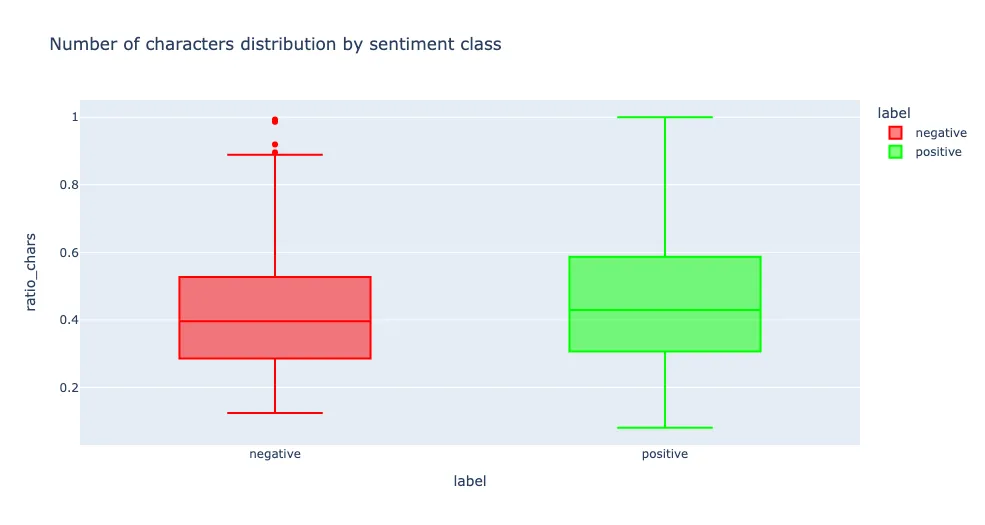
3. Количество символов по классам тональности:
%%read_sql df_len_news
SELECT original_news,
       label,
       length(original_news) * 1.0 / max(length(original_news))
       OVER (partition by NULL) AS ratio_chars
FROM ds_demo.sentiment_news
px.box(df_len_news,
       y="ratio_chars",
       x ='label',
       color='label',
       title = 'Number of characters distribution by sentiment class',
       color_discrete_map=color_discrete_map)
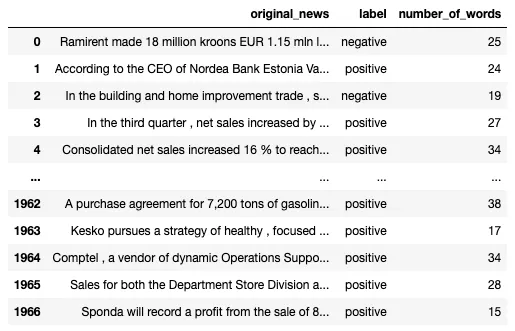
4. Количество слов по классам тональности:
%%read_sql df_len_words
SELECT original_news, label,
       ARRAY_LENGTH(STRING_TO_ARRAY(original_news, ' '), 1)
       AS number_of_words
FROM ds_demo.sentiment_news
px.box(df_len_words,
       y="number_of_words",
       x ='label',
       color='label',
       title = 'Number of words distribution by sentiment class',
       color_discrete_map=color_discrete_map)
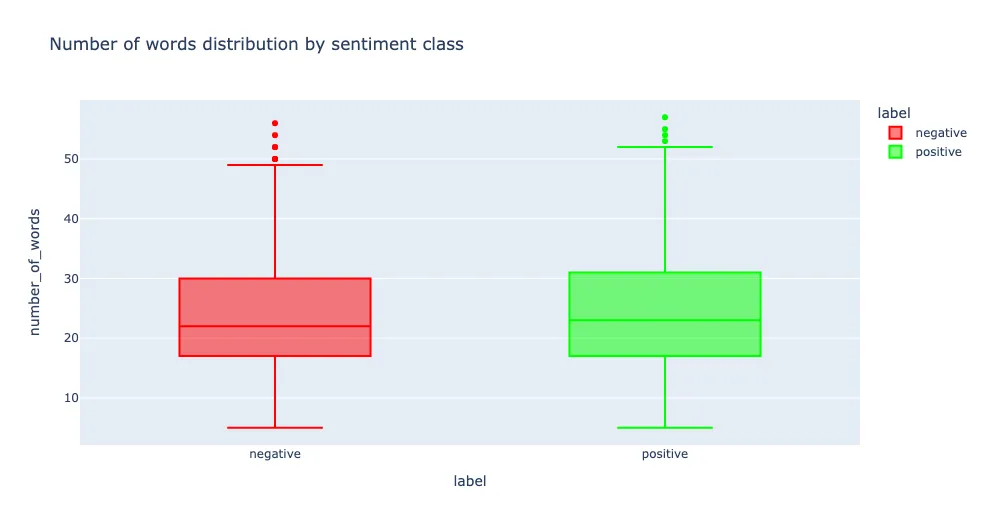
Позитивные новости, как правило, содержат немного больше слов и символов, чем негативные, но в целом мы не можем основывать наш анализ исключительно на длине.
Предварительная обработка данных — очистка текста
Под очисткой текста понимается удаление или преобразование определенных частей текста таким образом, чтобы текст стал более понятным для моделей NLP, изучающих его. Это позволяет моделям NLP работать лучше за счет уменьшения шума в текстовых данных.
Для этого мы создаем PL/Python и применяем достаточно простые действия по предварительной обработке данных:
- Во-первых, изменяем текст на строчный.
- Затем удаляем все специальные символы и URL-адреса.
- Наконец, удаляем все пробелы.
%%sql
DROP FUNCTION IF EXISTS text_prepare(text);
CREATE OR REPLACE FUNCTION text_prepare( content text)
RETURNS text
AS $$
    import re
    text = content
    replace_by_space_re = re.compile('[/(){}\[\]\|@,;]')
    bad_symbols_re = re.compile('[^0-9a-z #+_]')
    links_re = re.compile('(www|http)\S+')

    text = text.lower()  # lowercase text
    text = re.sub(replace_by_space_re," ",text)
    text = re.sub(bad_symbols_re, "",text)
    text = re.sub(links_re, "",text)
    text = re.sub(' +', ' ', text)
    return text.strip()
$$ LANGUAGE plpython3u
;
Обработанные новости мы храним в новом столбце под названием clean_text, именно его мы будем использовать для обучения нашей модели.
%%sql
ALTER TABLE ds_demo.sentiment_news ADD COLUMN cleaned_text text;
UPDATE ds_demo.sentiment_news
 SET cleaned_text = text_prepare(original_news::text);
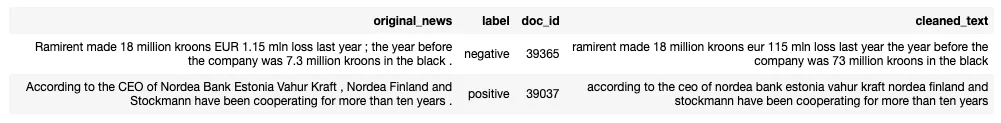
Быстрый обзор очищенных новостей:
%sql SELECT * FROM ds_demo.sentiment_news LIMIT 2;
Обучение модели анализу тональности с помощью PL/Python
Обучение модели обработки естественного языка для автоматического прогнозирования настроения финансовых новостей может помочь трейдерам и инвесторам в построении торговых/количественных стратегий.
Анализ настроения - это задача классификации текстов. В этом разделе мы используем технику Bag of Words для преобразования текстов в числовое представление, которое может быть использовано для обучения модели логистической регрессии.
Обучение модели — Логистическая регрессия частоты употребления терминов
Давайте напишем функцию PL/Python, которую можно вызывать как любую другую функцию SQL. Интеграция не требует никаких особых усилий, поскольку в Python есть бесконечное количество библиотек для ML.
Более того, помимо полной поддержки Python, PL/Python также предоставляет удобные функции для выполнения любого параметризованного запроса. Таким образом, выполнение алгоритмов ML может быть вопросом всего пары строк.
Давайте посмотрим:
%%sql
DROP FUNCTION IF EXISTS train_sentiment_news(text[],text[]);
DROP TYPE IF EXISTS news_type;
-- Create a new type for our PL/Python function output
CREATE type news_type AS (content text, label text, prediction text);
-- PL/Python function using Python3.9
CREATE FUNCTION train_sentiment_news( cleaned_text text[], label text[])
RETURNS SETOF news_type
AS $$
    import pandas as pd
    from sklearn.feature_extraction.text import CountVectorizer
    from sklearn.model_selection import train_test_split
    from sklearn.linear_model import LogisticRegression
    X = cleaned_text     y = label     df= pd.DataFrame()     df['content'] = X
    df['label'] = y
    X_train, X_test, y_train, y_test = train_test_split(df['content'], df['label'], test_size=0.2, random_state=42)
    vectorizer = CountVectorizer(min_df=4, stop_words='english')
    X_train = vectorizer.fit_transform(X_train)     X_test = vectorizer.transform(X_test)     # LOGISTIC REGRESSION     logreg = LogisticRegression()     # TRAIN      logreg.fit(X_train, y_train)     X = vectorizer.transform(df['content'])
    # PREDICTIONS ON FULL DATASET
    lr_prediction = logreg.predict(X)     df['prediction'] = lr_prediction
        return [{'content': str(row['content']),
             'label': str(row['label']),
             'prediction': str(row['prediction'])}
            for index, row in df.iterrows()]
$$ LANGUAGE plpython3u;
Как видите, PL/Python очень прост.
- Сначала мы импортируем все необходимые пакеты; мы используем библиотеки pandas и scikit-learn.
- Нам нужно загрузить входные данные (новости и метки) в датафрейм и преобразовать числовые переменные в числовые типы с помощью Bag of Words / CountVectorizer.
- Затем мы вызываем логистическую регрессию и обучаем ее на специальном множестве (80 % нашего набора данных).
- Наконец, мы возвращаем прогноз по всему набору данных в виде списка типов news_type.
В последней строке указывается язык расширения: в данном случае мы используем Python3, и поэтому расширение называется plpython3u. Если Вы хотите выполнить его на Python2, используйте язык расширения plpythonu.
Greenplum также предоставляет другой обработчик языка, PL/Container, который запускает PL/Container в Docker. Такой способ действительно является более безопасным.
Отображение прогнозов
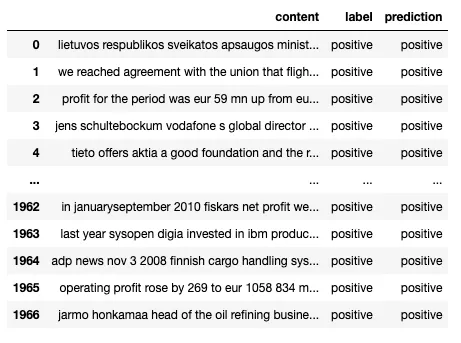
Мы можем проверить прогнозы, сделанные нашей моделью.
Функция train_sentiment_news() принимает на вход два массива, поэтому нам нужно применить функцию ARRAY_AGG(), чтобы объединить все записи столбцов cleaned_text и labels в два массива.
Кроме того, поскольку функция train_sentiment_news() возвращает набор new_type, нам необходимо разложить каждую запись результатов на различные столбцы с помощью CTE (Common Table Expression).
%%read_sql df_preds
WITH cte_data_array_agg AS (
        SELECT ARRAY_AGG(cleaned_text) AS contents,
                ARRAY_AGG(label) AS labels
        FROM ds_demo.sentiment_news
    ),     cte_predictions AS (
        SELECT train_sentiment_news(t.contents, t.labels)
        FROM cte_data_array_agg
    ) SELECT (train_sentiment_news::news_type).* FROM cte_predictions;
Оценка модели
Теперь давайте оценим нашу модель, определив: достоверность, F1-счет, точность, отзыв
%%sql
DROP FUNCTION IF EXISTS metrics_report(text[],text[]);
DROP TYPE IF EXISTS prediction_type;
CREATE type prediction_type AS (accuracy float, f1_score float, precision float, recall float);
CREATE OR REPLACE FUNCTION metrics_report(label text[], prediction text[])
RETURNS prediction_type
AS $$
    from sklearn.metrics import precision_recall_fscore_support as score
    from sklearn.metrics import accuracy_score
    import numpy as np
    y_true = label     y_pred = prediction     accuracy = accuracy_score(y_true, y_pred)     precision, recall, f1_score, support = score(y_true, y_pred)
    precision = float(np.mean(precision))
    f1_score = float(np.mean(f1_score))
    recall = float(np.mean(recall))
    accuracy = float(accuracy)
    return {'accuracy': accuracy,
            'f1_score': f1_score,
            'precision': precision,
            'recall': recall
    } $$ LANGUAGE plpython3u
;
Мы применяем функцию ARRAY_AGG() для объединения столбцов и разложения результатов композитного типа с помощью CTE.
%%read_sql df_preds
WITH
  cte_data_array_agg AS (
    SELECT ARRAY_AGG(cleaned_text) AS contents, ARRAY_AGG(label) AS labels
      FROM ds_demo.sentiment_news
  ),   cte_predictions AS (
      SELECT train_sentiment_news(t.contents, t.labels)
      FROM cte_data_array_agg
  ),   cte_label_pred AS (
    select (train_sentiment_news::news_type).*
      FROM cte_predictions
  ),   cte_metrics_report AS (
      SELECT metrics_report(array_agg(label), array_agg(prediction))
      FROM cte_label_pred
  ) SELECT (metrics_report::prediction_type).* FROM cte_metrics_report
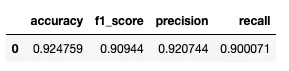
Модель достигла достоверности в 92,93%, показатели отзыва и точности немного ниже.
Развертывание модели - хранение модели
Нет особого смысла создавать модель и ничего с ней не делать. Поэтому нам нужно хранить ее в виде двоичных файлов, используя тип данных «bytea».
Храните ее в двоичном виде в таблице SQL
%%sql
DROP FUNCTION IF EXISTS save_nlp_models(text[],text[]);
DROP TYPE IF EXISTS model_type CASCADE;
CREATE TYPE model_type as (model_logreg bytea, model_bow bytea);
CREATE FUNCTION save_nlp_models(cleaned_text text[], label text[])
RETURNS model_type
AS $$
    import pandas as pd
    from sklearn.feature_extraction.text import CountVectorizer
    from sklearn.model_selection import train_test_split
    from sklearn.linear_model import LogisticRegression
    import pickle         X = cleaned_text     y = label     df= pd.DataFrame()     df['content'] = X
    df['label'] = y
    X_train, X_test, y_train, y_test = train_test_split(df['content'],
                                                        df['label'],
                                                        test_size=0.2,
                                                        random_state=42)
    vectorizer = CountVectorizer(min_df=4, stop_words='english')
    X_train = vectorizer.fit_transform(X_train)     X_test = vectorizer.transform(X_test)     # LOGISTIC REGRESSION     logreg = LogisticRegression()     logreg.fit(X_train, y_train)     X = vectorizer.transform(df['content'])
    lr_prediction = logreg.predict(X)     df['prediction'] = lr_prediction
        # Save Logistic Regression model     model_logreg = pickle.dumps(logreg)     # Save CountVectorizer      model_countvectorizer = pickle.dumps(vectorizer)         return {'model_logreg': model_logreg
            ,'model_bow': model_countvectorizer}
$$ LANGUAGE plpython3u
;
Для этого создадим таблицу ds_demo.saved_models, чтобы сначала сохранить модель:
%%sql
DROP TABLE IF EXISTS ds_demo.saved_models;
CREATE TABLE ds_demo.saved_models (model_logreg bytea,
                                   model_bow bytea,                                     model_name text);
В данном случае наша таблица содержит только model_name и два поля байтового массива (одно для логистической регрессии, а другое для Bag of Words), которые и являются сериализованной моделью. Обратите внимание на то, что это тот же тип данных, что и тот, который возвращают наши модели Scikit-learn.
Получив таблицу, мы можем легко вставить в нее новую запись с моделью:
%%sql
WITH cte_models AS (
        SELECT save_nlp_models(t.contents, t.labels)
    FROM (
        SELECT ARRAY_AGG(cleaned_text) AS contents,
               ARRAY_AGG(label) AS labels
          FROM ds_demo.sentiment_news) t
      ),     cte_casted_model AS (
        SELECT (save_nlp_models::model_type).*
        FROM cte_models)
    INSERT INTO ds_demo.saved_models
SELECT model_logreg, model_bow, 'nlp_sentiment_analysis_bow_logreg' AS model_name FROM cte_casted_model;
Показать двоичные файлы
%%sql
SELECT model_name, model_logreg::text, model_bow::text
FROM ds_demo.saved_models;

Отображение информации о модели
До сих пор мы могли создавать модели и хранить их. Но получать ее непосредственно из базы данных не очень удобно.
Поэтому мы должны вернуться к Python, чтобы вывести полезную информацию о нашей модели. Вот функция, которую мы будем для этого использовать:
%%sql
DROP FUNCTION get_model_info(text,text,text);
CREATE OR replace FUNCTION get_model_info(model_table text, model_column text, model_name text)
RETURNS text
AS $$
    from pandas import DataFrame
    import pickle     rv = plpy.execute('SELECT %s FROM %s WHERE model_name = %s;' % (plpy.quote_ident(model_column), model_table, "'"+model_name+"'"))
    model = pickle.loads(rv[0][model_column])
        return str(model.get_params())
  $$ LANGUAGE plpython3u;
Начнем с самого начала: мы снова передаем таблицу, содержащую модели, и столбец, в котором хранятся бинарные данные. Функция pickle.load() считывает вывод.
(Здесь показано, как результаты запроса plpython plpy.execute загружаются в Python).
Когда модель загружена, мы возвращаем model.get_params(), где хранятся параметры нашей логистической регрессии.
Это лишь пример того, как можно вывести конкретную функцию модели. Вы можете создать аналогичные функции для возврата других характеристик или даже всех возможных характеристик.
Давайте посмотрим, что же она возвращает:
%%sql
select get_model_info('ds_demo.saved_models','model_logreg','nlp_sentiment_analysis_bow_logreg');

Вывод модели - предсказание новых данных
Теперь, когда у нас есть модель, давайте использовать ее для построения прогнозов! Вызов модели достаточно прост и может быть выполнен на SQL с использованием PL/Python.
%%sql
DROP FUNCTION IF EXISTS predict_sentiment(text, bytea, bytea);
CREATE FUNCTION predict_sentiment(cleaned_text text, model_logreg bytea, model_bow bytea)
RETURNS text
AS $$
    import pickle

    logreg = model_logreg
    vectorizer = model_bow
    texts = cleaned_text

    # Save Logistic Regression model
    model_logreg_bytes = pickle.loads(logreg)
    # Save CountVectorizer
    model_countvectorizer = pickle.loads(vectorizer)

    return list(model_logreg_bytes.predict(model_countvectorizer.transform([texts])))[0]
$$ LANGUAGE plpython3u
;
По сравнению с предыдущей функцией мы добавляем один дополнительный входной параметр (cleaned_text), передавая на вход фрагмент финансовой новости, для которой мы хотим получить тональность.
%%sql
SELECT content, predict_sentiment(text_prepare(t.content), b.model_logreg, b.model_bow)
FROM
   ds_demo.financial_news t,
    ds_demo.saved_models b
LIMIT 5;
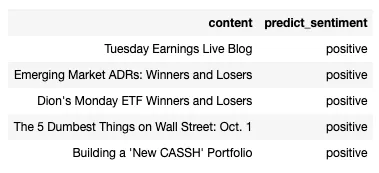
Теперь мы можем обрабатывать большие массивы данных и показывать распределение положительных/отрицательных новостей.
%%sql
SELECT predict_sentiment, count(*)
FROM (
  SELECT content, predict_sentiment(t.content, b.model_logreg, b.model_bow)
  FROM
    ds_demo.financial_news t,     ds_demo.saved_models b      LIMIT 10000
  ) results GROUP BY 1;
Заключение
В этой статье мы показали, что Вы можете обучать и использовать NLP и ML, не покидая хранилища данных Greenplum. Greenplum обладает мощными аналитическими возможностями, которые делают его отличным вариантом, идеально подходящим для решения задач Data Science.
Использование широких возможностей ML в базе данных Greenplum на PL/Python и PL/R позволяет специалистам по исследованию данных использовать обширную экосистему библиотек машинного обучения для анализа огромных массивов данных.


