

Коннекторы Kafka
Kafka Connect - это структура, которая обеспечивает поток данных между внешними системами.
Это может быть база данных, хранилище ключевых значений, поисковые индексы, файловая система и т. д. Коннекторы - это готовые к использованию компоненты Kafka Connect. Мы можем либо использовать существующие коннекторы для наших источников данных, либо создать свои собственные коннекторы.
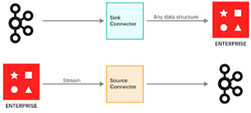
Существует 2 типа коннекторов - источник и поглотитель:
- Источник: Используется для передачи данных из внешнего источника в топик Kafka;
- Поглотитель: Используется для передачи данных из топика Kafka во внешний источник.

Коннекторы Kafka для передачи данных обладают рядом преимуществ:
- Они просты в разработке, развертывании и управлении.
- Их распределенный характер идеально подходит для работы с большими массивами данных благодаря готовым настройкам для разработки и тестирования.
- Для управления также доступен REST API.
- Транзакции со смещенной фиксацией управляются автоматически.
- В настоящее время они используют протоколы управления группами. - Позволяет вносить незначительные изменения в сообщения.
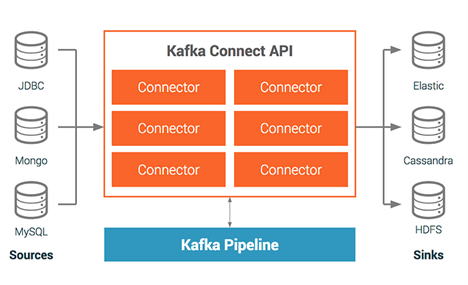
Существует множество коннекторов в виде готовых плагинов. При их выборе важно обратить внимание на следующее: для некоторых систем есть коннекторы источника и поглотителя, а для некоторых - только один тип. Одним из наиболее популярных и доступных '(!)' плагинов является Debezium. Debezium - это CDC для следующих баз данных:
- PostgreSQL(!)
- Couchbase
- MongoDB
- MongoDB(!)
- SQL Server(!)
- JDBC
- MySQL(!)
- Cassandra
- InfluxDB
- Redis
- MQTT
- ElasticSearch
В следующих разделах статьи я приведу примеры внешних систем. Для разнообразия я приведу примеры как для источника, так и для поглотителя (с помощью JDBC и коннектора Couchbase).
Источник
Предположим, у Вас есть таблица в базе данных Oracle, и Вы хотите передать ее в топик kafka. В данном случае Вам нужно использовать JDBC Source Connector. Ниже в качестве примера я приведу базовую конфигурацию:
{
    "connector.class": "io.confluent.connect.jdbc.JdbcSourceConnector",
    "tasks.max": "1",
    "auto.create.topic.enable": "true",
    "topic.prefix": "test-connect-",
    "connection.url": "jdbc:oracle:thin:@(DESCRIPTION=(ADDRESS=(PROTOCOL=TCP)(HOST=MyHost)(PORT=MyPort))(CONNECT_DATA=(SERVICE_NAME=MyOracleSID)))",
    "connection.user": "myusername",
    "connection.password": "mypassword",
    "connection.password.secure.key": "mycredentialstorekey",
    "mode": "incrementing",
    "incrementing.column.name": "id",
    "table.whitelist": "users",
    "key.converter": "org.apache.kafka.connect.storage.StringConverter",
    "value.converter": "io.confluent.connect.avro.AvroConverter",
    "transforms": "LogDateConverter",
    "transforms.LogDateConverter.type": "org.apache.kafka.connect.transforms.TimestampConverter$Value",
    "transforms.LogDateConverter.field": "LOG_DATE"
    "transforms.LogDateConverter.format": "yyyy-MM-dd",
    "transforms.LogDateConverter.target.type": "string"
}
connector.class: Мы используем JdbcSourceConnector от Confluent. Чтобы использовать этот коннектор, Вам необходимо предварительно установить его на Ваш Kafka.
tasks.max: Параметр, используемый для обеспечения параллелизма. Если Вы установите значение 2, коннектор будет параллельно выполнять максимум 2 задачи.
auto.create.topic.enable: Если этот параметр установлен в true, то новый топик будет создаваться путем поочередного добавления значений полей «topic.prefix» и «table.whitelist», и данные, поступающие из базы данных, будут записываться в этот топик.
topic.prefix: Префикс названия топика.
connection: Значения url, user и password здесь - это учетные данные, которые нужны коннектору для доступа к таблице в базе данных.
mode (режим): Это один из самых важных параметров коннектора источника, определяющий режим работы коннектора. Подробнее об этом я расскажу чуть позже.
incrementing.column.name: Поскольку значение режима задано как incrementing, здесь следует указать увеличивающийся столбец для каждой новой записи в таблице.
key.converter ve value.converter: Соответствующий конвертер должен быть добавлен к любому типу значений ключа и значения. Доступны конвертеры строк, целых чисел, json, avro и т. д..
Кроме того, если Ваш «value.converter» - это JsonConverter, Вам нужно добавить конфигурацию включения схемы в зависимости от того, является ли она схемой или нет. Например, если Ваши данные представлены в виде json-схемы/платежа следующим образом:
{
  "schema": {
    "type": "struct",
    "fields": [
      {
        "type": "int64",
        "optional": false,
        "field": "id"
      },
      {
        "type": "string",
        "optional": false,
        "field": "name"
      },
      {
        "type": "string",
        "optional": false,
        "field": "gender"
      }
    ],
    "optional": false,
    "name": "ksql.users"
  },
  "payload": {
    "registertime": 1493819497170,
    "name": "User1",
    "gender": "MALE"
  }
}
В конфигурацию нужно добавить следующее:
"value.converter": "org.apache.kafka.connect.json.JsonConverter"
"value.converter.schemas.enable": true
Но если Ваши данные выглядят так;
{
    "registertime": 1493819497170,
    "name": "User1",
    "gender": "MALE"
}
Вам нужно добавить следующее:
"value.converter": "org.apache.kafka.connect.json.JsonConverter"
"value.converter.schemas.enable": false
Мы всегда можем захотеть произвести некоторые преобразования, а не передавать данные в таблицу в таком виде, в каком они есть. Вот тут-то и пригодятся преобразования. В приведенном выше примере мы преобразуем столбец временной метки с именем «LOG_DATE» в строку при переносе его из таблицы в топик. Мы задаем имя операции преобразования, которую будем выполнять, в поле «Преобразования». Затем мы добавляем наши конфигурации в виде transforms.{transform_name}.{...}. В этом примере имя нашего преобразования - LogDateConverter. В поле «transforms.LogDateConverter.type» мы указываем, что наша операция преобразования - это преобразование временных меток. В поле «transforms.LogDateConverter.field» мы указываем имя соответствующего столбца в таблице, в поле «transforms.LogDateConverter.format» - формат поля временной метки в столбце, а в поле «transforms.LogDateConverter.target.type» - тип преобразуемых данных. Для одного коннектора можно выполнить более одной операции преобразования. Мы можем присвоить полю Transforms значение «LogDateConverter, RenameFieldNames» и добавить следующие конфигурации.
"transforms.RenameFieldNames.type": "org.apache.kafka.connect.transforms.ReplaceField$Value",
"transforms.RenameFieldNames.renames": "firstfield:firstField,secondfield:SecondField"
Согласно приведенной выше конфигурации, данные в виде {«firstfield»: 3, «secondfield»: «xyz"} превращаются в {“firstField”: 3, “SecondField”: “xyz”}.
Один из важных конфигов, о котором я хочу упомянуть, - это режим. Данный параметр может принимать 4 различных значения. Bulk, Incrementing, Timestamp, а также increment и timestamp вместе.
«bulk": При каждом опросе вся таблица переносится в топик.
«incrementing": При каждой вставке в таблицу полю «incrementing.column.name» присваивается столбец. Назовем его id. Логика заключается в следующем: записи в таблице проверяются при каждом запросе коннектора. Если среди этих записей есть строка со значением id больше, чем самая большая строка в предыдущем последнем запросе опроса, то эти данные передаются в тему. Здесь необходимо обратить на это внимание. Поскольку значение id не меняется в транзакциях обновления и удаления, в этом режиме перехватываются и передаются в Kafka только транзакции вставки.
«timestamp": В таблице в поле «timestamp.column.name» задается столбец timestamp, который меняется с каждой транзакцией. Назовем его «дата». Логика заключается в следующем: в каждом запросе коннектора на опрос, если есть столбец с полем даты с датой после даты последнего опроса, они передаются в топик. В отличие от режима инкрементации, если Вы хотите передавать данные в топик при всех операциях создания, обновления или удаления (здесь я имею в виду мягкое удаление), следует использовать именно этот режим.
«timestamp+increment": Это режим, в котором оба подхода используются вместе.
Имейте в виду, что Kafka connect не является CDC. CDC (Change Data Capture) - это захват изменений данных в источнике данных. Например, когда Вы обновляете поле даты в столбце базы данных, это изменение сразу же замечается и запускает определенное действие. В качестве примера CDC можно привести Debezium. Если вернуться к коннекторам kafka, то они не могут сразу обнаружить изменение, потому что в них нет CDC. Они запрашивают базу данных через соединение через регулярные промежутки времени. Мы называем это опросом. Одна из важных настроек коннектора - «poll.interval.ms». Например, если мы зададим значение 1000, коннектор будет каждые 1000 мс (1 секунда) проверять колонки и обеспечивать бесперебойную передачу данных.
Я попытался объяснить часть конфигов, которые считаю важными. Давайте приведем пример источника из couchbase. Я добавил простой пример коннектора источника couchbase ниже.
{
    "connector.class": "com.couchbase.connect.kafka.CouchbaseSourceConnector",
    "couchbase.persistence.polling.interval": "100ms",
    "tasks.max": "2",
    "couchbase.seed.nodes": "test.db.couchbase",
    "couchbase.collections": "User.Address",
    "couchbase.bucket": "Customer",
    "couchbase.username": "dbuser",
    "couchbase.password": "dbpass",
    "couchbase.stream.from": "NOW",
    "couchbase.source.handler": "com.couchbase.connect.kafka.handler.RawJsonSourceHandler",
    "value.converter": "org.apache.kafka.connect.converters.ByteArrayConverter",
    "value.converter.schemas.enable": "false",
    "couchbase.topic": "customer-user-address"
}
Некоторые конфигурации могут быть похожими на jdbc-коннектор. Например, конфигурации «connector.class», «value.converter.schemas.enable» и «tasks.max» полностью аналогичны jdbc. Конфиг «couchbase.persistence.polling.interval» выполняет ту же функцию, что и конфиг «poll.interval.ms» в коннекторе jdbc.
Когда мы смотрим на свойства Couchbase, seed.nodes определяется как наши узлы couchbase, поля username и password определяются как наши учетные данные couchbase, как следует из названия, bucket определяется как наш bucket couchbase, а collections определяется как {scope_name}.{collection_name} как наша коллекция, в которую будут передаваться данные.
couchbase.stream.from: С помощью этой настройки мы определяем, откуда коннектор будет передавать данные. Если мы зададим значение «BEGINNING», то при каждом перезапуске коннектора он будет обрабатывать все данные с самого начала. Таким образом, одни и те же данные могут быть обработаны несколько раз. Если этому значению присвоено значение «NOW», то после перезапуска коннектора он начнет передавать новые данные, вставленные в коллекцию. При закрытии коннектора вставленные данные теряются. Кроме этих, существуют также значения «SAVED_OFFSET_OR_BEGINNING» и «SAVED_OFFSET_OR_NOW», которые применяют тот же подход с учетом смещения. Например, ваш конфиг имеет значение «SAVED_OFFSET_OR_BEGINNING», а ваш коннектор закрыт. В Коллекцию были вставлены два новых данных. После того как коннектор встанет, он не будет обрабатывать ранее обработанные данные, а обработает 2 новых данных, вставленных, пока он был закрыт. Этот метод используется по умолчанию.
couchbase.source.handler: Этот конфиг определяет, как документ couchbase будет преобразован в запись kafka. Чтобы передавать документы в формате Json, после задания значения «com.couchbase.connect.kafka.handler.source.RawJsonSourceHandler», нам нужно задать значение.converter config «org.apache.kafka.connect.converters.ByteArrayConverter».
Поглотитель
Выше мы говорили о том, как передавать данные из источника данных в топик. Теперь же давайте перейдем к противоположному потоку - от топика к базе данных и т. д. Мы поговорим о коннекторах - поглотителях, которые мы будем использовать при передаче данных в сторонние системы.
Приведем первый пример с использованием коннектора JDBC Sink. В отличие от источника, я приведу этот пример с реестром схем.
{
    "connector.class": "io.confluent.connect.jdbc.JdbcSinkConnector",
    "tasks.max": "3",
    "topics": "company-connect",
    "connection.url": "jdbc:oracle:thin:@(DESCRIPTION=(ADDRESS=(PROTOCOL=TCP)(HOST=MyHost)(PORT=MyPort))(CONNECT_DATA=(SERVICE_NAME=MyOracleSID)))",
    "connection.user": "myusername",
    "connection.password": "mypassword",
    "table.name.format": "company",
    "value.converter": "io.confluent.connect.avro.AvroConverter",
    "value.converter.schema.registry.url": "schema.registry.kafka",
    "value.converter.value.subject.name.strategy": "io.confluent.kafka.serializers.subject.RecordNameStrategy",
    "value.converter.schemas.enable": "true",
    "db.timezone": "Europe/Istanbul",
    "insert.mode": insert
}
Здесь класс коннектора, максимум задач и конфигурация соединения такие же, как и в Ource. Топик, который является источником данных, задается с помощью конфигурации «topics», а таблица, которая является целью, задается с помощью конфигурации «table.name.format». Поскольку мы создаем данные, используя реестр схем для топика, нам нужно предоставить коннектору конфигурацию конвертера значений. Мы используем avro converter в качестве конвертера и определяем наш url реестра схем. Если мы используем стратегию, отличную от стратегии имени топика по умолчанию, мы указываем его с помощью «value.converter.value.subject.name.strategy». И поскольку это использование схемы, мы устанавливаем «value.converter.schemas.enable» в true. «db.timezone» используется для указания часового пояса базы данных, в которую будут передаваться данные. Например, часовой пояс Вашей базы данных - GMT+3. Если часовой пояс машины, на которой установлена Kafka, GMT+1, то в поле даты Ваших данных будет разница в 2 часа.
Теперь перейдем к «insert.mode», одному из самых важных конфигов. Это поле может принимать 3 различных значения: insert, update и upsert. Если наш режим - insert, то данные, поступающие в тему, вставляются в таблицу как новая запись. Если приходят данные с первичным ключом, принадлежащим существующей записи в таблице, то будет получена ошибка уникального ограничения и перенос не произойдет. Обновление вносит изменения в записи, находящиеся в таблице. Если мы задаем режим upsert, то нам необходимо также задать и значения «pk.mode» и «pk.fields». Нам нужно установить pk.mode как «record_value» и установить pk.fields как поле, соответствующее первичному ключу таблицы.
Я постарался объяснить конфиги, которые, на мой взгляд, являются самыми важными.
Давайте рассмотрим пример поглотителя.
{
    "connector.class": "com.couchbase.connect.kafka.CouchbaseSinkConnector",
    "couchbase.bootstrap.timeout": "10s"
    "tasks.max": "2",
    "couchbase.seed.nodes": "test.db.couchbase",
    "couchbase.collections": "User.Address",
    "couchbase.bucket": "Customer",
    "couchbase.username": "dbuser",
    "couchbase.password": "dbpass",
    "couchbase.document.expiration": "30d"
    "topics": "customer-user-address"
}
Большинство конфигураций здесь те же, что и в случае коннектора- источника.
couchbase.bootstrap.timeout: Максимальное время, в течение которого коннектор ожидает подключения к couchbase после запуска. Согласно этому конфигу, если Kafka не может подключиться к Couchbase в течение 10 секунд, значит, коннектор не работает.
couchbase.document.expiration: С помощью этого значения мы можем определить максимальный период, в течение которого данные, переданные из темы в коллекцию, будут храниться в couchbase. Согласно этой настройке, переданный документ будет удален через 30 дней.
Я постарался рассказать о коннекторах Kafka как можно больше важных моментов, необходимых в самом начале работы с этим инструментом. Возможно, Вам придется использовать различные подходы в зависимости от Ваших потребностей и структуры данных.


