

Почему Kafka – это новое Data Lake?
Многие дата-инженеры используют Kafka для хранения недавно поступивших данных, а затем переносят их в Data Lake. Однако появляется все больше и больше оснований полагать, что Kafka превращается в новую форму озера данных. Давайте постараемся разобраться, почему же происходит эта эволюция?
Сдвиг в сторону Data Lake действительно является основополагающим фактором развития мира данных. Озера данных играют важнейшую роль в управлении огромными объемами сырых, неструктурированных и полуструктурированных данных. Их способность хранить исторические данные как единый источник истины крайне важна для организаций, которые стремятся поддерживать согласованность, целостность и достоверность данных в своих отделах и командах.

Интеграция вычислительного движка, например Apache Spark, Trino, или ClickHouse, может превратить Data Lake в 'Data Lakehouse'. Это не только поможет хранить огромные объемы данных, но и эффективно их обрабатывать
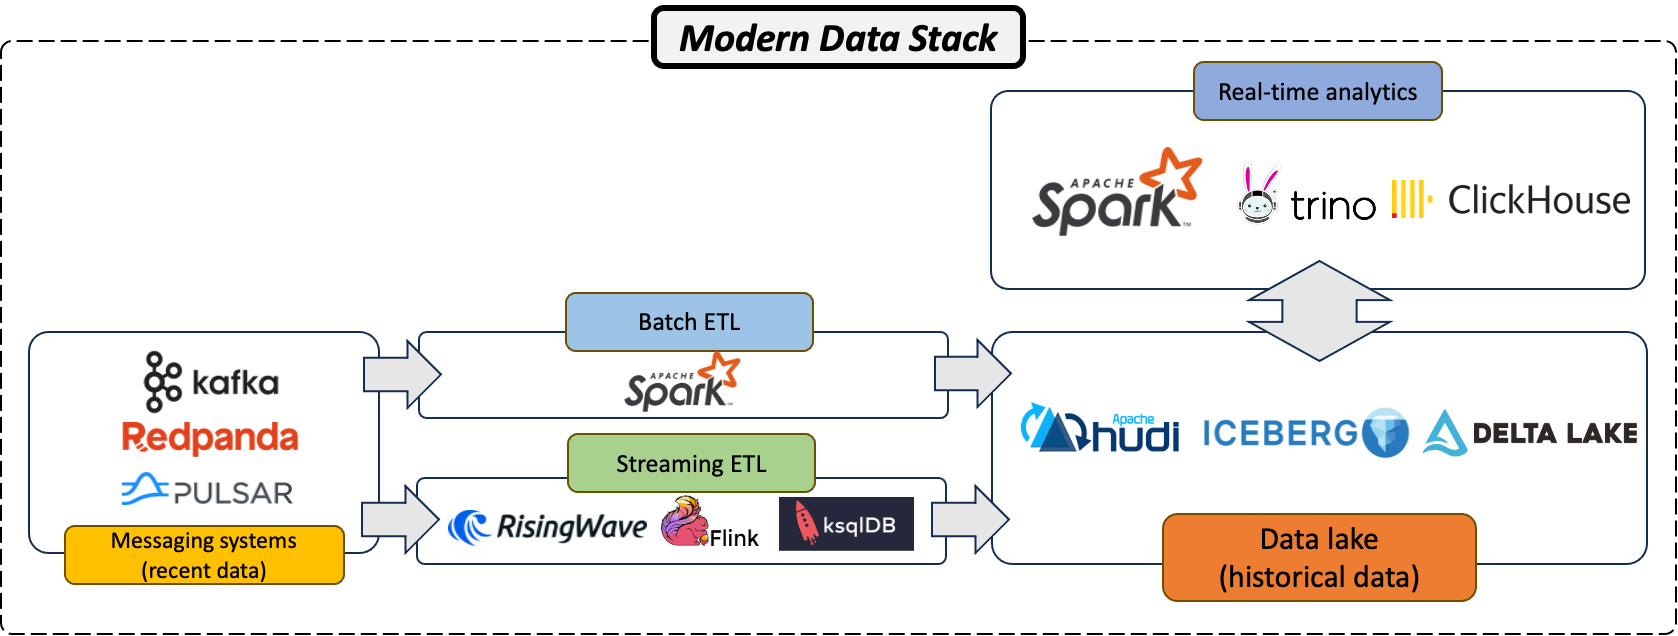
Apache Kafka, широко используемая платформа потоковой передачи событий, вошла в технологический стек многих корпораций, ориентированных на работу с данными. Kafka уже давно воспринимается как «хранилище последних данных» в современном стеке данных. Многие инженеры по обработке данных используют Kafka для хранения недавно поступивших данных, обычно на срок от 7 дней до месяца, перед передачей этих данных в озера данных.
У большинства людей сложилось впечатление, что «платформы потоковой передачи событий предназначены для транзитных данных, а Data Lake - для исторических данных». Однако появляется все больше оснований полагать, что Kafka превращается в новую форму озера данных.
Что такое Data Lake?
Озеро данных - это централизованное хранилище, позволяющее хранить все структурированные и неструктурированные данные в любом масштабе в одном месте. В отличие от хранилища данных, где данные хранятся в структурированном и упорядоченном виде, Data Lake хранит их в исходном формате.
Существует три популярных фреймворка для управления озерами данных, а именно Apache Iceberg, Apache Hudi и Delta Lake. Каждая из этих систем имеет свои уникальные особенности и преимущества, все три широко используются для хранения и управления историческими данными в больших масштабах. Их структура и функциональные возможности облегчают работу с огромными объемами данных, а возможности интеграции с популярными вычислительными движками, такими как Apache Spark, делают их подходящими вариантами для работы с различными приложениями Big Data.
Kafka обладает всеми свойствами Data Lake
Kafka по своей сути хорошо подходит для того, чтобы стать озером данных. Прежде чем обсуждать, является ли Kafka новой формой озера данных, давайте сначала разберемся, обладает ли Kafka всеми необходимыми свойствами для того, чтобы им стать.
Kafka действительно обладает всеми необходимыми свойствами Data Lake.
- Свойства ACID, присущие базе данных. Как было подчеркнуто в ключевом докладе Мартина Клеппманна на Саммите Kafka, прошедшем в Сан-Франциско в 2018 году, “Является ли Kafka БД?”, Kafka значительно эволюционировала и приобрела все свойства, присущие базам данных, а именно атомарность, согласованность, изоляцию и долговечность (ACID). Хотя многие используют Kafka для хранения только последних данных, на самом деле Kafka имеет возможность бесконечного хранения, подобно современным озерам данных. Эта возможность делает Kafka привлекательным вариантом для хранения огромных объемов данных.
- Экономичное многоуровневое хранилище данных. Одна из основных причин, по которой люди не решаются использовать Kafka для хранения долго хранящихся данных, - это мнение, что Kafka стоит дорого. Раньше это было правдой. Классическая структура Kafka подразмевала хранения данных в вычислительных экземплярах (например, AWS EC2), которые гораздо дороже объектных хранилищ, таких как AWS S3. Однако со временем ситуация сильно изменилась. Самая последня версия Kafka, созданная Confluent, а также другими мощными платформами по обработке данных (Redpanda и Apache Pulsar) использует многоуровневое хранение, которое сохраняет холодные данные в дешевом объектном хранилище, тем самым снижая затраты и делая возможным долговременное хранение данных. Новая структура хранения делает Kafka пригодной для хранения огромных объемов данных по низкой цене.
- Хранение разных типов данных. Kafka может работать с самыми разными типами данных, от структурированных данных, таких как реляционные данные, до полуструктурированных данных, таких как JSON и Avro, и даже до неструктурированных данных, таких как текстовые документы, изображения и видео (хотя это и редкость). Такая универсальность крайне важна в условиях современного разнообразия данных и позволяет Kafka служить централизованным хранилищем для всех данных организации, снижая сложность и накладные расходы на управление несколькими решениями для хранения данных.
- Хранение данных в режиме реального времени. Хотя многие используют озера данных для хранения исторических данных, современные озера данных развиваются и все больше переходят на работу в режиме реального времени. Такая эволюция естественна, поскольку современные приложения и устройства могут постоянно генерировать огромные объемы данных. Поэтому в Data Lake внедряются оптимизации, позволяющие получать данные в режиме реального времени. Будучи платформой потоковой передачи событий, Kafka по своей сути поддерживает прием данных в реальном времени. Ее архитектура хорошо подходит для хранения как быстро меняющихся данных в реальном времени, так и медленно меняющихся исторических данных.
Kafka может стать новым Data Lake?
Kafka обладает всеми свойствами озера данных. Но есть ли у Kafka потенциал для того, чтобы служить новым озером данных в производстве? В пользу этой точки зрения говорит несколько убедительных аргументов:
- Это источник данных. Многие организации напрямую вводят данные в Kafka, а затем переносят их в хранилища данных или другие системы хранения. Если Kafka используется в качестве озера данных, в котором данные хранятся постоянно, это избавляет от необходимости перемещать данные между различными системами. Исключение перемещения данных не только снижает затраты, но и минимизирует вероятность их несогласованности и потери.
- Единый источник истины. Использование Kafka в качестве озера данных означает, что оно может служить единым источником истины для всей организации. Несогласованность данных возникает из-за того, что люди преобразуют данные. Но если мы используем источник данных в качестве места назначения данных, то мы не столкнемся с проблемой несогласованности данных. Более того, такой подход значительно упрощает архитектуру данных, сокращая количество систем, которые необходимо поддерживать, синхронизировать и интегрировать, что делает инфраструктуру более управляемой, менее подверженной ошибкам и более экономичной.
- Богатая экосистема. Kafka может похвастаться очень богатой и надежной экосистемой для получения данных из различных источников, и большинство вычислительных машин могут с легкостью потреблять данные из Kafka. Такая гибкость значительно облегчает интеграцию Kafka в существующие системы и рабочие процессы, тем самым снижая усилия и сложность, необходимые для внедрения Kafka в качестве озера данных. Кроме того, возможности Kafka выходят за рамки простого приема и хранения данных. Она также предлагает встроенные возможности легкой потоковой обработки (через Kafka Streams), что означает, что данные могут обрабатываться в режиме реального времени по мере их поступления. Это значительное преимущество для организаций, которым требуется аналитика в режиме реального времени и возможность оперативного принятия решений.
Заменит ли Kafka существующий формат Data Lake?
Очевидный ответ - нет, по крайней мере, в ближайшем будущем. Несмотря на то, что Kafka может хранить как данные в реальном времени, так и исторические данные, это не означает, что она вытеснит широко используемые фреймворки для управления озерами данных, такие как Apache Iceberg, Apache Hudi и Delta Lake.
Эти фреймворки для управления озерами данных оптимизированы для хранения больших объемов данных, сохраняя при этом свойства ACID. Функционально Kafka еще не включает в себя такие важные функции, как понимание типов данных для сжатия, поддержка pushdown запросов, поддержка обновлений и вставок, что делает ее менее привлекательной для обслуживания исторических данных.
Возможная архитектура, которая будет принята в ближайшем будущем, - это использование Kafka в качестве единого интерфейса для чтения и записи, а также хранение в Kafka «горячих» и «теплых» данных. Затем холодные данные могут постепенно переводиться из Kafka в Iceberg/Hudi/Delta, прозрачно и без ведома пользователя. Такой подход позволяет использовать сильные стороны как Kafka, так и существующих озер данных. Пользователи могут продолжать читать и записывать данные, напрямую обращаясь к API Kafka, не обращая внимания на базовую структуру и формат данных. Это означает, что сложности базовых механизмов преобразования и хранения данных абстрагированы от конечных пользователей, что упрощает их взаимодействие с системой.
Создание озера потоковых данных с помощью Kafka
Data LakeHouse - это мощная платформа данных, объединяющая лучшие черты озер данных и хранилищ данных. Она представляет собой единую платформу, способную обрабатывать огромные объемы структурированных и неструктурированных данных и поддерживать передовую аналитику и машинное обучение. С развитием Kafka в новое озеро данных мы можем построить «озеро потоковых данных», которое может хранить и обрабатывать как данные, поступающие в режиме реального времени, так и исторические данные. Для создания «озера потоковых данных» на базе Kafka необходимо как минимум два ключевых компонента:
- Система потоковой обработки данных. Первый важный компонент - это система обработки потоков, например, RisingWave, Apache Flink или KsqlDB. Эти системы предназначены для обработки потоков данных, хранящихся в Kafka, в режиме реального времени, что позволяет компаниям принимать более быстрые и обоснованные решения, анализируя данные по мере их поступления.
- Аналитический движок, работающий в режиме реального времени. Второй важный компонент - аналитический движок, работающий в режиме реального времени, такой как Apache Spark, Trino или ClickHouse. Эти движки предназначены для анализа обработанных данных, получения инсайтов и облегчения принятия решений. Они способны обрабатывать большие объемы данных с низкой задержкой, что делает их идеальным решением для архитектуры озера потоковых данных, построенного на базе Kafka.
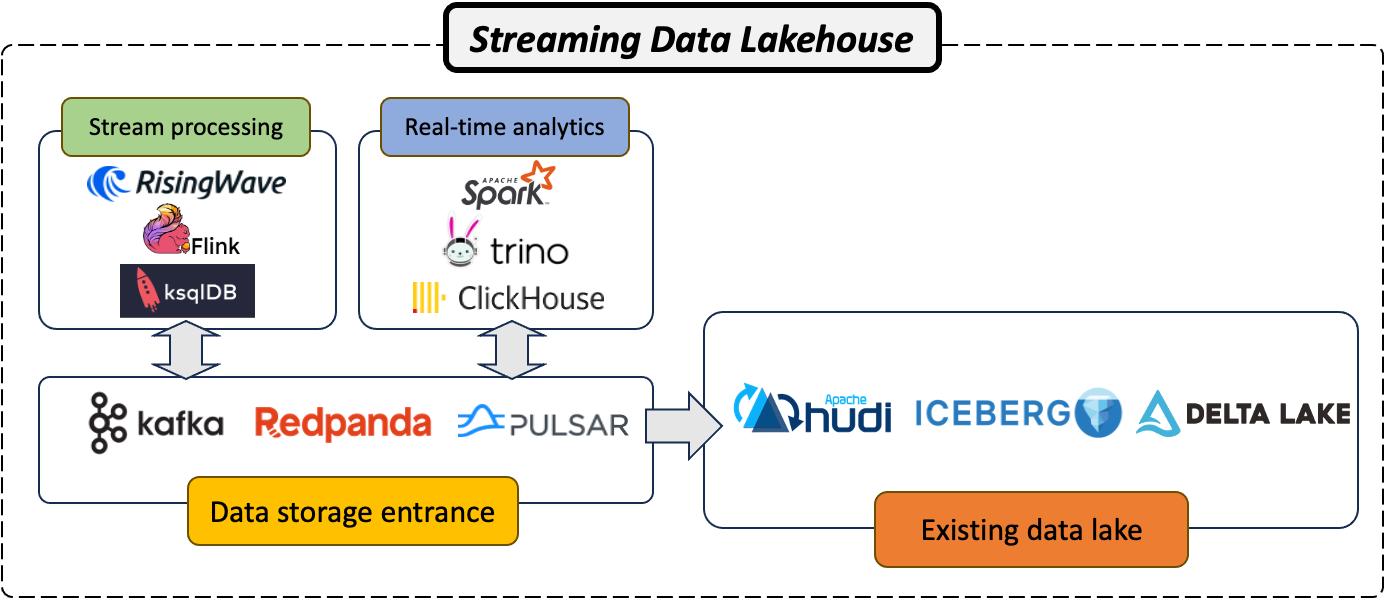
Объединив Kafka с надежной системой обработки потоков и мощным аналитическим движком, работающим в режиме реального времени, компании могут создать архитектуру озера потоковых данных, способную справиться со строгими требованиями современной обработки данных и аналитики. Такая архитектура позволяет организациям максимально использовать ценность своих данных, предоставляя в реальном времени информацию, которая способствует принятию более эффективных решений и создает конкурентные преимущества.
Wishlist для Kafka
Хотя Kafka невероятно мощна и универсальна, есть области для улучшения, особенно если она действительно хочет превратиться в Data Lake. Вот несколько пунктов в моем списке пожеланий для Kafka.
- Осознание типа данных для сжатия. В настоящее время Kafka рассматривает данные как массив байтов и не знает о реальной структуре и типе данных. Если бы Kafka могла знать типы данных, с которыми она работает, она могла бы выполнять сжатие данных более эффективно. Это позволит снизить требования к хранению данных и оптимизировать производительность аналитических запросов за счет минимизации объема данных, которые необходимо передавать и обрабатывать.
- Поддержка Query Pushdown. Query pushdown - это техника, которая предполагает перемещение частей запроса (например, фильтров) на уровень хранения, что позволяет более эффективно извлекать и обрабатывать данные. В настоящее время Kafka не поддерживает pushdown запросов, что означает, что все данные должны быть загружены в память и обработаны, даже если требуется только небольшое подмножество. Если бы Kafka поддерживала pushdown запросов, это повысило бы производительность аналитических запросов за счет уменьшения объема данных, которые необходимо загружать в память и обрабатывать.
- Поддержка обновлений и удалений. В настоящее время Kafka спроектирован как журнал, работающий только с приложениями, и хотя существуют обходные пути для обработки обновлений и удалений, они не так просты и эффективны, как в традиционных базах данных. Если бы Kafka мог поддерживать операции обновления и удаления, это сделало бы обслуживание данных более простым и эффективным. Это также сделало бы Kafka более полным и универсальным решением для хранения данных, повысив его пригодность в качестве озера данных. Для многих организаций такое добавление стало бы переломным моментом, упростив архитектуру данных и снизив накладные расходы, связанные с их обслуживанием.
Заключение
Принятие Kafka в качестве нового Data Lake представляет собой фундаментальный сдвиг в управлении данными и их анализе. Его расширенные возможности в сочетании с добавлением системы обработки потоков и аналитического механизма реального времени делают его надежным фундаментом для построения архитектуры «озера данных». Более того, его пригодность для хранения данных, способность служить единым источником истины и богатая экосистема еще больше укрепляют его позиции в качестве жизнеспособного варианта Data Lake. Посмотрим, как будет развиваться Kafka и другие платформы потоковой передачи событий в ближайшем будущем.


