

Аналитика: обработка данных с помощью Trino
Trino - это open-source движок запросов, способный выполнять запросы к различным хранилищам данных.
Trino, ранее известный как Presto SQL, - это распределенный SQL-движок с открытым исходным кодом, предназначенный для аналитики Big Data. Разработан для обеспечения высокой производительности и масштабируемости интерактивных аналитических запросов к большим массивам данных.
Представляем Вашему вниманию краткий обзор того, как именно можно использовать Trino в аналитических целях.
В зависимости от требований каждого конкретного проекта мы выбираем самые разные хранилища данных, такие как RDBMS, NoSQL DB, очереди сообщений, эластичные хранилища данных и т.д.
Основная проблема с некоторыми из них заключается в том, что, несмотря на то, что они очень хорошо справляются со своими основными задачами, заглянуть в них или написать произвольный запрос и получить из него какие-то конкретные данные очень сложно.
Рассмотрим Kafka. Данное решение идеально в плане выполнения функций системы обмена сообщениями, но у нас были случаи, когда мы хотели проверить данные в очереди, чтобы узнать, были ли произведены определенные пакеты данных, сколько раз они были произведены, когда они были произведены и т. д., и сделать это было очень сложно.
Некоторые NoSQL БД позволяют пользователям выполнять запросы только по ключам разделов, и если нам нужно время от времени выполнять запрос по какому-то произвольному столбцу, то сделать это невозможно (единственный выход - экспорт данных в какую-то платформу хранения данных или создание дублирующих таблиц в самой базе данных с нужными ключами разделов).

Наконец, мы не можем запросить данные из нескольких различных источников данных и объединить их в целях создания единого набора данных.
Один из способов сделать все это, как уже говорилось ранее, заключается в экспорте данных в Data Lake и переиндексировании данных непосредственно в целевой системе.
В большинстве случаев это работает. Но что, если Вы не хотите часто запрашивать эти данные? В этом случае их экспорт в Data Lake - лишь пустая трата дискового пространства.
Что делать, если Вы хотите запросить только самые последние данные? Большинство заданий по экспорту выполняются раз в день, в основном в конце дня.
Далее, каждый источник данных имеет свой собственный синтаксис для запроса данных, поэтому полезно иметь один язык, который позволяет делать запросы сразу из всех источников данных.
Trino позволяет запрашивать данные на месте, без необходимости их перемещения или переиндексирования.
Trino был создан как проект Presto внутри Facebook, он был разработан для быстрой обработки запросов к большим наборам данных. Его разработчики утверждают, что он используется для запросов к петабайтам данных.
Facebook выложил Presto в открытый доступ в 2013 году, в течение нескольких последующих лет он получил широкое признание в индустрии данных. В 2020 году команда, работавшая над Presto, переименовала его в Trino.
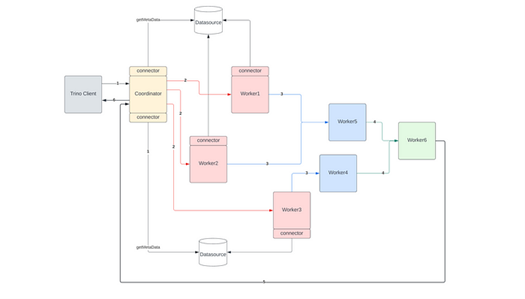
Как видите, в Trino есть координатор, рабочие узлы и коннекторы.
Когда пользователь отправляет запрос к определенному источнику данных через клиента Trino, в первую очередь он попадает к координатору, который затем разбирает этот запрос и запрашивает отдельные источники данных на предмет метаданных. Эти метаданные сообщают Trino, как эти данные хранятся и индексируются в целевом источнике данных. Используя эту информацию, он создает план запроса, запускает несколько рабочих узлов и назначает им задания для запроса целевого источника данных.
Затем рабочие узлы запрашивают часть данных, за которую они отвечают, и отправляют результат своего запроса вышестоящим рабочим узлам. В конце потока данные, полученные от нескольких рабочих узлов, соединяются вместе и возвращаются координатору, который передает их клиенту.
Взаимодействие между координатором и рабочими узлами, а также между самими рабочими узлами происходит через REST по HTTP/HTTPS.
Список коннекторов Trino доступен по следующей ссылке: https://trino.io/docs/current/connector.html
Установка
Инструкция по установке и настройке Trino доступна по ссылке: https://trino.io/docs/current/installation/deployment.html
Для начала установите JRE и JDK.
sudo apt update
sudo apt install openjdk-11-jre-headless
sudo apt install default-jre
wget <URL to the .tgz file>
Настройка
Распакуйте файл .tgz, перейдите в каталог etc. Теперь нужно добавить некоторые настройки.
После добавления всех файлов дерево файлов будет выглядеть следующим образом.
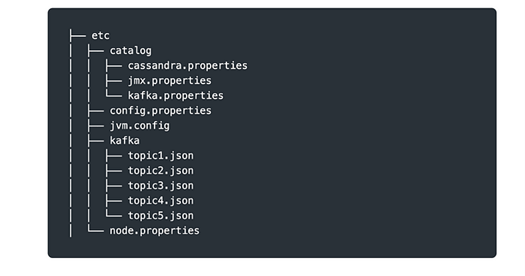
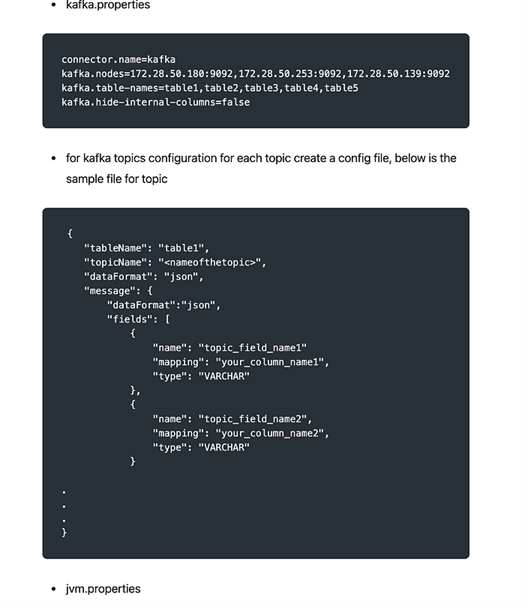
Ниже приведены примеры конфигурационных файлов, которые я использовал для Kafka и Cassandra:
- config.properties
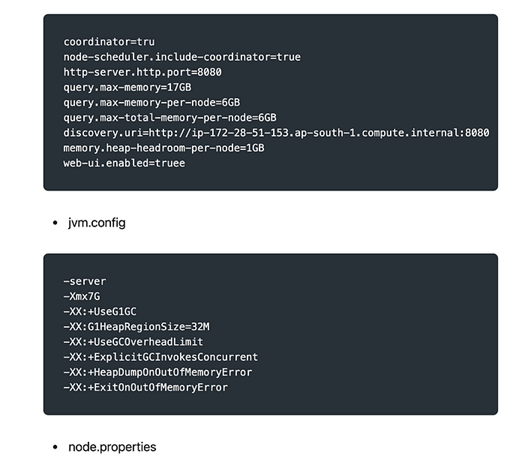
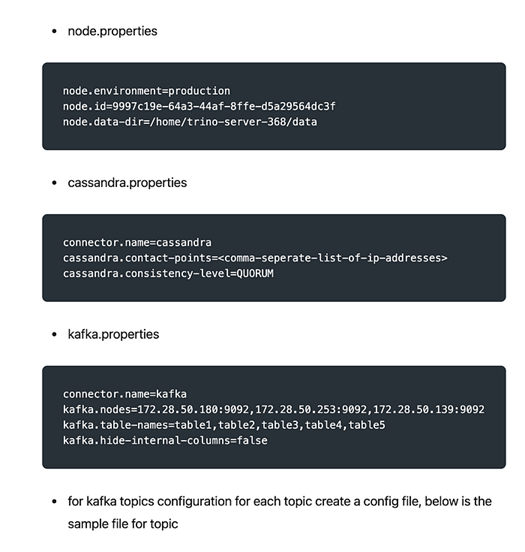
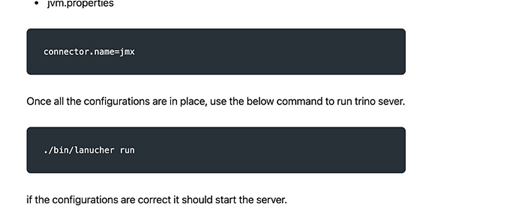
Если все настройки верны, то сервер должен запуститься.
Клиент Trino
Для запроса данных из настроенных источников данных Вам нужен клиент Trino. Настройка клиента Trino очень проста, следуйте инструкциям, доступным по ссылке: https://trino.io/docs/current/installation/cli.html
Это было очень краткое введение в Trino. Если Вам не нравится работать с клиентом Trino, Вы можете интегрировать его с Apache Superset. Наконец, Trino также предлагает jdbc driver, который позволяет подключаться к Trino из любого java-приложения.


