

Потоковая передача данных Postgres с помощью Apache Kafka и Debezium | ETL в режиме реального времени
Используем Apache Kafka, Debezium и Postgres правильно.
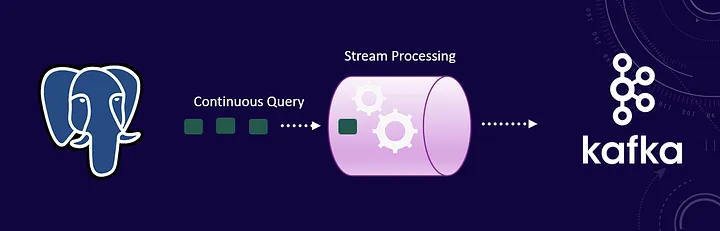
Сегодня мы продолжим говорить о потоковой передачи данных Postgres в Apache Kafka. Ранее мы установили среду и применили все настройки, необходимые для потоковой передачи данных из Postgres. Мы также установили Apache Kafka, Debezium и все остальные важные компоненты, а также настроили БД Postgres на потоковую передачу данных. В первую очередь нам нужна таблица, из которой мы будем брать данные. Во время Python ETL сессии мы загрузили несколько таблиц. Для организации потоковой передачи данных предлагаю воспользоваться таблицей FactInternetSales , содержащей транзакции по продажам. Представим, что информация о транзакции продажи приходит каждые несколько секунд, и нам надо сразу же передать ее в топик Kafka.
- Из этой статьи Вы узнаете о том, как:
- настроить Postgres на потоковую передачу данных
- передавать изменения, произошедшие в БД, в топик Kafka
- настроить коннектор потоковой передачи данных Postgres - Kafka
- организовать потоковую передачи данных консюмера через Python Kafka Consumer
Если Вам удобнее работать с видео-материалом, тогда предлагаю Вашему вниманию подробное видео на YouTube .

Таблица для потоковой передачи данных
Создадим новую таблицу, из которой в дальнейшем мы будем передавать данные. Она должна содержать специальные столбцы. Данная таблица будет служить источником данных для нашего топика Kafka.
CREATE TABLE IF NOT EXISTS public.factinternetsales_streaming
(
    productkey bigint,
    customerkey bigint,
    salesterritorykey bigint,
    salesordernumber text COLLATE pg_catalog."default",
    totalproductcost double precision,
    salesamount double precision
)

TABLESPACE pg_default;

ALTER TABLE IF EXISTS public.factinternetsales_streaming
    OWNER to postgres;
Инкрементальная загрузка данных
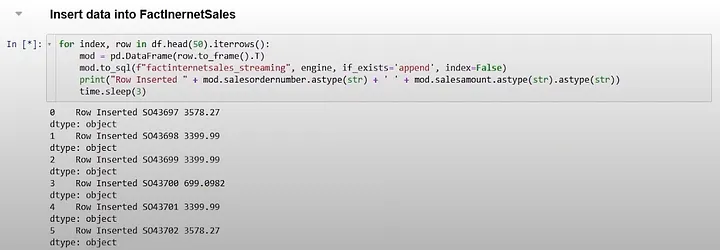
Мы должны вставлятьстроки в таблицу по одной за раз. Чтобы не делать этого вручную, примените специальный скрипт, как это сделал я. Это будет чем-то похоже на Python ETL серии. Когда мы выполним этот скрипт, он вставит строки так, как если бы это делало приложение, записывающее данные в БД. Так мы настроим нашу таблицу на потоковую передачу данных.
engine = create_engine(f'postgresql://{uid}:{pwd}@{server}:{port}/{db}')
df = pd.read_sql('Select * from public.factinternetsales', engine)
df = df[['productkey', 'customerkey', 'salesterritorykey', 'salesordernumber', 'totalproductcost', 'salesamount']]
#
for index, row in df.head(100).iterrows():
    mod = pd.DataFrame(row.to_frame().T)     mod.to_sql(f"factinternetsales_streaming", engine, if_exists='append', index=False)
    print("Row Inserted " + mod.salesordernumber.astype(str) + ' ' + mod.salesamount.astype(str).astype(str))
    time.sleep(3)
Коннектор Kafka Postgres
Переходим к настройке Kafka. Для организации потоковой передачи данных из Postgres мы можем использовать Debezium (при этом никакого дополнительного кода нам не нужно). Все, что нам нужно сделать – это настроить коннектор. Конечная точка нашего Debezium API: localhost:8083. Настройка коннектора выглядит следующим образом:
{
    "name": "source-productcategory-connector",
    "config": {
        "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
        "database.hostname": "your-host-ip",
        "database.port": "5432",
        "database.user": "user",
        "database.password": "password",
        "database.dbname": "AdventureWorks",
        "plugin.name": "pgoutput",
        "database.server.name": "source",
        "key.converter.schemas.enable": "false",
        "value.converter.schemas.enable": "false",
        "transforms": "unwrap",
        "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState",
        "value.converter": "org.apache.kafka.connect.json.JsonConverter",
        "key.converter": "org.apache.kafka.connect.json.JsonConverter",
        "table.include.list": "public.factinternetsales_streaming",
        "slot.name" : "dbz_sales_transaction_slot"
    } }
Kafka Python Consumer
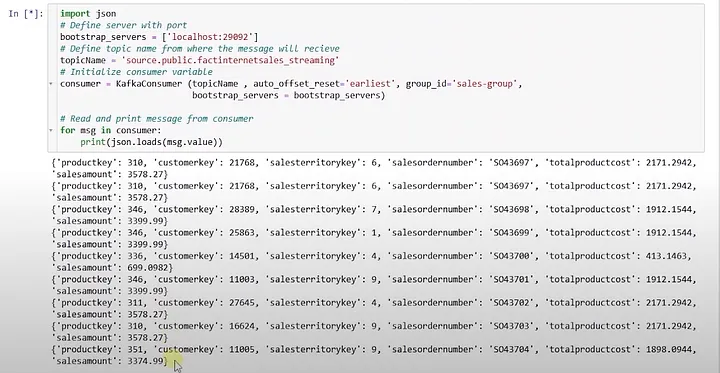
Воспользуемся Python Kafka Consumer, который будет подписываться на топик, связанный с нашей таблицей. Для этого добавим дополнительный параметр к этому консюмеру, называемому идентификатором группы. Это гарантирует, что мы прочитаем сообщение только один раз. Если мы остановим консюмера и повторно запустим его, он больше не будет читать те же сообщения. Он помнит последнее сообщение, которое он прочитал, и продолжит с этого момента. Запускаем этот консюмер и наш скрипт, который через равные промежутки времени будет вставлять данные в исходную таблицу.
Если мы вернемся к нашему консюмеру, то увидим, что изменения в базе данных успешно передаются в топик. Наш консюмер получает эти изменения и сразу же отображает их. Мы успешно транслируем изменения базы данных в топик Kafka, и одновременно наш консюмер Python читает этот поток из топикаKafka. Таким образом, мы успешно транслируем данные из Postgres в Kafka с помощью Debezium.
Заключение
- Мы продемонстрировали, как настроить базу данных Postgres для потоковой передачи данных в режиме реального времени.
- Для потоковой передачи изменений базы данных в топик Kafka мы создали коннектор Kafka.
- Для инкрементной вставки данных в базу мы создали специальный Python-скрипт.
- Для чтения потока данных из базы данных Postgres в режиме реального времени мы создали Python Consumer.
- Полный код Вы найдете здесь.


