

Планирование миллионов сообщений с помощью Kafka и Debezium
Реализовать высокомасштабную распределенную систему не так-то просто, поскольку традиционное планирование поверх базы данных не масштабируется. Более того, эта задача становится становится еще сложнее при работе с архитектурой микросервисов, поскольку Вы получаете все проблемы распределенных систем, такие как несогласованность данных, двойная запись и проблемы с границами домена.
В этой статье я расскажу Вам о том, как мы в Yotpo реализовали высокомасштабируемое и надежное решение для рассылки сообщений по расписанию с помощью Apache Kafka и Debezium CDC.
В следующих нескольких главах я подробно обосную выбор Debezium CDC в качестве инструмента для планирования сообщений в Apache Kafka.
Мотивация
В рамках нашей деятельности в Yotpo нам необходимо отправлять тонны электронных писем нашим клиентам и не только. Мало того, они могут быть отправлены в будущем, а в пиковое время их количество может достигать миллионов за несколько минут. Поэтому перед нами встала задача планирования отправки писем в больших масштабах.
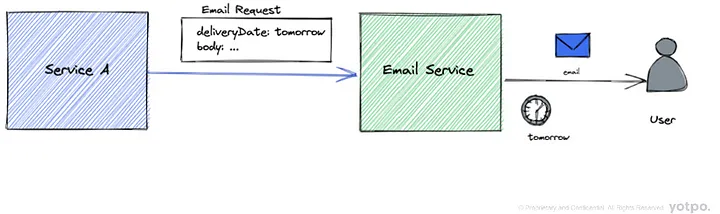
Мое путешествие по традиционным решениям по составлению расписания
Учитывая вышеуказанные требования, я начал изучать традиционные решения для планирования запросов электронной почты и быстро обнаружил, что они не соответствуют многим нашим требованиям. Как хранить все эти электронные письма и планировать их на точную дату доставки в таком масштабе, гарантируя, что все письма будут отправлены в заданную дату?

RabbitMQ - Обмен сообщениями с задержкой
Сначала мы подумали, что это именно то, что нам нужно! Но вскоре, прочитав README плагина, мы обнаружили, что система не масштабируется
Цитата из плагина RabbitMQ:
“Текущий дизайн этого плагина не очень подходит для сценариев с большим количеством отложенных сообщений (например, 100 тысяч или миллионов). Подробности смотри в пункте #72 .”
Более того, это решение означало, что мы не могли сохранить сообщения в наших системах, что создавало недостаток видимости и не позволяло отслеживать и анализировать эти данные.
Планировщик Quartz
Использование Quartz в качестве планировщика и инструмента выполнения заданий не будет масштабироваться для десятков тысяч и выглядит сложным, особенно когда у Вас есть короткие задачи/задания.
Цитата из официальной документации Quartz:
“Функция кластеризации лучше всего подходит для масштабирования долго выполняющихся и/или требовательных к процессору заданий (распределение рабочей нагрузки на несколько узлов). Если Вам нужно масштабировать систему для поддержки тысяч коротких (например, 1 секунда) заданий, рассмотрите возможность разделения набора заданий с помощью нескольких отдельных планировщиков (включая несколько кластерных планировщиков для HA). Планировщик использует общекластерную блокировку, которая снижает производительность по мере добавления новых узлов (при увеличении числа узлов более трех - в зависимости от возможностей вашей базы данных и т. д.)”
БД как хранилище отложенных сообщений для сообщений Apache Kafka
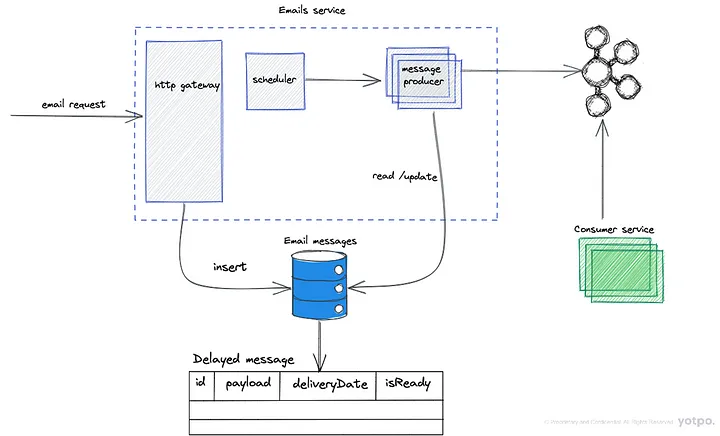
Преимущества:
- Вставка запланированных сообщений в базу данных
- Когда запускается таймер планировщика, ему необходимо запросить базу данных о недоставленных записях и получить блокировку на эти записи, чтобы убедиться в том, что записи будут произведены только один раз
- Производить сообщения в Kafka
- Обновление и фиксация в базе данных
- Потребительский сервис потребляет сообщения и отправляет электронные письма
Недостатки:
- Проблема двойной записи - мы пытаемся писать в две разные системы, т. е. в базу данных и в Kafka, что приводит к несогласованности данных
- Двухфазный коммит не подходит, потому что он не масштабируется
Debezium CDC – оптимальное решение
«Debezium - это распределенная платформа с открытым исходным кодом для сбора данных об изменениях. Запустите ее, направьте на свои базы данных, и Ваши приложения начнут реагировать на все вставки, обновления и удаления, которые другие приложения фиксируют в Ваших базах данных. Debezium долговечен и быстр, поэтому Ваши приложения могут быстро реагировать и не пропускать ни одного события, даже если что-то идет не так».
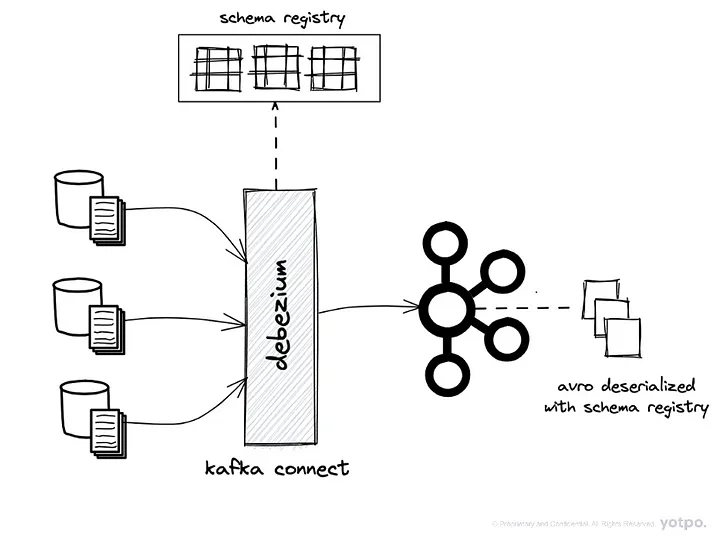
Использование Debezium для передачи запланированных сообщений из базы данных в Kafka
Мы используем Apache Kafka в качестве потоковой платформы и для связи между микросервисами. Как Вы, возможно, знаете, Apache Kafka - это высокомасштабируемая распределенная платформа, способная обрабатывать большое количество сообщений, но она не предоставляет решения для отложенных сообщений. Поэтому нам пришлось искать решение для хранения всех отложенных сообщений до тех пор, пока они не будут готовы к обработке (т. е. планированию).
Поскольку Debezium широко используется в Yotpo в качестве инфраструктуры для захвата данных об изменениях, почему бы не использовать его для решения других проблем, помимо простого CDC? Позвольте мне объяснить, как мы это сделали...
Если мы будем хранить сообщения в базе данных, нам нужно будет только передавать их обратно в Kafka, когда они будут готовы к обработке. Поскольку Debezium отлично справляется именно с этим, и, что еще важнее, в больших масштабах, мы сочли его идеальным вариантом!
Давайте подробнее рассмотрим высокоуровневую архитектуру.
Архитектура высокого уровня (HLA)
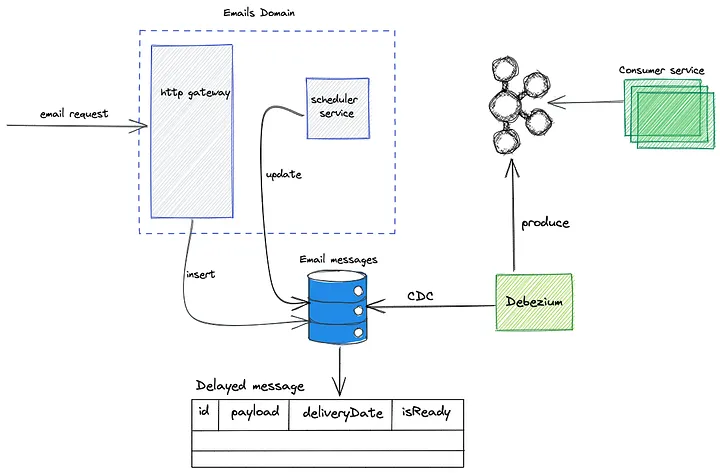
- HTTP-сервер вставляет сообщения в БД с указанием времени доставки
- Отдельное приложение будет служить простым планировщиком cron, который обновляет отложенное сообщение, когда время доставки < NOW и обновление READY - отмечено как true, чтобы быть проигнорированным в следующем цикле cron.
- Debezium будет перехватывать эти обновленные записи (только эти конкретные обновления, подробнее об этом позже) через CDC и передавать эти сообщения в Apache Kafka, готовые для потребления потребителем выполнения
Глубокое погружение в коннектор Debezium
Коннектор Debezium
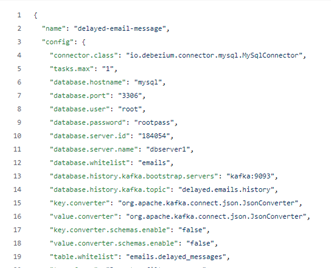
Коннектор настроен на таблицу delayed_messages (строки 19), и будет реагировать только на операции обновления с is_ready=false, измененной на is_ready = true.
Давайте подробнее рассмотрим раздел трансформаторов:
- ExtractNewRecordState — используется для уплотнения сообщений
- Reroute — изменяет тему Debezium Kafka по умолчанию на «email.execution».
- Фильтр — фильтрует сообщения с операцией обновления, которая меняет свой флаг is_ready с false на true. Это гарантирует, что коннектор Debezium выдает сообщение только для этой конкретной операции обновления и игнорирует любые другие операции
- Консюмер выполнения
Простой потребитель Kafka, который потребляет сообщения электронной почты из топика «email.execution» и просто отправляет электронные письма. Кроме того, необходимо оптимизировать конфигурацию потребителя и разделы тем Kafka в зависимости от масштаба.
Преимущества:
- Разделение проблем между планированием и выполнением, что повышает масштабируемость
- Выполнение планировщика не влияет на производительность базы данных
- Согласованность данных - нет проблем с двойной записью
- Отказоустойчивость
- Гибкость
- Возможность хранения в БД любых данных, которые Вам нужны
- Запрос этих данных для аналитических целей
Получите все преимущества Apache Kafka:
- Горизонтальное масштабирование
- Упорядочивание сообщений
- Пакетное потребление для повышения производительности
- Возможности потоковой передачи и многое другое...
Недостатки:
- Сложность – теперь у нас есть 2 дополнительные инфраструктуры, которые необходимо контролировать и обслуживать
Результаты:
Система работает на производстве в течение некоторого времени, на пике запланировано 50 тысяч писем одновременно, результаты следующие:
- запрос планировщика занял 1,25 секунды
- ~250 мс задержки, пока debezium не захватит все 50 тыс. писем из базы данных и не выведет их в тему Kafka - данные были получены из журналов приложения-планировщика и приложения-потребителя писем
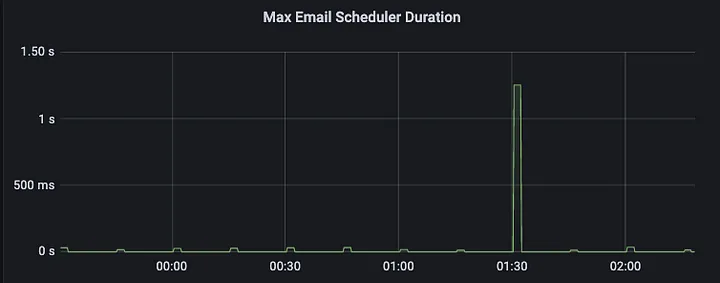
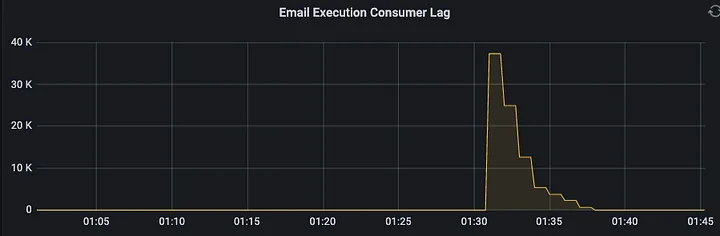
Как видите, планирование происходит очень быстро, и, согласно результатам, мы можем получить около 2,4 миллиона сообщений в минуту! И это при использовании стандартных конфигураций для Debezium и Mysql.
Будущие улучшения
Решение можно улучшить, оптимизировав некоторые подкомпоненты системы, например, наше хранилище баз данных. Создав процесс архивирования старых сообщений или создав разделы по дням, чтобы очистить старые разделы.
Дополнительная оптимизация может быть проведена в приложении Scheduler, оптимизируя запрос обновления для обработки миллионов сообщений одновременно.
Наконец, это решение может быть с открытым исходным кодом, так как оно представляет собой общий механизм отложенных сообщений для Apache Kafka.
Заключение
В этой статье мы рассмотрели, как использовать Debezium Change Data Capture для решения архитектурных задач. Я считаю, что паттерн CDC очень мощный, особенно когда вы объединяете Kafka и Debezium (Kafka Connect), и в будущем его будут использовать все больше компаний.
Мы использовали его для решения проблемы отложенных сообщений, но существует множество других паттернов, помимо CDC, таких как паттерн Outbox и распределенное вытеснение кэша.


