

Анализ изменения данных с помощью Debezium и Apache Pinot
В этой статье мы рассмотрим новый захватывающий мир аналитики в реальном времени, основанный на объединении популярного инструмента CDC Debezium с OLAP хранилищем данных Apache Pinot.
Аналитика в режиме самообслуживания
Аналитика в режиме самообслуживания - это термин, который я придумал для описания создания аналитических приложений с использованием CDC (захват данных об изменениях) вместо того, чтобы напрямую интегрироваться с операционными хранилищами данных. Проблема для организаций заключается в том, что с ростом масштабов бизнеса растет и сложность приложений и баз данных. При добавлении новых функций в приложения единственным способом ускорить процесс является децентрализация контроля над инфраструктурой и архитектурой приложений, чтобы команды самообслуживания тратили меньше времени на ожидание других команд.
Debezium
Debezium - это проект с открытым исходным кодом, спонсируемый RedHat, который фокусируется на том, чтобы сделать CDC как можно более простым и доступным. С сайта Debezium:
Debezium - это распределенная платформа с открытым исходным кодом для сбора данных об изменениях. Запустите ее, направьте на свои базы данных, и ваши приложения начнут реагировать на все вставки, обновления и удаления, которые другие приложения фиксируют в ваших базах данных.
В этом утверждении нет никакого маркетинга, потому что Debezium делает именно то, что описано, и делает это довольно хорошо. На первый взгляд может показаться, что Вы съели слона за один укус, но основы Debezium довольно просты. Я обнаружил, что первый барьер на пути к использованию CDC, в частности для микросервисов, заключается в том, что паттерны и практики хорошо проработаны, а сценарии использования не совсем понятны.
Вот три наиболее ценных сценария использования, которые я выявил на данный момент. Их, конечно, на самом деле гораздо больше.
- Аналитика данных об изменениях (простой аудит)
- Поиск событий (запрос главного представления распределенных данных домена)
- Внутренние/внешние информационные панели (преобразование данных домена в аналитические сведения)
В этой статье я расскажу о первых двух пунктах, а затем рассмотрю пример с открытым исходным кодом.

Аналитика изменения данных
Распределенные системы могут регулярно требовать большой координации между командами, чтобы убедиться, что несоответствие данных не оставит клиента или пользователя приложения в состоянии «внутренней ошибки сервера». Если Вы когда-нибудь становились жертвой странной проблемы с технической поддержкой, например, не могли создать новую онлайн-аккаунт для услуг сотовой связи, потому что старый аккаунт уже использовал Ваш номер телефона и электронную почту - подобных проблем достаточно, чтобы вскружить Вам голову.
Проблема здесь заключается в том, что проблему несоответствия данных необходимо диагностировать на уровне базы данных, так как не существует хорошего прецедента для такого рода «крайних случаев» при миграции новых микросервисов. Подобные проблемы могут заставить вас пройти через несколько уровней представителей технической поддержки, которые, похоже, не могут понять, что происходит. В конце концов, они могут сказать Вам, что решение проблемы невозможно без инженерной поддержки. Тогда инженер технической поддержки должен отладить несоответствия данных, привязанных к вашему номеру телефона и/или адресу электронной почты.
Ниже приведен пример события изменения данных, сгенерированного Debezium для обновления записи клиента в базе данных MySQL для учетных записей.
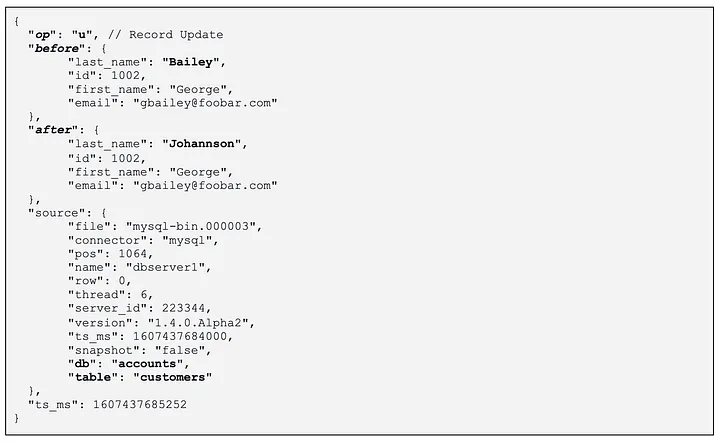
В приведенном выше примере события изменения Вы можете получить точное представление о том, что произошло на уровне базы данных с учетной записью клиента. Проблема в том, что вам нужна база данных этих изменений, чтобы иметь возможность запросить журнал. Загрузив события изменений в Apache Pinot с помощью Debezium и Kafka, Вы сможете запрашивать каждое изменение базы данных для учетных записей клиентов в режиме реального времени.
Теперь, вместо того чтобы заходить в каждую отдельную систему записей, чтобы выяснить, где существует несоответствие данных, инженеру службы поддержки достаточно запросить все изменения в любой учетной записи, привязанной к электронной почте или номеру телефона. Это очень важно для выявления и предотвращения подобных дефектов в будущем, а также дает командам разработчиков возможность видеть дальше хранилища данных своего микросервиса.
Поиск источников событий
Что замечательно в поиске источников событий , так это то, что он становится машиной времени для понимания состояния приложения или функции в определенный момент в прошлом. Системы контроля версий - отличный пример того, как поиск событий может быть ценным с точки зрения функции приложения.
Преимущества, которые Вы получаете от поиска событий, должны быть действительно сопоставлены с потенциальными затратами на дополнительную сложность приложения. Если использовать такой инструмент, как Debezium, для сбора событий данных об изменениях из базы данных вашего приложения, то поиск событий становится гораздо более простым для масштабирования среди команд разработчиков, что избавляет разработчиков от необходимости выполнять дополнительные тяжелые работы в исходном коде своего приложения.
Когда события изменений в Вашей базе данных поступают в хранилище, которое надежно хранит журнал изменений каждой записи, эти записи могут быть впоследствии рематериализованы для новых функций и приложений. Используя OLAP-хранилище данных, такое как Apache Pinot, вы можете создавать проекции на основе событий на весь домен, соединяя записи вместе на границе разных хранилищ данных. Pinot - идеальный инструмент для этого, поскольку большой объем данных о событиях изменений в базе данных не очень хорошо подходит для запросов в оперативных хранилищах данных или реляционных базах данных.
Запросы к изменениям данных с Pinot
Представим для примера, что Debezium передает события данных об изменениях из множества баз данных разных форматов - от NoSQL до RDBMS - в многочисленные темы Kafka, которые затем попадают в Pinot. На практике сделать что-то подобное обычно не очень просто, но и Debezium, и Pinot разграничивают свои обязанности, работая очень хорошо с Kafka.
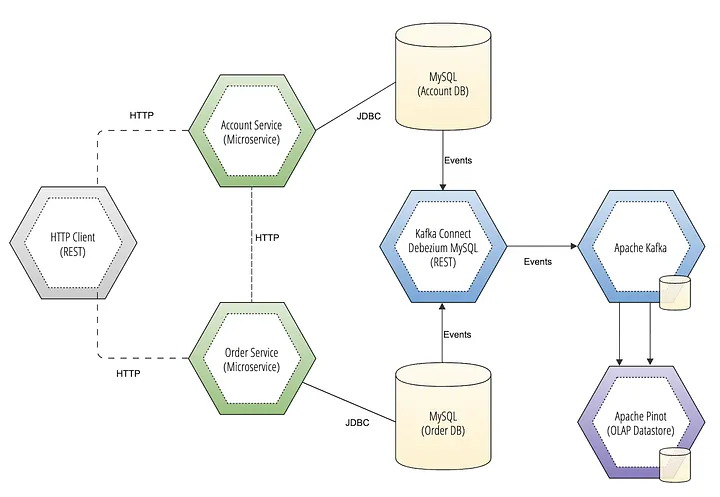
С обеих сторон Вы обращаетесь к Kafka для репликации доступного для запросов представления событий данных об изменениях, что дает Вам возможность запрашивать записи в базе данных практически в режиме реального времени без необходимости подключения к системе записи.
Пример
Теперь, когда мы рассказали о том, почему стоит использовать Debezium и Pinot вместе для различных сценариев использования, давайте рассмотрим рабочий пример. В качестве примера я возьму упрощенную микросервисную архитектуру из примера, который я упоминал ранее.
Основная цель этого упражнения - понять, как просто перенести события данных об изменениях из MySQL в Pinot с помощью Debezium и Kafka Connect. Репозиторий GitHub для этого примера.
Сначала запустите Docker compose. Файл compose содержит несколько контейнеров, включая Apache Pinot и MySQL, а также Apache Kafka и Zookeeper. В Debezium также есть служба коннекторов, которая управляет конфигурациями для различных коннекторов, которые Вы планируете использовать для различных баз данных. В данном случае мы используем MySQL.
$ docker-compose up
Выполните следующую команду в другой вкладке терминала после того, как убедитесь, что все контейнеры запущены и прогреты. Вы можете проверить состояние кластера, перейдя в менеджер кластеров Apache Pinot по адресу http://localhost:9000.
$ sh ./bootstrap.sh
Теперь откройте консоль запросов Pinot (http://localhost:9000/#/query) и выполните следующую команду SQL (вы можете получить SQL-запрос из репозитория GitHub).
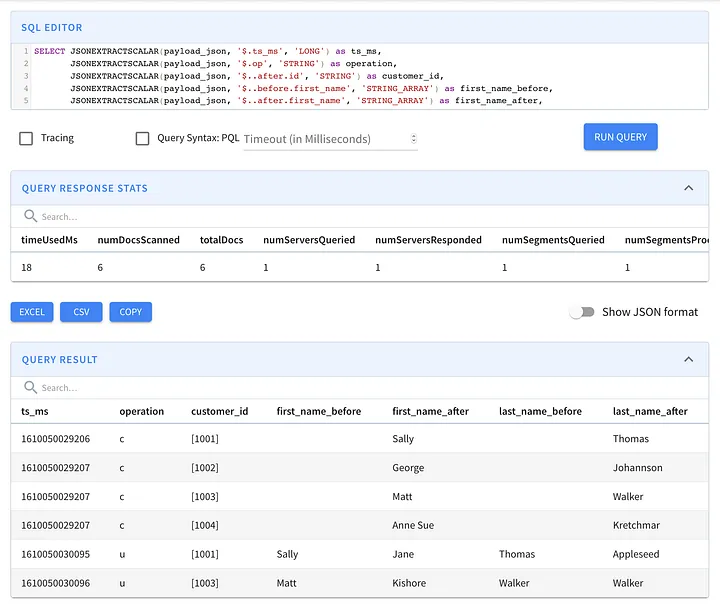
В результатах, показанных на изображении выше, вы можете увидеть список изменений записей базы данных для имени и фамилии клиента. Второй столбец - это тип операции, которая в данном примере либо создана, либо обновлена. Затем следует идентификатор клиента, а за ним - состояние до и после изменения имени и фамилии клиента.
Заключение
Apache Pinot и Debezium - еще один пример двух замечательных инструментов с открытым исходным кодом, которые работают вместе для решения различных сложных задач. Эта запись в блоге, как я надеюсь, станет первой в серии статей, в которых мы глубже рассмотрим те случаи использования, о которых я говорил ранее.


