

Как мы организуем 2000+ моделей DBT в Apache Airflow
В последние годы DBT (Data Build Tool) зарекомендовал себя как основной рабочий процесс преобразования данных, подключаемый к различным процессорам обработки благодаря надежному способу объявления преобразований на SQL с использованием шаблонов Jinja. Наряду с этим он обеспечивает хорошую поддержку документации, тестирования и пакетов, созданных сообществом для расширения собственных возможностей. Это, безусловно, сделало работу в ELT намного проще и приятнее.
Несмотря на то, что DBT Core заботится о линейности между моделями, в нем нет решения того, где и когда он должен выполняться в производственной среде. Другими словами, он не поставляется с оркестровкой из коробки.
Из этой статьи Вы узнаете о том, как мы использовали Airflow для оркестровки нашего проекта DBT Core, создав интуитивно понятный конвейер, который позволил аналитикам данных и даже владельцам продуктов создавать и поддерживать свои собственные модели данных. Используя всего лишь SQL и основы Git, разные люди в бизнесе могут увидеть, как их модели превращаются в группы DAG Airflow в течение всего лишь нескольких минут, полностью готовые к выполнению в распределенной и масштабируемой среде, со встроенными оповещениями, тестами качества данных и контролем доступа. И самое главное: не нужно знать, что такое Airflow DAG - кроме взаимодействия с ней в пользовательском интерфейсе.
Давайте разделим это на 2 ключевые области: Моно vs Мульти подход DAG
- Структура проекта и расположение DAG
- Конвейер генерации DAG
- Как и зачем мы создали наш DBTOperator
- Заключение и дальнейшая работа
Моно vs Мульти подход DAG
Интуитивно понятным способом решения этой проблемы является моделирование всего проекта DBT как «одной большой группы DAG». Это облегчает соединение задач, учитывая линейку DBT, и обеспечивает хороший вид линейки всего проекта DBT в Airflow.
Однако подход Mono DAG имеет ряд недостатков, которые были очень важны для нас на момент начала проекта:
- Поскольку расписание задается на уровне группы DAG, это означает, что весь проект будет выполняться по одному и тому же расписанию. Это проблематично, если у Вас разные SLA для моделей в проекте.
- В этой большой группе DAG может быть трудно ориентироваться. Если же в Вашем проекте 2000 с лишним моделей, найти путь в этой гигантской группе DAG может быть непросто, особенно для аналитиков и бизнесменов, не привыкших к Airflow.
- Он крайне неэффективен для управления доступом. Поскольку у нас есть разные команды, владеющие разными частями проекта DBT, нам нужно использовать это разделение и в Airflow: только Ваша команда должна иметь возможность вручную запускать ваши модели или, например, принимать решение о полном обновлении. Наличие одной большой группы DAG означает наличие одного уровня управления доступом для всего проекта.
- Может быть сложно разделить уведомления в случае сбоя модели. Опять же, мы хотели уведомлять только соответствующие команды в случае сбоя модели.
Очень важное замечание: мы начали наш проект задолго до того, как DBT выпустил встроенную поддержку нескольких проектов. Несмотря на то, что DBT Core доступен не полностью, DBT mesh вполне может стать способом разделения проекта и сделать работу с одной DAG на проект менее сложной.
Разделение проекта DBT на несколько групп DAG
Чтобы решить эти проблемы, мы решили разделить проект на различные группы DAG в соответствии с правилами группировки, которые имеют смысл для нашей организации. Таким образом, мы можем установить различные SLA для разных частей проекта, контроль доступа на уровне DAG и различные цели для оповещений и уведомлений в функциях обратного вызова. Кроме того, команда может легко отфильтровать только свои группы DAG и получить лучший опыт просмотра своих моделей в Airflow.
Однако возникают различные вопросы, такие как: как мы решаем, какие модели группировать в DAG? И как связать зависимые группы DAG?
Эти важные вопросы помогли нам разработать то решение, которое мы имеем сегодня. Важно отметить, что для нас не так уж важно иметь возможность видеть полную линейку DBT в Airflow. Для исследования данных мы используем Datahub, который предоставляет очень красивый вид линии. Поэтому мы решили использовать Airflow для максимально эффективного управления выполнением модели, а не в качестве инструмента для поиска данных.
Структура проекта и расположение групп DAG
Размышляя над упомянутыми ранее вопросами, мы пришли к концепции групп моделей. Группа моделей - это набор преобразований данных, которые тесно связаны друг с другом: например, таблицы из одного и того же хранилища данных, которые должны обновляться вместе и имеют смысл только как единое целое. Кроме того, они принадлежат одной командой. Группа моделей предназначена для достижения какой-либо цели в бизнесе: выполнения промежуточных преобразований и подготовки группы таблиц, создания витрин данных, расчета KPI и т. д.
Поэтому мы решили создать одну группу DAG для каждой группы моделей, поскольку модели тесно связаны друг с другом и должны разрабатываться вместе.
Минималистичная структура проекта, представленная ниже, может помочь в понимании задумки.
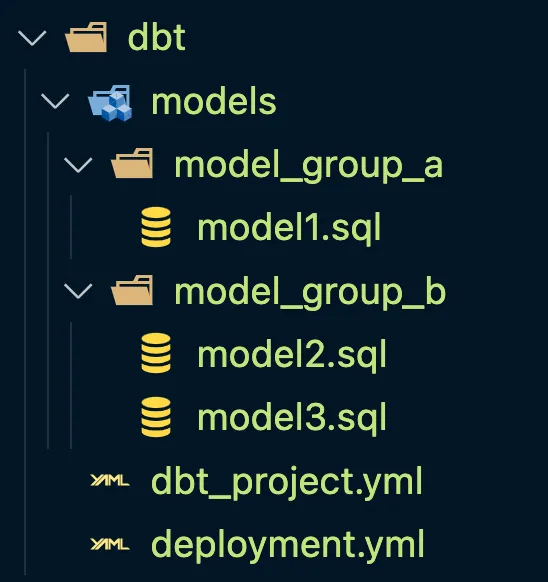
Давайте разберемся, что к чему:
- dbt_project.yml: это Ваш обычный файл dbt_project в корне проекта. Здесь нет ничего особенного.
- deployment.yml: в этом файле Вы регистрируете группы моделей для развертывания - т. е. для преобразования группы моделей в DAG. Вы также указываете расписание запуска, теги, владельцев и т. д. Это будет выглядеть следующим образом:
# deployment.yml
---
model_groups:
  - name: model_group_a # this is the name of the folder.
    schedule: 0 0 * * * # this is the DAG schedule.
    owner: Team_A # This is the owner of the DAG in Airflow (role).
    tags: [tag1, tag2] # Tags for the Airflow DAG
    description: This prepares tables for further transformation. # DAG description.

  - name: model_group_b
    schedule: 0 2 * * *
    owner: Team_A
    tags: [tag1, tag2]
    description: Creates a data mart by joining multiple tables.
model_group_a и model_group_b: папки, содержащие модели SQL (аналогичным образом работают и модели DBT Python). Для данного примера рассмотрим, что model2.sql ссылается на model1.sql в model_group_a как зависимость. Группа_моделей - это не что иное, как папка в проекте DBT, содержащая модели. Вы можете поместить в нее сколько угодно моделей, и она также позволяет генерировать DAG для вложенных папок.
В Airflow эта структура будет выглядеть следующим образом:
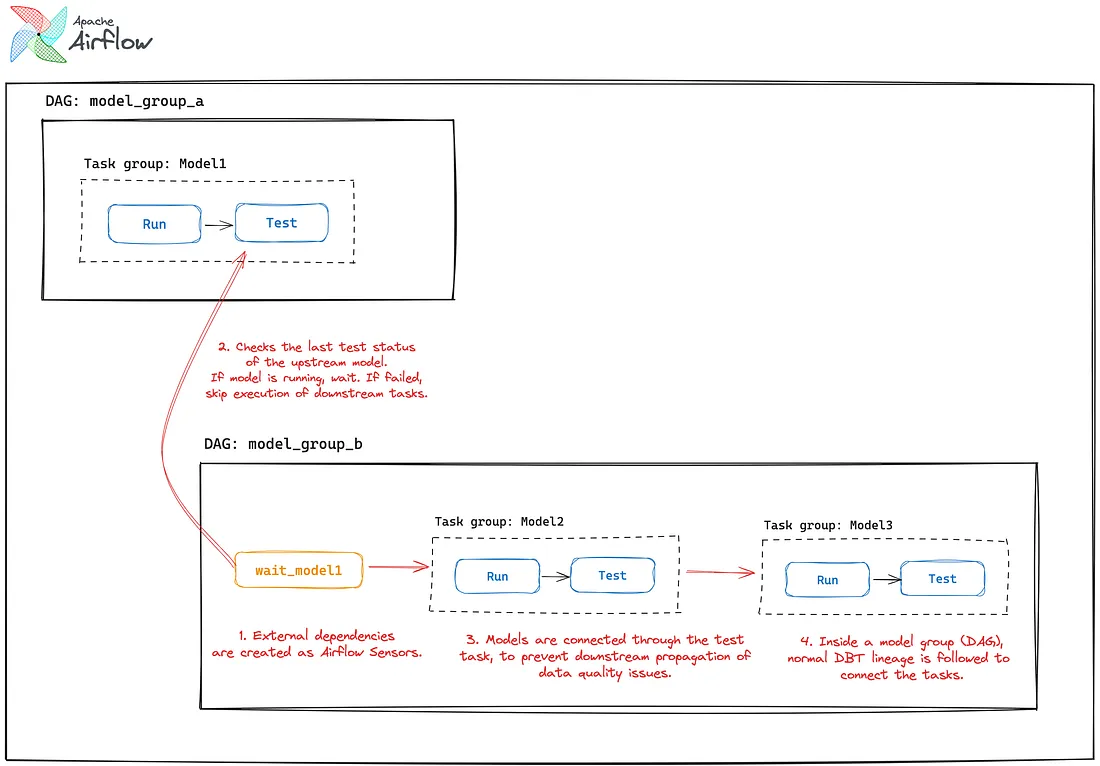
Благодаря такой структуре мы обеспечиваем несколько важных моментов:
- Зависимые группы DAG связаны между собой датчиками: Это позволяет каждой группе моделей выполняться по своему расписанию и в то же время предотвращает распространение сбоев вниз по потоку. Если проверка датчика не удается, то нижележащие модели пропускаются. Важным замечанием здесь является то, что нам пришлось форкнуть родной датчик внешней задачи Airflow. Это связано с тем, что мы хотели проверять последний статус выполнения данной восходящей модели, независимо от даты ее выполнения. Родной датчик позволяет только пощупать конкретные даты выполнения.
- Внутри той же группы DAG линия выполнения основывается на задаче dbt-test: Это предотвращает распространение ошибок качества данных вниз по течению, что позволяет избежать эффекта снежного кома, когда проблемы качества данных становятся все хуже и хуже.
- У каждой группы DAG (группы моделей) есть владелец: это означает, что ручные действия над этой группой DAG (запуск полного обновления, очистка задач и т. д.) могут выполнять только соответствующие члены команды.
- Количество групп DAG и их размер можно изменять, следуя схеме проекта DBT: Поскольку все группы DAG генерируются динамически на основе групп моделей, они могут быть как детализированными, так и большими, как Вы хотите. Количество моделей, содержащихся в группе моделей в проекте DBT, определяет расположение DAG.
Конвейер генерации DAG
Теперь мы рассмотрим, что происходит с того момента, как член команды создает PR в репозитории DBT. В двух словах конвейер развертывания проекта DBT выглядит следующим образом:
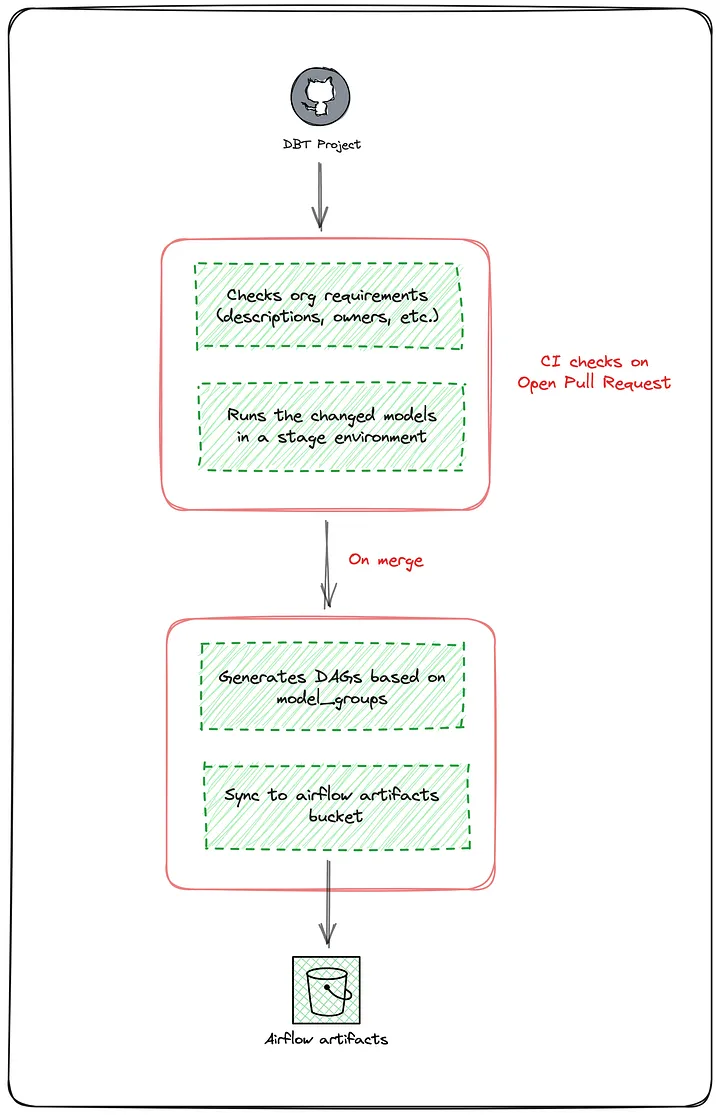
Два очень важных элемента были введены в качестве шагов CI для каждого запроса на выгрузку:
1.Проверка требований к управлению организацией: У каждой модели должен быть владелец и соответствующие теги, описания и т. д. Это очень важно, так как это наполняет Datahub, делая наш каталог данных богатым и содержательным.
2. Запускайте обновленные модели в среде staging: Это гарантирует, что вносимые изменения приведут к успешному запуску как обновляемой модели, так и ее последующих зависимостей. Наша область постановки для CI-прогона DBT содержит репрезентативные образцы производственных моделей, что позволяет минимизировать затраты на проведение CI-тестов. Правильное тестирование моделей DBT в CI - это отдельная тема, которая потребует отдельного поста.
После слияния PR запускается наш процесс генерации DAG. Он работает, разбирая файл DBT manifest.json, чтобы получить полный граф. Затем, в соответствии с правилами групп моделей, определенными в deployment.yaml, создаются различные DAG.
Важной концепцией здесь является различие между «внутренними» и «внешними» моделями при разборе манифеста DBT. Внутренние модели - это те, которые содержатся в соответствующей группе моделей, в то время как внешние модели - это их зависимости за пределами данной группы моделей. Используя это разграничение, мы можем назначать соответствующие сенсоры с помощью нашего ExternalLatestTaskSensor, форка родного сенсора внешних задач Airflow. Мы модифицировали запрос к базе метаданных, чтобы получить последнее состояние вышестоящей задачи (упорядоченное по дате выполнения), так что датчик проверяет последний результат dbt-теста для вышестоящей задачи.
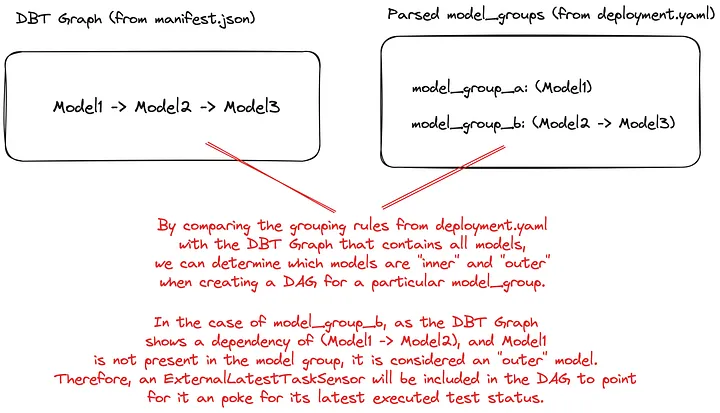
Таким образом, каждая группа моделей также связана между собой датчиками, что позволяет им работать по индивидуальному расписанию. Другим вариантом, который мы рассматривали, было использование TriggerDagRunOperator, но это позволило бы нам установить расписание только для самых верхних моделей.
Сама генерация DAG выполняется с помощью шаблонов Jinja, ведь мы, в конце концов, просто создаем кучу файлов на Python. Все, что нам нужно сделать, это определить, какие модели включить в конкретную DAG, их «внутреннюю» линию и «внешние» зависимости от моделей (сенсоры).
Наконец, когда генерация завершена, DAGs и артефакты проекта DBT отправляются в бакет артефактов Airflow, откуда их забирает другой процесс (запущенный в Airflow).
Как и зачем мы создали наш DBTOperator
Если мы запускаем DBT на Airflow, мы можем либо использовать BashOperator для выполнения команд dbt, либо создать DBTOperator. Последний вариант гораздо предпочтительнее первого, и я чуть позже я объясню, почему стоит задуматься о создании собственного DBTOperator.
Мы начали наше путешествие по DBTOperator, используя реализацию с открытым исходным кодом от проекта Airflow-dbt. Она служила нам верой и правдой в течение нескольких месяцев, но через какое-то время мы поняли, что будет лучше, если мы создадим свой собственный Operator.
Мы хотели использовать программные вызовы DBT вместо команд подпроцесса, которые предлагают лучший способ обработки результатов выполнения, а также полностью соответствуют лучшим практикам. Код стал чище и читабельнее после использования точки входа Python для dbt cli.
Самое главное, мы хотели устранить очевидные ограничения в нашем решении по оркестровке DBT, особенно при ручном вмешательстве для исправления ошибок. Некоторые из этих ограничений перечислены ниже.
Изменения схемы для инкрементных моделей
Ни одна из штатных опций DBT on_schema_change не решила нашу проблему, потому что почти во всех случаях нам приходится заполнять информацию, когда, например, добавляется колонка. Поэтому единственным вариантом в случае изменения схемы является полное обновление всей системы. В итоге мы столкнулись с тем, что значительное количество моделей вышло из строя из-за ожидаемых изменений схемы источника, и на тот момент единственным способом «вызвать» полное обновление было удаление таблицы на Snowflake.
Конечно, это не идеальный вариант. Поэтому одной из первых вещей, которую мы реализовали в нашем пользовательском DBTOperator, была возможность анализа журналов выполнения dbt-run после неудачного запуска. Если в результате разбора журналов мы обнаруживаем, что сбой был вызван изменением схемы, мы автоматически перезапускаем эту модель, передавая флаг --full-refresh. Эта простая возможность позволила нам сэкономить часы на ежедневном обслуживании моделей DBT.
Первичная обработка больших моделей или полное обновление
Иногда при первичной обработке очень большой модели или при запуске ручного полного обновления по разным причинам мы перегружали наше DBT-хранилище Snowflake. Чтобы избежать этого, мы создали функцию в DBTOperator, которая динамически меняет хранилище, используемое для выполнения данной модели, и устанавливает его размер (маленький, средний, большой и т. д.).
Таким образом, все обычные небольшие инкрементные модели могут выполняться на одном и том же хранилище DBT, в то время как огромное выполнение происходит на изолированном хранилище с выделенными ресурсами. Это предотвращает образование очередей выполнения запросов в Snowflake.
Кроме того, мы позволяем аналитикам данных запускать полное обновление из самого интерфейса Airflow, без необходимости сбрасывать таблицы. Все, что делает DBTOperator, - это передает флаг --full-refresh команде dbt run, когда это необходимо.
Ручное включение отдельных моделей в группе моделей
Иногда нашим аналитикам данных требуется запустить только одну или две модели в группе моделей DAG. Иногда эти прогоны должны были полностью обновлять указанные модели.
Для этого мы создали опцию, доступную в качестве параметра Airflow DAG, позволяющую аналитику запускать только определенные модели в группе DAG. Все остальные модели, не выбранные для данной конкретной группы, будут пропущены. Такой подход позволяет не тратить ресурсы впустую, запуская все модели в группе DAG, когда необходимо выполнить только одну или две.
Хотя использование опции очистки задачи в Airflow также является решением, оно не подходит в случаях, когда пользователям необходимо выполнить полное обновление или изменить склад, выполняющий данную модель. Вы не можете настроить прогоны с параметрами, просто очистив задачу в Airflow. Эта настраиваемая опция позволяет аналитикам более точно определить свои потребности, повышая эффективность и гибкость выполнения модели.
Запуск последующих зависимостей после исправления модели
В нашей структуре Airflow-DBT имеется множество DAG, соответствующих группам моделей, и некоторые модели имеют длинную цепочку зависимостей, состоящую из 4-5 DAG. Когда выполнение одной модели (прогон или тест) в первой DAG этой цепочки заканчивается неудачей, все последующие модели в разных DAG будут пропущены, чтобы предотвратить распространение ошибки. Как обеспечить повторный запуск всех последующих групп DAG после исправления первой модели?
Раньше мы делали это вручную. Аналитикам данных приходилось отслеживать нижележащие группы DAG, которые нужно было повторно запускать после исправления модели. Этот процесс отнимал слишком много времени и был чреват ошибками.
Чтобы решить эту проблему, мы создали опцию Trigger Downstream в Airflow DAG, которая работает на основе пользовательской логики в DBTOperator. При установке этого значения во время выполнения DAG, если все модели работают успешно, DAG автоматически получает информацию обо всех зависимостях ниже по течению и запускает DagRun для них. Это устраняет необходимость в ручном процессе запуска DAG после исправления ошибок.
Этот процесс было легко реализовать с помощью команды dbt ls, которая выводит список моделей в графе зависимостей. Затем мы сопоставили их с группами DAG, в которые они входят, и использовали функцию Airflow trigger_dag() для автоматического запуска последующих исполнений.
Что еще более важно, этот процесс автоматически продолжается по принципу «цепной реакции»: запущенная DAG получает флаг аргумента, чтобы после завершения также запустить свои последующие зависимости, продолжая процесс до тех пор, пока последняя DAG в цепочке не будет очищена.
Параметры DAG как интерфейс для выполнения DBT
После реализации всех вышеупомянутых решений в DBTOperator мы также создали параметры DAG, чтобы открыть некоторые конфигурации для пользователей, позволяя им настраивать ручные прогоны.
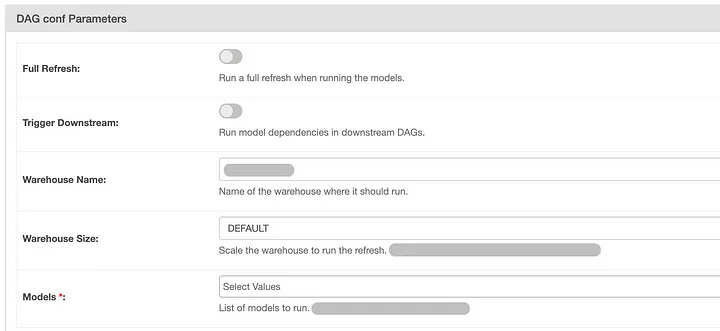
Это существенно изменило повседневную жизнь аналитиков данных и инженеров-аналитиков, которые теперь могут полностью настраивать ручные прогоны, когда это необходимо.
Все эти параметры динамически добавляются в шаблон при автоматической генерации DAG, как объяснялось ранее. Таким образом, для заполнения выпадающего списка Models, например, используются доступные модели в данной группе моделей.
Кроме того, этот метод «введения параметров» в конвейер генерации DAG является достаточно расширяемым, что позволяет нам создавать больше параметров в будущем, когда в этом возникнет необходимость.
Заключение и дальнейшие действия
Я надеюсь, что эта статья поможет Вам взглянуть на оркестровку DBT в Airflow с другой стороны. Хотя эта реализация продолжает служить нашим потребностям даже спустя два года, она далека от совершенства или идеала и может быть улучшена.
Похожую реализацию с открытым исходным кодом можно найти в проекте Astronomer Cosmos. Интересными особенностями здесь являются использование групп задач для совместного выполнения и тестирования каждой модели (как это сделали и мы ), а также чрезвычайно простой и чистый способ объявления DbtDag в конфигурации проекта.
Также можно разделить проект на несколько DAG, поскольку конструктор может принимать аргументы dbt select. Таким образом, Вы можете передать теги и разделить проект, например, по разным тегам. Однако мне неясно, как они работают с возможными взаимодействиями (ссылками на модели) между группами DAG. Если Вы начинаете свой путь оркестровки DBT, Вам определенно стоит проверить его, так как он предоставляет собой чистую абстракцию.
На данный момент то, что ждет нас впереди и сильно влияет на взаимодействие с DBT, - это внедрение контрактов данных. Используя контракт в качестве связующего звена между исходной системой и таблицами в озере данных, мы можем автоматизировать создание коннекторов (экстракторов данных), а также моделей DBT для выполнения начальных (базовых) преобразований, не требующих знаний бизнеса, таких как приведение типов, стандартизация имен столбцов и нестинг сложных полей. Таким образом, некоторые из описанных ранее групп моделей создаются полностью автоматизированным способом на основе контрактов с данными.
Я полностью открыт для дальнейшего обсуждения реализации DBT-Airflow и очень хочу услышать, как сообщество решает эту проблему. Поэтому, если у Вас есть похожая реализация, пожалуйста, напишите мне. Только благодаря сплоченному сотрудничеству мы сможем создать действительно удивительные решения, которые принесут реальную пользу.


