

Apache Parquet: Как стать героем, используя формат колоночно-ориентированных данных с открытым исходным кодом
Формат Apache Parquet подходит для работы с Google BigQuery, Azure Data Lakes, Amazon Athena и Redshift Spectrum.
Apache Parquet хорошо подходит для работы с AWS Athena, PresoDB, Azure Data Lake и Amazon Redshift Spectrum. Каждый сервис позволяет использовать стандартный SQL для анализа данных на Amazon S3.
Однако выбранный формат данных может существенно повлиять на производительность и стоимость, особенно если речь идет о машинном обучении, искусственном интеллекте или других сложных операциях.
Если Вы хотите создать ETL или ELT процесс поглощения данных для data lake, пришло время познакомиться с возможностями формата файлов Apache Parquet.
Что такое Apache Parquet?
Во-первых, мы понимаем, что Вы, возможно, никогда даже и не слышали о формате файлов Apache Parquet. Подобно файлу CSV, Parquet - это тип файла. Разница в том, что Parquet разработан как колоночно-ореиентированный формат хранения данных для поддержки сложной обработки данных.
Apache Parquet - это самоописывающийся формат данных, который встраивает схему или структуру в сами данные. Формат файла использует модель измельчения и сборки записей, которая была разработана в Google. В результате получается файл, оптимизированный для выполнения запросов и минимизации операций ввода-вывода.
В частности, он обладает следующими характеристиками:
- Apache Parquet ориентирован на столбцы и предназначен для эффективного хранения данных по столбцам (блоки, группы строк, куски столбцов...).
- Apache Parquet создан с нуля с использованием алгоритма измельчения и сборки Google.
- Файлы Parquet были разработаны с учетом сложных вложенных структур данных.
- Apache Parquet создан для поддержки эффективных схем сжатия и кодирования
- Apache Parquet позволяет снизить затраты на хранение файлов данных и повысить эффективность запросов к данным с помощью бессерверных технологий, таких как Amazon Athena, Redshift Spectrum, BigQuery и Azure Data Lakes.
- Лицензирована под программным фондом Apache и доступна для любого проекта.
- Поддерживает привычные типы данных, метаданные файлов, автоматическое кодирование словарей

Ассоциация «Big Data» с этим форматом может создать впечатление, что он ограничен конкретными случаями использования. Однако по мере того, как формат выходит из тени сложных решений для работы с большими данными Hadoop, он получает все более широкую поддержку. Например, команды создают недорогие и при этом действительно высокопроизводительные бессерверные стеки бизнес-аналитики с помощью Apache Parquet, Tableau и Amazon Athena.
Parquet vs. CSV
Формат CSV является распространенным и достаточно простым. Многие инструменты, такие как Excel, Google Sheets и множество других, могут создавать файлы CSV. Вы даже можете создавать CSV-файлы с помощью любого инструмента для редактирования текста.
Мы все любим CSV-файлы, но все имеет свою цену, даже Ваша любовь к CSV-файлам, особенно если CSV - формат по умолчанию для конвейеров обработки данных. Цена, спросите Вы? Есть ли у моих CSV-файлов цена? А как же!
- Колоночно-ориентированные базы данных, такие как AWS Redshift Spectrum, или сервисы запросов, такие как AWS EMR (Apache Hive) или Amazon Athena, взимают плату за объем данных, отсканированных за запрос (многие другие сервисы также взимают плату на основе запрашиваемых данных).
- Google и Amazon взимают плату за объем данных, хранящихся на GS/S3.
Использование CSV по умолчанию приведет как к техническим, так и к финансовым последствиям (не самым приятным). Вы научитесь любить формат файлов Apache так же сильно, как и свой верный CSV.
Хотя мы не рассматриваем этот вопрос в данной статье, в будущем мы рассмотрим варианты использования Parquet и ORC.
Почему именно Parquet? Пример: 1 Тб файл CSV
Производительность Parquet (по сравнению с CSV) дает неоспоримые преимущества с точки зрения стоимости, эффективности и гибкости. Ниже показана эффективность и результативность использования файла Parquet по сравнению с CSV.
Преобразование данных CSV в столбцовый формат Parquet, их сжатие и разбиение на разделы позволяет сэкономить средства и получить преимущества в виде более высокой производительности. В следующей таблице сравнивается экономия, полученная при преобразовании данных в различные форматы:
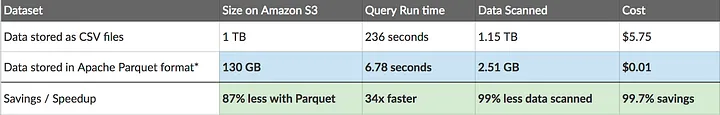
Подумайте вот о чем: Если бы Вы в течение года использовали несжатые файлы CSV объемом 1 ТБ в качестве основы для своих запросов, затраты составили бы 2000 долларов США. При использовании файлов Parquet общие затраты составили бы 3,65 доллара США. Я знаю, что Вы любите CSV-файлы, но так ли сильно? В больших масштабах эти расходы возрастают еще больше!
Кроме того, если время - деньги, то подумайте о следующем: Ваши аналитики тратят около 5 минут на ожидание завершения запроса просто потому, что Вы предпочитаете CSV.
Если Вы платите кому-то 150 долларов в час и делаете это раз в день в течение года, то он потратит около 30 часов только на ожидание завершения запроса. Это примерно $4500 непродуктивного времени «ожидания».
Общее время ожидания для пользователя Apache Parquet? Около 42 минут или $100.
Пример архитектуры Parquet: Redshift Spectrum и Amazon Athena Data Lake
Как выполнять запросы к файлам Parquet? Amazon Athena и Amazon Redshift Spectrum позволяют выполнять запросы Amazon SQL к данным в Amazon S3. Наличие Parquet на s3 может быть эффективной стратегией для команд, которые хотят разделить данные, где резиденты находятся в Redshift, а другие данные - на S3.
Например, предположим, что в таблице historical_purchase в Redshift у Вас около 4 ТБ данных. Поскольку к ней обращаются нечасто, имеет смысл выгрузить ее в S3. Это освободит место в Redshift, но при этом обеспечит доступ Вашей команде через Spectrum. Теперь возникает большой вопрос: в каком формате Вы храните эту таблицу historical_purchase объемом 4 ТБ? CSV? Как насчет использования хранилища данных Parquet?
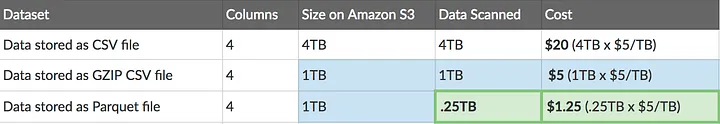
Наша таблица historical_purchase состоит из четырех одинаковых по размеру столбцов, которые хранятся в Amazon S3 в трех файлах.
- Несжатый файл CSV
Несжатый CSV-файл имеет общий размер 4 ТБ. Выполнение запроса для получения данных из одного столбца таблицы требует от Redshift Spectrum сканирования всего файла размером 4 ТБ. В результате такой запрос будет стоить 20 долларов.
- GZIP CSV-файл
Если сжать CSV-файл с помощью GZIP, то его размер уменьшится до 1 ГБ. Вот это экономия! Однако Redshift Spectrum все равно придется сканировать весь файл. Хорошая новость: Ваш CSV-файл в четыре раза меньше, чем несжатый, поэтому Вы платите всего лишь одну четвертую часть того, что платили раньше. Этот запрос стоил бы 5 долларов.
- Образец файла Parquet
Если сжать файл и преобразовать CSV в Apache, то в итоге получится эффективное кодирование 1 ТБ данных в S3. Однако, поскольку формат файла столбцовый, Redshift Spectrum может читать только столбцы, имеющие отношение к выполняемому запросу. Ему нужно просканировать только 1/4 часть данных. Этот запрос обойдется всего в 1,25 доллара.
Если Вы выполняете этот запрос раз в год, использование несжатых CSV-файлов обойдется Вам в $7300. Даже сжатые CSV-запросы будут стоить более $1800. Использование формата файлов Apache обойдется примерно в $460… Все еще предпочитаете CSV-файлы?
Заключение
Тенденция к «бессерверным» интерактивным службам SQL-запросов и готовым пакетам обработки данных только усиливается. Если Вы являетесь постоянным клиентом AWS, то можете столкнуться с проблемой Redshift Spectrum vs. Athena, особенно учитвая факт учитывая совпадения основных функций сервисов.
Однако при правильном подходе озеро данных и формат Parquet открывают перед командами новые возможности для ускорения работы при меньших инвестициях, независимо от механизма запросов.
Когда Вы платите только за выполняемые запросы, очень важно оптимизировать данные, на которые опираются эти системы. Использование Parquet с Athena и Spectrum снижает затраты, а анализ данных с Amazon S3 с помощью стандартного SQL становится чрезвычайно простым.
Кроме того, Google поддерживает загрузку этих файлов в BigQuery, а Microsoft - в Azure Data Lakes. Таким образом, обеспечивается уровень переносимости между облаками.


