

За Apache Iceberg – будущее. Чего ждать от 2025 года?
В течение многих лет сообщество разработчиков данных обсуждало будущее формата открытых таблиц. Победит ли интеграция Databricks? Сможет ли Apache Hudi удержать лидирующие позиции? Или его место займет Apache Iceberg?
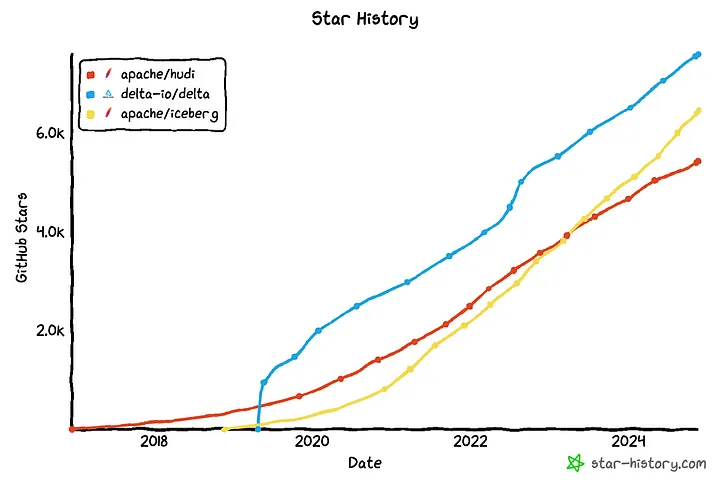
К концу 2024 года стало очевидно, что победил Apache Iceberg.
Как мы к этому пришли? Компанию Databricks купила Tabular, компания, основанная создателями Iceberg, что свидетельствует об одобрении потенциала Iceberg. Тем временем компания Snowflake выпустила Polaris, свой собственный каталог на базе Iceberg. Благодаря тому, что такие известные поставщики механизмов запросов, как Starburst и Dremio, поддержали Polaris, индустрия объединилась вокруг общего стандарта.
Apache Iceberg стал форматом открытых таблиц де-факто. Но это еще только начало истории. Если заглянуть в будущее до 2025 года, то можно выделить несколько моментов, которые закрепят за Iceberg позицию лидера в области современной инженерии данных.
Что будет с Iceberg в 2025 году?
1. Каталог RBAC: Исправление разрешений в масштабе
Давайте признаем, что управление разрешениями в озерах данных всегда было непростым делом. В отсутствие единого подхода пользователям приходилось полагаться на специальные методы, такие как установка разрешений на уровне бакета S3 или использование специфических элементов управления доступом в механизме запросов. Такая фрагментация не только неэффективна, но и создает риски в плане безопасности.
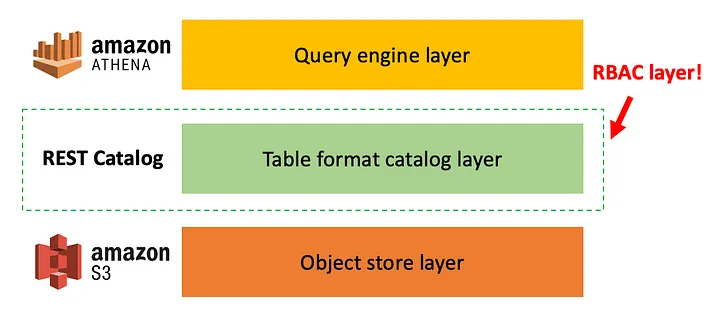
Сообщество Iceberg решает эту проблему с помощью новой спецификации OpenAPI (PR #10722). Эта спецификация стандартизирует структуру продаваемых учетных данных, позволяя разработчикам создавать системы управления доступом на основе ролей (RBAC) непосредственно в каталогах Iceberg.
Например, администратор может определять политики доступа на уровне каталога, независимо от базового хранилища или механизма запросов. Эти возможности отражают функции корпоративного уровня, такие как Unity Catalog от Databricks, с гибкостью и открытостью, которые обеспечивает Iceberg.

2. CDC: эволюция потоковой передачи данных от Iceberg
“Iceberg не для потокового вещания», - мнение, бытовавшее в прошлом. Честно говоря, Iceberg действительно не хватает надежных возможностей CDC. Хотя его архитектура и поддерживает версионированные снимки таблиц (процедуры Spark CDC), она не оптимизирована для высокочастотных изменений данных или аналитики в режиме реального времени.
Все постепенно меняется с появлением Iceberg Spec V3, в котором появилась одна очень важная функция, а именно Row Lineage.
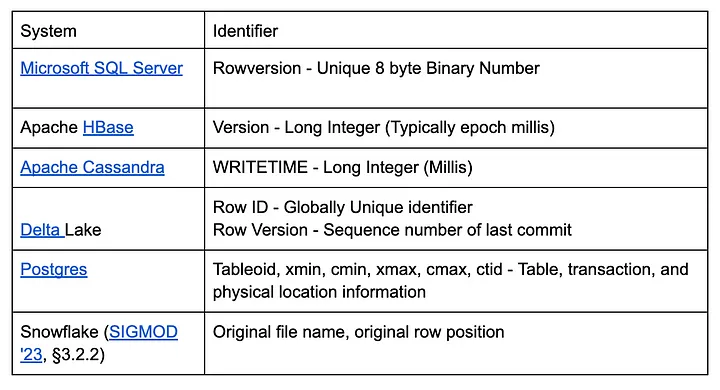
Row Lineage позволяет Iceberg отслеживать изменения отдельных строк при их обновлении, удалении или вставке. Это позволяет реализовать эффективные пайплайны CDC непосредственно на таблицах Iceberg, что является серьезным шагом вперед для потоковых приложений. В частности, обслуживание материализованных представлений и синхронизация данных между системами станут более удобными.
Ознакомьтесь с предложением по спецификации для получения более подробной информации. Когда спецификация V3 будет полностью реализована, Iceberg начнет полноценно конкурировать с традиционными потоковыми системами, такими как Kafka и Hudi, в области обработки данных в режиме реального времени.
3. Материализованные предложения: упрощение производных данных
Озера данных - это место, где хранятся необработанные исторические данные, часто называемые «бронзовыми». Настоящую ценность представляют не они сами, а производные наборы данных, вычисленные на их основе. Это агрегации, преобразования и различные предварительно вычисленные метрики.
До сих пор в Iceberg отсутствовала встроенная поддержка материализованных представлений, что вынуждало пользователей полагаться на внешние системы или собственные решения для управления производными данными. Это создавало две основные проблемы:
- Отслеживание зависимостей между базовыми и производными таблицами слишком громоздко.
- Любое обновление базовой таблицы требует полного пересчета производных данных.
Предлагаемая функция материализованных представлений (PR #11041) в корне меняет эту ситуацию. При использовании материализованных представлений предварительно вычисленные результаты хранятся в виде таблиц, а Iceberg обрабатывает метаданные, необходимые для отслеживания зависимостей. Это означает более высокую производительность запросов и автоматическое обновление производных данных при изменении базовой таблицы. Это также открывает широкие возможности для систем, ориентированных на материализованные представления, таких как RisingWave. Предоставление материализованных представлений для Iceberg может значительно улучшить работу пользователей при извлечении информации из динамических данных.
Экспансия Iceberg
По мере становления Iceberg развивается и его экосистема. Вот несколько областей, за которыми стоит следить в 2025 году:
- Новые типы данных: Поддержка временных меток с точностью до наносекунд и часовых поясов откроет Iceberg для таких отраслей, как финансы и телекоммуникации, где высокая точность данных имеет решающее значение.
- Двоичные векторы удаления: Spec V3 представляет масштабируемое и эффективное решение для обработки удалений, что особенно полезно в области юриспруденции или для соответствия GDPR.
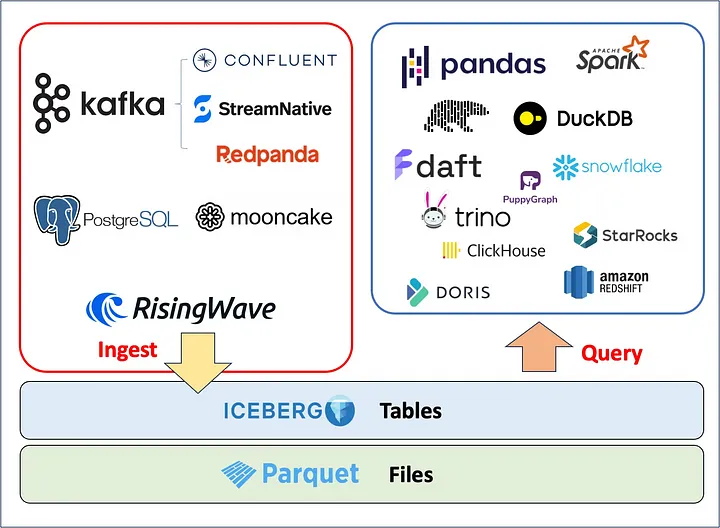
Экосистема Iceberg сильна как никогда. Сегодня Вы можете вводить данные в Iceberg с помощью Kafka или протокола PostgreSQL (через RisingWave) и запрашивать их с помощью современных механизмов запросов, таких как Trino, Snowflake, Databricks, RisingWave и других. В 2025 году на горизонте маячат действительно захватывающие события.
Чего не хватает Iceberg?
Экосистема Iceberg уже сейчас достаточно хорошо развита. Вы можете использовать протоколы Kafka или Postgres (через RisingWave) для получения данных и запросов к ним с помощью различных движков. Но во всем этом есть один серьезный пробел, а именно уплотнение данных.
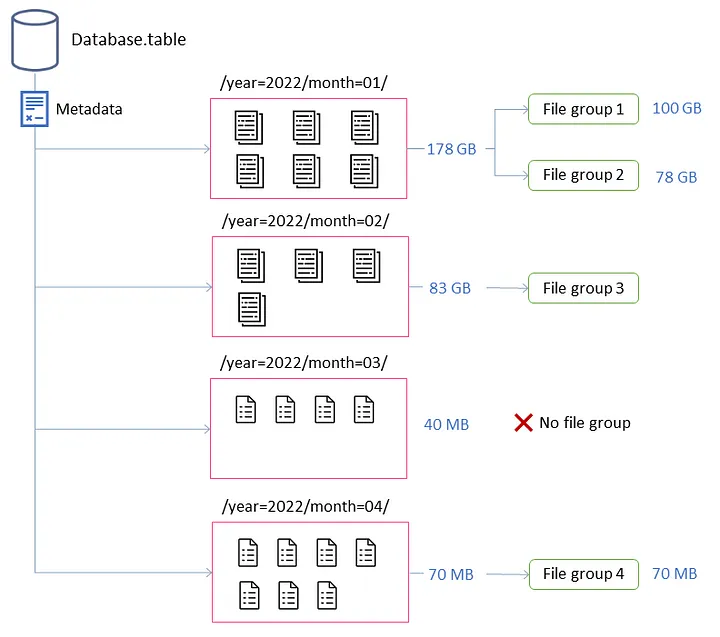
Сегодня для уплотнения обычно используются тяжеловесные задания Spark, которые могут оказаться непосильными для небольших команд или рабочих нагрузок. Это создает препятствия для пользователей SQL и Python, которым нужен более простой и ресурсоэффективный способ уплотнения таблиц Iceberg.
Хорошие новости? Сообщество осознает эту проблему, и стремится к созданию легкого, не зависящего от движка фреймворка. Будем надеяться, что в 2025 году появятся решения, которые сделают Iceberg более доступным для широкого круга пользователей.
Что день грядущий нам готовит
Благодаря таким новшествам, как каталоги RBAC, потоковые возможности, материализованные представления и поддержка новых типов данных, Apache Iceberg постепенно превращается в универсальный формато таблиц для работы с данными.
2024 год доказал, что у Iceberg есть все шансы на победу в войне форматов. В 2025 году мы сосредоточимся на том, чтобы сделать его еще лучше, быстрее и проще в использовании абсолютно для всех - от небольших стартапов до глобальных предприятий. Создаете ли Вы аналитические пайплайны в реальном времени, управляете петабайтами исторических данных или изучаете передовые архитектуры Data Lake, Iceberg совершенно точно есть, что Вам предложить.
Будущее инженерии данных уже наступило, и это Iceberg.


