

Глубокое погружение в новые таблицы Amazon S3
На конференции AWS re:Invent 2024 компания AWS представила таблицы Amazon S3, специализированное решение для масштабируемого хранения и управления табличными данными на основе стандарта Apache Iceberg. Прежде чем погрузиться в изучение таблиц Amazon S3, необходимо понять, что такое «формат открытых таблиц» и Apache Iceberg.
Что такое формат открытых таблиц (OTF)?
В традиционных базах данных процесс создания данных для чтения обычно включает в себя установку программного обеспечения базы данных, создание базы данных, определение схем и таблиц или внешних таблиц, а затем чтение данных из них. В отличие от этого, при использовании открытого формата таблиц данные хранятся непосредственно в файловых форматах, таких как Apache Parquet, Apache ORC или Apache Avro, в рамках озера данных. Вместо того чтобы загружать данные в традиционную базу данных, формат открытых таблиц позволяет организовывать и управлять этими файлами как виртуальными таблицами, которые фактически находятся поверх каталогов файлов.
Для упрощения работы с запросами можно использовать систему каталогов, например AWS Glue Catalog, которая регистрирует эти виртуальные таблицы, позволяя таким механизмам запросов, как Apache Spark, Trino или AWS Athena, беспрепятственно получать доступ к данным и обрабатывать их. Среди доступных форматов открытых таблиц наиболее широко распространены Apache Iceberg, Delta Lake и Apache Hudi. Эти форматы высоко ценятся за их производительность, масштабируемость и расширенные возможности, включая поддержку запросов с временным перемещением и эволюцию схемы.
Apache Iceberg
Apache Iceberg - это формат таблиц с открытым исходным кодом для больших наборов данных в озерах данных, в котором добавлена поддержка ACID-транзакций, эволюции схемы и запросов с перемещением во времени. Он помогает управлять данными в облачных системах хранения, таких как AWS S3 (тип бакета - general purpose), делая озера данных похожими на традиционные базы данных с улучшенной производительностью, целостностью данных и гибкостью для аналитических рабочих нагрузок.
До сих пор существовало только два типа бакетов S3: оригинальный бакет общего назначения и бакет с каталогом, связанный с S3 Express, представленный на re:Invent 2023, который имеет более высокую производительность и поддерживает иерархическое хранение данных. Третий тип бакета, представленный на re:Invent 2024, - Amazon S3 Table Bucket.

Таблицы Amazon S3
Таблицы Amazon S3 - это полностью управляемые таблицы Apache Iceberg в S3, предназначенные для повышения эффективности хранения и анализа табличных данных, например ежедневных операций покупки, показаний датчиков или показов рекламы. Данные такого типа организованы в строки и столбцы, подобно таблице базы данных.
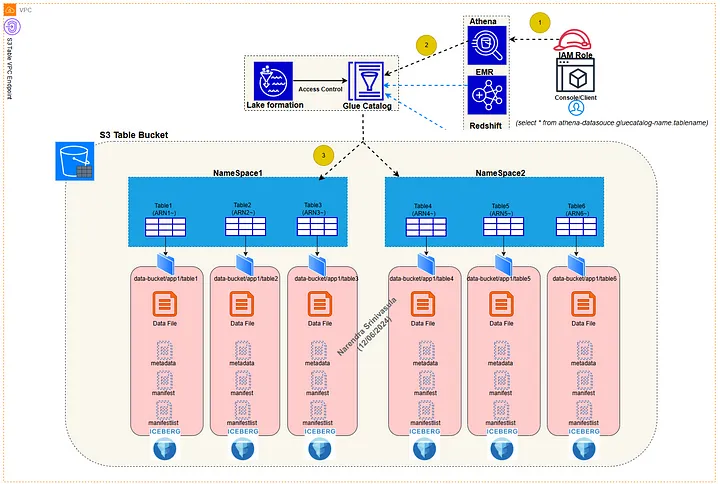
При использовании таких таблиц данные хранятся в специальном типе бакета S3, называемом табличным бакетом, в котором таблицы организованы как подресурсы. Эти бакеты поддерживают формат Apache Iceberg, что позволяет легко управлять данными и выполнять к ним запросы.
Вы можете использовать стандартный SQL для запросов к этим таблицам с помощью таких популярных инструментов, как Amazon Athena, Amazon Redshift и Apache Spark, что делает аналитику простой и доступной. Таблицы S3 созданы для повышения производительности запросов при сохранении низких затрат на хранение данных.
######################
## Create s3 table bucket
########################

aws s3control create-table-bucket \
    --account-id <AWS_ACCOUNT_ID> \
    --bucket-name  data-bucket

######################
## Create Amazon s3 table
########################
aws s3control create-table \
    --account-id <AWS_ACCOUNT_ID> \
    --bucket-name my-table-bucket \
    --table-name my_table \
    --table-type ICEBERG \
    --namespace namespace1
Новая таксономия
Пространства имен: Логическая группировка таблиц S3, называемая пространствами имен. Эти пространства имен не являются физическими ресурсами, как таблицы S3 или бакеты таблиц, они представляют собой организационные инструменты, помогающие более эффективно управлять таблицами. Пространства имен облегчают контроль доступа и масштабирование управления данными.
Бакет таблицы S3 & Политики таблицы: Теперь Вы можете писать политики для бакета, таблицы, основанные на ресурсах, и политики для конкретного пространства имен.
ARN таблицы: У каждой таблицы теперь есть свой ARN. Это значит, что теперь Вы можете однозначно идентифицировать их и писать ресурсозависимые политики.
Конечная точка таблиц S3: У нас появилась новая конечная точка интерфейса для таблиц s3, специфичная для каждого региона.
API операций с таблицами S3: Для операционных целей введены новые API: ListTable,CreateTable,GetTableMetadataLocation,UpdateMetadataLocation,DeleteTable
Управление API таблиц S3: Введены новые API для управления PutTablePolicy,PutTableBucketPolicy,PutTableMaintenanceConfig,PutTableBucketMaintenanceConfig
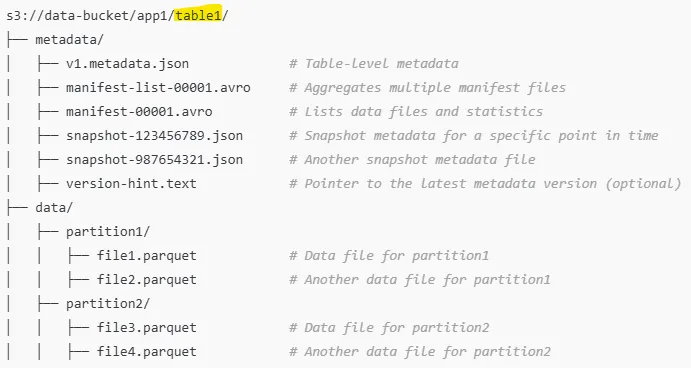
Физическая структура файла S3
Почему именно таблицы Amazon S3?
Таблицы Amazon S3 сочетают в себе масштабируемость, производительность и управляемость современной системы хранения таблиц. Повышая производительность, обеспечивая безопасность на уровне таблиц и оптимизируя расходы на хранение, они решают основные проблемы управления табличными данными в масштабе, что делает их мощным средством хранения данных.
Улучшенная производительность
Таблицы Amazon S3 Tables созданы специально для эффективной обработки аналитических данных. Используя формат Apache Iceberg, таблицы S3 повышают производительность запросов благодаря таким функциям, как обрезка разделов и индексирование метаданных. По сравнению с традиционным самоуправляемым табличным хранилищем:
- Более быстрое выполнение запросов: таблицы S3 обеспечивает до 3 раз более высокую производительность запросов благодаря оптимизации доступа к данным и их обработки.
- Поддержка одновременных рабочих нагрузок: Обеспечивают высокопроизводительные операции чтения и записи, поддерживая до 10 раз больше транзакций в секунду.
- Запросы с перемещением во времени: Получение исторических версий данных с минимальными накладными расходами, что обеспечивает более быстрый и надежный аудит и отладку.
Безопасность на уровне таблиц
Управление доступом и разрешениями для табличных данных в озерах данных традиционно было сложным. Таблицы S3 обеспечивают надежные механизмы безопасности:
- Контроль доступа в зависимости от пространства имен: Группируйте таблицы по пространствам имен (например, HR или Finance) и устанавливайте подробные политики для контроля доступа для различных команд или отделов.
- Политики на основе ресурсов: Применяйте политики для конкретных ресурсов на уровне таблицы или бакета, чтобы контролировать, кто может читать, записывать или изменять данные.
- Интеграция с AWS IAM: беспрепятственное управление доступом пользователей с помощью разрешений, связанных с AWS Identity and Access Management (IAM).
Оптимизированные затраты на хранение
Таблицы Amazon S3 помогают снизить затраты на хранение и управление большими наборами данных несколькими способами:
- Эффективное управление метаданными: Древовидная структура метаданных Apache Iceberg сокращает накладные расходы на управление миллионами или миллиардами файлов, что приводит к снижению операционных затрат.
- Сокращение дублирования: В отличие от традиционных систем, нет необходимости дублировать данные между озерами и хранилищами, что значительно экономит затраты на хранение и обработку.
Автоматизированное обслуживание!!!
Вы определяете политику обслуживания для таблицы S3 с помощью API PutTableMaintenanceConfiguration. Политика определяет правила для таких задач, как частота уплотнения, истечение срока действия данных или сохранение снимков.
AWS автоматически применяет все эти политики через регулярные промежутки времени или на основе указанных Вами условий. Процессы обслуживания запускаются без ручного вмешательства, обеспечивая оптимизацию всей таблицы.
Операции обслуживания обновляют внутренние файлы метаданных Iceberg (например, манифесты и моментальные снимки) для того, чтобы отразить текущее состояние таблицы.
#########################
#table-maintenance-config.json
###########################
{   "TableMaintenanceConfiguration": {
    "Compaction": {
      "Enabled": true,
      "MaxFileSizeMB": 128,
      "CompactionFrequencyHours": 24
    },     "SnapshotRetention": {
      "Enabled": true,
      "MaxSnapshots": 5,
      "RetentionPeriodDays": 30
    },     "GarbageCollection": {
      "Enabled": true,
      "OrphanedFileRetentionDays": 7
    }   } }

aws s3control put-table-maintenance-configuration \
    --account-id <AWS_ACCOUNT_ID> \
    --table-name <TABLE_NAME> \
    --table-maintenance-configuration file://table-maintenance-config.json
Уплотнение
Раздел Compaction определяет настройки для объединения маленьких файлов в большие, что повышает производительность запросов и уменьшает оверхеды на метаданные.Enabled: Указывает, включено ли автоматическое уплотнение или нет. true включает процесс уплотнения.MaxFileSizeMB Указывает целевой максимальный размер уплотненных файлов в мегабайтах. Пример: 128 означает, что файлы будут уплотняться на фрагменты размером до 128 МБ.CompactionFrequencyHours: Устанавливает частоту выполнения процесса уплотнения. Пример: 24 означает, что уплотнение будет происходить раз в 24 часа.
SnapshotRetention
Раздел SnapshotRetention управляет политикой сохранения моментальных снимков таблиц, которые используются для запросов с перемещением во времени и версионирования.Enabled: Указывает, включено ли сохранение моментальных снимков. Пример: true включает политику сохранения.MaxSnapshots: Определяет максимальное количество сохраняемых снимков. Пример: 5 означает, что будут сохранены только последние 5 снимков.RetentionPeriodDays: Определяет максимальный возраст (в днях) для сохраняемых снимков.Пример: 30 означает, что снимки старше 30 дней будут автоматически удаляться.
GarbageCollection
Секция GarbageCollection обрабатывает очистку «осиротевших» файлов, которые представляют собой файлы данных, на которые больше не ссылается ни один активный снимок.Enabled: Указывает, включена ли сборка мусора. Пример: true включает процесс очистки.OrphanedFileRetentionDays: Указывает, как долго должны храниться осиротевшие файлы перед удалением. Пример: 7 означает, что «осиротевшие» файлы будут храниться в течение 7 дней, прежде чем будут удалены.
Контроль доступа к таблицам Amazon S3
Уровень бакета таблицы
{
  "Version": "2012-10-17",
  "Statement": [
    {       "Effect": "AllowBucketAction",
     "Principal": {
     "AWS": "arn:aws:iam::123456789012:role/dataengineer"
    },       "Action": [
        "s3tables:GetTableMetadataLocation",
        "s3tables:GetTableData",
        "s3tables:ListTables",
        "s3tables:GetTableMaintenanceConfig",
        "s3tables:GetTableBucketMaintenanceConfig"
      ],       "Resource": "arn:aws:s3tables:us-east-1:123456789012:bucket/data-bucket/table/*"
    }   ] }
Политика контроля доступа на уровне таблицы:
{
  "Version": "2012-10-17",
  "Statement": [
    {       "Effect": "AllowTableAction",
     "Principal": {
     "AWS": "arn:aws:iam::123456789012:role/dataengineer"
    },       "Action": [
        "s3tables:GetTableMetadataLocation",
        "s3tables:GetTableData"
       ],       "Resource": "arn:aws:s3tables:us-east-1:123456789012:bucket/data-bucket/table/table-UUID"
    }   ] }
Политика управления доступом на уровне пространства имен:
{
  "Version": "2012-10-17",
  "Statement": [
    {       "Effect": "AllowTableAction",
     "Principal": {
     "AWS": "arn:aws:iam::123456789012:role/dataengineer"
    },       "Action": [
        "s3tables:GetTableMetadataLocation",
        "s3tables:GetTableData"
       ],       "Resource": "arn:aws:s3tables:us-east-1:123456789012:bucket/data-bucket/table/*"
 "condition": {
 "StringLike" : {
          "s3tables:namespace":"namespace1"
          }       }     }   ] }
Интеграция создания озера
Вы можете включить Lake Formation и добиться контроля доступа на уровне базы данных, таблицы или даже столбца.
Преимущества Lake Formation
- Разрешения на уровне столбцов: Разрешите определенным пользователям доступ только к определенным столбцам таблицы.
- Фильтрация на уровне строк: Ограничьте доступ к строкам на основе фильтров (например, отдел = 'HR').
- Унифицированный контроль доступа: Обеспечение согласованных правил доступа в таких службах, как Athena, EMR и Redshift Spectrum.
Пример с Lake Formation: в Lake Formation можно создать такие разрешения, как: Предоставить аналитику данных доступ к таблице table1, но только к столбцам sales и region.
Такие механизмы запросов, как Amazon Athena, Apache Spark и другие, соблюдают все эти элементы управления доступом. Когда пользователь запрашивает таблицу S3, начинается проверка разрешений. При использовании Lake Formation детализированные политики доступа (например, доступ на уровне столбцов) применяются автоматически.
Аварийное восстановление
Эта возможность есть в дорожной карте aws, но на данный момент она недоступна. Таблицы AWS S3 предназначены только для регионов! Однако для достижения этой цели Вы можете использовать свое собственное решение.
Заключение
Таблицы Amazon S3 значительно упрощают управление и запросы к большим объемам данных, решая такие проблемы, как производительность, безопасность и стоимость. Они помогают компаниям модернизировать свои системы данных и оптимизировать аналитику. Однако настройка аварийного восстановления (DR) по-прежнему требует ручного вмешательства.


