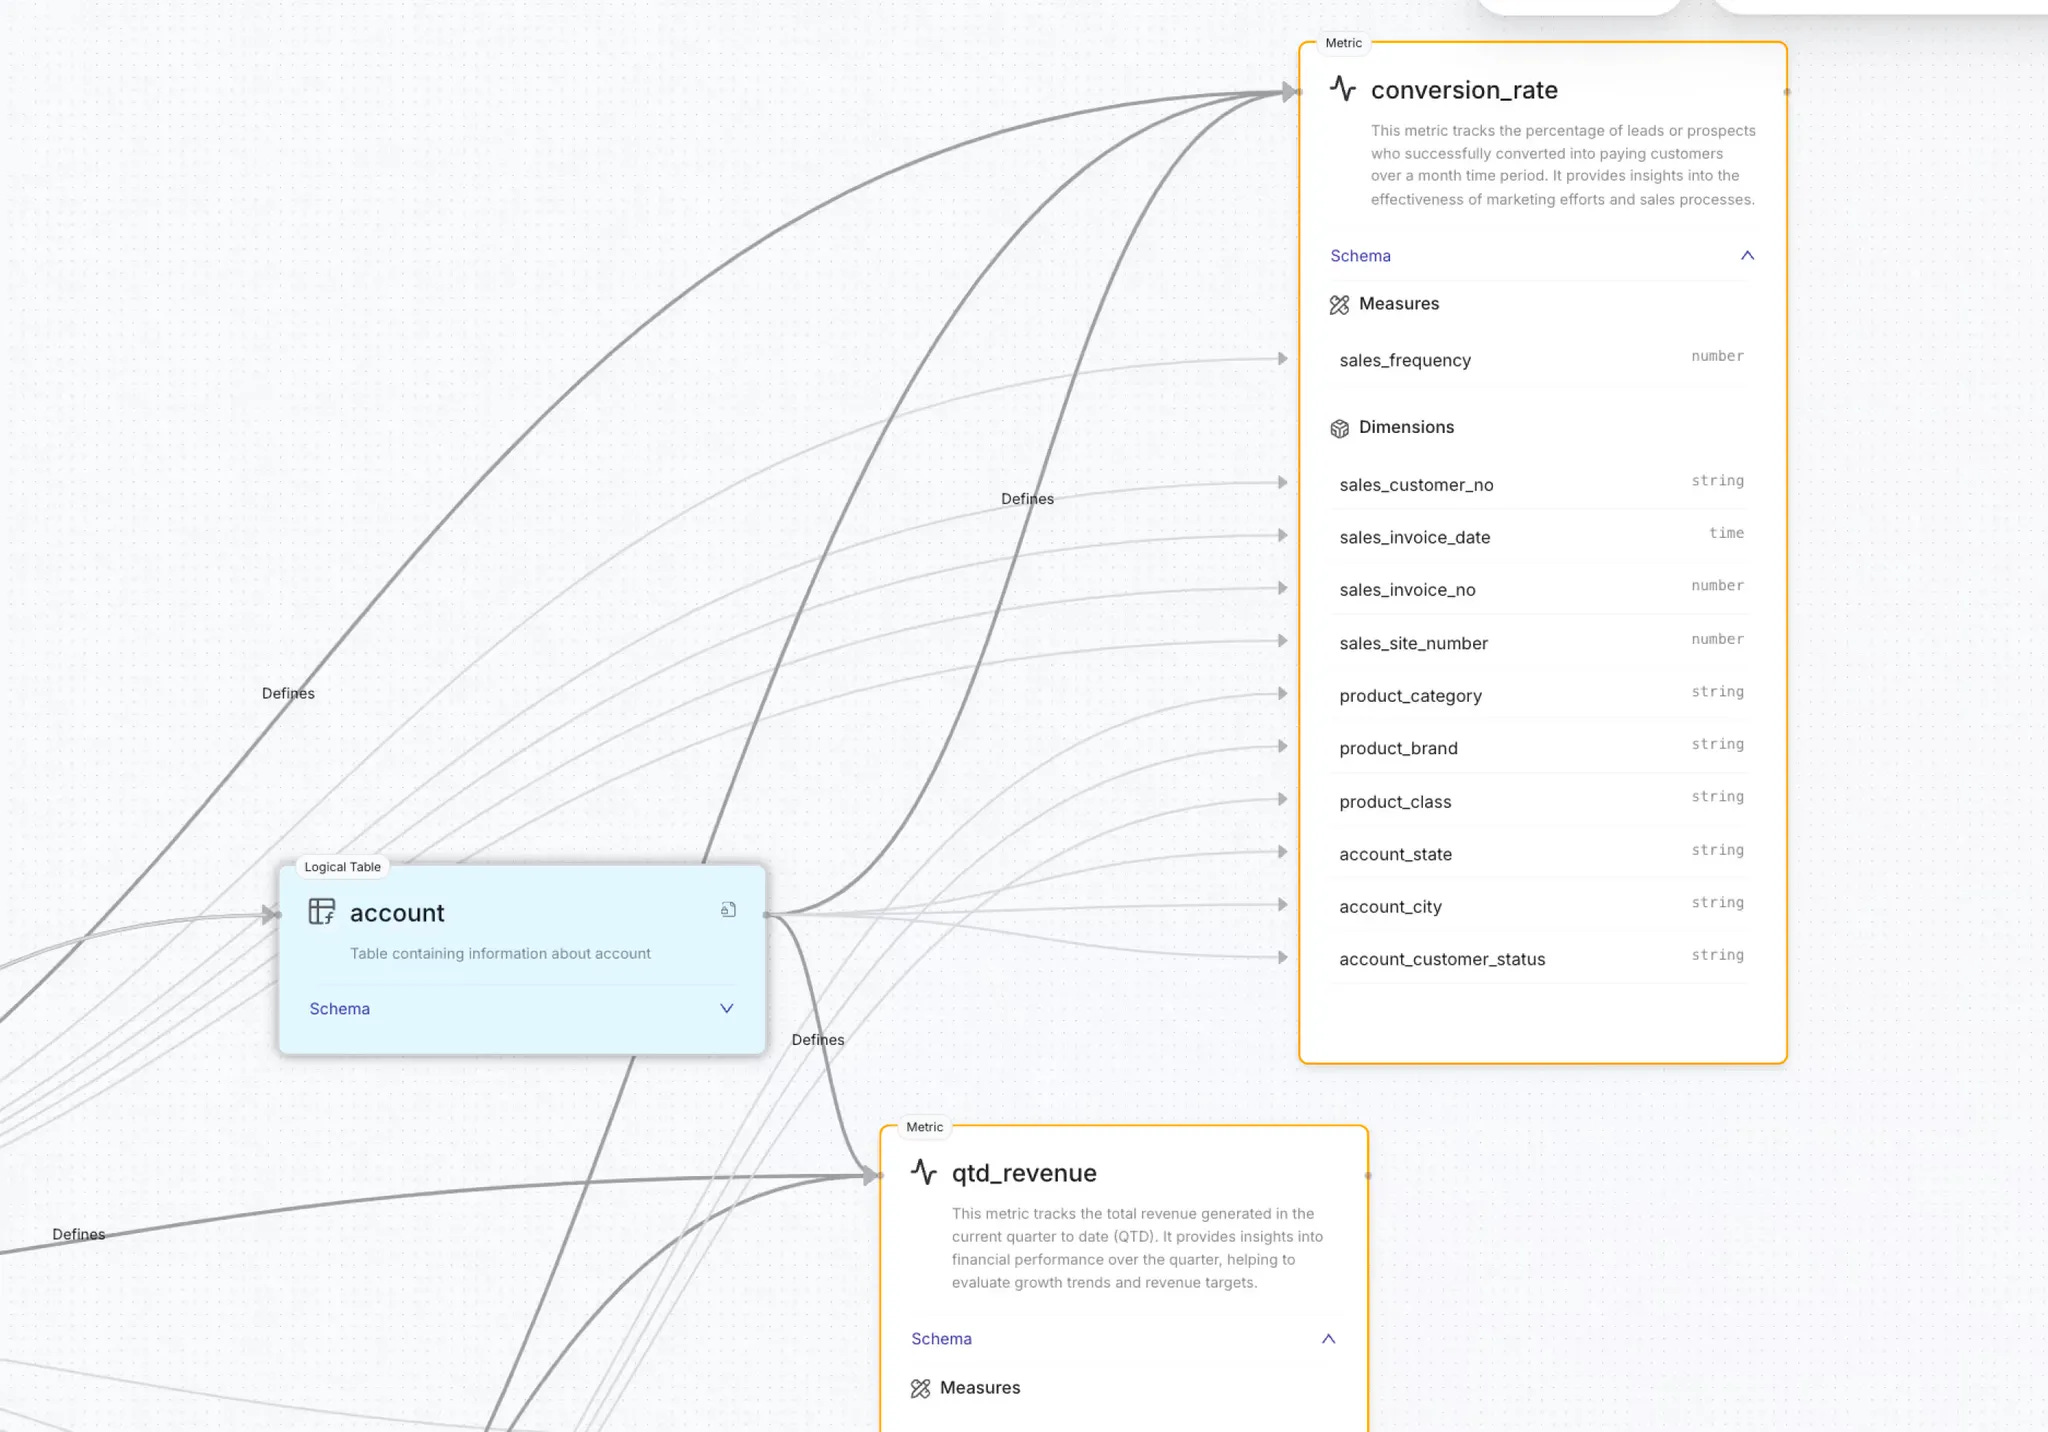
Современный стек данных слишком сложен … и 70% лидеров и практиков в области данных с этим полностью согласны!
Модульная архитектура и подход, не требующий специальных сложных манипуляций – все для того, чтобы жизнь специалистов по работе с данными стала хоть чуточку легче.
TLDR
- Сегодня руководители компаний признают, что трансформационный потенциал ИИ напрямую зависит от наличия тщательно реализованной стратегии обработки данных. Без эффективной стратегии в области данных, поддерживаемой бизнес-лидерами, их стремление «сделать хоть что-то полезное» с помощью нейросетей/традиционного ИИ неизбежно столкнется с большим сопротивлением и с высокой долей вероятности будет обречено на провал (Forbes: основные причины провала 85% проектов в области ИИ). Они должны использовать все свое влияние и авторитет, выделяя разумный бюджет и оказывая серьезную поддержку командам по работе с данными для того, чтобы повысить эффективность управления данными в своих компаниях;
- С первого взгляда, нужно только лишь оптимизировать работу существующих инструментов и решений в области данных, но не все так просто. Многие респонденты рассказали нам о проблемах, с которыми они сталкиваются ввиду слишком большого количества инструментов, приводящих к чрезмерно сложным решениям. Это существенно ограничивает возможности ИИ. Кроме того, «старые» решения уже просто не подходят для обработки постоянно растущих объемов данных и передовой категории ИИ (ожидания от потребления данных слишком завышены);
- Дальновидные организации перестраивают свои команды, ориентируясь на бизнес-домены, а не на технологические специализации. Распространение такого подхода неизбежно приведет к специализации, необходимой для интеграции огромного количества специальных инструментов и решений, что в свою очередь приведет к фрагментации знаний и опыта, а значит, к более медленному и сложному процессу принятия решений. Если этой проблемой не заниматься, она приведет к совсем неутешительным результатам. Компании, ориентированные на воспитание T-shaped профессионалов, обладающих глубокими познаниями в области данных наряду с общей экспертизой, открывают перед нами мощнейшие передовые возможности решения проблем, с которыми не может сравниться ни одна узкоспециализированная команда. Борьба с перегруженностью инструментами - одно из ключевых действий на пути к этой цели.

Введение
Не так давно, а если быть точным, то в 2024 году, компания Modern Data Company провела большой опрос совместно с сообществом MD101 . Ответы были получены от 230 с лишним человек из 48 стран, имеющих за своей спиной в среднем 15 с лишним лет опыта работы в сфере данных.
Одним из самых показательных результатов, подтвердивших наши самые серьезные опасения, стало переполнение инструментами большинства стеков данных, и связанные с этим когнитивная перегрузка и финансовые последствия.
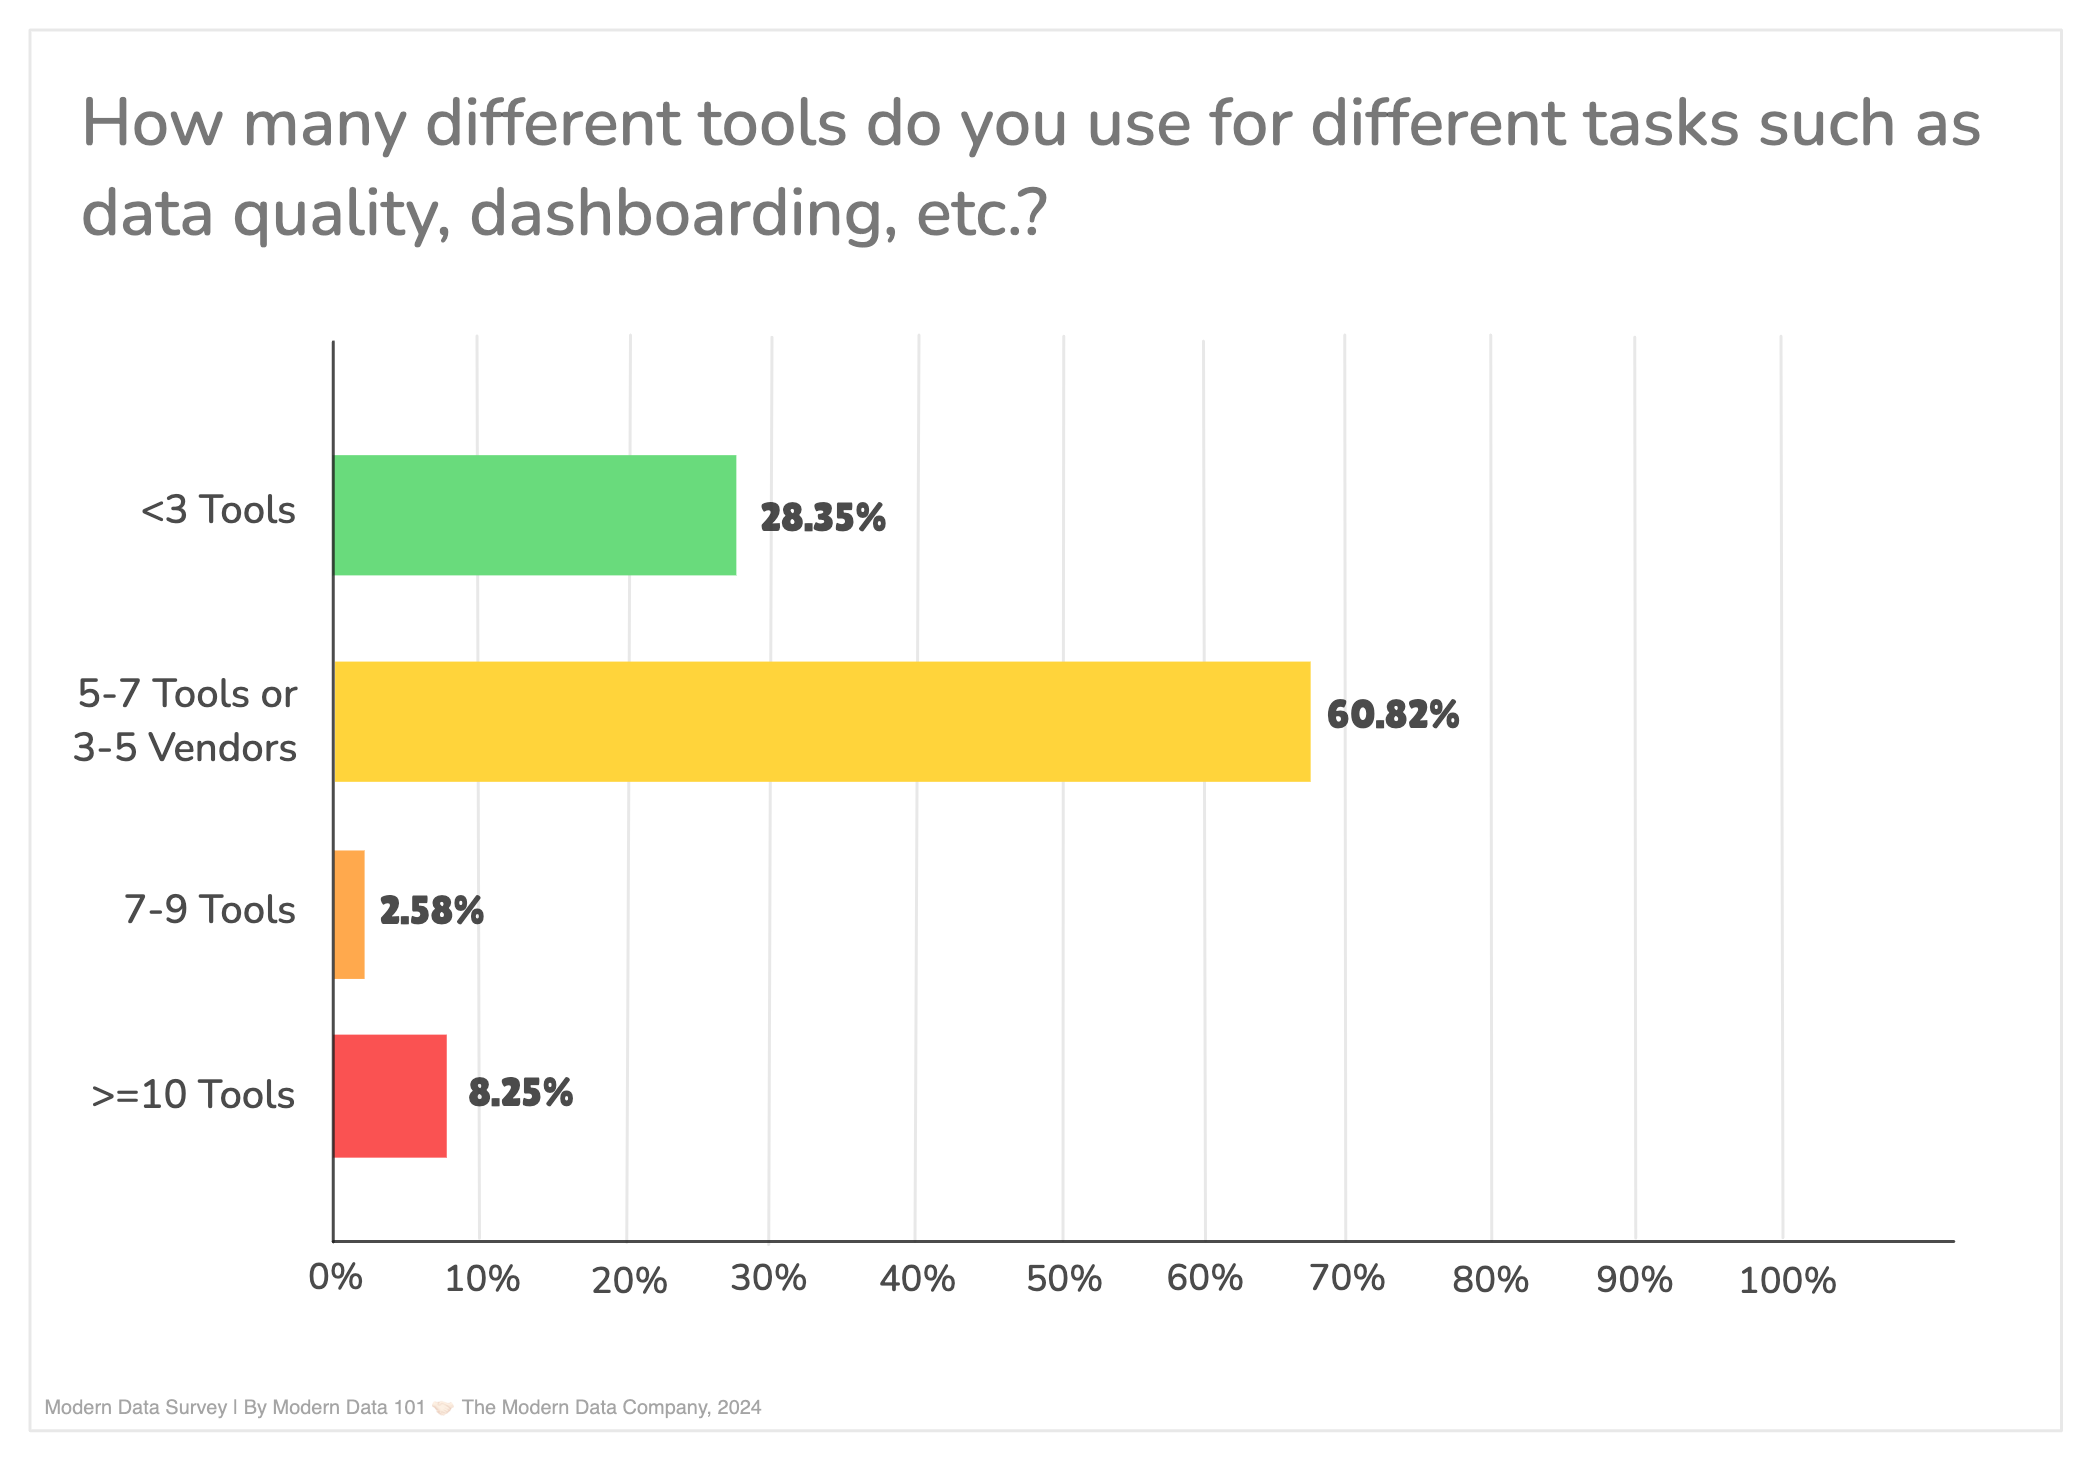
Более 70 % респондентов используют более 5-7 различных инструментов или работают с 3-5 поставщиками решений в области данных, пытаясь решить различные задачи, такие как качество данных и создание дашбордов. Около 10 % опрощенных используют более 10 инструментов, что само по себе свидетельствует о растущей сложности ландшафта данных.
Как мы до такого докатилась или почему стек управления данными и аналитикой так сильно перегружен
«Конечному пользователю, не являющемуся экспертом в области данных, становится все труднее и труднее, поскольку экосистемы данных постепенно превращаются в слишком сложные и разрозненные системы, к которым постоянно добавляются какие-то новые решения. Комплексные инфраструктуры, требующие регулярного обслуживания, отвлекают дата-инженеров от решения таких важных задач, как разработка приложений для работы с данными, которые влияют на бизнес в целом и в конечном итоге повышают рентабельность инвестиций в сферу данных».
datadeveloperplatform.org
Современный стек данных (Modern Data Stack, MDS) принес много положительных моментов, одним из которых стал переход к облачным экосистемам, что снизило барьеры для входа на рынок и сделало данные не только более доступными, но и легко восстанавливаемыми.
Но с появлением MDS появилось и большое количество вендоров, предлагающих большое количество точечных решений. Повсеместное распространение широкого спектра инструментов, особенно от поставщиков, было продиктовано следующими факторами:
- Специализация вместо обобщения: Специализированные инструменты решают точечные проблемы с данными и создают силосы данных;
- Снижение барьеров для входа на рынок: Облачные технологии и SaaS снизили затраты и ускорили внедрение новых инструментов;
- Различные типы сотрудничества между поставщиками и лидерами в разных областях: руководители с разными предпочтениями в выборе инструментов и независимые решения команд по работе с данными привели к созданию нескоординированного стека;
- Отсутствие единой корпоративной стратегии работы с данными: Приоритет сиюминутным решениям. Инструменты внедрялись для решения сиюминутных проблем без учета долгосрочной перспективы.
Результат интеграции различных инструментов обработки данных
Несмотря на то, что главной целью внедрения изолированных инструментов было создание модульной сети решений, которые пользователи могли бы объединять для решения более масштабных задач, со временем современный стек данных стал самой настоящей «вещью в себе». Он стал похож на непролазный лабиринт пайплайнов, понятный лишь «ибранным.
- Огромные потери времени;
- Высокие скрытые расходы;
- ROI команд данных;
- Команды данных начинают выполнять функции OPS;
- Подорванное доверие к данным;
- Перегруженность стека данных;
- Обесценивание инструментов;
- Завышенные ожидания
Огромные потери времени: интеграция 5+ инструментов
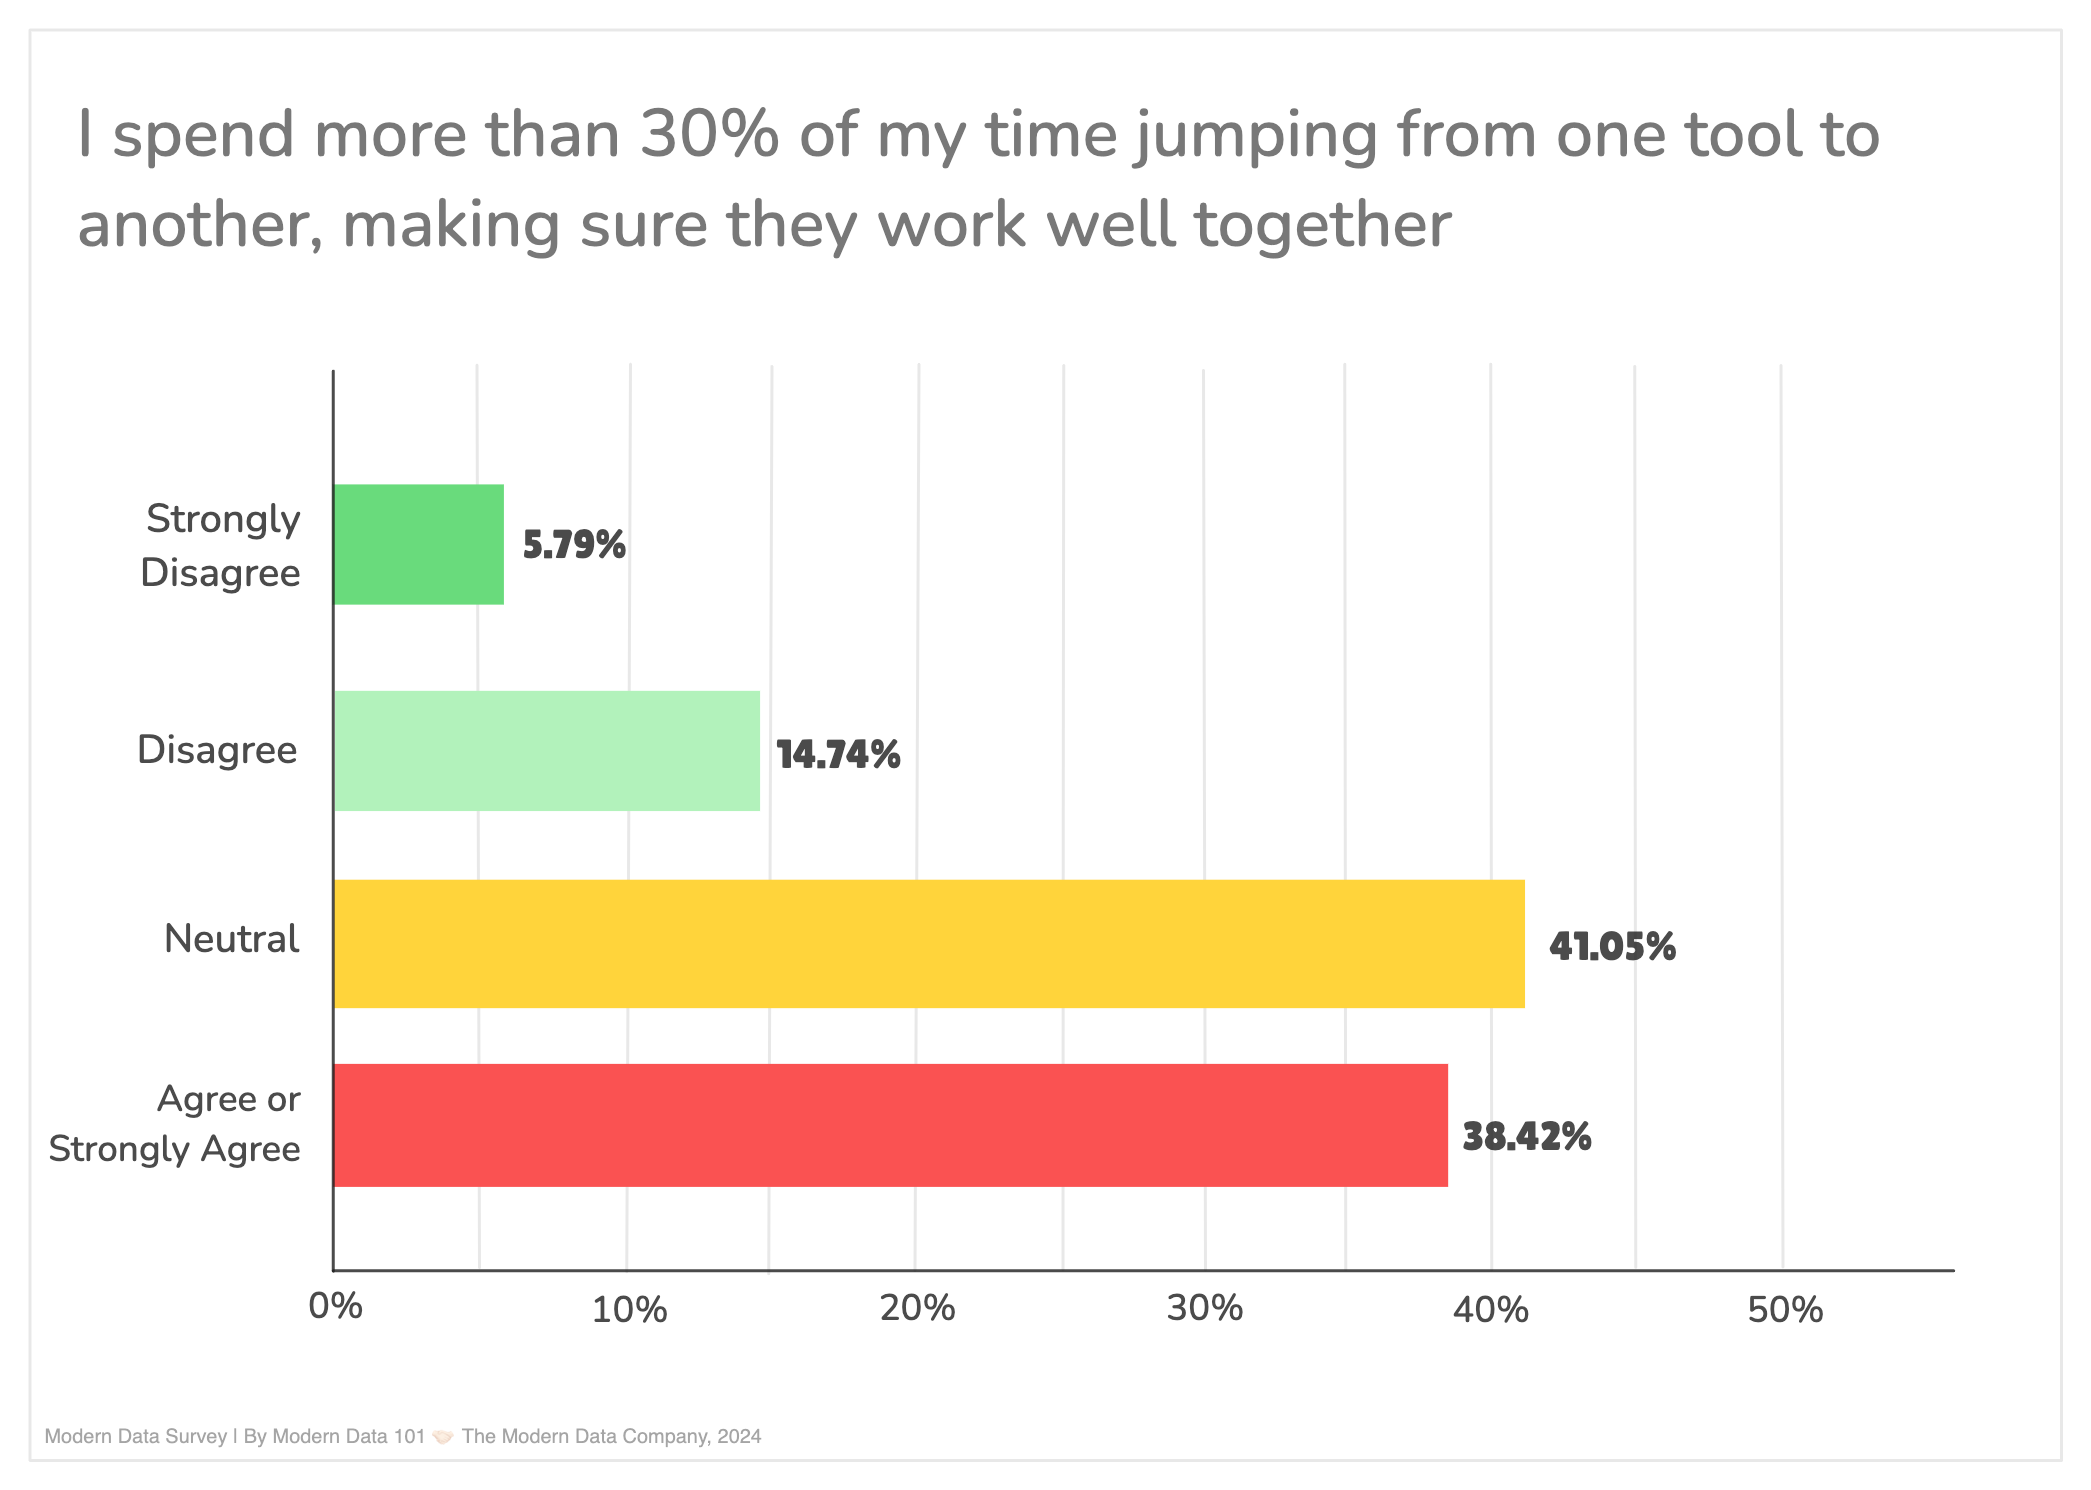
Пользователи тратят около 1/3 своего времени на переход от одного инструмента к другому.
Около 40 % респондентов тратят более 30 % своего рабочего времени на переход от одного инструмента к другому, пытаясь организовать их слаженную работу.
Вы только задумайтесь над тем, сколько времени команды специалистов по данным тратят на то, чтобы удержаться на плаву в условиях огромного количества решений и продуктов, представленных на рынке. Каждый новый инструмент требует внедрения, обучения и адаптации. Пользователи должны не просто научиться работать с ним, но и понять, как именно он вписывается (или не вписывается) в существующие рабочие процессы.
Постоянное переключение между продуктами мешает работе: при переходе от одного интерфейса к другому очень часто теряется контекст решения той или иной задачи. Оно не только замедляет работу, но и повышает риск ошибок.
Нельзя забывать и о проблемах интеграции. Команды специалистов по работе с данными тратят часы на устранение ошибок, связанных с внедрением новых инструментовв существующие процессы и организацией их слаженной работы. Даже после решения этих проблем еще одной важной задачей является регулярное обслуживание обновленной экосистемы.
Никто не отменял и контроль согласованности и достоверности полученных результатов. Специалисты по работе с данными вынуждены пристально отслеживать историю движения информации по пайплану. Этот процесс не только отнимает много времени, но и связан с большим количеством возможных ошибок. В результате ценное рабочее время и ресурсы тратятся не на первоочередные задачи, приносящие прибыль, а на выполнение скучной рутинной работы.
Высокие скрытые расходы: затраты на интеграцию новых решений
Лицензирование, обучение персонала и поддержка нескольких инструментов все это далеко не бесплатно.
Операционные расходы
- Затраты на специалистов по работе с платформой, ответственных за ее работоспособное состояние;
- Затраты на интеграцию новых инстурментов и поддержание жизнеспособности пайплайна;
- Затраты на устранение сложных зависимостей при частой передаче проектов.
Затраты, связанные с инфраструктурой и переходом от одного решения к другому
- Стоимость перемещения огромных массивов данных;
- Стоимость создания инфраструктуры проектирования данных для эксплуатации точечных решений;
- Стоимость хранения и перемещения данных, а также вычислений для 100% информации, содержащейся в болотах данных.
Затраты на лицензирование
- Стоимость лицензий на отдельные решения, необходимые для работы с облаком;
- Стоимость общих деноминаторов для точечных решений (дублирование)
Затраты на интеграцию новых продуктов и обслуживание экосистемы
- Стоимость интеграции при появлении нового инструмента в экосистеме;
- Стоимость управления для каждой точки интеграции.
Когнитивные затраты + расходы, связанные с минимизацией рисков
- Стоимость когнитивной нагрузки, возникающей в процессе освоения каждого нового инструмента;
- Стоимость минимизации рисков, связанных с данными, которые возникают ввиду большого количества точек воздействия
Как Вы уже могли догадаться, список далеко не полный ...
ROI: рост числа инструментов с небольшим коэффициентом рентабельности инвестиций
Для принятия каждого решения требуется время. Внедрение каждого нового инструмента – не исключение, оно также подразумевает расход сил, терпения и времени.
Само по себе добавление еще одного инструмента в существующую систему - это еще полбеды, ведь за ним неизбежно последуют расходы на обслуживание, интеграцию и лицензирование новшества.
В итоге конечная цель, состоящая в приближении к желаемым бизнес-результатам, отодвигается на второй план; все ресурсы на себя перетягивает интеграция нового инструмента , которая в свою очередь неразрывно связана с использованием специализированных решений по устранению «пробелов» в усовершенствованной экосистеме. Получается замкнутый круг…
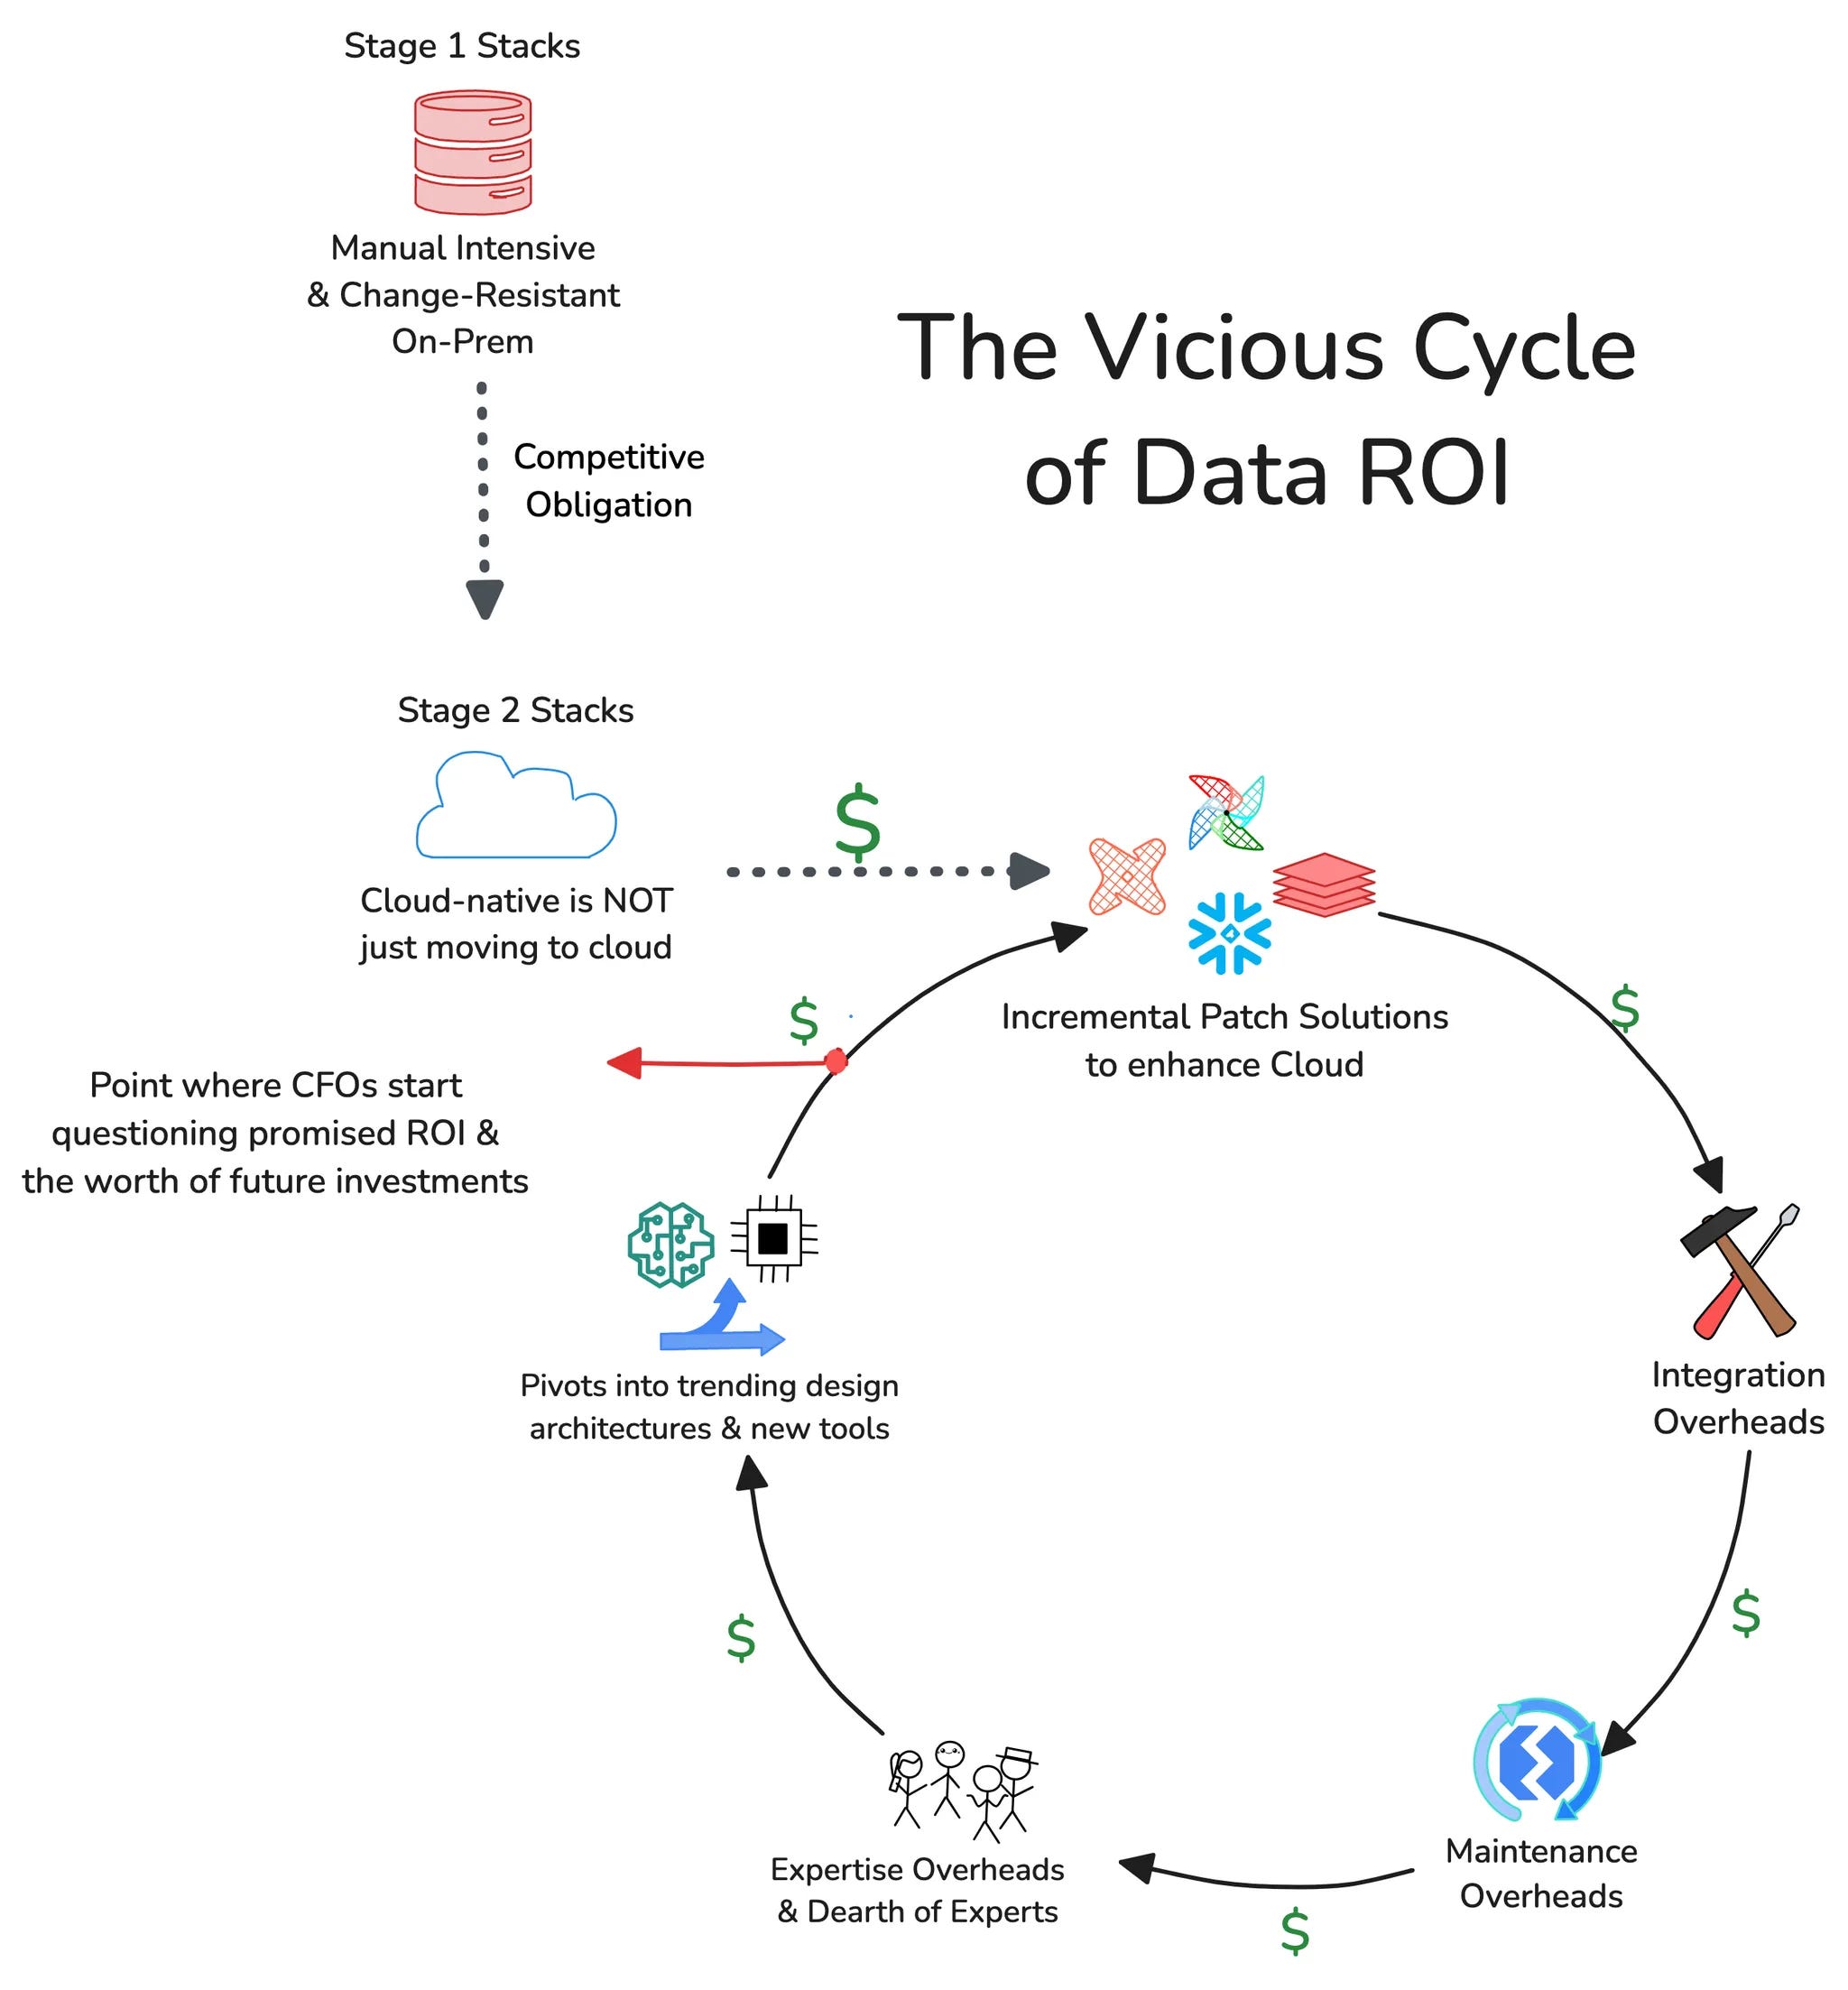
А ведь каждая итерация новых нишевых решений, помимо затрат на лицензирование, подразумевает дополнительные скрытые (и просто огромные!) расходы на приобретение расширенного пакета функций + затраты на регулярное обслуживание.
Стоимость владения новым инструментом значительно возрастает, когда к стоимости лицензирования и обслуживания добавляются различные эксплуатационные расходы. Если на заключение самого договора Вы тратите 2 миллиона долларов, а затем еще 300 тысяч долларов на всякие дополнительные расходы, то очевидно, что ROI этого решения падает.
«Около 40 % респондентов утверждают, что наибольшая часть затрат связана именно с обеспечением интеграции между различными инструментами обработки данных».
Команда по работе с данными начинает выполнять функцию Ops: сначала обслуживание данных и только потом их ценность
При наличии большого количества инструментов, о чем свидетельствует такой известный отчет, как MAD Landscape или MDS, организациям становится все труднее и труднее сфокусироваться на разработке решений, которые действительно приносят желаемые финансовые результаты (ввиду постоянной обработки заявок на обслуживание текущих и новых инструментов). Дата-инженеры и аналитики данных буквально застряли в «болоте», где на первом месте стоят эксплуатационные задачи, на втором - интеграция новых решений, и только на последнем – сами данные. Такой подход предполагает уйму времени, потраченную на устранение инфраструктурных недостатков и поддержку работоспособности пайплайнов.
Надежность данных: Экспоненциальный рост объема данных создает проблемы с их достоверностью и удобством их использования
«Я думаю, что многие команды по работе с данными сталкиваются с проблемой определения метрик в своем BI-инструментарии, например, при работе с HubSpot или с любым другим маркетинговым решением, например, с Google Analytics. На один и тот же вопрос Вы можете получить три абсолютно разных ответа.
Это заставляет руководство компании задуматься над тем, можно ли полученным данным доверять. Они просто не понимают, чему в этом случае верить, а чему - нет".
~ Мэдисон Шотт, старший инженер Convertkit
Когда данные перетекают из одного инструмента в другой (читай - дублируются), происходит их неконтролируемое искажение; по мере роста числа инструментов отследить их происхождение становится все труднее. Чаще всего, чтобы облегчить себе жизнь, пользователи предпочитают просто копировать данные, а не ждать того, чтобы какая-то проблема в пайплайне была решена. Это отчасти можно объяснить недостаточной осведомленностью о последствиях дублирования или повреждения данных, а также расстройством, вызванным временными задержками, связанными с решением различных задач в области данных.
А без надлежащих «соединительных мостов» нет стабильной модели, на которую бы могли спокойно положиться разработчики данных и пользователи. Вместо этого мы зачастую получаем страшное ветвистое дерево, каждая ветвь которого появлялась как реакция на новое требование или ответ на вновь пришедший запрос.
Перегруженность: учет разных кривых обучения различных решений
Каждый инструмент имеет свой собственный язык проектирования, основанный на определенной философии и подходе к проектированию. Это подразумевает наличие различных языков программирования, форматов, фреймворков или жизненных циклов, что делает взаимодействие с ними достаточно сложным.
Конечные пользователи, ожидающие от новых инструментов быстрой отдачи, или дата-инженеры, отвечающие за то, чтобы они хорошо взаимодействовали друг с другом, должны изучить подходы к проектированию каждого из них. А это совсем непросто. Необходимость изучать обходные пути для 5-7 инструментов и оптимальные способы их интеграции увеличивают и без того высокую когнитивную нагрузку.
- Проблемы совместимости заставляют компании внедрять новые инструменты для того, чтобы заполнить существующие пробелы;
- Операционная сложность, связанная с их интеграцией, поддержкой и оптимизацией растет в геометрической прогрессии;
- Рост числа решений в области данных, используемых компанией, часто приводит к фрагментарной видимости данных и пониманию общей картины, что усложняет и без того непростой процесс принятия стратегически важных решений.
«Инфляция» инструментов: раздутый пул поставщиков и неконтролируемое дублирование данных во внедренных системах
Кроме того, существует социально-политический фактор конкуренции друг с другом, который привел к появлению схожих функций у разных производителей, претендующих на место лидера. По мере появления новых инструментов они внимательно следили за отзывами пользователей и пытались сделать что-то подобное у себя (может быть, чуть лучше, чем у других).
POV: техническая неизбежность фрагментации стека данных
Представим, что к Вашему стеку данных подключаются два разных точечных инструмента, один из которых предназначен для каталогизации данных, а другой - для управления ими. Это подразумевает необходимость не только изучать их философию и способы интеграции, но и в развитие совершенно параллельных направлений. Инструменту управления нужен собственный каталог, а инструменту каталогизации – политика управления.
POV: Неизбежность нишевых вендорских решений
В борьбе за долю рынка поставщики решений в области работы с данными дублируют функции друг друга, что усложняет консолидацию стеков. Например, поставщик, изначально предлагавший только услуги по хранению данных, вдруг ни с того ни с сего начал предлагать варианты каталогизации, обеспечения качества данных, их трансформации и т. д.
Теперь рассмотрим ту же проблему, но уже в масштабе, не будем ограничиваться только двумя точечными решениями. Даже если рассматривать стоимость этих параллельных путей как второстепенную, по сути, это существенный недостаток системы, который продолжает множить вариации одного и того же решения.
Многие возможности нишевого инструментария остались за кадром ввиду дублирования или отсутствия конкретных требований. К сожалению, это также означает и то, что пользователи должны платить, скажем, за 100 возможностей одного решения, в то время как они вполне могли бы обойтись и пятью.
Завышенные ожидания: постоянное стремление к децентрализации!
Когда системы собираются по кусочкам без единой стратегии, управление ее многочисленными частями становится похожим на настоящий кошмар, в результате которого конечным пользователям становится намного сложнее получить доступ к данным.
Такие отделы, как маркетинг, продажи и служба поддержки, вынуждены преодолевать кучу препятствий для того, чтобы получить доступ к интересующей их информации. Тем временем центральная команда по работе с данными перегружена запросами, в результате чего дата-инженерам приходится бросать все свои дела и в срочном порядке распределять нагрузку между доменами.
Именно здесь, на ранних этапах развития Data Mesh, был сделан акцент на владении доменами – то есть сдвиг в пользу децентрализации. Данная идея на первый взгляд может показаться идеальным решением: пусть отдельные команды сами управляют своими данными. Но это только на первый взгляд … Если применить ее к реальной жизни, то можно столкнуться со следующими проблемами:
- Для выделения каждого отдельного домена не хватает квалифицированных специалистов. Насколько оправдана идея создания команд по работе с данными и изолированных стеков данных для каждого домена с финансовой точки зрения?
- Не хватает специалистов или бюджета для того, чтобы перестроить существующие процессы, оптимизировать пайплайны или внедрить принципиально новую инфраструктуру;
- Не хватает экспертов, которые помогут обучить и подключить других сотрудников в процессе культурной миграции.
Это проблема как дефицита навыков, так и нехватки ресурсов. Кроме того, когда на развитие стеков данных уходят десятилетия (при этом ощутимой пользы от них нет), организации просто напросто теряют всякий интерес к оптимизации своей работы в области данных. Если Вашей конечной целью является самодостаточность доменов, лучше обратить внимание на их автономию, а не на децентрализацию.
Слишком много инструментов – как быть?
Возможно, имеет смысл из множества разрозненных инструментов, нацеленных на решение конкретных задач, создать модульную сеть продуктов, которые можно объединять для решения более масштабных проблем...
Почему этот подход не работает?
Модульность - это простые решения, которые можно собрать вместе по своему усмотрению так, чтобы они могли решать более масштабные задачи.
Инструменты, призванные решать конкретные задачи, по сути, сами являются большими решениями, нацеленными на серьезные вопросы, такие как качество данных или ETL.
Каждый компонент такого большого решения (инструмента) не может взаимодействовать с другими большими решениями напрямую (базовые компоненты одного инструмента не могут быть повторно использованы в других приложениях или продуктах). Они должны быть тщательно интегрированы в единую работоспособную систему.
Правильное решение: разумная модульность стека данных
В этом решении есть два ключевых момента:
- Разумная: как сократить потери, связанные со слишком большим количеством инструментов, не создавая при этом дополнительных проблем для специалистов по работе с данными? Другими словами, как мы можем улучшить работу существующего стека данных?
- Модульность: Как обеспечить возможность многократного использования одних и тех же инструментов в разных доменах и сократить накладные расходы на их интеграцию. Другими словами, как унифицировать подход к использованию имеющихся инструментов?
Интересно, что модульность, то есть разбиение большой задачи на несколько независимых решений, позволяет унифицировать существующий стек данных. Обратите внимание, что «разбиение» и «унификация» находятся в одном предложении. С другой стороны, крупные решения (нишевые инструменты) способствуют разрастанию силоса данных.
Внимательно проанализировав множество возможных вариантов, мы пришли к выводу, что модульность подобная Lego, обеспечиваемая унифицированными платформами данных приводит к следующему:
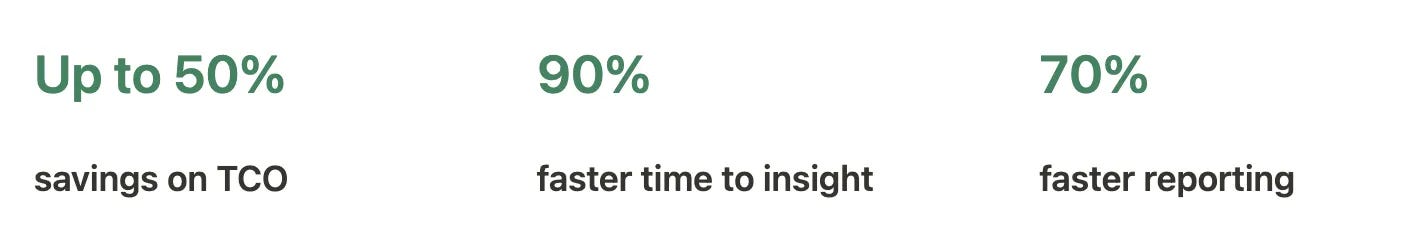
Это сильно контрастирует с традиционными стеками данных, которые представляют собой набор инструментов, «вынужденных» общаться друг с другом посредством сложных и трудоемких интеграций. Некоторые исследования в области данных показали, что:
- 70 % респондентов используют более 5-7 различных инструментов или работают с 3-5 поставщиками для решения различных задач, таких как качество данных и создание дашбордов;
- около 10 % опрошенных используют более 10 инструментов, что свидетельствует о растущей сложности стека данных;
- около 40 % респондентов тратят более 30 % своего времени на переход от одного инструмента к другому.
Настройка плоскости утилиты для облегчения модульной архитектуры данных
Плоскость утилиты служит основой для обеспечения модульности, предоставляя набор основных утилит и сервисов, которые являются сравнительно легкими, многократно используемыми и совместимыми по всему стеку данных.
В отличие от традиционных инструментов, предназначенных для решения нишевых задач, плоскость утилиты фокусируется на предоставлении атомарных, блочных возможностей, которые можно свободно компоновать для решения самых различных задач.
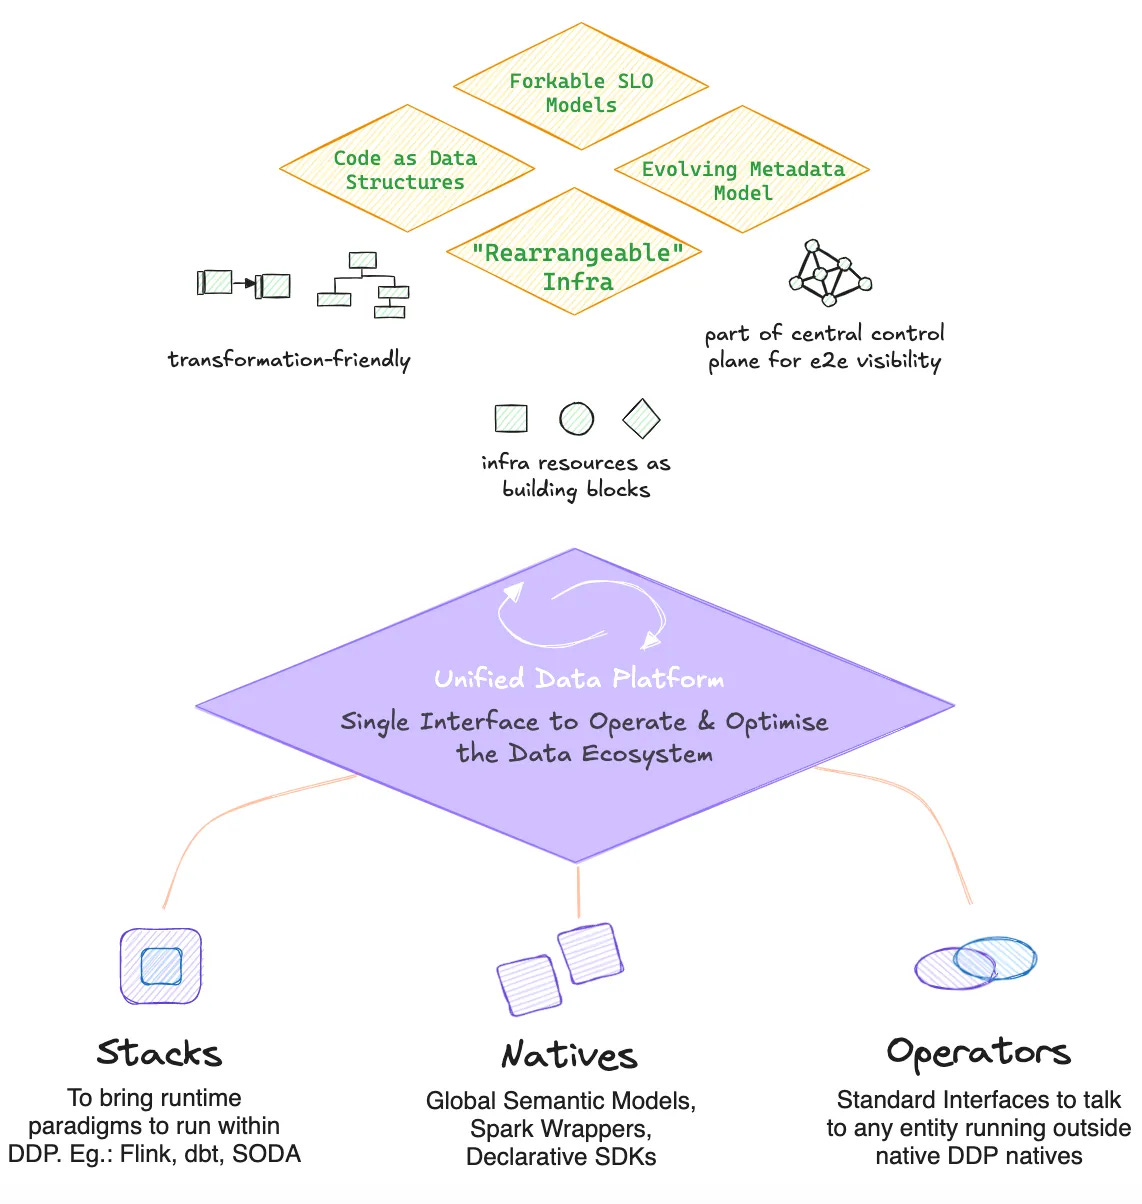
Ключевые принципы плоскости утилиты
1. Атомарность и гранулярность
Плоскость утилиты предполагает минимально возможные единицы функциональности, которые можно сравнить с функциями ПО. В качестве примера можно привести правила проверки данных, функции преобразования или механизмы поиска метаданных. Они предназначены для решения микропроблем и при необходимости могут быть объединены в более крупные рабочие процессы.
2. Взаимозаменяемость
Все компоненты плоскости утилиты можно задействовать с помощью стандартизированных протоколов или API, избегая жестких границ, чем обычно характеризуются традиционные монолитные инструменты. Это позволяет решениям и командам работать сообща, не прибегая к трудоемким процессам, направленным на интеграцию.
3. Нейтральный слой
Плоскость утилиты служит нейтральной основой, располагаясь ниже решений, специфичных для каждой конкретной области, и позволяя командам создавать свою собственную логику или рабочие процессы без привязки к конкретному производителю.
4. Инкрементное внедрение
Плоскость утилиты не разрушает существующие системы, а, наоборот, улучшает их. Команды могут внедрять отдельные утилиты постепенно, исходя из своих насущных потребностей, без необходимости сиюминутной замены или перестройки текущих инструментов или рабочих процессов.
Преимущества единой плоскости утилиты
1. Гибкость: Команды могут использовать только те утилиты, которые им необходимы, что существенно снижает накладные расходы на поддержание работоспособности системы;
2. Возможность повторного использования: Утилиты, созданные один раз, можно использовать повторно в разных командах, доменах и даже организациях;
3. Сокращение дублирования инструментария: Благодаря ориентации на модульные возможности снижается потребность в нишевых инструментах для решения схожих по своей сути задач;
4. Масштабируемость: Плоскость утилиты масштабируется как по горизонтали (путем добавления новых функций), так и по вертикали (путем создания сложных решений из сравнительно простых строительных блоков).
Продолжение темы «избавления от перегрузки технического стека»
Создавая плоскость утилиты и двигаясь в сторону модульной архитектуры, мы сокращаем количество нишевых инструментов. Это становится возможным за счет привлечения:
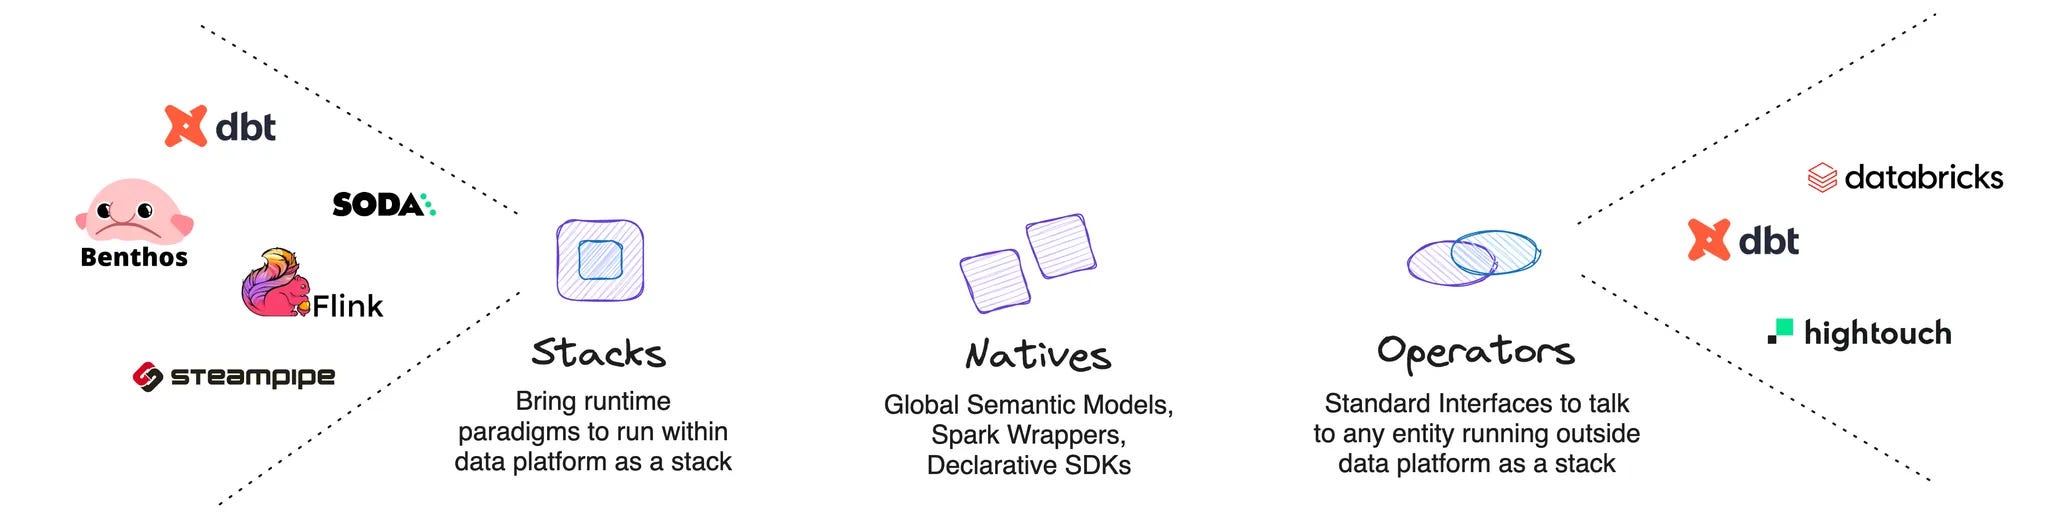
- собственных ресурсов (как строительных блоков):
Ресурсы, такие как хранилища, вычисления, рабочие процессы, сервисы, политики, кластеры и модели могут стать модульными решениями, которые разработчики могут использовать при решении поставленных перед ними задач;
- внешних ресурсов (операторов)
Операторы могут выступать в качестве модульных интерфейсов, которые тесно взаимодействуют с инструментами, работающими вне единой платформы. Оператор регистрирует ресурсы, которые не являются родными для платформы, и позволяет управляющему (внешнему или родному) оркестровщику идентифицировать их и управлять ими. Ресурсы оператора делают платформу расширяемой и настраиваемой;
- других внешних ресурсов (стеков данных):
Плоскость утилиты обеспечивает модульность существующих стеков, таких как dbt, Flink или SODA. Она позволяет интегрировать в существующую экосистему различные новые парадигмы, такие как dbt, Flink и SODA, не требуя их полного переписывания.
Как это работает? Задачи единовременной интеграции и непрерывного управления системой делегируются платформе с помощью различных декларативных средств. Эти «чужие» парадигмы встраиваются в единые стандарты платформы, что позволяет пользователям получать доступ к информации и работать с различными стеками через общий интерфейс и паттерн (сокращая когнитивную нагрузку и смягчая кривые обучения, которые возникают при использовании различных инструментов).
Со временем наличие общего операционного интерфейса помогает организации выработать единую стратегию работы с данными, позволяющую минимизировать набор инструментов и оптимизируя подход к работе в целом. Возможность четко распределять «строительные блоки» для решения конкретных задач дает организациям возможность отнести затраты к доменам, а также понять влияние различных инструментов на общую эффективность затрат и времени.
Например, готовые к использованию функции унифицированных платформ позволяют управлять жизненным циклом продуктов данных и оптимизировать их ценность за счет:
- мониторинга использования и внедрения продуктов данных;
- отслеживания производительности и затрат для каждого продукта данных (включая затраты на инструменты и ресурсы);
- измерения влияния нововведений на бизнес в целом и окупаемости инвестиций.
Внедрение единой плоскости утилиты с помощью платформ DDP
Платформы данных, созданные по образцу стандарта Data Developer Platform (DDP), служат в качестве надежной плоскости утилиты, легко интегрируемой в существующую инфраструктуру данных. Выступая в качестве важнейшего фактора, этот уровень обеспечивает модульность архитектуры данных и ее соответствие конкретным бизнес-целям, сохраняя при этом целостность текущих операций. Подобная архитектура позволяет применять единый подход к управлению рабочими процессами данных в рамках всего стека данных.
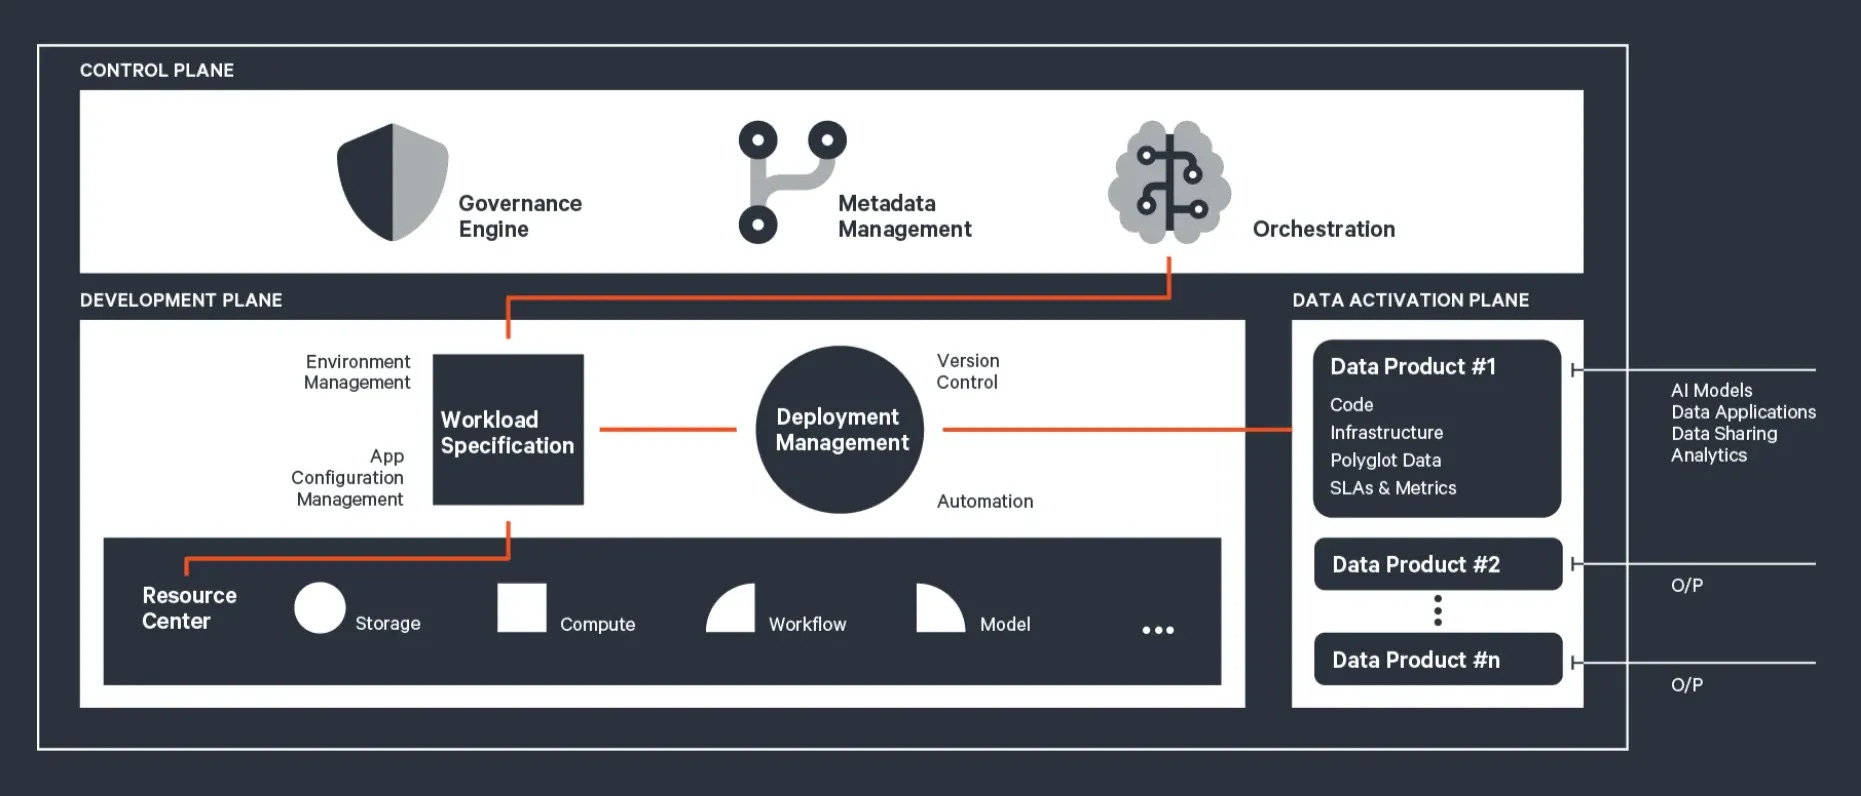
Центральная плоскость управления: Унификация видимости, доступа и управления
При подключении любого инструмента к платформе центральная плоскость утилиты получает доступ ко всей системе, обеспечивая сквозную видимость всех интегрированных инструментов с помощью трех основных механизмов:
1. Унифицированная оркестровка: автоматизирует рабочие процессы, обеспечивая бесперебойное выполнение заданий в пайплайне;
2. Унифицированные метаданные: создает прозрачную историю и понятный контекст для всех активов данных, повышая эффективность системы и обеспечивая ее соответствие нормативным требования;
3. Унифицированное управление: многократно используемые модульные решения, которые могут быть применены к различным случаям или продуктам данных в зависимости от требований, предъявляемых к домену.
Данная модель основана на принципах гибридной децентрализации, ориентированной на конкретные домены.
Плоскость разработки: модульное проектирование с использованием различных строительных блоков
Плоскость разработки предназначена для модуляризации кода, рабочих процессов и ресурсов, которые представлены в виде многократно используемых строительных блоков. Они могут быть адаптированы к решению разных конкретных задач, что позволяет создать композитную архитектуру данных. Именно здесь разработчики данных могут использовать все три парадигмы проектирования (собственные ресурсы, стеки и операторы) для создания модульных решений.
Внедрение модулей: подход «справа налево»
В структуре платформы используется принцип «справа налево», который начинается с определения бизнес-результата и заканчивается разработкой соответствующей технической стратегии:
- определение бизнес-проблемы или задачи, например, улучшение сегментации клиентов или повышение операционной эффективности;
- согласование конкретных продуктов данных, инфраструктуры и процессов для решения поставленной задачи;
- использование модульных ресурсов и конфигурации в плоскости разработки для более быстрого развертывания решений.
Эта методология, разработанная на основе обратной технологии, гарантирует, что все технические усилия будут направлены на достижение поставленной цели.
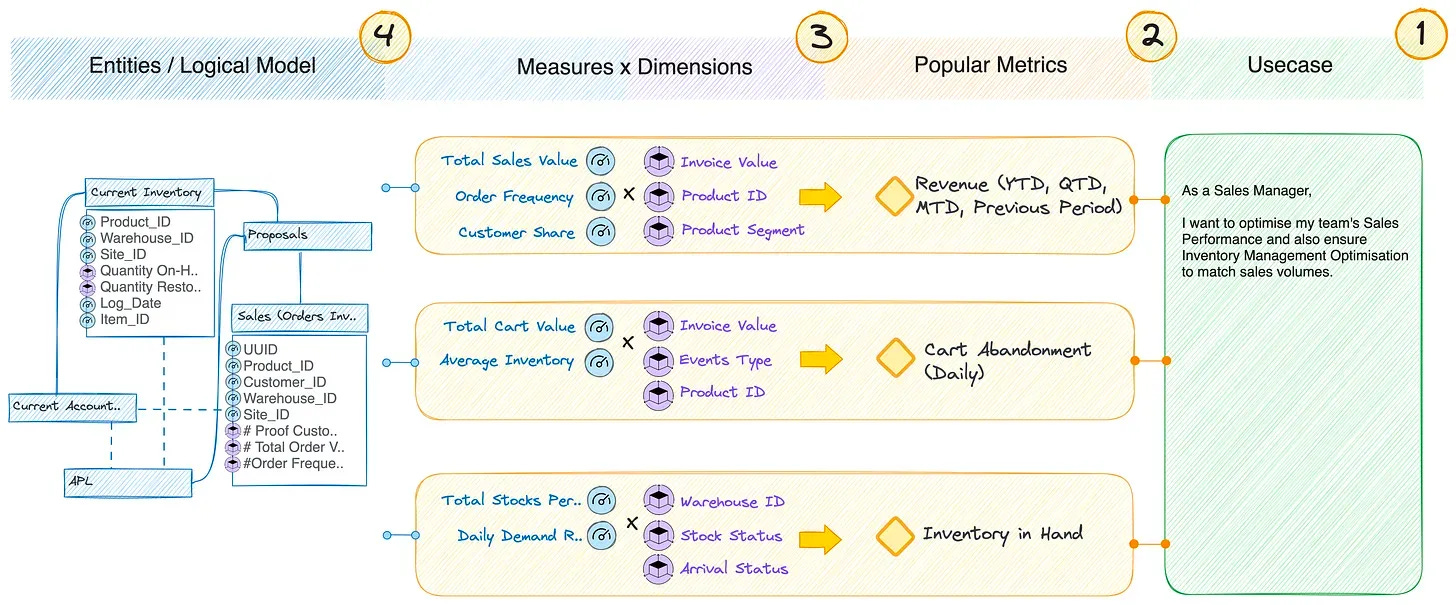
Семантические модели: разблокировка функциональной совместимости и возможности повторного использования
Семантические модели играют ключевую роль в преодолении разрыва между техническими решениями и бизнес-результатами. Выступая в качестве общего глоссария для всех заинтересованных сторон, эти модели:
- обеспечивают совместимость между продуктами данных за счет стандартизации структуры информации и доступа к ней;
- предоставляют возможность повторного использования, позволяющую применять активы данных и рабочие процессы в различных контекстах без дублирования;
- упрощение совместной работы, обеспечивающее единую ясность для технических специалистов и нетехнических пользователей.
Благодаря интеграции семантических моделей в архитектуру DDP преобразует необработанные данные в полезные инсайты, помогаю достичь поставленных целей.