

Модуль 4. Моделирование данных в StarRocks
Методологическое значение моделирования
В StarRocks проектирование таблиц — это архитектурное решение, а не просто разработка схемы.
Ошибки на этом этапе приводят к тому, что:
- простая агрегация в BI идёт 30 секунд вместо 1–2;
- таблицы растут в 5 раз быстрее, чем ожидалось;
- ingest «захлёбывается» при пиках;
- MV не используются оптимизатором, и нагрузка падает на сырые данные.
Методология проектирования в StarRocks отличается от классических реляционных DWH, потому что:
- система не делает полноценных индексов в стиле PostgreSQL — мы должны закладывать их логику в структуру данных;
- компоновка данных (sort key, partition, distribution) влияет на план выполнения;
- типы таблиц (Duplicate, Aggregate, Primary Key) задают физическое поведение данных.
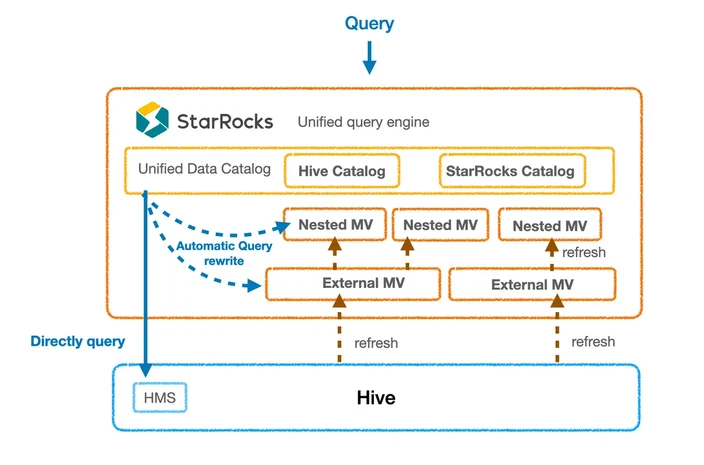
Типы таблиц и когда их использовать
StarRocks поддерживает три типа таблиц, которые напрямую влияют на ingestion, хранение и запросы:
-
Duplicate Key Table
- Что это: хранит дубликаты строк как есть.
-
Когда использовать:
- сырые логи, где важно сохранить 100% оригинала;
- временные зоны обработки перед агрегацией;
- стейджинговые зоны.
- Плюсы: быстрый ingest, простая структура.
- Минусы: быстрый рост объёма, без агрегации.
- Aggregate Key Table
- Что это: агрегирует строки по ключам, значения по колонкам объединяются агрегатными функциями (SUM, MIN, MAX и др.).
-
Когда использовать:
- предагрегированные витрины;
- отчёты по датам/категориям, где историчность на уровне агрегации.
- Плюсы: экономия места, быстрые запросы.
- Минусы: потеря детализации, ingest медленнее.
- Что это: поддерживает upsert и delete по ключу.
-
Когда использовать:
- витрины, где данные обновляются;
- интеграция с CDC;
- real-time отчёты с коррекциями.
- Плюсы: удобное обновление, консистентность.
- Минусы: выше нагрузка на BE, дороже по диску.
- Primary Key Table
Партиционирование (Partitioning)
Зачем:
- Уменьшает объём сканирования в запросах.
- Ускоряет загрузку (ingest) за счёт работы с конкретными партициями.
- Облегчает удаление/архивацию старых данных.
Варианты:
- Range Partition — по дате или диапазону чисел.
- List Partition — по значению (например, региону).
- Composite Partition — сочетание (дата+регион).
Методологические советы:
- Для real-time — день или час как партиция.
- Для batch-аналитики — месяц или квартал.
- Не плодить тысячи партиций — FE начинает тормозить на метаданных.
Пример:
PARTITION BY RANGE (dt) (
    PARTITION p202501 VALUES LESS THAN ("2025-02-01"),
    PARTITION p202502 VALUES LESS THAN ("2025-03-01")
)
Дистрибуция (Distribution)
Зачем:
- Равномерная нагрузка по BE-нoдам.
- Минимизация «горячих» сегментов.
Варианты:
- Hash — по одному или нескольким бизнес-ключам (например, customer_id).
- Random — только для тестов или низких объёмов.
Методологический совет: выбирать ключ, который:
- равномерно распределён,
- часто участвует в фильтрах или join,
- не создаёт «горячие» партиции.
Ключ сортировки (Sort Key)
Что это:
- Определяет порядок данных внутри сегментов.
- Влияет на скорость фильтрации и агрегаций.
Пример:
Для витрины продаж (region_id, sale_date) → сортируем по sale_date внутри region_id.
Совет:
- Не злоупотреблять количеством колонок — сортировка по 1–3 колонкам обычно достаточно.
- Сортировать по часто используемым в WHERE и GROUP BY полям.
Материализованные представления (MV)
Зачем:
- Хранить результаты тяжёлых запросов и переписывать SQL BI-инструмента на MV.
- Ускорять join и агрегации.
Пример:
CREATE MATERIALIZED VIEW mv_sales
AS
SELECT region_id, dt, SUM(amount) AS total_sales
FROM sales
GROUP BY region_id, dt;
Методология:
- Создавать MV под конкретные BI-дашборды.
- Проверять с EXPLAIN что запросы реально используют MV.
- Обновление — инкрементальное при возможности.
Практические кейсы
Кейс 1. Оптимизация витрины продаж
- Проблема: запрос по продажам за 2 года (1,5 млрд строк) занимал 40 сек.
-
Решение:
- Перевели таблицу в Aggregate Key по (region_id, sale_date).
- Добавили MV с предагрегацией по неделям.
- Применили партиционирование по месяцам.
- Результат: запрос сократился до 1,8 сек.
- Риск: потеря детализации на уровне транзакций.
- Защита: хранить дубликаты в отдельной raw-таблице.
Кейс 2. Real-time мониторинг логов
- Проблема: ingest из Kafka 300k событий/сек, запросы начали лагать.
-
Решение:
- Перевели на PK-таблицу с upsert по session_id.
- Разбили партиции по дню+часу.
- Увеличили batch в Routine Load.
- Результат: латентность снизилась до 3 сек.
- Риск: рост нагрузки на compaction.
- Защита: ночные окна компакшна.
Риски и как от них застраховаться
|
Риск |
Симптом |
Как избежать |
|---|---|---|
|
Неверный тип таблицы |
Медленные запросы или ingest |
Выбирать на основе профиля данных (Raw, Aggregated, Upsert) |
|
Перекос в дистрибуции |
Одни BE перегружены |
Подбор ключа, анализ распределения |
|
Слишком мелкие партиции |
Рост метаданных, лаги в FE |
Укрупнять партиции |
|
MV не используется |
BI стреляет в сырые таблицы |
Проверять переписывание с EXPLAIN |
|
TTL удаляет нужные данные |
Потеря истории |
Разделить active/historical зоны |
Методологические рекомендации
- Думать от запроса, а не от исходных данных — BI-дэшборды и их SLA определяют модель.
- Raw zone + витрины — хранить сырые данные и строить отдельные таблицы под BI.
- Инкрементальное обновление MVs — избегать полной перестройки.
- TTL и агрегация старых данных — уменьшает нагрузку и хранение.
- Ежеквартальный аудит схемы — удалять неиспользуемые колонки, витрины, MV.


