

Ассеты в оркестраторах данных: концепция и реализация в Airflow
Что такое ассеты?
В контексте систем оркестрации данных (Airflow, Dagster, Prefect) ассет — это абстракция, представляющая собой материальный объект данных: таблицу в базе данных, файл в облачном хранилище, модель в ML-реестре, агрегированную витрину в DWH и т.д.
У каждого ассета есть уникальный идентификатор, который, как правило, оформлен в стиле URI:
- postgresql://db/schema/table
- s3://bucket/path/to/file.parquet
- mlflow://model_registry/model_name/version
Ассеты позволяют описывать не просто задачи (tasks) и их порядок, а реальные данные и зависимости между ними. Таким образом мы получаем граф данных, а не только граф задач.
Ключевые особенности ассетов:
- Фокус не на коде, а на данных.
- Возможность отслеживания и документирования зависимости между данными.
- Прозрачность: легко понять, какие процессы влияют на конкретный набор данных.
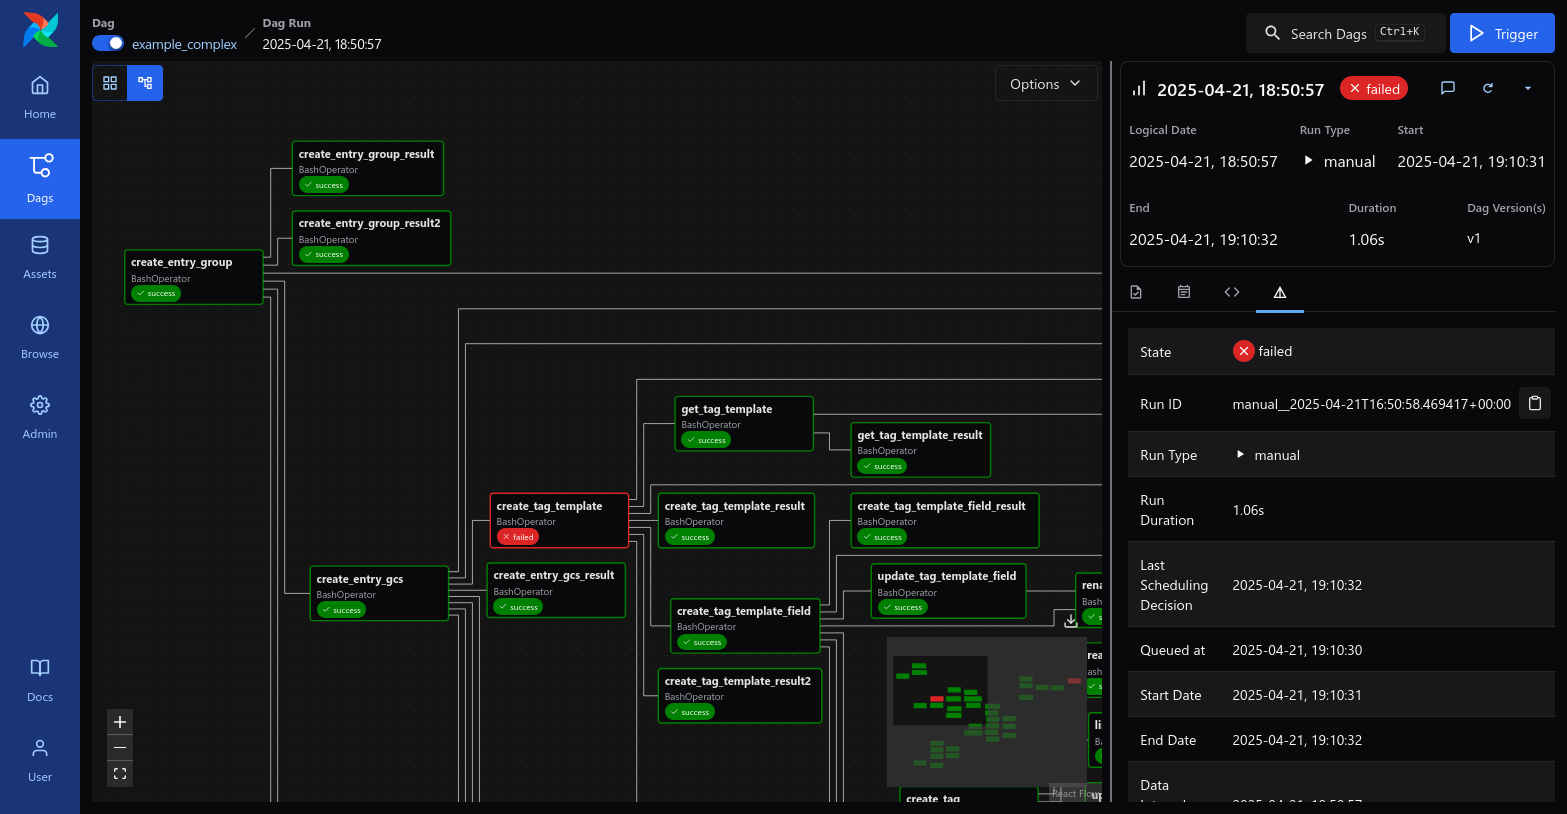
- Возможность построения lineage-графов (Data Lineage).
Почему эта концепция важна?
Рассмотрим аналогию из описания Prefect: в игре SimCity вы управляете одним и тем же городом, но можете переключаться между разными “линзами” — транспорт, электричество, водоснабжение.
С ассетами то же самое: вы можете смотреть на свою систему через призму зависимостей данных, истории обновлений или производных объектов.
Преимущества:
- Упрощение сопровождения: легче понять, что и когда сломалось.
- Минимизация переработок: если upstream-ассет не изменился, downstream-ассет можно не пересчитывать.
- Возможность частичного пересчёта цепочек (incremental builds).
Как Airflow работает с ассетами
История появления ассетов в Airflow
В Airflow 2.4 появился объект Dataset, позволяющий определять зависимость между задачами на основе данных, а не только графа задач. Это было революционным шагом для Airflow, который до этого жил исключительно в парадигме DAG → Tasks.
В Airflow 3.0 Dataset был переименован в Asset, что подчёркивает фокус на данных. Появился декоратор @asset для объявления функций, которые создают ассеты.
Пример использования в Airflow
from airflow.decorators import asset
from airflow.datasets import Asset
sales_table = Asset("postgresql://analytics/sales")
report_file = Asset("s3://reports/monthly_report.csv")
@asset(sales_table)
def extract_sales():
    # Логика извлечения данных из внешнего источника
    ...
@asset(report_file, inputs=[sales_table])
def generate_report():
    # Генерация отчёта на основе sales_table
    ...
Что происходит:
- Мы явно указываем, какие ассеты производит каждая функция.
- Airflow строит граф зависимостей ассетов, который существует параллельно с DAG.
- Можно запускать DAG, когда обновляется определённый ассет.
Ограничения ассетов в Airflow
В отличие от Prefect и Dagster:
- Нет динамической материализации: нельзя “на лету” добавить новый ассет в процессе выполнения.
- Нет императивного создания ассета: ассеты создаются строго в момент выполнения задачи с @asset.
- Слабее интеграция с lineage — нужен дополнительный инструмент (например, OpenLineage).
Как строится граф зависимостей в Airflow
Airflow отслеживает “события материализации” — факт создания или обновления ассета.
Механизм:
- Task, помеченная @asset, в конце работы “помечает” указанный ассет как обновлённый.
- Все DAG-и, которые зависят от этого ассета, могут быть автоматически запущены.
- Это реализует data-driven scheduling — запуск по готовности данных, а не только по расписанию.
Практическое применение ассетов в Airflow
- Автоматический запуск цепочек по готовности данных (например, после загрузки новой партии данных в S3).
- Построение lineage-графов для аудита.
- Интеграция с DQ-системами: можно “замораживать” downstream-задачи, если upstream-ассет не прошёл проверку качества.
- Инкрементальные пайплайны — запуск только тех частей, которые реально затронуты изменениями.
Технические риски и ограничения
Риски
- Сложность отладки — граф ассетов может быть неочевиден при большом количестве зависимостей.
- Ложные срабатывания — автоматический запуск DAG-а из-за изменения ассета, даже если изменение было незначительным.
- Отсутствие нативной CDC-логики — ассеты фиксируют факт обновления, но не передают дельту.
- Сложность при микросервисной архитектуре — ассеты в разных Airflow-инстансах не синхронизируются напрямую.
Ограничения Airflow-реализации
- Нет встроенной визуализации lineage без плагинов.
- Нет возможности группировать ассеты в “логические наборы” нативными средствами (только через DAG).
- Отсутствует полноценная интеграция с внешними каталогами данных (Data Catalog).
Лучшие практики при работе с ассетами в Airflow
-
Используйте осмысленные URI
Не table1, а postgresql://prod.analytics.sales_by_region. -
Разделяйте слой ассетов и слой задач
Tasks — это операции, ассеты — это данные. Смешивание может усложнить поддержку. -
Интегрируйте с Data Catalog / OpenLineage
Чтобы визуализировать зависимости и автоматизировать документирование. -
Внедряйте тесты качества данных
Чтобы downstream-ассеты не обновлялись при ошибочных данных.
Сравнение подходов: Airflow, Dagster, Prefect
|
Характеристика |
Airflow |
Dagster |
Prefect |
|---|---|---|---|
|
Фокус |
DAG-и и ассеты как дополнение |
Ассеты в центре архитектуры |
Гибкая смесь задач и ассетов |
|
Динамическая материализация |
× |
✓ |
✓ |
|
Data-driven запуск |
✓ |
✓ |
✓ |
|
Интеграция с lineage |
Ограничено |
Глубокая |
Автоматическая |
|
Кривая обучения |
Средняя |
Выше средней |
Низкая |
Ассеты в Airflow — это шаг в сторону data-centric парадигмы оркестрации, где важнее понимать, какие данные производятся и используются, чем просто управлять порядком задач.
Хотя реализация Airflow пока уступает Prefect и Dagster в гибкости, она уже даёт:
- Запуск пайплайнов по готовности данных.
- Возможность построения графов зависимостей на уровне данных.
- Улучшенную наблюдаемость и контроль изменений.
Для команд, которые уже используют Airflow и хотят начать мыслить категориями данных, ассеты — это хороший старт.
Высокоуровневая схема
+------------------------------ Airflow Control Plane ---------------------------+| || +-----------+ +-----------+ +-----------+ +------------------+ || | Web UI |<--->| Scheduler |<--->| Triggerer |<--->| Executor | || +-----------+ +-----------+ +-----------+ +---------+--------+ || ^ | || | v || +--------+-----+ +-------+ || | Worker Pool | | Sensors| || +--------------+ +-------+ || || +--------------+ +-----------------+ +---------------------------+ || | Metastore |<--->| Lineage/DQ |<---->| Logging/Observability | || | (DB: DAGs, | | (OpenLineage, | | (S3/GCS, Loki, ELK) | || | runs, assets)| | GreatExpect.) | +---------------------------+ |+--------------------------------------------------------------------------------+|| emits/consumes "Asset Materialization" eventsv+-------------------------------------- Data Plane --------------------------------------+| || +------------------+ +-------------------+ +---------------------------+ || | Sources |---> | Tasks/@asset | ---> | Sinks / Target Assets | || | (DB, APIs, Kafka)| | (Python,SQL) | | (DWHtables, S3 files, | || +------------------+ +-------------------+ | ML registry models) | || +---------------------------+ || |+----------------------------------------------------------------------------------------+
Идея: задачи (Tasks) с декоратором @asset производят/обновляют ассеты (таблицы/файлы/модели). Факт обновления фиксируется как событие материализации ассета. Планировщик (Scheduler) использует эти события, чтобы запускать зависимые DAG’и/задачи по готовности данных (data-driven scheduling). Метастор хранит реестр DAG’ов, ран-метаданные и карту ассетов. DQ/Lineage-сервисы получают события, строят lineage и валидируют данные. Логи и метрики идут в систему наблюдаемости.
Детальный поток событий (sequence view)
(1) Upstream Task (@asset) стартует| |читает исходные данныеv+-----------------------------------+ |Преобразование/загрузка данных| |(Python/SQL/библиотеки, Spark etc)| +-----------------------------------+ | |записываетцелевойобъектvTarget Asset (URI: postgresql://prod/analytics/sales_by_region)| | --> emit AssetMaterialized {uri, run_id, ts, version, checksum, metadata}v+------------------- Airflow Scheduler -------------------+ | -регистрирует событие ассета| | -вычисляет затронутые зависимости| | -помещает в очередь запусков нужные DAG runs| +--------------------------------------------------------+ |vDependent DAG(s) (dataset/asset-triggered)->Executor->Workers| |для каждого downstream шага: проверка предусловий|(вт.ч. DQ/SLAs/freshness/ partitionfilters)vDownstream Task(s) (@asset or @task)->производятслед. ассеты| +--> повтор цикла (каскадная материализация)
Модель данных и адресация ассетов (ключи в стиле URI)
Asset Key (URI) : <scheme>://<authority>/<path>[?<query>][#<fragment>]Примеры:- postgresql://prod/analytics/sales_by_region- s3://datalake/bronze/sales/2025/08/13/part-0001.parquet- mlflow://model-registry/churn_model/versions/42Metadata (минимум):- logical_name, uri, producing_task_id, producing_dag_id- materialized_at (ts), run_id, data_version/hash/checksum- optional: partition_keys, freshness_slo, schema_fingerprint
Определение зависимостей (data-driven scheduling)
+--------------------------+| DAG_B (consumer) || Triggers on: || Asset A = s3://... || Asset B = postgresql://... (AND condition)+--------------------------+
Условие запуска:
- обе материализации (A и B) новее последнего успешного run DAG_B
- опционально: совпали partition keys / data_version
- не нарушены DQ/SLAs
Жизненный цикл ассета
[REGISTER]->[MATERIALIZE]->[VALIDATE]->[PUBLISH]->[SERVE]->[RETIRE]| | || | +-->открытиепотребителям(BI/ML)| +-->DQchecks(Great Expectations, custom)+-->событиеAssetMaterialized(Airflow datasets/assets)
Смысл: после записи ассета происходит материализация и фиксация события. Далее проходят проверки качества/свежести, затем ассет публикуется и потребляется системами BI/ML. Когда схема или SLA устаревают — ассет снимается с публикации (retire) и замещается новой версией.
Встраивание DQ и Lineage
Upstream @asset ---->emits materialization| || +-->OpenLineage exporter --->LineageBackend(Marquez/Collibra/Atlas)|+-->DQ Hook --->GreatExpectations(context)|+-->ValidationResult(pass/fail, metrics)|+-->back toScheduler(block/unblock downstream)
Сенсоры и внешние триггеры
External System (e.g., Data Lake Loader)
    |
    +--> writes s3://landing/inbox/file.csv
            |
            +--> FileSensor / AssetSensor detects
                       |
                       +--> emits AssetMaterialized (for landing asset)
                               |
                               +--> Scheduler triggers ingestion DAG
Пример (сквозной, с URI и зависимостью)
Assет1(bronze):s3://datalake/bronze/sales/2025/08/13/*.jsonproducedby: dag=ingest_sales, task=@assetbronze_salesAssет2(silver):s3://datalake/silver/sales/2025/08/13/*.parquetproducedby: dag=transform_sales, task=@assetsilver_salesdepends_on: bronze_salesАссет3(gold, DWH):postgresql://prod/analytics/sales_by_regionproducedby: dag=mart_sales, task=@assetmart_sales_by_regiondepends_on: silver_salesBI-витрина(Looker/Power BI):connects to: postgresql://prod/analytics/sales_by_regionfreshness SLO: <= 2h since last bronze ingest
Поток:
- ingest_sales кладет сырые JSON в bronze и эмитит материализацию.
- transform_sales срабатывает по готовности bronze, пишет silver Parquet и эмитит материализацию.
- mart_sales срабатывает по silver, обновляет витрину в Postgres и эмитит материализацию.
- BI проверяет свежесть gold ассета.
Обратная заправка (backfill) и частичная материализация
Backfillwindow: 2025-08-01..2025-08-13(by daypartitions)fordindays:materialize(brownz/silver/goldfor partition=d)emit eventsper partition triggerdownstreamonly ford
Итог: пересчитываются только нужные партиции и каскады ниже по графу
Ошибки, риски, защиты
Риск: Оркестрация сработает от "шумной" материализации (пустые обновления).
Защита: сравнивать schema_fingerprint / checksum; игнорировать no-op.
Риск: Несогласованные версии данных между ассетами.
Защита: передача data_version/partition_keys в событии; strict matching при триггере.
Риск: Медленные сенсоры / дупликаты событий.
Защита: Reschedule-сенсоры, идемпотентные мьютексы (task instance lock), дедупликация по (uri, version).
Риск: Невидимые ошибки качества (битые партиции).
Защита: обязательные DQ-чекпоинты до эмиссии "валидной" материализации (или блокировка downstream при fail).
Риск: Разрыв lineage при сторонних загрузках.
Защита: стандартизованные эмиттеры событий, policy "no write without materialize event".
Мини-карта реализации в Airflow (понятиями)
DAG code:- @asset(outputs=[Asset("s3://.../silver/...")], inputs=[Asset("s3://.../bronze/...")])- Dataset/Asset dependencies declared per task- DatasetTriggeredDagRun (Airflow2.4+) / Assets (Airflow3.x)- Sensors (FileSensor, ExternalTask/AssetSensor)- DQ hooks (Great Expectations)aspre/post-task checks- OpenLineage providertoemit lineageontask successControl:- Scheduler listensfordataset/asset updates (metastore)- Triggerer wakes deferred tasks (sensors/asyncops)- Executor schedulesonWorkers (Celery/K8s/Local)State:- Metastore keeps DAG runs, task instances, asset events- Logsto objectstorage; metricstoPrometheus/StatsD
Эта текстовая схема отражает, как ассеты адресуются URI, как события материализации двигают вычисления «по данным», и где Airflow встраивает DQ, сенсоры и lineage, чтобы получить предсказуемый и воспроизводимый конвейер


