

Миграция хранилища данных: от вынужденной меры до стратегического апгрейда вашего Data-стека
Один из ключевых моментов в жизни любого data-подразделения — миграция хранилища данных. Это событие часто воспринимается как неизбежное зло, операция по ликвидации пожара, но мы готовы доказать, что это не так.
На примере реального кейса масштабной миграции для крупного образовательного проекта мы покажем, как переезд стал катализатором глубинной прокачки всего стека технологий, архитектуры и компетенций команды. Мы не только перенесли данные, но и построили более эффективную, отказоустойчивую и масштабируемую платформу, сократив операционные затраты и открыв новые возможности для аналитики.
Если вы стоите на пороге подобного решения, этот материал — готовое руководство к действию, написанное с учетом всех рисков, ошибок и проверенных решений.
Часть 1: Не пожар, а плановое обновление. Почему начался переезд?
Исходная инфраструктура заказчика работала стабильно, но с серьезными издержками. Ключевой pain point — размытое SLA ежедневной загрузки данных в продакшен. Процесс занимал несколько часов и требовал постоянного ручного контроля инженера. Проблема была не в мощности железа, а в архитектурных недоработках и неоптимальном коде, которые маскировались ресурсами серверов.
При ежедневном объеме данных в 14-16 ТБ эти недочеты стали критическими. Было принято стратегическое решение о смене облачного провайдера.
Первый этап миграции показал, что теоретические планы всегда сталкиваются с практикой. Новая среда не была готова к нашим объемам данных при сохранении старого стека. Мы столкнулись с таким понятием, как S3 Throttling - при нагрузочном тестировании система буквально «задыхалась». Провайдеру пришлось перенастраивать сеть и выделять более мощные ноды.
Примечание:
S3 Throttling (дословно — «троттлинг», «ограничение пропускной способности» или «дросселирование») — это механизм, используемый облачными провайдерами (такими как AWS, Yandex Cloud, Google Cloud и другими) для защиты своих систем хранения S3 от перегрузки.
Если говорить просто, это принудительное ограничение количества запросов к вашему бакету S3 в единицу времени.

Далее мы столкнулись с такой проблемой, как рандомные сбои при записи файлов в бакеты. Самое опасное в этом случае — если ошибка происходила на таблицах нижнего слоя (Core), это ломало все витрины верхних уровней. Восстановление было возможно только полной перегрузкой всего прода, что неприемлемо для бизнеса.
Мы не стали мириться со всеми этими проблемами и запустили целый комплекс мер. В первую очередь мы сделали апгрейд системы Data Quality. Мы разработали фреймворк для сравнения количества файлов, записанных Spark, с фактическим количеством в S3 после записи и внедрили систему ретраев (три попытки оказалось оптимальным числом). Помимо этого мы создали алерты, которые сигнализировали дежурному инженеру о сбое ретраев. Это давало возможность быстро отреагировать: точечно перезапустить даги или полностью остановить загрузку, чтобы сохранить консистентность данных на момент T-2.
Часть 2: Глубокая оптимизация архитектуры и стека
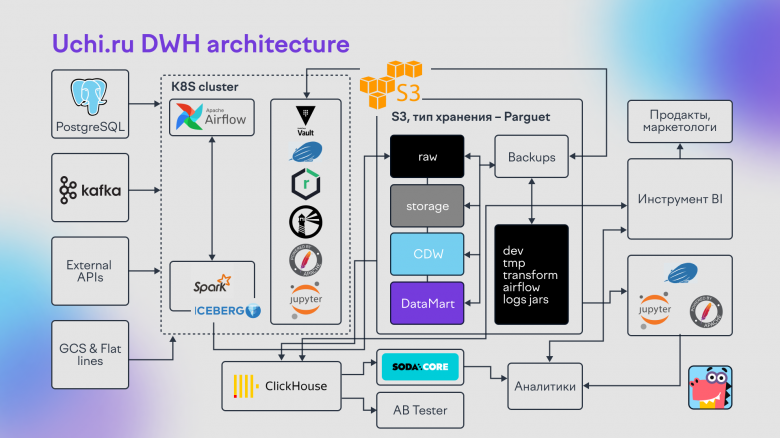
Чуть позже стало ясно, что необходимы фундаментальные изменения. Мы разработали план по изменению инженерной архитектуры, ключевым элементом которого стало внедрение Apache Iceberg для решения проблем с согласованностью.
Мы протестировали несколько решений для надежной записи данных:
- Дефолтный S3-коммитер - не подошел. Слишком медленный и требующий строгой консистентности, которой у нас не было;
- Staging directory-коммитер – гораздо быстрее, но не поддерживает партицированные таблицы. Проблемы периодически повторялись.
- Magic-коммитер – в разы надежнее и быстрее, но создавал новые проблемы — длительный пересчет партиций в Hive Metastore (до 10-15 минут для больших таблиц).
Таким образом, коммитеры лишь частично решали проблему в среде без строгой консистентности. Это привело нас к решению о смене провайдера на того, кто мог предоставить нужные гарантии. К этому моменту у нас уже был готовый чек-лист тестов, метрик и вопросов к саппорту.
Далее мы провели рефакторинг слоев данных внутри DWH. Выделили слой DDS (Data Delivery Service) - сюда мы вынесли плоские витрины из data mart, структурировав основной слой для данных. Затем мы создали слой CDM (Common Data Model) и полностью заменили им бессистемный набор агрегатов (это слой переиспользуемых и стандартизированных данных). После этого мы очистили Data Mart - оставили в нем только агрегаты для дашбордов, убрав транзакционные таблицы, что значительно повысило производительность и ясность.
Мы ушли от Custom SQL на стороне сервера Tableau к использованию экстрактов. Написали фреймворк для их автоматической загрузки по готовности витрин. В результате пользователи получили мгновенный доступ к актуальным данным без каких-либо задержек.
Далее мы привнесли на прод возможность делать версионированные таблицы (Slowly Changing Dimensions).
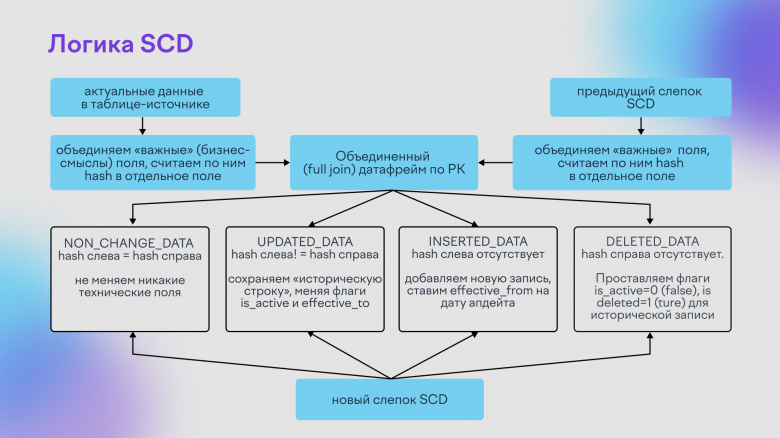
Кроме того, мы решили перейти с YARN на Kubernetes. Это решение было продиктовано поиском большей гибкости и эффективности. В результате мы получили сразу несколько неоспоримых преимуществ:
- Автомасштабирование- подключение дополнительных нод при пиковой нагрузке и их отключение в спокойные периоды (экономия средств);
- Разные версии Spark и Python в одном кластере - разработчики получили свободу выбора инструментов без конфликтов;
- Поддержка множества фреймворков - единая среда для управления сразу всеми задачами.
Помимо всего прочего мы обновили ClickHouse (деплой последней версии + создание тестового инстанса для аналитиков и пробных обновлений) и внедрили OpenLDAP, что дало нем децентрализацию управления доступом. Больше не нужно править конфиги каждого сервиса под каждого нового пользователя. Интеграция с ClickHouse в разы упростила управление правами.
Примечание:
OpenLDAP — это открытая (open-source) реализация LDAP (Lightweight Directory Access Protocol). Если говорить простыми словами, это сервис, который работает как универсальная адресная книга или телефонный справочник для всей вашей IT-инфраструктуры.
Далее, мы сделали деплой Hashicorp Vault, что обеспечило нам безопасное хранение секретов и ключей с доступом через LDAP и ролевой моделью, и модернизировали JupyterLab (решили проблему с лимитами хранения, интегрировав монтирование S3-бакетов прямо в рабочую директорию. Аналитики получили безразмерное и надежное хранилище для своих работ).
Кроме всего прочего мы заменили Thrift на Kyuubi для повышения производительности запросов к данным в S3 в 3-4 раза и радикального увеличения отказоустойчивости.
Примечание:
Apache Thrift — это фреймворк для создания межъязыковых сервисов. В контексте Big Data под "Thrift-сервером" обычно подразумевается Spark Thrift Server (STS). Это стандартный сервер, который запускается поверх Spark SQL и позволяет подключаться к нему с помощью JDBC/ODBC драйверов (например, из BI-инструментов вроде Tableau). Thrift Server — это монолитное решение, которое не отвечает требованиям современных, отказоустойчивых и динамичных data-платформ.
Kyuubi — это распределенный, cloud-native SQL-шлюз, который предоставляет многопользовательский доступ к движкам обработки данных (Spark, Flink, Trino). Его ключевая философия — "Отправляй вычисления к данным, а не данные к вычислениям". Kyuubi не является долгоживущим Spark-приложением, он работает как менеджер сессий (Session Manager) или "оркестратор". Когда клиент (например, Tableau) отправляет SQL-запрос через JDBC
Далее мы обновили AirFlow - переход на последнюю версию ускорил запуск задач и открыл возможности нативной интеграции с Kubernetes.
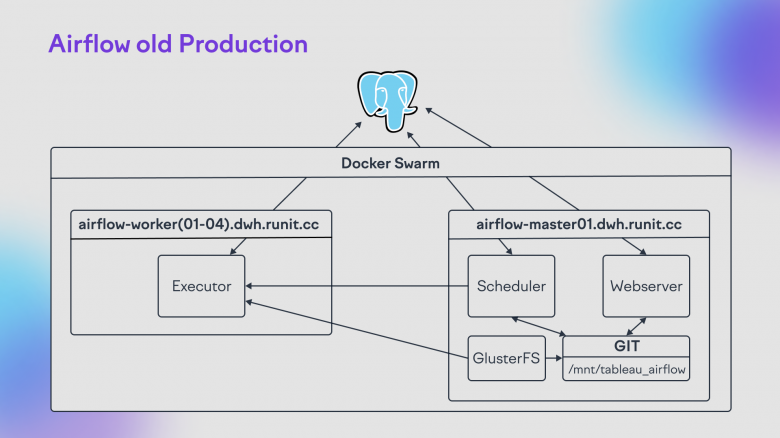
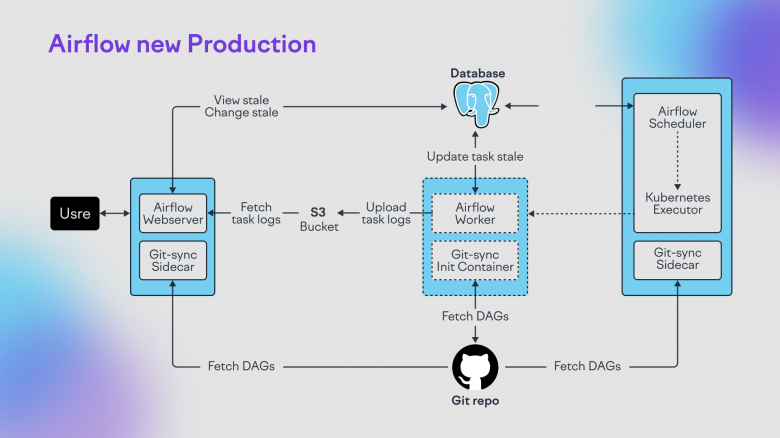
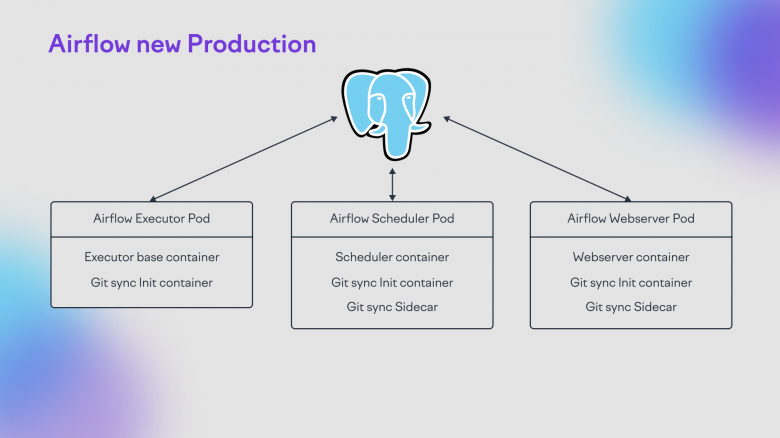
Часть 3: Внедрение Apache Iceberg — ключ к надежности
Apache Iceberg — это высокоуровневый открытый формат табличных данных (Open Table Format), предназначенный для хранения огромных, терабайтных и петабайтных, наборов данных в распределенных системах, таких как AWS S3, HDFS или Google Cloud Storage.
Если говорить просто, Iceberg — это слой интеллекта поверх ваших файлов данных (Parquet, Avro, ORC), который превращает набор файлов в полноценную, управляемую базу данных с возможностями, ранее недоступными в мире Big Data.
Его основные преимущества:
- Скорость - встроенный коммитер дал значительный прирост скорости записи;
- Версионность (Time Travel) - возможность откатиться к любому предыдущему состоянию данных, что бесценно для анализа и отладки;
- Надежность - проблема неполной записи данных была окончательно решена.
Внедрение Iceberg — это не просто установка плагина. Это изменение парадигмы работы с данными. Требуется перенастройка процессов и, зачастую, перерасчет существующих слоев DWH. Мы столкнулись с тем, что некоторые источники меняли данные задним числом, что выявляло новые требования к качеству данных.
В целом хотим подчеркнуть, что миграция — это не просто переезд данных из точки А в точку Б. Это уникальное окно возможностей для тотального апгрейда Вашей data-платформы. В результате Вы получите значительное сокращение SLA загрузки данных, повышение отказоустойчивости и производительности всех компонентов стека, внедрите современные практики управления данными (Data Quality, Versioning, Security), а также привлечете высококлассных специалистов, мотивированных сложными амбиционными задачами.
Миграция заставит Вас сместить фокус с операционных задач (Run) на задачи развития (Change). Это инвестиция в будущее, которая окупается за счет снижения эксплуатационных расходов, увеличения скорости получения аналитики и снижения рисков потери данных.


