

Метаданные в BI и OpenMetadata
Представьте себе огромную библиотеку, где книги разбросаны по полу без каких-либо опознавательных знаков. Текст внутри книги — это Ваши данные. А вот название книги, автор, оглавление, индекс — это и есть метаданные. Без них найти нужную информацию практически невозможно.
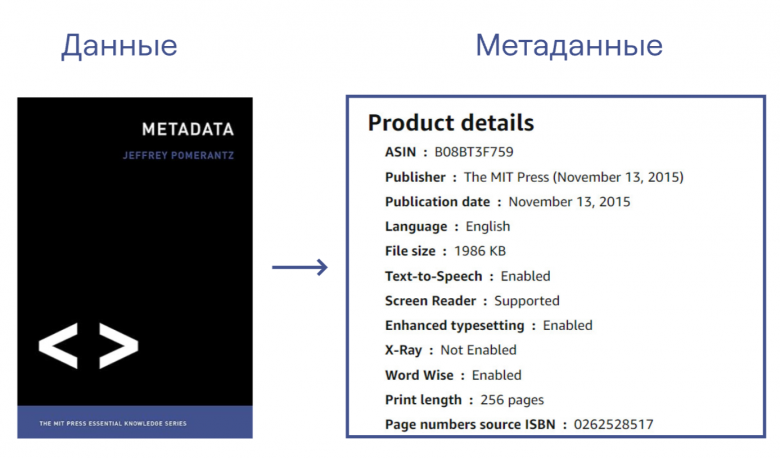
Или другой пример: посмотрите «Свойства» любого файла на вашем компьютере. Вы увидите его размер, дату создания, тип — это все метаданные.
В мире BI и аналитики метаданные — это всё, что описывает Ваши данные:
- Структура: какие есть базы данных, схемы, таблицы, колонки? Как они называются и какого типа?
-
Смысл: что означает эта колонка
revenue_qtd? Она включает НДС или нет? Это операционная выручка или общая? - Происхождение (data lineage): откуда эти данные взялись? Какие преобразования они прошли, прежде чем попасть в эту таблицу?
- Качество: насколько эти данные полны, актуальны и достоверны? Сколько в этой колонке пропущенных значений?
- Отношения: как эта таблица связана с другими?
- Использование: кто и какие дашборды строит на основе этих данных?

Почему управление метаданными — это не «хорошо бы иметь», а самый настоящий must have?
Без централизованной системы управления метаданными компании сталкиваются с одними и теми же болезненными проблемами.
«А где же мне взять эти цифры?» - аналитик тратит до 60-80% времени не на анализ, а на поиск и проверку данных. Он обходит десятки таблиц, спрашивает коллег в чатах, пытается понять, какая из трех таблиц sales является верной.
Ошибки в решениях – еще один важный аспект. Разные департаменты используют разные определения одного и того же показателя (например, «активный клиент»). Финансы считают одно, маркетинг — другое. В итоге отчеты не сходятся, а руководство принимает решения на основе некорректных данных.
Хрупкость аналитики - когда ключевой инженер уходит в отпуск или увольняется, оказывается, что никто не знает, как работает сложный ETL-процесс, который готовит данные для всех отчетов. Любое изменение в источнике приводит к многодневному простою.
И, наконец, проблемы с compliance. Невозможно найти и защитить все данные, содержащие персональную информацию (PII), что ведет к риску огромных штрафов.
Рассмотрим пример из практики. Крупный ритейлер потратил полгода и несколько миллионов рублей на разработку сложной ML-модели для прогноза спроса. Модель работала плохо. Оказалось, что в ключевой таблице sales колонка date_id на самом деле содержала не дату продажи, а дату загрузки данных в систему, со смещением в трое суток. Из-за этого модель училась на неверных данных. Проблема была обнаружена случайно. Простой тег в системе метаданных PII: false или комментарий к колонке спас бы полгода работы и бюджет.
OpenMetadata – самый лучший инструмент для построения Data Culture
Мы проанализировали множество инструментов, представленных на рынке (Amundsen, DataHub, Atlan) и решили остановиться на OpenMetadata. Это открытая, универсальная платформа, которая объединяет в себе каталог данных, инструменты качества и коллаборации.
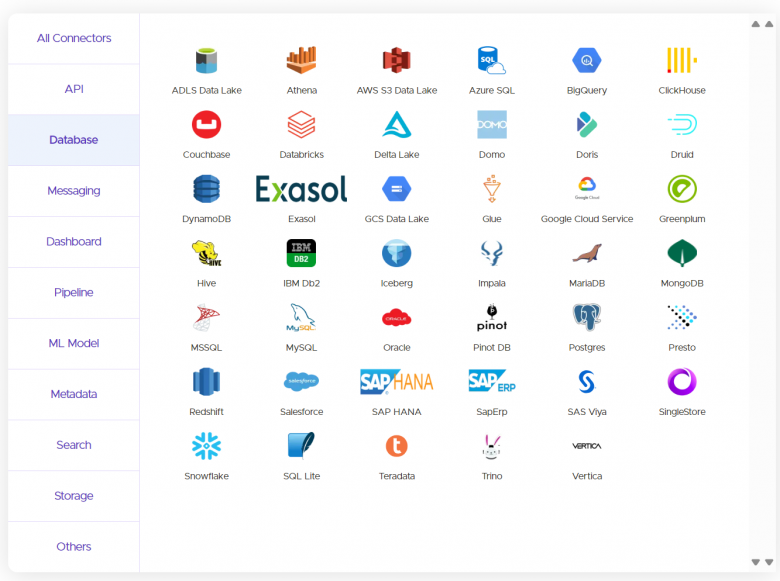
OMD поддерживает более 70 коннекторов ко всем популярным системам: базы данных (PostgreSQL, MySQL, BigQuery, Snowflake), дата-лейки (Iceberg, Hudi, Delta Lake), BI-системы (Tableau, Superset, Looker), пайплайны (Airflow, dbt), messaging systems (Kafka).
Самая типичная ошибка, которую можно допустить на старте- попытаться подключить всё и сразу. Это создает информационный шум и демотивирует команду. Мы выступаем за поэтапный подход:
- Этап 1 - подключить 1-2 ключевых источника данных (например, ваше основное хранилище и витрину данных);
- Этап 2- добавить BI-систему (например, Tableau), чтобы связать дашборды с исходными данными;
- Этап 3 -подключить пайплайны (Airflow) для построения Lineage;
- Этап 4 - постепенно расширять охват на все остальные системы.
Главная магия начинается, когда Вы добавляете бизнес-контекст.
Описания: OMD автоматически подтягивает комментарии из БД (если они там есть). Но чаще всего их нет. Мы настоятельно рекомендуем нашим клиентам завести процесс, при котором описание таблиц и колонок является обязательным шагом перед выкладкой данных в продакшн. В OMD можно легко заполнить эти описания через веб-интерфейс.
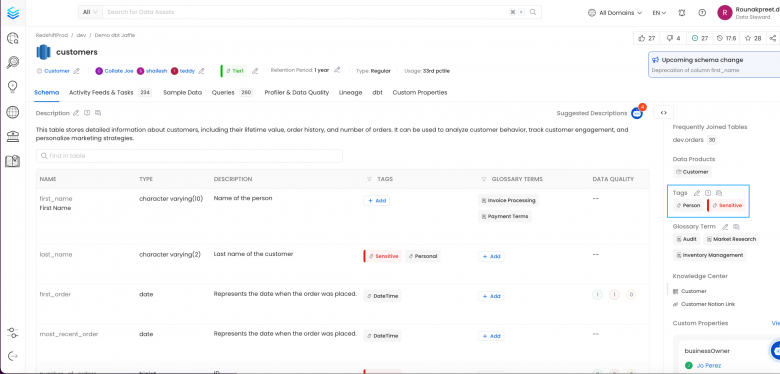
Теги - это мощнейший инструмент классификации. Мы используем их для двух основных целей:
-
Безопасность: Теги
PII(Personal Identifiable Information),PCI(данные кредитных карт),Confidential. Они автоматически запускают процессы маскирования данных для неуполномоченных пользователей; -
Классификация: Теги
Marketing,Finance,Logisticsпомогают быстро отфильтровать данные по доменам.
Главная ошибка в данном случае заключается в том, чтобы создавать десятки никому не понятных тегов без единой стратегии. Мы всегда помогаем клиентам разработать единую таксономию тегов перед их массовым применением.
Глоссарий - это сердце Вашей бизнес-терминологии. Именно здесь Вы определяете, что такое «активный клиент», «LTV», «выручка». Прекращение споров на совещаниях! В OMD можно создать иерархические термины, связать их между собой и, самое главное, привязать эти термины к конкретным колонкам в таблицах. Пользователь может кликнуть на термин «Выручка» и сразу увидеть все таблицы и колонки, где она считается.
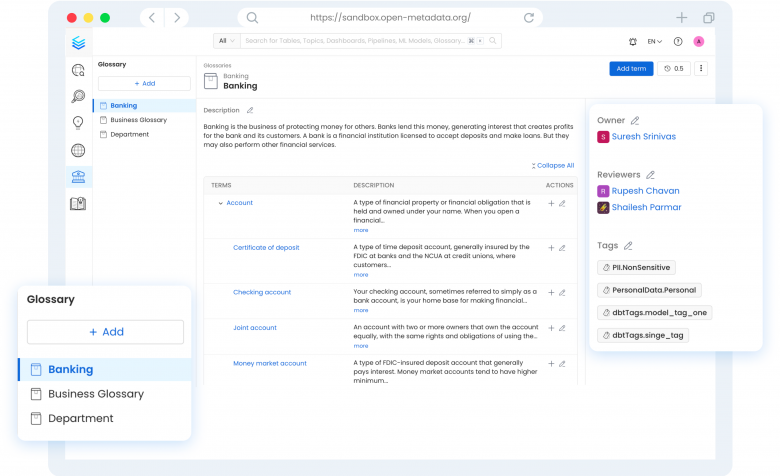
Владельцы метаданных - это самая важная функция для обеспечения ответственности. Каждый датасет должен иметь владельца или команду-владельца. Это те люди, к которым можно прийти с вопросом «Почему данные в этой таблице обновляются с задержкой в сутки?». OMD поддерживает наследование владельцев (назначили владельца базы -> он автоматически владелец всех таблиц в ней), что упрощает управление.
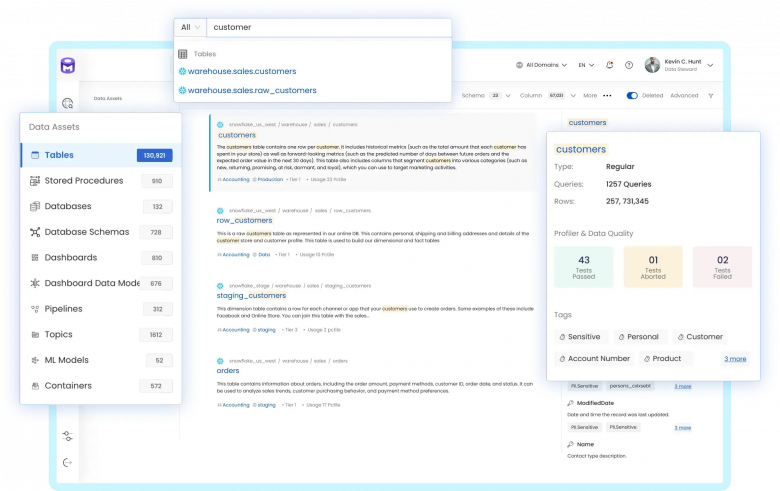
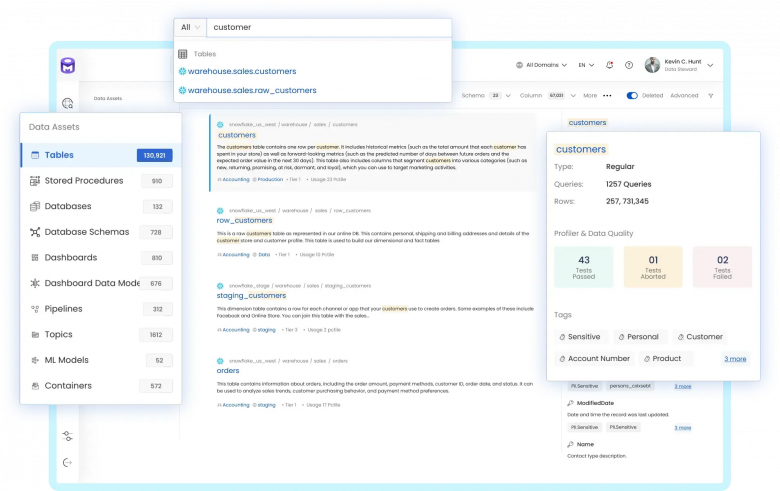
Поиск и обнаружение: Google для ваших данных
После настройки OMD поиск данных превращается из квеста в рутину. Аналитик может не просто искать по названию таблицы (sales), но и по бизнес-термину (выручка), по тегу (PII), по описанию. Это экономит часы рабочего времени ежедневно.
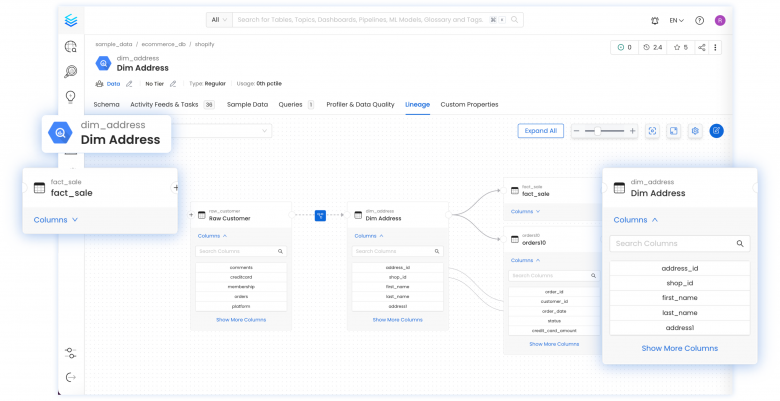
Data - lineage: карта Вашей data-вселенной
Это один из самых ценных функционалов. Data Lineage визуально показывает, откуда данные пришли, какие преобразования прошли и куда пошли дальше.
Пример:
В OMD Вы видите, что дашборд «Ежедневные продажи» в Tableau (Dashboard A) берет данные из витрины dm_daily_sales (Data Mart), которая, в свою очередь, строится из сырых таблиц raw_sales и raw_products через ETL-процесс в Airflow.
В таблице raw_products изменили название колонки с prod_id на product_id.
ETL-пайплайн падает, витрина не обновляется, дашборд показывает вчерашние данные. Поиск причины может занять полдня.
Решение: Инженер видит в OMD, что падающий ETL-процесс зависит от raw_products. Он мгновенно строит Lineage и видит, что колонка prod_id используется в витрине dm_daily_sales. Причина найдена за 2 минуты. Он вносит правку в ETL-скрипт.
Lineage бывает двух видов: автоматический (OMD сам строит его, анализируя SQL-код в DBT или Airflow) и ручной (если процесс кастомный, связь можно проставить вручную).
Качество данных: доверие, подкрепленное цифрами
Доверие к данным не появляется по взмаху волшебной палочки. Его нужно строить и постоянно подтверждать.
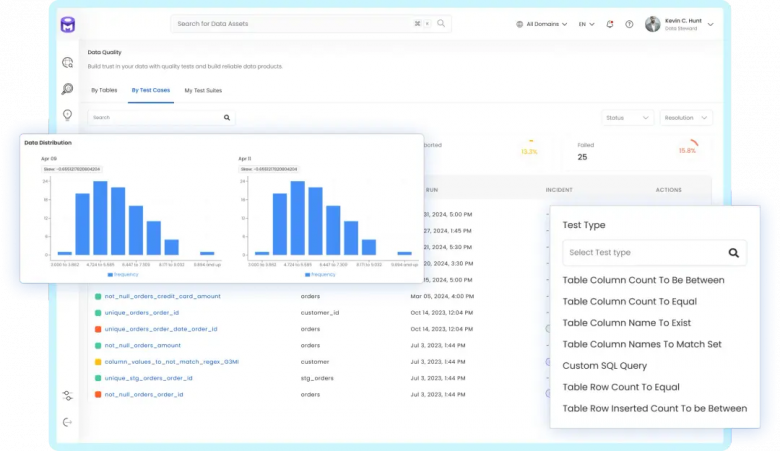
Основные способы поддержания высокого качества данных:
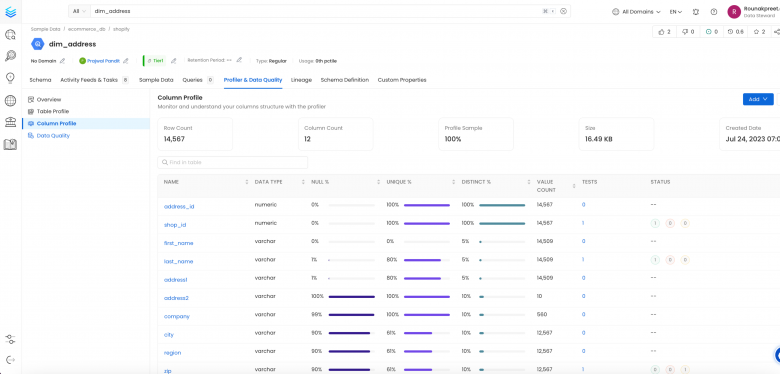
Профилирование данных - OMD может автоматически сканировать Ваши таблицы и показывать статистику: распределение значений в колонках, количество NULL, минимум/максимум, уникальность. Это первый шаг к понимаю качества данных.
Тестирование или активный мониторинг. OMD позволяет настраивать тесты для таблиц и колонок.
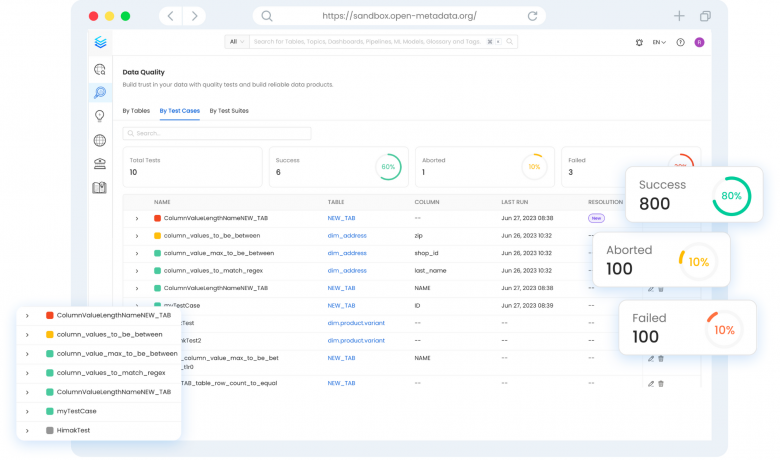
Можно использовать no-code интерфейс для простых тестов или Python SDK для сложных, кастомных проверок.
Однако в данном случае существует риск создать сотни тестов, которые будут падать постоянно, и команда перестанет на них реагировать («эффект мальчика, который кричал „волки“»). Мы рекомендуем начинать с 5-10 самых критичных для бизнеса тестов и постепенно расширять покрытие.
Еще одна важная вещь, о которой стоит упомянуть – это менеджер инцидентов. Когда тест падает, создается инцидент. OMD позволяет настроить workflow: кому приходит оповещение (в Slack, по email), кто ответственный за исправление, как отслеживается статус. Это превращает разрозненные сбои в управляемый процесс.
Коллаборация и оповещения: оживляем данные
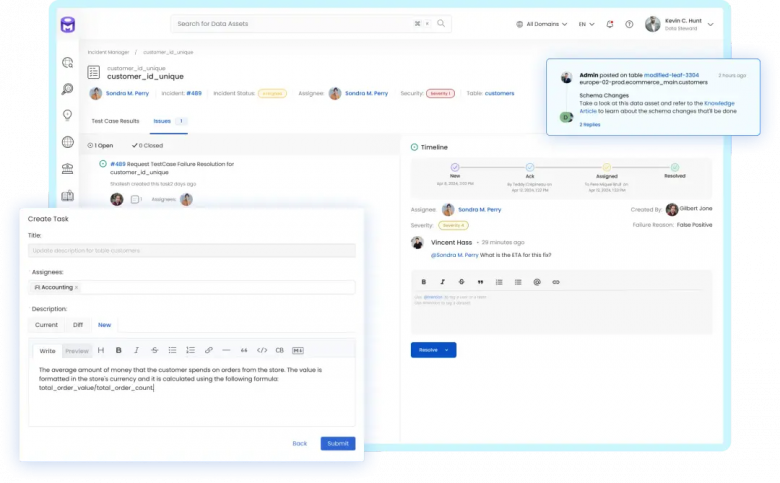
OMD — это «социальная» сеть для Ваших данных. Внутри платформы можно обсуждать любой ассет: «А почему в этой колонке вчера было столько NULL?». Создавать задачи - «Владельцу: просьба добавить описание к этой таблице». Подписываться на изменения - получать уведомления, если в важную для Вас таблицу добавили новую колонку или если упал тест качества. Делать объявления: «Внимание! Завтра с 02:00 до 04:00 будет происходить перезагрузка таблицы sales. Дашборды могут не работать».
Это убивает разрозненные переписки в мессенджерах и почте и хранит всю историю обсуждения данных в одном месте.
Наши рекомендации по внедрению OMD
Внедрение системы управления метаданными — это на 20% про технологию и на 80% про процессы и людей.
Начните с бизнес-проблемы, а не с технологии. Не «внедрим OMD», а «решим проблему поиска данных и согласованности отчетов». Найдите в компании боль — и устраните ее с помощью OMD.
Назначьте ответственных (Data Owners). Без этого система быстро устареет. Сделайте кого-то ответственным за каждый важный датасет.
Разработайте единые стандарты: на наименования таблиц, на описание, на теги. Без этого будет каша.
Продвигайте и обучайте. Проводите воркшопы, показывайте аналитикам, как инструмент экономит их время. Создайте «послов данных» — людей, которые продвигают data culture в отделах.
Самая большая ошибка — купить лицензию/установить OMD и бросить это на самотек. Через полгода он превратится в еще одно «кладбище данных», которое покажет устаревшую информацию и только усилит недоверие.
OpenMetadata — это не просто еще один инструмент в вашем data-стеке. Это центральная нервная система вашей data-культуры. Это платформа, которая соединяет инженеров данных, аналитиков, бизнес-пользователей и менеджмент, говорящих, наконец, на одном языке.
Внедряя его, Вы инвестируете не в софт, а в скорость, доверие и качество ваших данных, а значит, и в качество бизнес-решений, которые на них основаны.


