

Data Vault 2.0: секреты эффективного хранения данных
Сегодня мы хотим поделиться с Вами не просто сухой теорией, а нашим практическим опытом построения хранилищ данных по методологии Data Vault 2.0. Это далеко не панацея, но в определенных сценариях — это единственный способ построить систему, которая не упадет под тяжестью постоянно меняющихся бизнес-требований.
Почему классические подходы Инмона и Кимбалла сегодня буксуют?
Когда мы только начинали, мир данных был гораздо проще. Данные текли из нескольких операционных систем, структура была относительно стабильной, а бизнес мог ждать месяцами для получения нового отчета. Классические подходы — нормализованное хранилище Инмона или звездообразные схемы Кимбалла — работали.
Сегодня всё изменилось. Данные льются из сотен источников: мобильные приложения, CRM, ERP, IoT-устройства, SaaS-сервисы. Бизнес требует новые метрики «на вчера», а структура данных меняется ежеквартально. Классические архитектуры с их жесткими связями и сложными ETL-процессами просто не успевают за этим темпом.
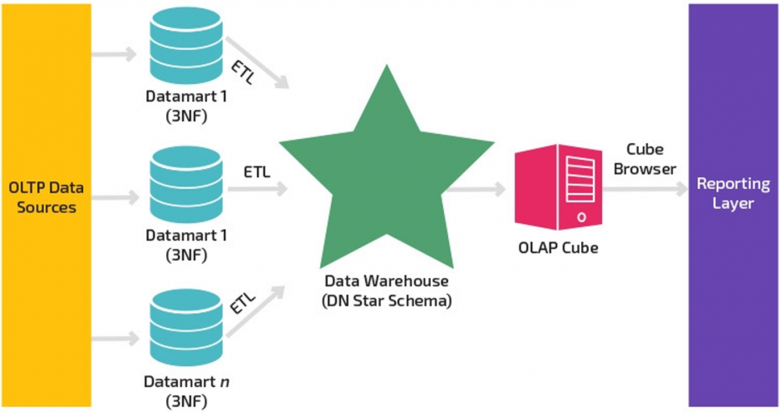
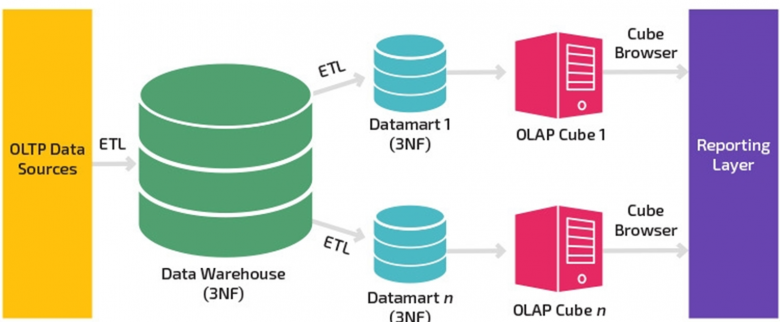
Как известно, традиционная архитектура DWH может быть построена либо по методу Ральфа Кимбалла, либо по методу Билла Инмона.
Метод Кимбалла: выгрузка данных из источников в DWH, построенное по схеме «звезда».
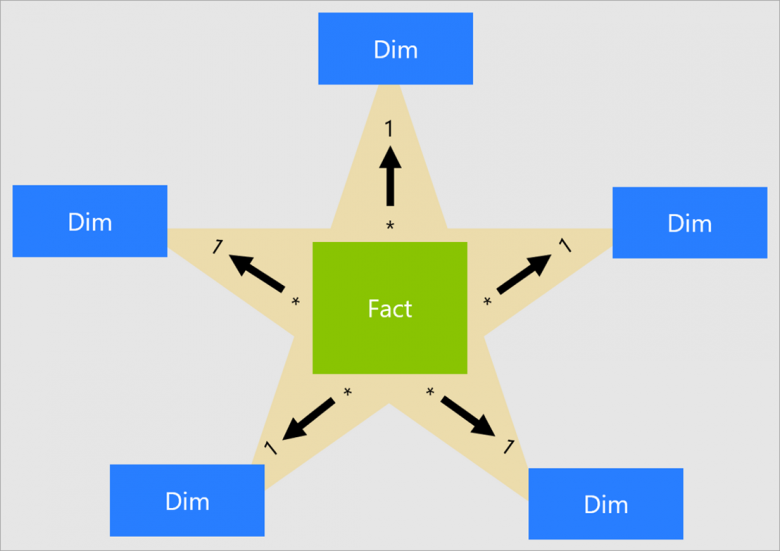
Метод Инмона: сначала разработка, проектирование и создание централизованного хранилища, потом создание витрин данных.
Типичные головные боли наших клиентов до перехода на Data Vault:
- «Мы год разрабатываем витрину, а потом бизнес меняет требования, и мы переделываем всё с нуля». Жесткая схема «звезда» не прощает изменений. Добавление нового атрибута или измерения ведет к каскадным правкам ETL, перестройке витрин и простою;
- «Наши ETL-процессы стали монолитом, который никто не понимает». Логика обработки данных расползается на тысячи строк кода, где всё связано со всем. Исправить одну ошибку — значит сломать три другие;
- «Мы не можем понять, откуда взялась эта цифра в отчете». Отсутствие сквозной прослеживаемости (data lineage). Когда в отчете появляется аномалия, недели уходят на то, чтобы найти корень проблемы в цепочке преобразований;
- «Наше хранилище перестало масштабироваться». Объем данных вырос в 10 раз, а время обновления — в 50. Добавление новых источников стало настолько болезненным, что проще отказаться, чем интегрировать.

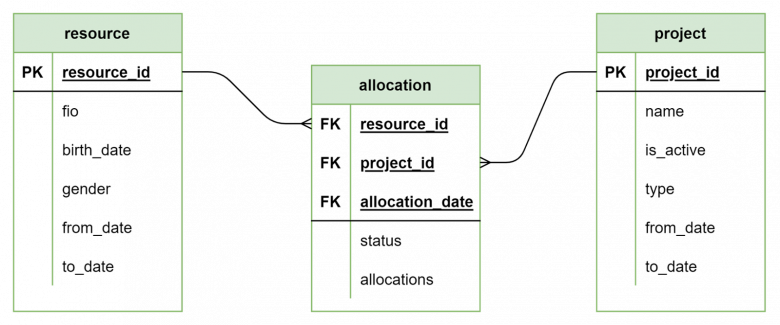
Пример «Проекты-ресурсы»
Представим, что у нас есть:
- таблица resource (сотрудники);
- таблица project (проекты);
- таблица allocation (распределение) – показывает, какой ресурс в какое время и где был задействован.
Для обеспечения историчности используются атрибуты from_date и to_date.
Через некоторое время мы получаем от бизнеса следующие требования:
1. Добавить информацию об отделах сотрудников
Сложности:
- Нужно будет добавить новую таблицу Departments и установить связи с таблицей Resource. Это приведет к необходимости обновления схемы базы данных;
- Нужно будет изменить процессы загрузки данных, что увеличит время выполнения ETL-задач и усложнит поддержку.
- Существующие отчеты и data marts, использующие данные сотрудников, нужно будет подогнать под новую структуру, что в теории может привести к временным сбоям в их работе.
2. Добавить иерархию отделов
Сложности:
- Потребуется добавить дополнительные поля в таблицу Departments, чтобы хранить информацию о родительских отделах. Это может повлиять на все существующие процессы, работающие с данными отделов.
- Необходимо будет установить новые ограничения внешних ключей, что усложнит целостность данных и увеличит риск ошибок при их загрузке.
- Витрины и отчеты нужно будет адаптировать для отображения иерархической структуры отделов, что потребует времени и ресурсов на доработку.
3. Добавить возможность сложной вложенности отделов (прямое и функциональное подчинение)
Сложности:
- Для хранения информации о подчинении потребуется добавить поля или создать новые таблицы - это усложнит логическую модель и увеличит количество таблиц и связей.
- Придется переработать существующие ETL-процессы, что увеличит время на обработку данных и усложнит отладку.
А теперь обратим внимание на подход Data Vault 2.0
Data Vault 2.0: не усложнять, а структурировать хаос
Data Vault 2.0 — это не просто другая модель данных. Это принципиально иная философия построения хранилища, которая решает все эти проблемы через гибкость, параллелизм и аудируемость.

Основная идея Data Vault проста: разделить данные на три независимых и простых типа сущностей:
-
Хабы - это ядра бизнес-сущностей. В хабе хранится только уникальный бизнес-ключ (например,
customer_id,product_sku) и технические метаданные. Важнейшее правило: данные в хабе никогда не изменяются и не удаляются. Хаб — это список уникальных ключей, которые когда-либо встречались в системе; - Ссылка (Links) - это соединения между хабами. Связь моделирует бизнес-событие или отношение: «заказ», «транзакция», «факт посещения». Связь содержит ключи связанных хабов и технические метаданные. Как и хабы, связи неизменны;
-
Спутники - это всё, что изменяется во времени. Атрибуты, описания, статусы — всё это хранится в спутниках. Каждый спутник привязан к одному хабу или одной связи и содержит историю изменений своих атрибутов с помощью полей
load_dateиend_date.
Проще говоря, хаб – это «кто?» или «что?» (Клиент №123); ссылка - «Что сделал?» или «С кем связан?» (Клиент №123 совершил Заказ №456), а спутник - это «Каким он был?» (На 01.01.2023 клиент №123 имел имя «Иван» и статус «активен»)
Пример «Проекты-ресурсы»
Приведем наш пример, указанный выше к виду DataVault.
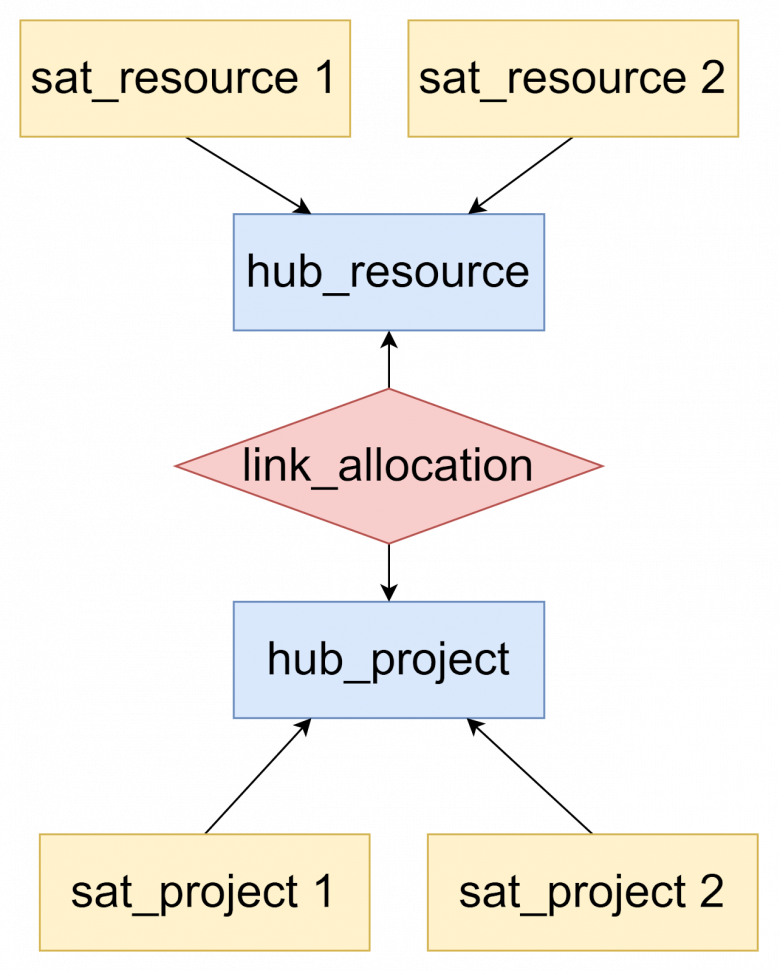
В получившейся структуре:
- синие блоки hub_ — объекты (ресурсы, отделы, проекты, сущности)
- желтые блоки sat_ —атрибуты объектов
- красные ромбы link_ — таблицы ссылок
Решение с использованием подхода Data Vault 2.0
В подходе Data Vault 2.0 каждое новое бизнес-требование обрабатывается путем добавления новых хабов, ссылок и сателлитов, что обеспечивает гибкость и минимизирует влияние на текущую архитектуру.
Реализуем каждое из приведенных выше требований.
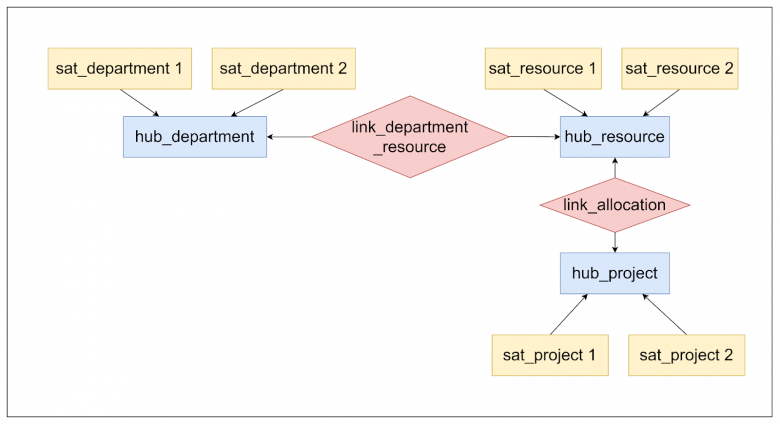
1.Добавить информацию об отделах сотрудников.
Для решения данной задачи в Data Vault потребуется создать хаб для хранения уникальных идентификаторов отделов и их ключевых атрибутов:
- Создание хаба для отделов (hub_department)
- Создание сателлита для атрибутов отделов (sat_department 1, 2)
- Создание ссылки между сотрудниками и отделами (link_department_resource)
Мы создали новые таблицы для отделов, не меняя существующую структуру.
2. Добавить иерархию отделов
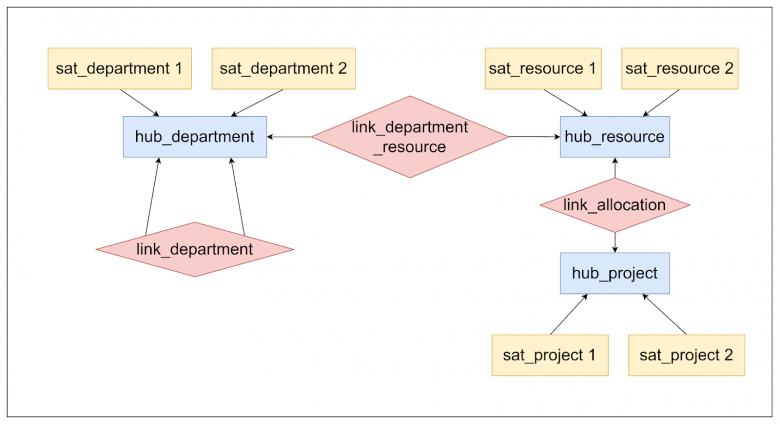
Создаем новую ссылку, описывающую отношения между отделами.
Создаем ссылку иерархии отделов (link_department)
Эта таблица фиксирует иерархию отделов без необходимости изменения хаба или сателлитов отделов.
3. Добавить возможность сложной вложенности отделов (прямое и функциональное подчинение)
Для реализации иерархии сразу с несколькими типами подчинения можно использовать таблицу ссылок иерархии отделов (link_department) либо создать новую таблицу ссылок.
Ключевые преимущества Data Vault 2.0 в реалиях российского бизнеса
- Скорость и гибкость реагирования на изменения бизнеса. Это главное преимущество. Новый источник данных? Просто добавляем новые хабы, связи и спутники. Не нужно перестраивать всю архитектуру. Это критически важно в условиях, когда бизнес-модели меняются каждый квартал.
- Параллельная разработка. Разные команды могут независимо работать с разными частями модели данных. Команда по работе с клиентами развивает свои хабы и спутники, а команда по продуктам — свои. Они не блокируют друг друга.
- Автоматическая историчность. В Data Vault вы по умолчанию сохраняете всю историю изменений атрибутов. Для бизнеса это значит возможность делать срезы на любую дату в прошлом без сложных реконструкций.
- Устойчивость к плохому качеству данных из источников. Если из источника пришли «кривые» данные, они попадают в спутник с пометкой об источнике. Вы можете позже добавить правильные данные из другого источника. Модель от этого не сломается.
- Прозрачность и аудируемость. Вы всегда можете точно сказать, откуда взялась каждая цифра, в каком источнике и когда она появилась. Это снимает бесконечные споры между департаментами и упрощает аудит.
Подводные камни и кому НЕ стоит смотреть в сторону Data Vault
Во-первых, это сложность для конечных пользователей. Data Vault — это не модель для отчетности. Это сырая, нормализованная модель для разработчиков. Без витрин данных (Data Marts) бизнес-пользователи ничего в ней не поймут. Вы не сможете подключить Tableau прямо к Data Vault. Вам придется поверх него строить витрины в виде тех же «звезд» Кимбалла. Это дополнительный слой и затраты. Наша рекомендация - заранее закладывайте время и бюджет на построение витрин. Автоматизируйте их генерацию с помощью инструментов вроде dbt.
Во-вторых, это обилие таблиц и JOIN-ов. Вместо одной таблицы customer у вас будет hub_customer, sat_customer_personal_data, sat_customer_status и т.д. Выборка данных требует десятков JOIN-ов. Риск заключается в резком падении производительности запросов. Решение - Data Vault идеально работает только с MPP-СУБД (Massively Parallel Processing), которые designed для большого количества JOIN-ов: Snowflake, Teradata, Greenplum, ClickHouse. Пытаться построить Data Vault на MySQL или обычном PostgreSQL — это путь к боли и страданиям.
В – третьих, это сложность модели для понимания. Модель Data Vault может содержать тысячи таблиц. Без хороших инструментов визуализации и документации (например, SqlDBM, Erwin) разобраться в ней невозможно. Ошибочно начинать проект без утвержденных стандартов именования и инструмента для визуального проектирования. Вы очень быстро запутаетесь в своих же hub_, lnk_, sat_.
В –четвертых, это необходимость зрелой экспертизы. Data Vault требует иной образ мышления. Разработчикам, привыкшим к «звездам», сложно перестроиться. Недостаток опыта приводит к созданию неправильных связей или спутников, которые потом приходится переделывать. Наше решение - мы всегда начинаем с интенсивного обучения команды заказчика и проводим пилот на небольшом, но значимом кусочке данных.
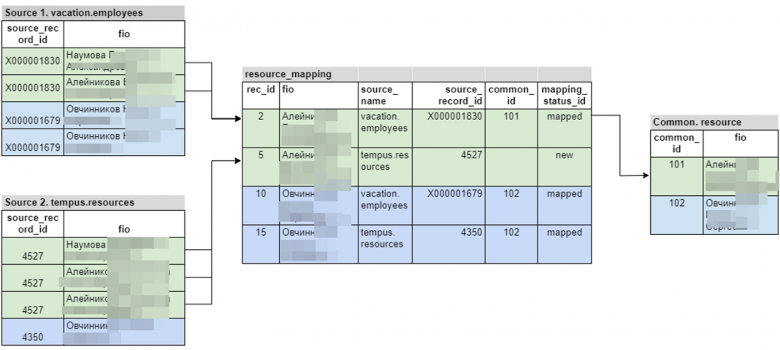
Все эти особенности усложняют процесс интеграции данных в DWH и требуют тщательного проектирования и использования надежных инструментов для управления и консолидации мастер-данных.
На изображении ниже - пример данных, где одни и те же сотрудники имеют различные идентификаторы в разных системах.
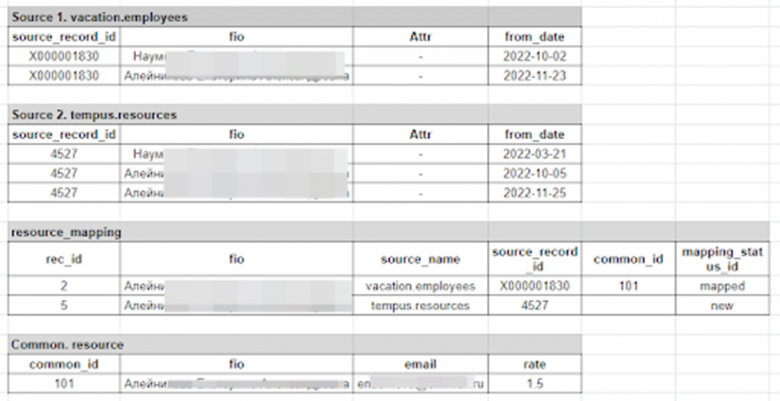
Для сопоставления данных из различных источников с единой общей таблицей (Common) используется промежуточная таблица, позволяющая установить соответствие между разными идентификаторами и упорядочить информацию.
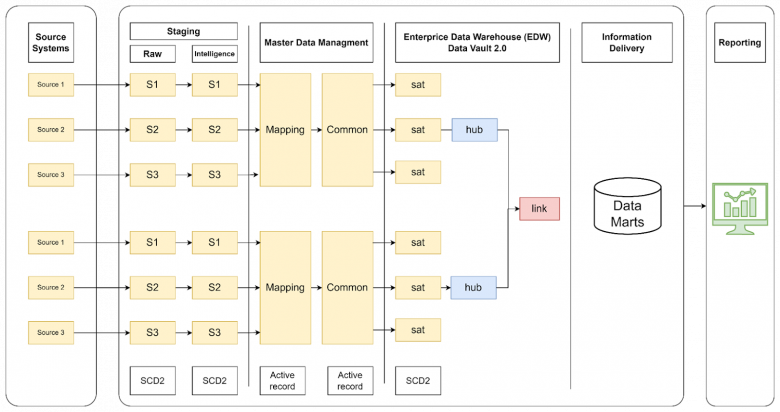
Верхнеуровневая схема хранилища
Прежде чем данные попадут в DWH, они проходят через несколько ключевых этапов обработки. Вначале jyb загружаются в Staging.Raw, где сохраняются в неизменном виде для упрощения последующих ETL-процессов. Далее на уровне Staging.Intelligence данные приводятся к единым названиям полей и формату. После этого происходит их консолидация в слое MDM, где они объединяются и связываются с эталонными записями. Только после этого информация попадает в Enterprise Data Warehouse (EDW), где она организовывается по принципам Data Vault.
Кому идеально подходит Data Vault 2.0?
Это, в первую очередь, крупные компании с десятками разнородных источников данных, финтех и банки, где требуется полный аудит и историчность всех данных, а также компании, работающие в Agile, где требования к данным меняются постоянно и предсказуемо. Кроме того, это рганизации с несколькими командами разработки, которые должны работать параллельно.
Кому точно не стоит его использовать?
Во – первых, это стартапы и небольшие проекты, Вам вполне хватит классической «звезды». Во-вторых, это проекты с устаревшей инфраструктурой. Если Ваша СУБД не поддерживает эффективные JOIN, вы не получите никаких преимуществ, только боль. И в – третьих, это команды без готовности инвестировать в обучение. Без внутренней экспертизы проект обречен.
Data Vault 2.0 — это мощнейший инструмент для построения гибкого, масштабируемого и надежного хранилища данных. Он идеально подходит для сложных, динамичных сред, где изменения — это норма.
Это не магия, а архитектура, которая требует правильной технологической базы (мощная MPP-СУБД), инвестиций в обучение команды, дисциплины и стандартов в проектировании, а также понимания, что это только слой хранения, и поверх него всё равно придется строить витрины.
Если вы чувствуете, что ваше текущее хранилище перестало справляться с темпами бизнеса, — давайте обсудим. Мы поможем оценить риски и преимущества, проведем пилот и поможем вашей команде освоить эту методологию. Давайте строить системы, которые работают на вас, а не вы на них.


