

Построение высокопроизводительного хранилища данных на Greenplum с применением методологии Data Vault 2.0: от архитектурных принципов до промышленной эксплуатации
В современном мире, где данные становятся ключевым активом бизнеса, построение масштабируемого, гибкого и производительного хранилища данных превращается из технической задачи в стратегическую необходимость. Наша компания, обладая многолетним опытом реализации сложных DWH-проектов, готова поделиться уникальным кейсом миграции с устаревшей инфраструктуры на PostgreSQL к современной платформе на базе Greenplum с полным циклом внедрения методологии Data Vault 2.0.
Изначальная инфраструктура проекта была построена на PostgreSQL — надежной SQL-СУБД, но не предназначенной для аналитических нагрузок большого объема. Архитектура включала два основных источника данных: кластер MongoDB для операционных данных бэкенда и внешние API-сервисы. Для обработки изменений данных использовался кастомный CDC-сервис на Node.js, который читал oplog MongoDB и применял изменения в слое сырых данных.
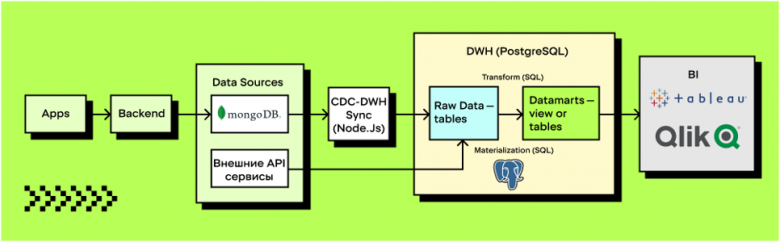
У данной архитектуры был ряд существенных недостатков:
- Невозможность горизонтального масштабирования сервера PostgreSQL
- Витрина-монолит весом более 150 Гб с 300+ атрибутами
- Отсутствие стандартизации в коде и процессах разработки
- Многочисленные дублирования метрик в различных витринах
- Экспоненциальный рост сложности оптимизации запросов
- Высокие операционные затраты на поддержку самописного CDC-решения
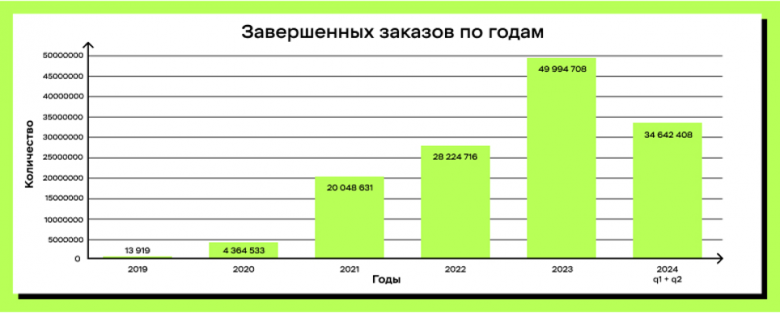
В итоге мы накопили довольно много данных ...

Кроме того, объемы данных показывали устойчивый рост: с 75,1 миллионов заказов в 2023 году до 54,4 миллионов только за первое полугодие 2024 года, что требовало принципиально нового подхода к архитектуре хранения и обработки данных.
Выбор целевой платформы: Greenplum как основа будущей архитектуры
После тщательного анализа рынка решений для аналитических нагрузок был выбран Greenplum —MPP СУБД с открытым исходным кодом, основанная на PostgreSQL. Критерии выбора включали бесплатность и открытость решения; легкую горизонтальную масштабируемость; поддержку колоночного хранения данных; ориентированность на аналитические нагрузки, а также наличие экспертизы в команде.
Хотя Greenplum и основан на устаревшей версии PostgreSQL 9.4 и имеет ограничения с OLTP-нагрузкой, его преимущества для аналитических сценариев использования оказались решающими.

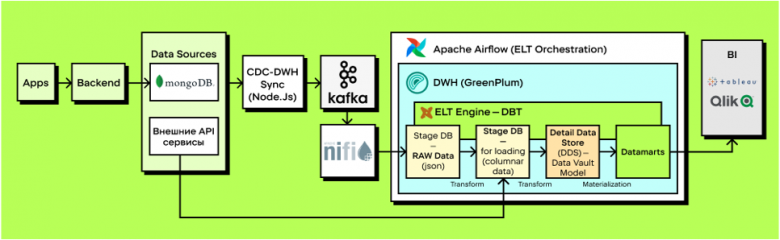
Новая архитектура представляет собой многослойную систему. В качестве слоя источников данных мы выбрали MongoDB кластер (10 инстансов) и внешние API-сервисы. Затем мы создали CDC-слой - улучшенный кастомный сервис, читающий oplog MongoDB и отправляющий изменения в Kafka. Для буферизации мы выбрали Apache Kafka (для надежного хранения потоковых данных). Для переноса данных из Kafka в Greenplum мы выбрали Apache NiFi. Для хранения данных - Greenplum в конфигурации 16 сегментов на 4 сегмент-хостах, для трансформации данных - DBT с доработанным коннектором для Greenplum. В качестве оркестратора больше всего нам понравился Apache Airflow (для управления ETL-процессами), а в качестве модели хранения данных выбрали DataVault 2.0.
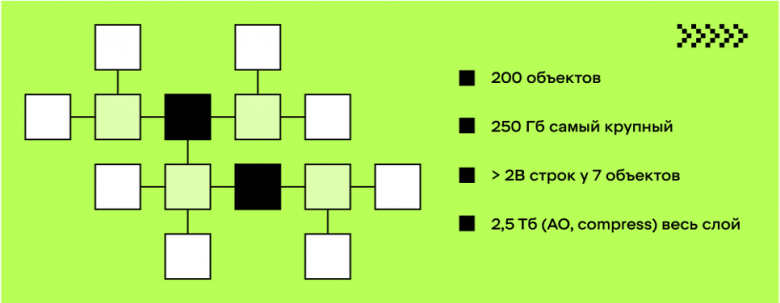
Главная часть нашего хранилища — его детальный слой. Сейчас DDS включает в себя:
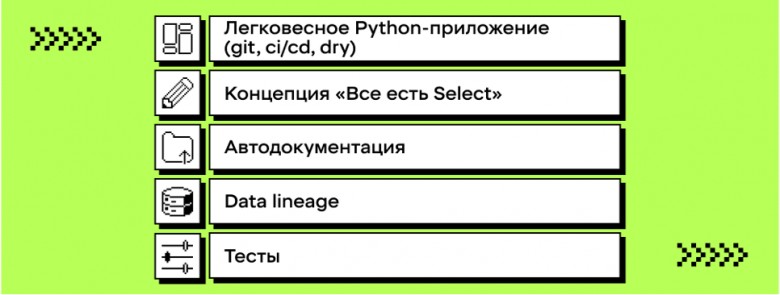
Сейчас в проде многие используют DBT. Можно сказать, что это трендовый элемент, но мы используем его не из-за его популярности, а потому что приложение легковесное, отлично подходит для CI/CD и полностью соответствует принципу DRY.
Это очень важно при методологии DataVault. DBT следует концепции «Всё есть SELECT» (все команды CREATE, INSERT, UPDATE, DELETE заменяются одним SELECT-запросом). При этом логика преобразований может быть многоуровневой, что освобождает инженеров от DDL-операций. + встроенная автодокументация с Web-сервером, Data Lineage и тесты, позволяющие сохранить ещё больше ресурсов для концентрации на моделировании и настройке ELT.
Поскольку нативный коннектор DBT для Greenplum отсутствовал, была проведена работа по интеграции с появившимся коннектором, доработке пакета DBT Vault для поддержки Greenplum, а также по адаптации синтаксиса хэширования и оконных функций. Кроме этого мы автоматизировали работу с кастомными скриптами.
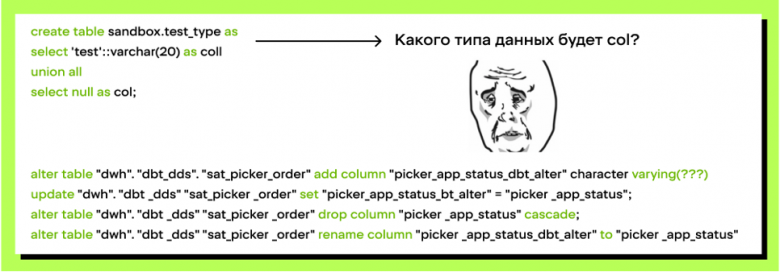
Функционал DBT expand_column_types оказался для нас удивительным и вредным. Он по умолчанию включен в DBT, и явно его отключить в нашей версии было невозможно (в итоге мы его выпилили).
Внедрение методологии Data Vault 2.0
Методология DV 2.0 была выбрана за ее гибкость и способность сохранять полную историю изменений. Как ее реализовали мы. Во-первых, мы использовали MD5 хэшей для построения ключей вместо последовательных идентификаторов. Далее мы организовали данные в хабы, линки и сателлиты. Помле этого мы реализовали механизм параллельной загрузки данных и обеспечили возможности джойнов с Data Lake.
Оптимизация производительности на каждом этапе ETL
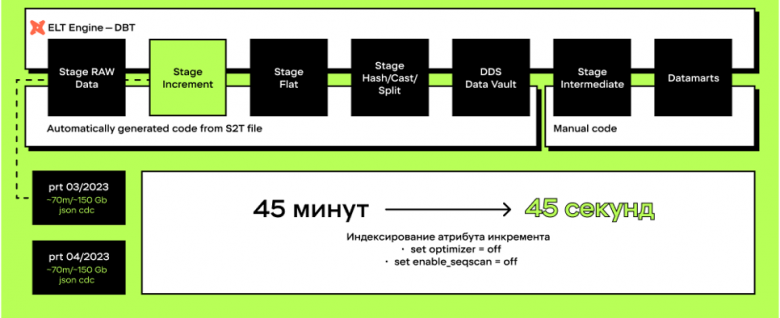
Этап 1: Взятие инкремента из сырых данных
Сырые данные хранились в партиционированных по месяцам таблицах, некоторые из которых достигали 150 Гб к концу месяца. Для оптимизации было введено дополнительное индексирование по атрибутам временных диапазонов, был принудительно отключен GPORCA и настроено последовательное сканирование. Время обработки в итоге было сокращено с 45+ минут до более приемлемых значений.
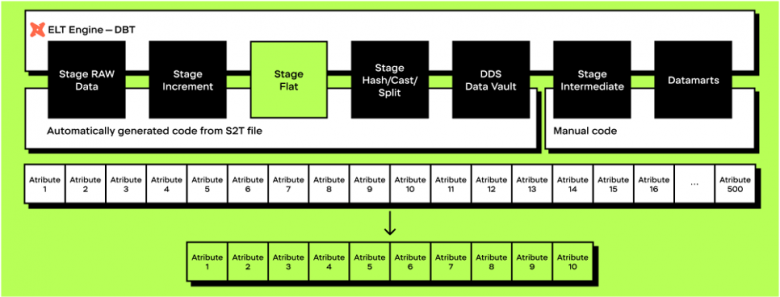
Этап 2: Раскладка неструктурированных данных
Для обработки MongoDB-документов с 500+ атрибутами мы реализовали самописный скрипт для анализа сырых данных на предмет новых атрибутов, сервисную таблицу маппинга атрибутов в плоский вид, а также механизм почасового обновления метаданных о структуре документов.
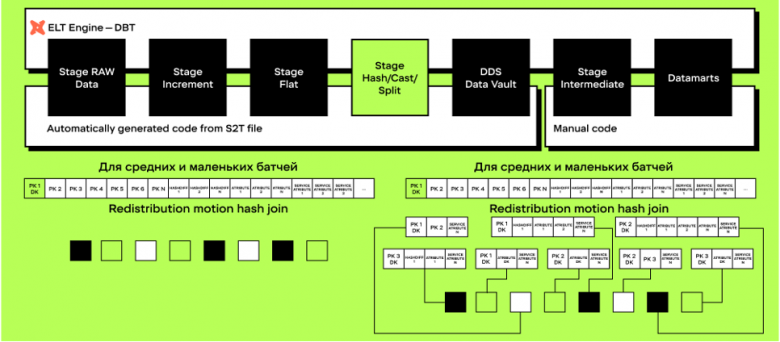
Этап 3: Подготовка финального стейджа
На этом этапе решались задачи хэширования атрибутов для PK и хэшдифов сателлитов, стандартизации именования атрибутов, приведения типов данных, а также оптимальной дистрибуции данных для последующих джойнов.
Этап 4: Вставка в DDS
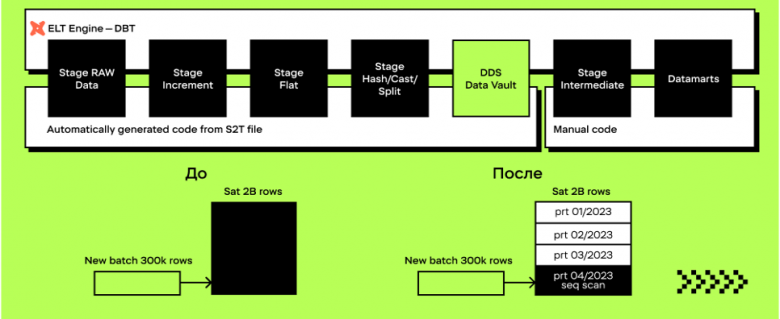
Для больших объектов Data Vault мы реализовали правильное секционирование для минимизации сканируемых данных, механизм обработки релевантных партиций, а также защиту от дублирования данных при пересечении ключей между партициями.
Этап 5: Сбор витрин
Критически важный этап с точки зрения бизнес-ценности.
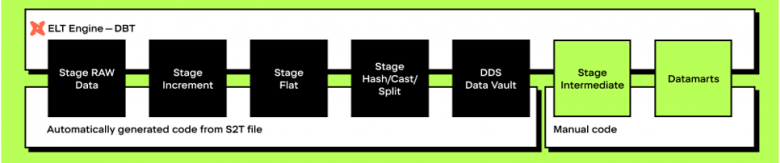
Мы спроектировали промежуточных intermediate-таблицы, оптимизировали дистрибуции для локальных джойнов, реализовали механизмы полного и инкрементального пересчета, а также обеспечили консистентность и воспроизводимость исторических данных.
Организация процессов разработки и поставки кода
Для коллективной работы над объектами Greenplum мы реализовали двухуровневую систему: управление через Liquibase (создание схем, служебных объектов, настройка прав с автоматизированным процессом тестирования и наката изменений), а также управление через DBT (полный контроль над объектами в выделенных схемах с автоматизированной сборкой и деплоем через Docker-образы).
Процесс запуска расчетов организован через ssh-оператор Airflow, который через единый entrypoint запускает различные функционалы проекта. Одноразовые контейнеры обеспечивают изоляцию версий и предсказуемость выполнения задач.
Для сложных DDL-изменений и кастомных пересчетов реализован модуль миграций на Python, интегрированный в DBT-проект и запускаемый через отдельный ручной DAG.
Система мониторинга и алертинга
Для предотвращения инцидентов и оперативного реагирования мы внедрили многоуровневую систему мониторинга каждого этапа ETL, включающую в себя мониторинг чтения данных из oplog и отправки в Kafka, контроль лага вычитки из топиков, наблюдение за обработкой сообщений в NiFi, мониторинг вставки данных в Greenplum, отслеживание результатов работы DBT и его тестов, а также контроль выполнения Airflow DAG и времени обработки задач.
Система алертинга была настроена с учетом приоритетности уведомлений для исключения эффекта "замыливания глаза" на важные события.
Внедрение новой архитектуры позволило достичь значительных улучшений. Мы ускорили процесс разработки витрин данных в 3-5 раз (!). У нас наконец-то появилась возможность подключения аналитиков к разработке моделей данных и мы сократили потребность в дата-инженерах для поддержки платформы. Кроме того, мы устранили ряд узких мест в доставке данных, ликвидировали дублирование метрик и обеспечение консистентности, а также реализовали инкрементальное обновление витрин. У нас появилась возможность бесшовного масштабирования сервера БД, сохранения полной истории изменений данных, а также создания основы для перехода к архитектуре Data Mesh.
Однако, несмотря на значительные улучшения, все же остаются области для дальнейшей оптимизации. Это в первую очередь касается управления огромным объемом данных в сыром слое, оптимизации распределения ресурсов между многочисленными пользователями, а также управления растущим количеством объектов в БД
Планы по развитию примерно следующие:
- Внедрение механизма охлаждения исторических данных в S3
- Добавление ClickHouse для обслуживания многочисленных читающих пользователей
- Расширение перечня источников данных
- Дальнейшая автоматизация процессов управления инфраструктурой
Реализация хранилища данных на Greenplum с применением методологии Data Vault 2.0 показала свою эффективность для высоконагруженных аналитических систем. Представленное решение демонстрирует возможность построения масштабируемой, гибкой и производительной платформы для работы с большими объемами данных, способной адаптироваться к быстро меняющимся бизнес-требованиям.


