

MLOps: Стратегия выбора инструментов между Open Source и вендорскими решениями для успешного внедрения машинного обучения
В современном мире данных машинное обучение (ML) перестало быть просто областью экспериментов и превратилось в ключевой инструмент бизнеса. Однако путь от идеи до работающей в продакшене модели полон сложностей. Согласно исследованиям, до 87% Data Science проектов никогда не достигают производственной стадии. Основная причина — отсутствие эффективных процессов управления жизненным циклом ML-моделей. Именно здесь на помощь приходит MLOps — набор практик, объединяющий машинное обучение и DevOps для автоматизации, масштабирования и мониторинга ML-систем.
Мы прекрасно понимаем, что один из ключевых вопросов, стоящих перед любым техническим руководителем или ML-инженером — выбор технологического стека. На чем строить свою MLOps-инфраструктуру: на проверенных проприетарных решениях от крупных вендоров или на гибких инструментах с открытым исходным кодом (Open Source)? В этом подробном руководстве мы проведем глубокий анализ обоих подходов, рассмотрим конкретные инструменты, разберем реальные примеры, потенциальные риски и типичные ошибки при внедрении.
Суть MLOps и почему без него не обойтись
MLOps — это не просто модный термин, а жизненно важная дисциплина, которая формализует и автоматизирует все этапы работы с ML-моделями. Представьте себе типичный сценарий: Data Scientist месяцами экспериментирует в Jupyter Notebook, подбирая алгоритмы и фичи, и в итоге получает модель с выдающимися метриками на тестовых данных. Но это лишь 10% пути. Следующие 90% — это упаковка модели в воспроизводимый формат (Docker-контейнер), оркестрация и развертывание в кластере (Kubernetes), организация непрерывного обучения (CI/CD для ML), мониторинг работы модели в реальном времени, обнаружение дрейфа данных (Data Drift) и концептуального дрейфа (Concept Drift), а также управление версиями не только кода, но и данных, и самих моделей.
В одиночку с этими задачами не справиться. MLOps предоставляет инструменты и процессы, которые позволяют ускорить выведение моделей в продакшен в разы, повысить надежность и воспроизводимость ML-пайплайнов, снизить операционные риски и затраты на поддержку, а также автоматизировать рутинные задачи, позволяя Data Scientist’ам сосредоточиться на исследованиях.
Проприетарные решения vs Open Source: детальное сравнение
Выбор между этими двумя путями является стратегическим и зависит от множества факторов. Рассмотрим основные из них более подробно.
1. Качество кода и надежность
Проприетарные решения зачастую воспринимаются как более стабильные и отполированные. Вендор инвестирует в тестирование, обеспечение качества и предоставляет гарантированный SLA. Однако это не панацея. Код закрыт, и если вы столкнулись с критическим багом, который проявляется именно в вашем сценарии, вы не можете его исправить самостоятельно. Единственный выход — обращаться в поддержку и ждать следующего патча, который может выйти через недели или месяцы. Пример: ошибка в алгоритме автоматического масштабирования проприетарной платформы может привести простою инференса и прямым финансовым потерям, а вы останетесь один на один с проблемой.
Исходный же код открыт для аудитории тысяч разработчиков. Это означает, что баги и уязвимости обнаруживаются и фиксятся сообществом крайне быстро. Качество кода в популярных проектах (Kubeflow, MLflow) очень высокое. Рисковая зона - качество нишевых или молодых OS-проектов может быть неравномерным. Главная ошибка - слепое доверие к любому OS-инструменту без предварительного аудита кода и проверки активности его сообщества.
2. Универсальность и применимость
Проприетарные решения следуют принципу «все в одном». Вам предлагается готовая экосистема, где все компоненты идеально (в теории) интегрированы друг с другом. Это быстро и удобно на старте. Однако здесь кроется главная ловушка — vendor Lock-in. Ваши данные, пайплайны и модели оказываются запертыми внутри экосистемы вендора. Миграция на другую платформу в будущем может оказаться не просто сложной, а практически невозможной и астрономически дорогой. Пример: построив все процессы на платформе «X», вы оказываетесь в заложниках у ее ценовой политики и технологической дорожной карты.
Open Source решения основаны на открытых стандартах и практиках. Навык работы с Kubernetes, Airflow или MLflow является универсальным и высоко ценится на рынке. Это упрощает найм специалистов и дает свободу выбора. Если один инструмент перестает развиваться, вы всегда можете заменить его на аналог, не перестраивая всю архитектуру с нуля. Главная ошибка в данном случае – это неверная оценка трудозатрат на интеграцию разрозненных OS-инструментов в единую слаженную систему.
3. Модульность и гибкость
Проприетарные решения часто представляют собой монолит. Вы получаете весь набор функций, даже те, которые вам не нужны. Это может приводить к избыточному потреблению ресурсов и сложностям кастомизации. Если вам нужна нестандартная функция, вы должны убеждать вендора ее реализовать.
Open-source решения – это своего рода конструктор «Лего». Вы можете собрать идеальную платформу, взяв лучшие инструменты для каждой задачи: MLflow для трекинга экспериментов, Seldon Core для деплоя, Feast для управления фичами. Это дает невероятную гибкость. Риск в данном случае состоит в том, что такой подход требует глубокой экспертизы и ресурсов на сборку и поддержку этого «конструктора». Приведем пример наиболее распространенной ошибки -команда начинает одновременно внедрять 5 разных OS-инструментов без четкого плана их интеграции, что приводит к хаосу и росту технического долга.
4. Стабильность и обновления
В случае проприетарных решений обновления контролируются вендором. Они могут быть редкими, но зато тщательно протестированными. Обратная сторона — вы не контролируете процесс. Новое обновление может сломать обратную совместимость, а откатиться на стабильную версию часто невозможно.
В случае open source вы сами решаете, когда и какое обновление применять. Сообщества популярных проектов выпускают обновления и патчи очень быстро. Основной риск в данном случае состоит в отсутствии выделенного ресурса на своевременное обновление компонентов может привести к отставанию от актуальных версий и накоплению неисправленных уязвимостей.
Проанализировав все выше сказанное, можно прийти к следующему выводу.
Проприетарное решение – наиболее оптимальный вариант в том случае, если:
- у вас нет сильной экспертной команды DevOps/MLOps инженеров;
- скорость выхода на рынок (Time-to-Market) критически важна, и вы готовы заплатить за готовое решение;
- бюджет позволяет покрывать постоянные лицензионные расходы и вы цените возможность официальной поддержки;
- Вы работаете в строго регулируемых индустриях, где требуется сертифицированное ПО.
Open Source больше всего подходит в том случае, если:
- вы хотите избежать ловушки Vendor Lock-in и сохранить полный контроль над своей архитектурой.
- в вашей команде есть эксперты, готовые кастомизировать и поддерживать инфраструктуру.
- вам критически важна гибкость и возможность адаптировать инструмент под уникальные бизнес-процессы.
- вы хотите быть на острие технологий и быстро получать доступ к новейшим функциям.
Обзор ключевых Open-Source-инструментов MLOps
Рассмотрим подробнее пять столпов современного OS MLOps-стека.
- Kubeflow: мощный, но сложный комплекс
Kubeflow — это целая экосистема, предназначенная для развертывания, оркестрации и управления end-to-end ML-пайплайнами на Kubernetes. Она предоставляет готовые компоненты для всего цикла: Kubeflow Pipelines для оркестрации, KFServing для инференса, Katib для подбора гиперпараметров, централизованный UI.
Примечание:
KFServing — это проект с открытым исходным кодом, который позже был переименован и переработан в KServe. Это высокопроизводительный, универсальный и стандартизированный способ обслуживания (serving) моделей машинного обучения в Kubernetes. Его главная цель — абстрагировать всю сложность развертывания моделей за простым и мощным API.
Представьте, что у вас есть обученная модель (например, в формате .pb для TensorFlow, .pt для PyTorch или model.pkl для Scikit-learn). Чтобы она приносила пользу, нужно:
- Обернуть ее в HTTP-сервер (REST/gRPC API).
- Упаковать в Docker-контейнер.
- Развернуть в Kubernetes (создать Deployment, Service, Ingress).
- Настроить автомасштабирование (чтобы справляться с нагрузкой).
- Организовать A/B-тестирование между разными версиями модели.
- Настроить мониторинг и логирование.
KServe делает все это автоматически на основе одного конфигурационного файла (YAML).
Katib — это система для автоматического подбора гиперпараметров (Hyperparameter Tuning - HPO) и поиска нейронных архитектур (NAS), не зависящая от фреймворка. Если упростить, Katib — это "умный робот", который методом проб и ошибок ищет лучшие настройки для вашей модели, чтобы добиться максимальной точности.
Вместо того чтобы вручную запускать сотни экспериментов, меняя learning rate, количество слоев или размер батча, вы описываете пространство для поиска, а Katib делает это за вас, используя распределенные вычисления.
Вместе KServe и Katib образуют мощный дуэт в рамках платформы Kubeflow:
- Katib помогает вам найти и обучить наилучшую возможную версию модели.
- KServe помогает вам развернуть эту модель в продакшене самым эффективным, масштабируемым и управляемым способом.
Это идеальное воплощение принципов MLOps: автоматизация и оптимизация всего жизненного цикла модели — от экспериментирования и тюнинга до промышленного обслуживания.
Основные преимущества Kuberflow состоят в нативной интеграции с Kubernetes, мощных возможностях масштабирования, а также в поддержке множества фреймворков.
К основным сложностям внедрения в первую очередь стоит отнести установку и конфигурацию Kubeflow — задачу для опытных Kubernetes-инженеров. Неверная настройка может привести к нестабильной работе всего кластера. Еще один важный момент - нехватка документации. Сообщество часто жалуется на недостаток качественных руководств. Внедрение может превратиться в самый настоящий метод проб и ошибок. Помимо всего прочего важна и избыточность: большинство пользователей применяют лишь 20% возможностей Kubeflow. Частая ошибка — пытаться внедрить его целиком для простой задачи, что создает ненужную сложность.
Идеальный сценарий в данном случае, это крупные компании с мощной инженерной командой, которые строят стандартизированную, корпоративную ML-платформу для множества разрозненных команд Data Scientists.
2. MLflow: лидер управления жизненным циклом
MLflow — это библиотека с очень низким порогом входа, которая решает ключевую проблему — воспроизводимость экспериментов. Она решает такие задачи, как трекинг параметров, метрик и артефактов (MLflow Tracking), упаковка и деплой моделей (MLflow Models), управление моделями в продакшене (Model Registry).
К ее основным преимуществам в первую очередь стоит отнести простоту использования, поддержку всех популярных ML-фреймворков и легкую интеграцию в существующий код.
Теперь рассмотрим ключевые риски и сложности, связанные с данным продуктом. В первую очередь данная библиотека не является полноценной платформой. MLflow не оркестрирует пайплайны и не занимается развертыванием в продакшен «из коробки». Его нужно интегрировать с другими инструментами (например, с Airflow для оркестрации и Kubernetes для деплоя). Также нельзя не сказать и о проблемах масштабирования. Стандартный сервер трекинга MLflow может не справиться с нагрузкой от большой команды и миллионов экспериментов. Требуется перенос бэкенда в масштабируемое хранилище (например, в базу данных PostgreSQL).
Идеальный сценарий - правильная отправная точка для внедрения MLOps в любой компании, от стартапа до крупного предприятия. Отлично подходит для трекинга экспериментов и управления моделями.
3. Pachyderm: версионирование данных на промышленном уровне
Pachyderm решает фундаментальную проблему MLOps — контроль версий для данных так же, как Git делает это для кода. Занимается решением таких задач, как сквозное версионирование данных и пайплайнов, автоматическая дедупликация (хранятся только изменения, а не полные копии датасетов) и data-driven триггеры (пайплайн запускается автоматически при поступлении новых данных).
Говоря о преимуществах данного продукта в первую очередь стоит выделить обеспечение полной воспроизводимости любого эксперимента в любой момент времени, что критически важно для аудита и compliance.
Среди рисков и ошибок внедрения в первую очередь стоит выделить высокий порог входа (требует глубокого понимания не только самого Pachyderm, но и Kubernetes), сложность миграции (перенос существующих ETL/ELT-пайплайнов в парадигму Pachyderm — это большой и дорогой проект), а также операционные затраты. Требует выделенного администратора для поддержки.
Идеальный сценарий - организации, работающие с огромными объемами данных (Петабайты), где воспроизводимость и отслеживаемость каждого изменения являются обязательными требованиями (например, финтех, здравоохранение).
4. Seldon Core: стандарт де-факто для продакшен-инференса
Seldon Core специализируется на одной из самых сложных задач — преобразовании обученной модели в высокодоступный, масштабируемый микросервис. Решает такие задачи, как деплой моделей в Kubernetes в виде REST/gRPC API, продвинутые стратегии выкатки (A/B-тестирование, канареечный rollout), мониторинг, объяснимость (Explainability), а также обнаружение дрейфа.
К преимуществам данного продукта в первую очередь стоит отнести производственную надежность, богатый функционал и тесную интеграцию с Kubeflow и MLflow. Помимо всего прочего здесь также предусмотрена интеграция с инструментами для обнаружения дрейфа данных и выявления выбросов в них (Outlier, Adversarial и Drift Detection).
Примечание:
Outlier Detection — это процесс идентификации входных данных (запросов к модели), которые значительно отличаются от данных, на которых модель обучалась. Это не просто шум, а точки, которые лежат так далеко от общего распределения, что модель оказывается в неопределенной ситуации и ее предсказания становятся ненадежными.
Почему это важно?
Модель, никогда не видевшая подобных данных, будет делать предсказание с низкой уверенностью или просто "гадать". Это может привести к ошибочным бизнес-решениям.Кроме того, очень часто встречаются и ошибки в самих данных - аномалии часто свидетельствуют о сбоях в upstream-системах (например, логгер пишет -999 вместо реального значения, API-партнер начал присылать данные в новой, непредвиденной единице измерения). И, наконец, безопасность - может быть индикатором злонамеренной активности.
Adversarial Detection — это выявление специально сконструированных входных данных, цель которых — обмануть модель, заставив ее сделать неправильное предсказание. Эти данные выглядят для человека практически идентично нормальным, но содержат незаметные для глаза возмущения (perturbations), которые кардинально меняют вывод модели.
Почему это критически важно?
Во-первых, с точки зрения безопасности: атаки — прямая угроза для систем безопасности (обход Face ID, обход анти-спам фильтров), беспилотных автомобилей (изменение знака "стоп" на "ограничение скорости 80"), и т.д. Во-вторых, с точки зрения надежности - ставит под сомнение возможность развертывания ML в ответственных сферах.
Пример (знаменитая атака на классификатор изображений): На картинку панды добавляется небольшой, незаметный для человека шум. Модель, которая с высокой уверенностью определяла панду, после этого с еще большей уверенностью классифицирует ее как гиббона.
Дрейф — это самое частое явление в продакшене ML. Это общее название для ситуаций, когда связь между входными данными и целевой переменной меняется со временем, что приводит к degradation производительности модели.
Существует два основных типа дрейфа:
-
Data Drift (Ковариатный дрейф / Drift в данных): изменение распределения входных данных
P(X). Модель продолжает работать, но мир вокруг нее изменился. Качество данных на inference отличается от качества данных при обучении. Обнаруживается с помощью статистических тестов (сравнение распределения каждого признака (и их совместных распределений) между обучающей выборкой и данными в продакшене), а также с помощью моделей-детекторов (обучение классификатора отличать обучающие данные от продакшенных. Если он отличает их слишком хорошо — есть дрейф). -
Concept Drift (Дрейф концепции): изменение связи между входными данными и целевой переменной
P(Y|X). Сами данные могут оставаться прежними, но их смысл и то, что они предсказывают, изменилось. Обнаруживается с помощью мониторинга метрик (самый прямой способ — падение операционных метрик (Accuracy, Precision, Recall, F1-score, AUC-ROC), а также с помощью мониторинга "сигналов прокси".
Такие инструменты, как Seldon Core, Evidently AI, Arize AI, Fiddler AI, WhyLabs, имеют встроенные возможности для мониторинга всех трех типов проблем.
Главная цель — не просто обнаружить проблему, а закрыть петлю MLOps:
Обнаружение -> Оповещение -> Анализ -> Переобучение / Переразвертывание -> Валидация.
Внедрение этого цикла превращает вашу ML-систему из статичного артефакта в живой, адаптирующийся и надежный механизм, который постоянно сохраняет свою ценность для бизнеса.
Вкратце end-to-end-схему работы с Seldon Core можно описать следующим образом:
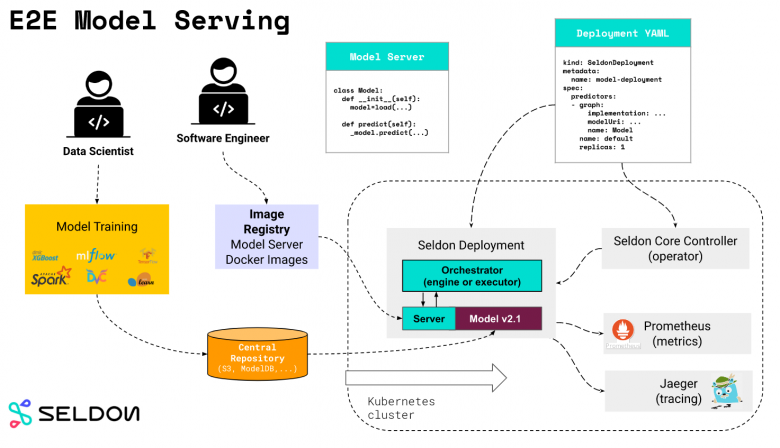
Перейдем к рискам. Во-первых, Seldon Core не решает задач всего цикла. Это инструмент specifically для деплоя, а не для трекинга экспериментов или подготовки данных. Во-вторых, он предполагает понимание Kubernetes. Без этого невозможно корректно сконфигурировать ресурсы, сети и политики безопасности.
Идеальный сценарий - любая команда, которая использует Kubernetes и хочет быстро и надежно выводить модели в продакшен с расширенными возможностями управления трафиком.
5. Metaflow: упрощение жизни Data Scientist`ов
Разработанный в Netflix, Metaflow абстрагирует сложности инфраструктуры, позволяя Data Scientist’ам описывать пайплайны как простой Python-код. Задачи, которые решает данный инструмент: оркестрация workflows, управление зависимостями, версионирование кода и данных, прозрачная работа с облачными ресурсами.
Главное его преимущество – это низкий порог входа для Data Scientists, который идеально подходит для команд, которые хотят самостоятельно запускать пайплайны без глубокого погружения в Kubernetes.
По сути, Metaflow- это так называемая «прослойки» между Data Scientist и Kubernetes.
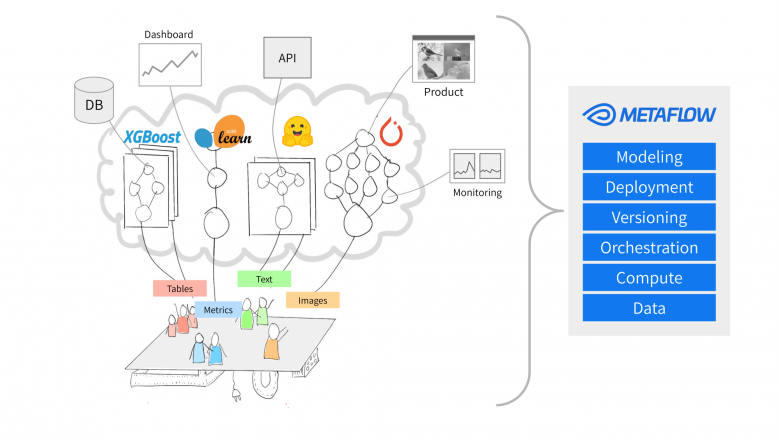
Риски и ошибки внедрения. Во-первых, это еще один инструмент в стеке. Если у вас уже настроены Airflow или Kubeflow Pipelines, его внедрение может создать избыточность. Во-вторых, это экосистема. Наибольшую выгоду от Metaflow можно извлечь при использовании всего стека от Netflix (включая собственное хранилище данных), что не всегда возможно.
Идеальный сценарий - команды Data Scientists, которые хотят самостоятельно управлять своими пайплайнами от исследования до продакшена, не полагаясь на помощь ML-инженеров на каждом шагу.
Как избежать наиболее распространенных ошибок и получить максимум от Open Source MLOps
Работа с OS-инструментами — это не только свобода, но и ответственность. К основным издержкам в первую очередь стоит отнести затраты на интеграцию (самостоятельное соединение разрозненных инструментов в единое целое), операционную поддержку (обновления, безопасность, мониторинг здоровья самих MLOps-инструментов ложатся на ваших инженеров), а также время (значительное увеличение Time-to-Market на этапе построения платформы).
Как правильно нивелировать все эти риски?
Во-первых, начните с малого. Не пытайтесь внедрить весь стек сразу. Начните с MLflow для трекинга экспериментов. Затем добавьте Seldon Core для деплоя. Постепенно наращивайте сложность.
Во-вторых, обязательно инвестируйте в экспертизу. Или наймите MLOps-инженеров, или обучите своих. Без этого любое внедрение обречено на провал.
В – третьих, обязательно рассмотрите managed-сервисы. Используйте облачные предварительно настроенные версии OS-инструментов.


