

Развертывание кластера Doris: локально, на серверах и в облаке
Apache Doris — распределенная колоночная система хранения и обработки данных, предназначенная для аналитических нагрузок в режиме онлайн-аналитической обработки (OLAP). Она сочетает в себе принципы переработки больших данных в масштабе кластера и простоту использования: поддерживает SQL, JDBC/ODBC интерфейсы, конвейеры инжестирования данных и высокую производительность при больших объемах. В рамках данного курса мы расставим акценты на практических аспектах развёртывания кластера Doris: как сделать локальную тестовую сборку, как масштабировать на продакшн‑серверах и как размещать Doris в облаке с учётом типичных кейсов и требований к задержкам, доступности и соответствию требованиям локализации данных. Материал рассчитан на нового сотрудника: мы разобрать теорию, термины, методологии, а также дадим конкретные примеры и рекомендации по настройке и эксплуатации.
Архитектура Doris
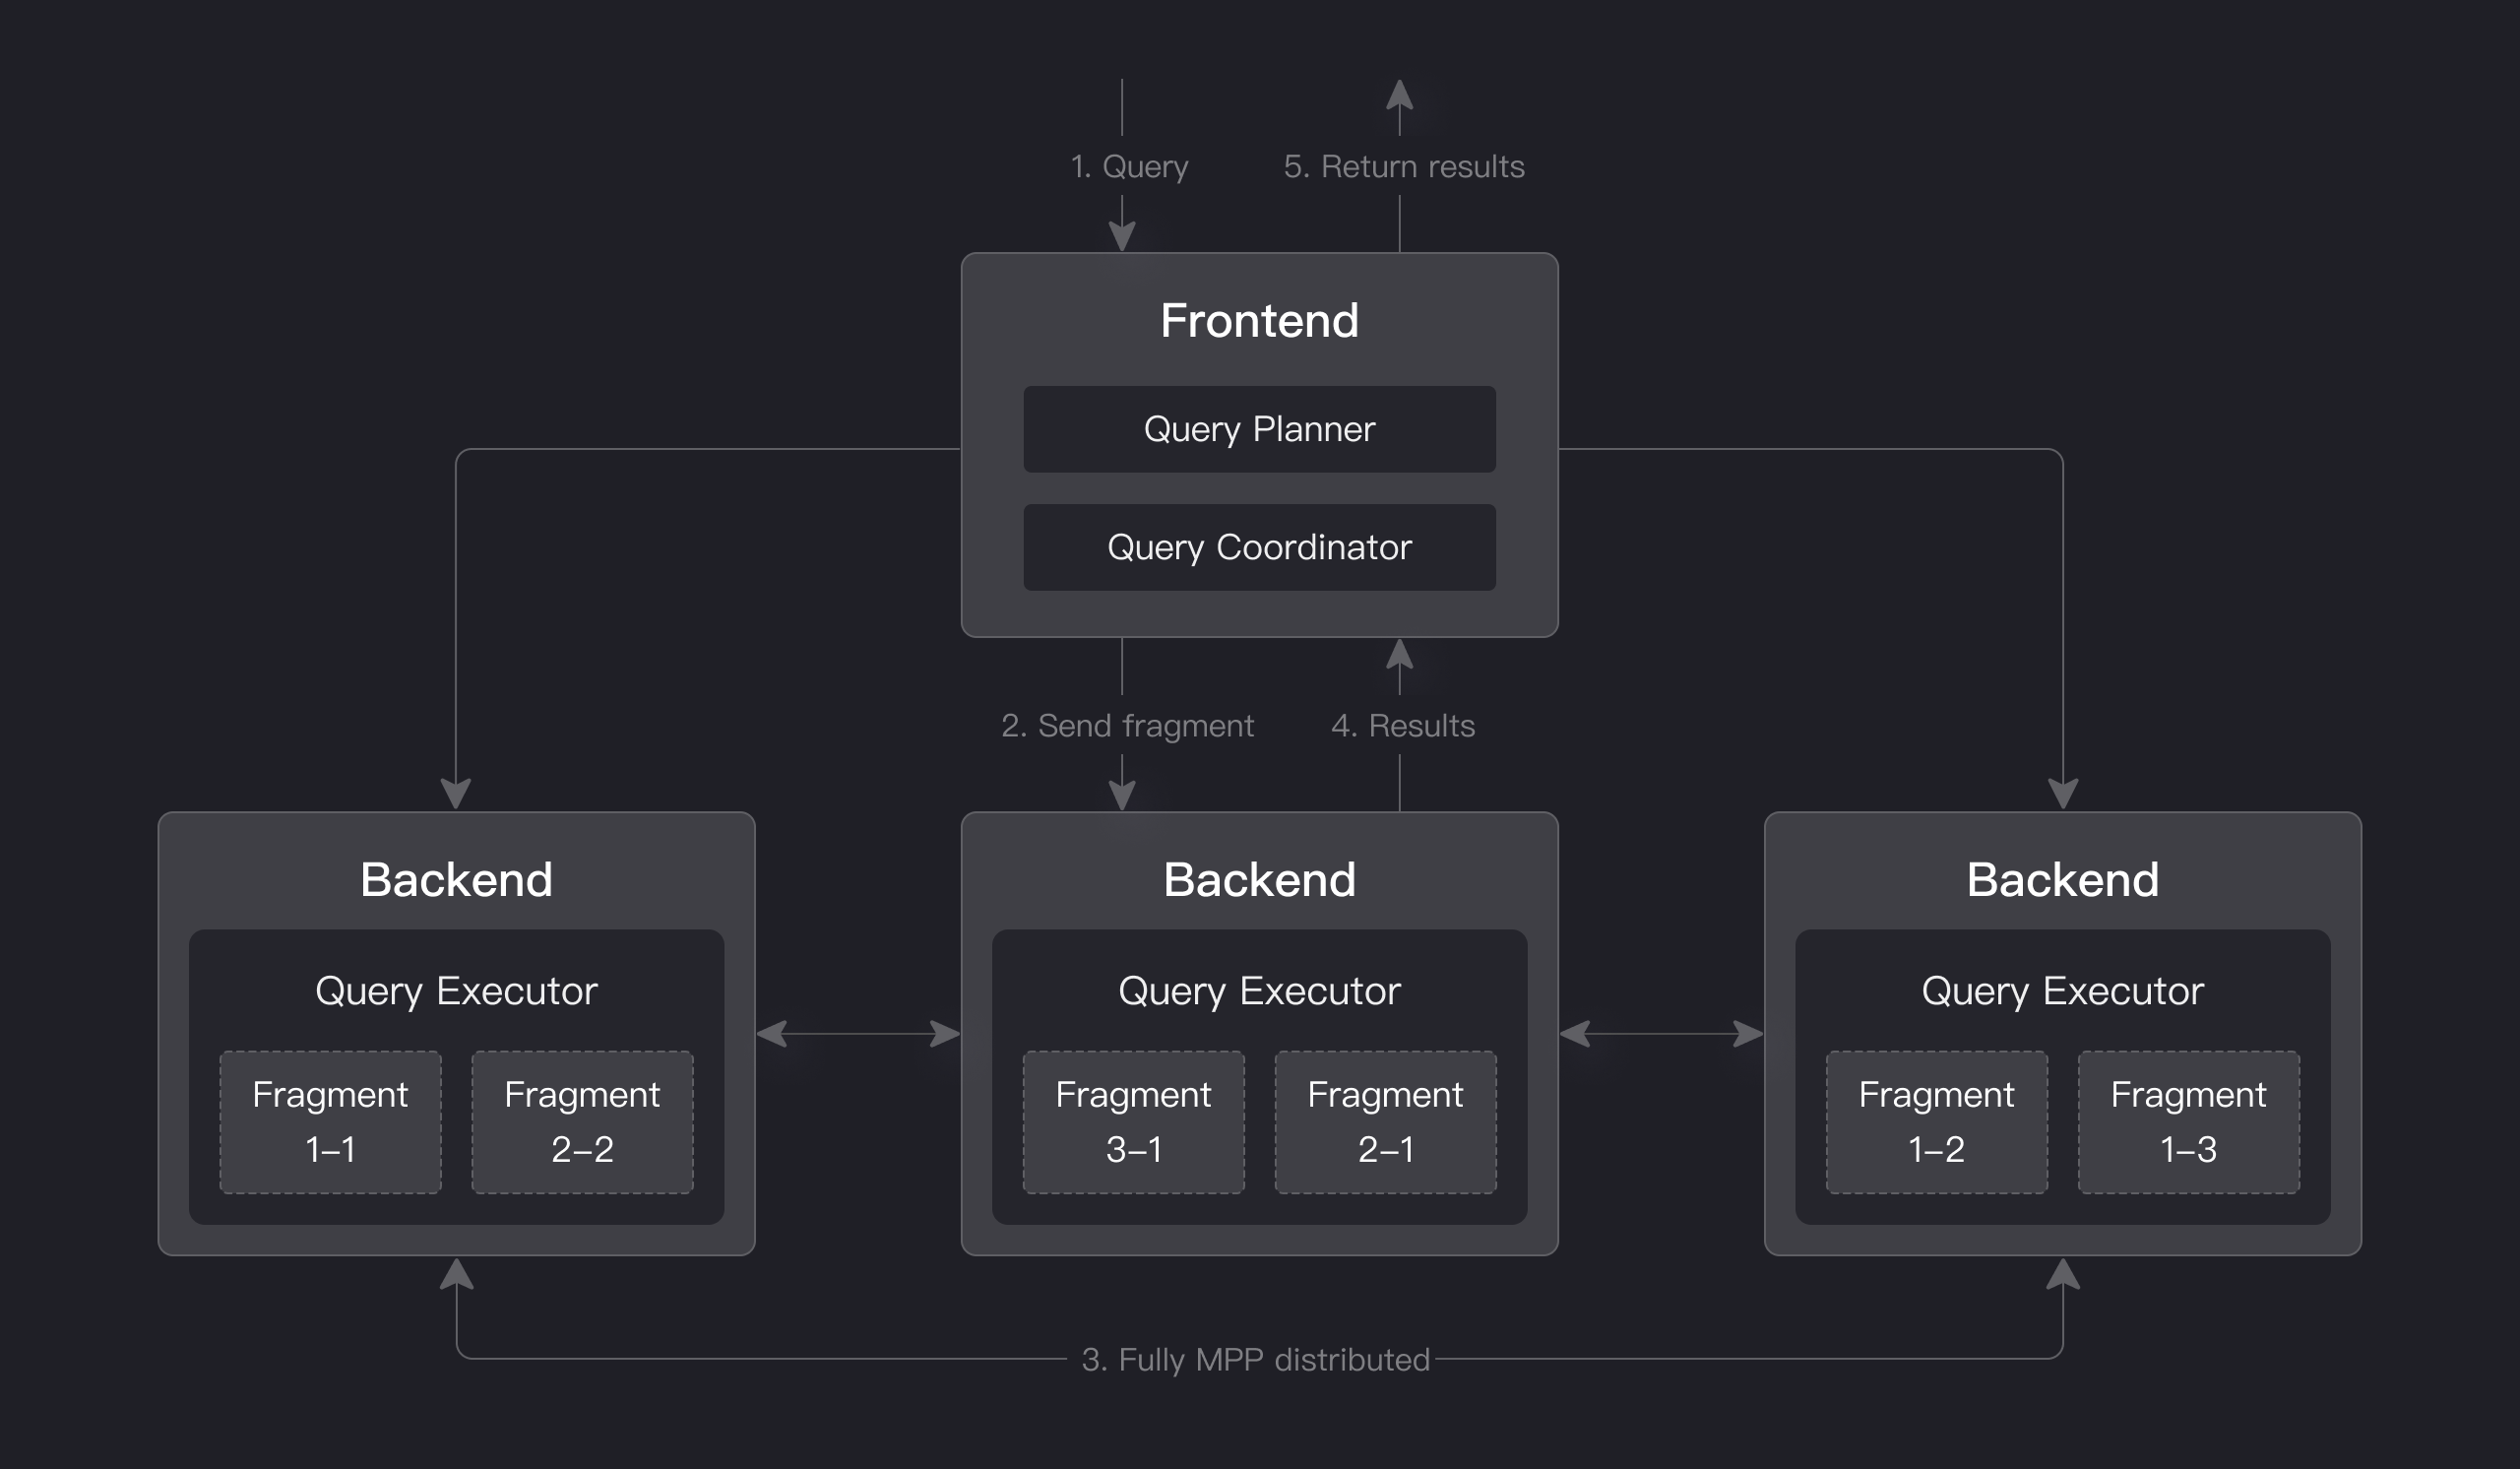
Основная идея Doris состоит в реализации распределённого хранилища и вычислений, работающего по многодоменной архитектуре. Кластера Doris состоят из двух основных типов узлов: FE (Frontend) и BE (Backend). FE управляет метаданными, схемами, правами пользователей, планированием выполнения запросов и координацией выполнения. BE хранит данные и выполняет вычисления, связанные с чтением и агрегациями. Совокупность FE и BE образует кластер Doris.
Ключевые концепции:
- Таблицы и данные. Таблицы Doris распределяются по узлам BE. Данные хранятся в колоночном формате на уровне BE, что обеспечивает высокую сжимаемость и эффективную реализацию агрегаций и фильтраций.
- Репликация и отказоустойчивость. Doris поддерживает репликацию данных на несколько BE‑узлов. Это позволяет выдерживать выход узла из строя без потери доступности.
- Распределение данных. В Doris можно задавать стратегию распределения данных по узлам BE через ключи распределения (distribution keys), что влияет на планирование запросов и балансировку нагрузки.
- Ингестирование и загрузка данных. Doris поддерживает различные механизмы загрузки: прямой импорт из файлов, потоковая подача, источники через брокеры (broker) с чтением из HDFS, S3‑совместимых хранилищ, локальных файлов и др.
- Каталог и метаданные. FE хранит каталог объектов, схемы баз и таблиц, метаданные о правах доступа, схемах распределения и прочем. BE хранит сами данные и соответствующие индексы вариацией.
- Мониторинг и эксплуатация. Doris предоставляет веб‑интерфейсы FE и BE для мониторинга состояния кластера, запросов, загрузок данных и использования ресурсов. В производственных условиях мониторинг обычно дополняется внешними системами: Prometheus, Grafana, ELK/EFK‑пулы и т. п.
Преимущества и ограничения
- Преимущества Doris: поддержка SQL‑запросов, горизонтальное масштабирование, эффективное выполнение аналитических запросов на больших данных, поддержка параллельной загрузки данных, гибкая стратегия хранения и возможность работы в реальном времени и с пакетной загрузкой.
- Возможные ограничения: сложность настройки и обслуживания в зависимости от масштаба; потребность в продвинутой настройке параметров памяти и CPU; управление инфраструктурой для обеспечения высокой доступности; ответственность за резервное копирование и восстановление; потенциал ограничений по конкретным типам нагрузок (например, смена паттернов запросов может потребовать перестройки распределения).
Типовой цикл развёртывания
Цикл развёртывания Doris обычно включает: проектирование архитектуры кластера (сколько FE и BE узлов, в каких зонах доступности и сетевом сегменте), подготовку инфраструктуры, развёртывание бинарников или Docker‑образов, настройку конфигурационных файлов, запуск и первичную загрузку тестовых данных, настройку мониторинга и резервного копирования, верификацию работы с реальными запросами и нагрузкой. В продвинутых сценариях добавляются CI/CD конвейеры для деплоя изменений, автоматическое масштабирование и обновления без простоя.
Безопасность и соответствие требованиям
Doris поддерживает аутентификацию пользователей, роли и права доступа, конфигурацию TLS‑шифрования для сетевого трафика FE/BE и клиентов, а также хранение конфигурационных данных и логов. В реальных проектах особое внимание уделяется локализации данных (data residency), защиты доступа к данным через VPN/периметр, журналированию действий пользователей, а также соответствию требованиям регуляторов (например, для России — требования к локализации и хранению данных в отечественных дата‑центрах при определённых условиях контракта и законодательства).
Практические примеры
Локальная разработка: один узел
Цель: понять концепцию работы Doris, проверить загрузку данных и выставить минимальные показатели производительности без необходимости развёртывания сложного кластера.
Что потребуется:
- одна машина с достаточными ресурсами для FE и BE (например, 4–8 ядер CPU, 16–32 ГБ оперативной памяти, диск SSD).
- Docker или tarball для быстрого развёртывания.
- небольшой набор тестовых данных (например, данные формата CSV/Parquet).
Пошаговый сценарий:
- Установка и запуск. Используйте официальный образ Doris или tarball. Запускаем FE и BE на локальной машине.
- Создание базы и таблицы. Выполняем создание базы, таблицы и базовых индексов, выбираем стратегию распределения, например HASH на столбцах-ключах, подходящую под ваши данные.
- Загрузка данных. Подключаем локальные файлы или используем брокер для загрузки из локального FS. Пример команды LOAD LABEL с указанием путей к данным и формата CSV.
- Выполнение тестового запроса. Отправляем простые SELECT‑запросы, смотрим план выполнения, задержки и конвергенцию выполнения.
- Мониторинг. Проверяем загрузку CPU, I/O и потребление памяти FE и BE через веб‑интерфейс Doris, а при необходимости подключаем Prometheus/Grafana для более детального мониторинга.
Плюсы и ограничения локального варианта: простота прототипирования, быстрое освоение CLI и SQL, отсутствие сетевых задержек. Минусы: ограниченная производительность и отсутствие высокой доступности.
Развёртывание на нескольких серверах (обычное продакшн‑развертывание)
Цель: обеспечить устойчивую работу кластера Doris в условиях реальногоproduction‑окружения: несколько FE и BE узлов, распределение нагрузки, отказоустойчивость.
Что потребуется:
- 2–3 FE‑узла для отказоустойчивости и централизованного управления.
- 3–6 BE‑узлов или больше в зависимости от объема данных и требуемой скорости обработки.
- Отдельное хранилище для данных BE (SSD/NVMe), сетевое соединение с низкой задержкой между узлами.
- Базовый набор инструментов мониторинга (Prometheus, Grafana), возможно инструменты резервного копирования.
Пошаговый сценарий:
- Подготовка инфраструктуры. Настраиваем сетевые правила, DNS‑имя кластера, запас по времени simple maintenance windows. Разделяем роли FE и BE на отдельных серверах или группах виртуальных машин.
- Установка Doris. Разворачиваем бинарники/образ Doris на всех узлах. Указываем параметры конфигурации: cluster name, IP‑адреса FE, портов, пути к данным BE, параметры JVM/нашивки памяти. В конфигурационных файлах явно прописываем IP FE на BE, чтобы BE знал, где находится FE.
- Конфигурация кластера. Добавляем FE и BE в кластер с помощью соответствующих команд или скриптов. Проверяем, что все узлы видят друг друга и FE координирует планирование запросов.
- Ингестирование и загрузка данных. Настраиваем брокеры (S3/HDFS/local) и запускаем загрузку больших массивов данных. Важно проверить параллелизм загрузки и ограничения по полосе.
- Тестирование отказоустойчивости. Эмулируем выход BE‑узлов из строя и восстанавливаем их, проверяем, что запросы продолжают обслуживаться FE и что данные остаются консистентными.
- Мониторинг и оптимизация. Собираем метрики, настраиваем алерты на задержки, использование памяти и заполнение дисков. При необходимости регулируем параллелизм, параметры памяти JVM, размер буферов.
Плюсы и ограничения: высокий уровень отказоустойчивости и производительности в реальных нагрузках, возможность горизонтального масштабирования, но сложность эксплуатации и больше точек конфликта при неправильной настройке.
Облачное развёртывание
Цель: разместить Doris в одном из облаков, обеспечивая высокий уровень доступности, гибкость масштабирования и упрощённое управление инфраструктурой.
Доступные пути:
- Облачные сервисы и managed‑обслуживание. В некоторых облачных средах можно использовать готовые образы Doris, Helm‑чарт или оператор Kubernetes для развёртывания Doris. Это упрощает управление и обновления, но требует понимания особенностей облачных сетей и политик безопасности.
- Самостоятельное развёртывание на Kubernetes. В рамках Kubernetes можно использовать StatefulSets для BE и Deployment для FE, Service для доступа и Ingress для внешнего доступа. Часто применяются Helm‑чарты, чтобы упростить задачу конфигурации и управления версионированием.
Практический сценарий под Kubernetes:
- Создание пространства имён и базовых ролей. Создаём ns doris, настраиваем RBAC.
- Установка Helm и добавление репозиториев, где хранится Doris Helm Chart. Устанавливаем chart с параметрами: количество реплик FE и BE, настройки persistentVolumeClaim, ресурсы CPU/memory, параметры TLS и аутентификации.
- Настройка сервисов. Создаём LoadBalancer/Ingress для доступа к FE, настраиваем внутренние service‑порты для BE, чтобы обеспечить связь между всеми узлами кластера.
- Ингестирование данных. Подключаем S3/Яндекс.Облако/HDFS‑хранилища через брокеров. Подготавливаем Load Label и запускаем загрузку больших объемов данных.
- Мониторинг. Встраиваем Prometheus и Grafana через официальные экспортеры Doris и Kubernetes‑модули. Это позволит видеть задержки, конвейеринг, загрузку CPUs и оперативной памяти по каждому узлу.
- Безопасность. Включаем TLS, настраиваем аутентификацию пользователей, ограничиваем сетевой доступ. В облачном окружении уделяем внимание политике сетевой безопасности, чтобы запросы снаружи шли через безопасные каналы.
Плюсы и ограничения: масштабируемость, гибкость и упрощённое обновление через облако, но стоимость может повышаться, и требуется опыт работы с Kubernetes/облачной инфраструктурой.
Технические детали
Модели хранения и конфигурации
- Архитектура FE/BE. FE управляет схемами, метаданными и координацией запросов. BE — хранит данные и выполняет вычисления. Суммарная мощность кластера зависит от числа BE‑узлов и их спецификаций.
- Распределение таблиц. Выбор распределения по ключу или хеш‑распределение зависит от характера запросов и распределяемости данных. Неправильное распределение может привести к неравномерной загрузке и заторам.
- Ингестирование через брокеры. Doris использует концепцию брокера для доступа к внешним источникам файлов (HDFS, S3, локальные хранилища). Создаётся брокер с нужной конфигурацией, затем запускаются загрузки через команды LOAD LABEL.
- Форматы данных. Doris поддерживает CSV, Parquet и другие форматы, часто предпочтение отдаётся Parquet из-за эффективной колоночной обработки и компрессии.
- Безопасность и доступ. В продакшене применяются TLS‑шлюзы и аутентификация, а также ограничение доступа к данным через роли и политики.
Производительность и настройка ресурсов
- Память и CPU. BE‑узлы требуют достаточно памяти для работы кешей, индексов и операционной памяти. Рекомендации зависят от объема данных и сложности запросов: для начала можно рассчитать 1–2 ГБ RAM на TB данных в референсной конфигурации, затем масштабировать.
- Хранение. Для больших наборов данных рекомендуется SSD‑хранение или NVMe с достаточной ёмкостью. Важно обеспечить быстрый доступ к данным и достаточное пространство для журналов и снапшотов.
- Сеть. Производительные межузловые соединения снижают задержки и улучшают распределение нагрузки. В облачных округах чаще всего применяются сетевые политики и сегментация.
- Мониторинг и алертинг. Включаем Prometheus и Grafana для мониторинга задержек, очередей планирования, загрузки CPU/RAM, а также метрики дискового ввода/вывода. Логирование помогает в расследовании проблем.
Примеры конфигураций и сценарии
- Локальная сборка для обучения. Устанавливаем 1 FE и 1 BE на одной машине, настраиваем cluster_name и IP FE на BE, добавляем данные через брокера и выполняем несколько тестовых запросов для проверки корректности.
- Средний продакшн. 2 FE, 4 BE, 2–3 кластера по зонам доступности. Используем S3‑совместимое хранилище для данных и резервного копирования. Включаем TLS и ограничиваем доступ к FE.
- Облачная развёртка. Kubernetes deployment с StatefulSet для BE и Deployment для FE, Helm Chart, интеграция с внешним хранилищем, мониторинг в Grafana, альтернатива — управляемый сервис с готовыми темплейтами.
Риски и ограничения
- Стратегия хранения и консистентность. Конкретные модели консистентности и механизмов восстановления зависят от реализации Doris. Важно тестировать режимы отказоустойчивости и убедиться, что резервные копии и журналы сохранены.
- Масштабирование. Глобальная производительность зависит от размера кластера, распределения данных, параметров памяти и вычислительных возможностей. Неправильное масштабирование может привести к задержкам и неравномерной загрузке.
- Безопасность и комплаенс. Необходимо обеспечить настройку TLS, аутентификацию и контроль доступа, а также соответствие требованиям локализации и защиты данных в рамках вашего регуляторного окружения.
- Операционная сложность. Развёртывание кластера Doris требует чёткого подхода к конфигурациям, сетевым настройкам, мониторингу и обслуживанию. Ошибки в конфигурации могут привести к простоям или потере доступа к данным.
- Интеграции. В зависимости от вашего стека могут потребоваться дополнительные инструменты для инжестирования, потоковых загрузок и аналитики данных. Следует планировать совместимость с существующими системами (ETL‑конвейеры, BI‑инструменты, системы мониторинга).
Развертывание кластера Doris — это важный и многоступенчатый процесс, который начинается с теории архитектуры, переходит к практическим шагам локальной разработки и масштабируется до продакшн‑развертываний на серверах и в облаке. В зависимости от задач и бюджета вы можете выбрать локальный тестовый режим, затем перейти к кластеру на серверах или в облаке с учетом требований к доступности, задержкам и безопасности. Важно планировать инфраструктуру, конфигурации памяти и CPU, способ ingest данных, мониторинг и резервное копирование заранее, чтобы снизить риски и обеспечить устойчивую работу аналитических нагрузок на больших данных.
Вопрос–Ответ (FAQ)
1) Что такое FE и BE в Doris и какую роль они выполняют?
FE (Frontend) — узел, который управляет метаданными, схемами, пользователями и координацией запросов. BE (Backend) — узел, который хранит данные и выполняет вычисления по запросам. Совместно они образуют кластер Doris: FE отвечает за планирование и управление, BE — за хранение данных и вычисления.
2) Как выбрать конфигурацию кластера: сколько FE и BE узлов мне нужно?
Это зависит от объема данных, требуемой скорости запросов и желаемой отказоустойчивости. В небольшом окружении достаточно 1–2 FE и 2–4 BE узлов для тестирования и разработки. В продакшне обычно используют 2 FE для доступности и 3–6 BE (или больше) в зависимости от размера базы. Для больших нагрузок потребуется горизонтальное масштабирование BE и эффективное распределение нагрузки между узлами.
3) Какие типы хранилищ поддерживает Doris для данных и загрузки?
Doris поддерживает хранение данных на локальном диске BE, а для инжестирования данных — брокеры, которые позволяют считывать данные из HDFS, S3‑совместимых хранилищ, локальных файлов и аналога. Для загрузки больших наборов данных обычно применяют Parquet/CSV и брокеры, что упрощает конвейеры ETL.
4) Какие риски есть при миграции на Doris из другой СУБД?
Основные риски включают несовместимости в синтаксисе SQL, различия в поведении распределения данных, сложность настройки параметров памяти и скорости выполнения запросов, а также потребность в переработке ETL конвейеров под аргументы Doris. Нужно провести пилотный проект, тестировать типовые запросы и стратегии загрузки данных до перехода в продакшн.
5) Какие механизмы защиты и безопасности предоставляет Doris?
Doris поддерживает аутентификацию пользователей, роли и разрешения, TLS‑шифрование для сетевого трафика и безопасное взаимодействие клиентов. В продакшне полезно включать TLS между FE и BE, а также между клиентами и FE, настраивать политики доступа и аудит действий пользователей.
6) Какой подход к мониторингу рекомендуется использовать?
Стандартно — встроенные веб‑интерфейсы FE/BE для базового мониторинга и внешние системы мониторинга, такие как Prometheus и Grafana, для детальной визуализации метрик: задержки запросов, загрузка CPU/RAM, I/O на дисках, статус загрузок. В продакшне целесообразно иметь централизованную сборку логов (ELK/EFK) и алертинг на критические метрики.
7) Какие примеры практических сценариев можно привести для локального, серверного и облачного развёртывания?
- Локально: один FE и один BE на одной машине, быстрая проверка конфигураций, загрузка тестовых данных, выполнение простых запросов.
- На серверах: 2 FE и 4 BE узла, настройка кластера, брокеры для загрузки больших данных из S3/HDFS, мониторинг и настройка отказоустойчивости.
- В облаке: развёртывание через Kubernetes с StatefulSets для BE и Deployment для FE, использование Helm Chart, интеграция с облачным хранилищем и мониторингом, настройка безопасного доступа и TLS.
8) Что важно учесть при локализации данных в российском контексте?
Необходимо учитывать требования регуляторов к локализации данных и хранению данных в отечественных дата‑центрах, настройках сетевой безопасности и доступности. В таких случаях выбирают отечественные облачные площадки/провайдеров для размещения инфраструктуры Doris, аккуратно настраивают правила доступа и путей к данным, а также обеспечивают соответствие SLA и требованиям к аудиту.
9) Какой опыт и навыки необходимы для успешного развёртывания Doris?
Необходимо понимание концепций распределённых систем, основ баз данных OLAP, SQL, а также навыков администрирования Linux‑серверов, работы с сетями и системами мониторинга. Опыт работы с Kubernetes и облачными инструментами (если выбирается облачное развёртывание) будет большим плюсом.
10) Что даст нам Doris по сравнению с привычными аналитическими системами?
Doris обеспечивает высокую производительность аналитических запросов на больших данных благодаря мощной архитектуре MPP и колоночному формату хранения. Он позволяет строить сложные аналитические конвейеры, работать с большими массивами данных в реальном времени и легко интегрироваться с существующими BI‑инструментами через стандартные интерфейсы SQL, JDBC/ODBC. Это позволяет оперативно развернуть аналитическую платформу без необходимости построения собственного решения с нуля.
Развертывание кластера Doris — это последовательность четких шагов: от теоретических основ архитектуры до практических сценариев локального тестирования, сервера и облака. Важно помнить о планировании инфраструктуры, выборе подходящей архитектуры кластеров, грамотной настройке инжестирования и мониторинга, а также учёте рисков безопасности и соответствия требованиям. При должном подходе Doris может стать мощной основой для вашей аналитической экосистемы, обеспечивая устойчивую производительность, масштабируемость и гибкость в управлении данными.


