

Выбор инструмента ETL/ELT для ClickHouse: обзор Apache NiFi и Apache Airflow
В современном мире данные — это неотъемлемая часть нашей жизни, но вся их истинная ценность раскрывается только тогда, когда они своевременно и без потерь поступают в системы анализа, такие как мощные колоночные СУБД, например, ClickHouse.
Сегодня мы подробно разберем два ведущих подхода к организации потоков данных: Apache NiFi и Apache Airflow. Мы не просто сравним их, а покажем, какой инструмент и в каком сценарии станет вашим стратегическим преимуществом, а также какие подводные камни могут вас подстерегать на пути внедрения.
Почему эта тема критически важна для вашего бизнеса? Представьте, что вы ритейлер, и ежедневно ваши магазины генерируют гигабайты данных о продажах и клиентах. Если эти данные задерживаются, обрабатываются с ошибками или теряются, вы принимаете решения на основе вчерашней или неполной картины. Это приводит к прямым финансовым потерям: неоптимальным закупкам, упущенным возможностям для кросс-продаж и неэффективным маркетинговым кампаниям. Правильно выстроенный конвейер данных — это не техническая роскошь, а кровеносная система вашего бизнеса.
Давайте начнем с Apache NiFi — инструмента, который переворачивает представление о том, насколько сложно может быть управление данными.
Apache NiFi: Low-Code подход к потоковой передаче данных
Разработка в NiFi напоминает сборку конструктора. Вы создаете потоки данных на визуальном полотне, соединяя между собой специализированные блоки — процессоры. Каждый процессор выполняет свою элементарную функцию: взять файл с FTP, распаковать архив, преобразовать JSON в CSV, отправить запрос в базу данных. Это парадигма Low-Code, которая позволяет строить сложные ETL/ELT-процессы без написания объемного кода на Java или Python.
Самое главное преимущество данного подхода состоит в снижении порога входа. Аналитики или ИТ-специалисты, не являющиеся углубленными программистами, могут самостоятельно настраивать и поддерживать потоки данных. Это ускоряет разработку и снижает нагрузку на дорогостоящие разработческие ресурсы.
Для гибкой работы NiFi использует свой язык выражений NiFi Expression Language.
NiFi Expression Language (EL) — это специальный язык, который позволяет ссылаться на атрибуты FlowFile, переменные окружения, параметры контекста и выполнять над ними различные операции прямо в значениях свойств процессоров NiFi.
Проще говоря, это способ делать настройки в NiFi "умными" и динамическими. Вместо того чтобы указывать статическое значение (например, /data/files), вы можете написать выражение, которое вычислится в реальном времени для каждого обрабатываемого файла (например, /data/${filename:substringBefore('.')}).
С его помощью вы можете автоматически направлять файлы в разные директории на основе их содержимого, даты создания или других атрибутов. Например, ${now():format('yyyy/MM/dd')}/${filename} создаст путь 2023/10/25/myfile.csv.
Условная маршрутизация (RouteOnAttribute) - одна из самых мощных функций придуманных когда-либо. Вы можете создавать сложные условия для направления FlowFile по разным веткам потока. Например, ${attribute:equals('SUCCESS')} — файл пройдет дальше, только если у него есть атрибут attribute со значением SUCCESS.
Еще одна функция данного языка, о которой стоит сказать - манипуляция с данными. Можно извлекать части строк, менять регистр, объединять значения атрибутов. Например, ${filename:toUpper():replace(' ', '_')} превратит my file.txt в MY_FILE.TXT.
Кроме того, NiFi Expression Language позволяет валидировать данные, то есть проверять наличие необходимых атрибутов или их соответствие определенным шаблонам перед дальнейшей обработкой. Например, ${attribute:matches('[0-9]{4}-[0-9]{2}-[0-9]{2}')} проверит, что атрибут имеет формат даты YYYY-MM-DD.
И, наконец, это интеграция с внешним контекстом или использование переменных из Registry или параметров контекста для создания гибких и переиспользуемых потоков.
По большому счету, NiFi Expression Language — это "суперсила", которая превращает статические конфигурации в гибкие, интеллектуальные и мощные потоки данных. Его освоение — это ключевой шаг к созданию профессиональных, отказоустойчивых и легко адаптируемых ETL/ELT-процессов в Apache NiFi.
Гарантированная доставка и отказоустойчивость — краеугольный камень NiFi
Это то, что отличает его от многих других инструментов. NiFi оперирует концепцией FlowFile — это объект, который содержит сами данные (контент) и их метаданные (атрибуты). Каждый FlowFile на каждом этапе обработки сохраняется на диск. Что это значит на практике?
В первую очередь, это потеря данных при сбое. Если сервер внезапно отключится, после перезапуска NiFi продолжит обработку именно с того места, где она прервалась, не потеряв ни байта информации.
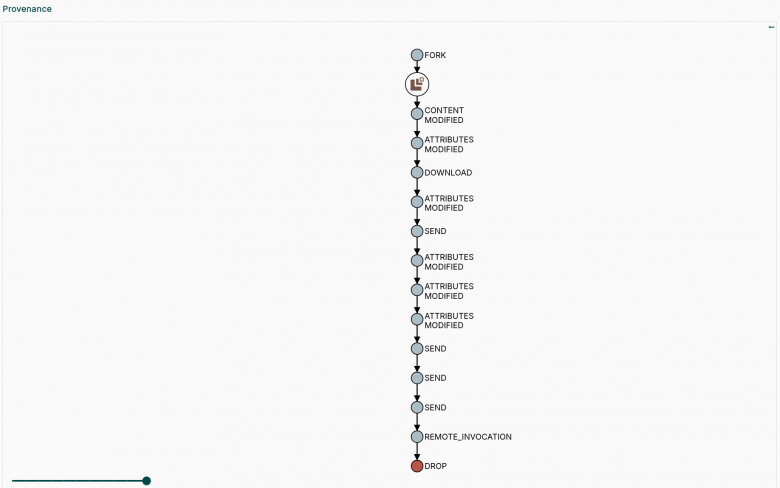
Кроме того, NiFi предоставляет беспрецедентные возможности для отладки. Вы можете в реальном времени просматривать содержимое и атрибуты каждого файла на любом этапе его пути. А в разделе Data Provenance можно отследить полную родословную любого файла: откуда он пришел, какие преобразования прошел и куда был доставлен. Это не просто удобно для разработки — это мощный инструмент аудита и расследования инцидентов.
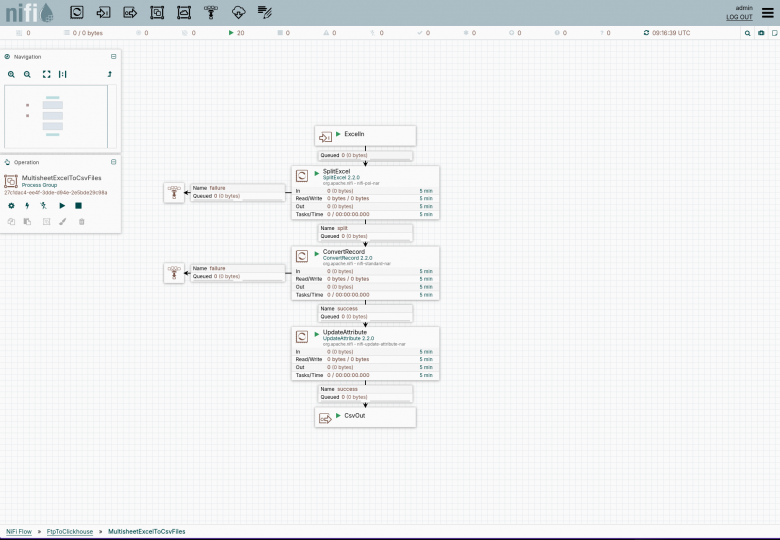
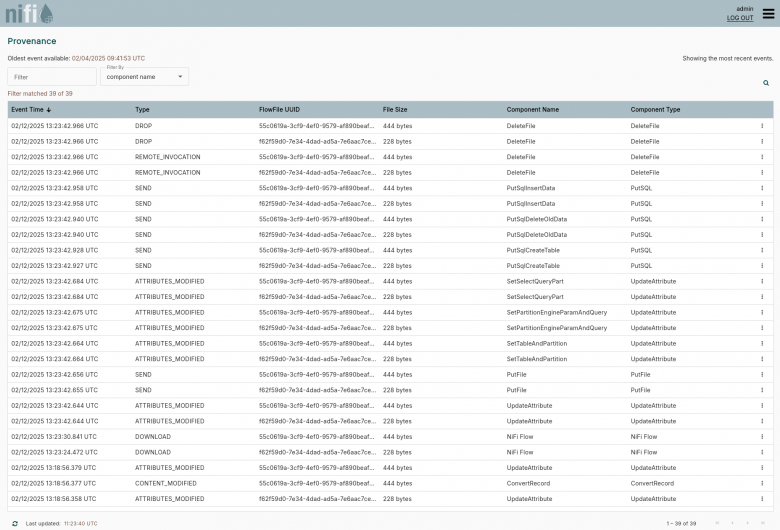
У любого файла можно просмотреть его путь от загрузки до окончания обработки, просто нажмите на три точки у любого события и выберите пункт Show Lineage:
Интеграция с ClickHouse: практические шаги и подводные камни
Для подключения NiFi к ClickHouse необходим JDBC-драйвер. Процесс установки в Docker-окружении прост: создается небольшой Dockerfile, который добавляет jar-файл драйвера в образ NiFi.
FROM apache/nifi:latest
USER root
RUN mkdir -p /opt/jar/
RUN curl -Lo '/opt/jar/clickhouse-jdbc-0.8.0-shaded-all.jar' 'https://github.com/ClickHouse/clickhouse-java/releases/download/v0.8.0/clickhouse-jdbc-0.8.0-shaded-all.jar'
USER nifi
Далее в настройках NiFi создается сервис DBCPConnectionPool, где указываются:
- URL подключения к ClickHouse (например, jdbc:clickhouse://clickhouse-server:8123/default)
- Класс драйвера (com.clickhouse.jdbc.ClickHouseDriver)
- Путь к jar-файлу драйвера.
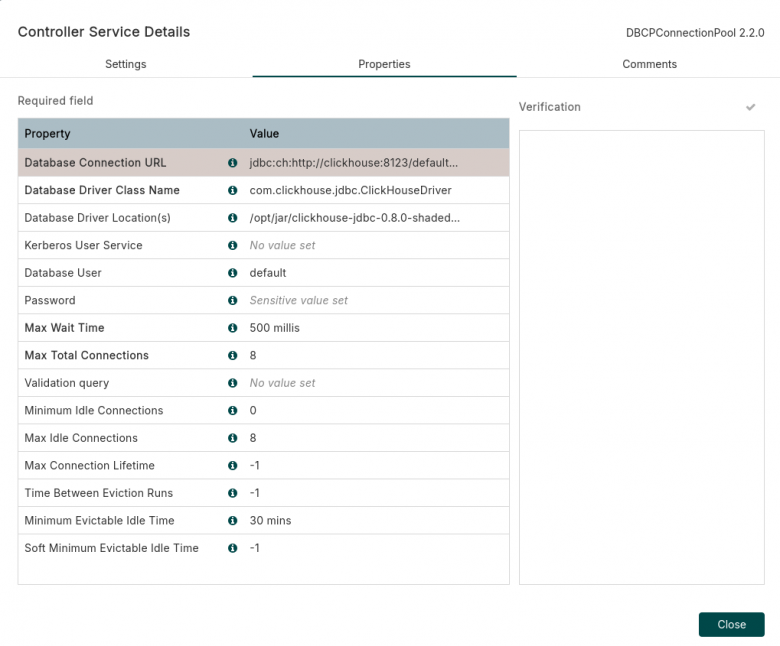
Важно! Неверно указанный класс драйвера или забытый jar-файл приводит к ошибкам подключения на этапе запуска потоков. Наша рекомендация — всегда проверять подключение с помощью тестового процессора ExecuteSQL перед построением основных потоков.
Общий процесс загрузки CSV в ClickHouse через NiFi выглядит так:
- Получение файла (с FTP, из облачного хранилища).
- Предобработка: парсинг, валидация, преобразование в нужную кодировку.
- Сохранение в специальную директорию ClickHouse (/var/lib/clickhouse/user_files), откуда СУБД может читать файлы напрямую.
- Формирование и выполнение SQL-запросов: создание таблицы, если ее нет, удаление старых данных (если это инкрементальное обновление) и вставка новых данных с помощью запроса INSERT FROM file(...).
- Очистка: удаление временного файла.
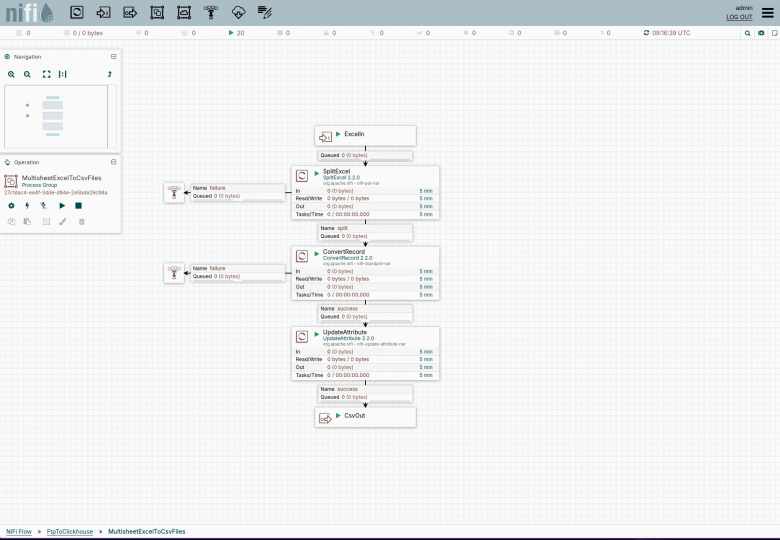
Ключевой риск на этом этапе заключается в отсутствии обработки ошибок при выполнении SQL. Что, если структура CSV не совпадет со структурой таблицы? NiFi позволяет настроить маршрутизацию по признаку "успех/неудача", чтобы "битые" файлы не терялись, а отправлялись в карантин для последующего разбора.
Apache Airflow: оркестратор для сложных процессов по расписанию
Теперь рассмотрим Apache Airflow. Его философия совершенно иная. Если NiFi — это визуальный конструктор для непрерывных потоков данных, то Airflow — это платформа для оркестрации задач, запускаемых по расписанию или событию.
Процессы в Airflow описываются кодом на Python в виде направленных ациклических графов (DAG). Каждый узел графа — это задача (Task), например, "запустить скрипт", "выполнить SQL-запрос", "отправить письмо".
Его ключевое преимущество – это гибкость и мощность. Поскольку все описывается кодом, вы можете реализовать сколь угодно сложную логику: ветвления, циклы, сложные зависимости между задачами.
Рассмотрим пример из практики: ежедневная задача по формированию витрины данных в ClickHouse, которая включает в себя 10 последовательных шагов: выгрузка из 5 разных источников (API, базы данных, файлы), их очистка, объединение, агрегация и финальная загрузка. В Airflow такой процесс описывается одним DAG, где каждая задача зависит от успешного выполнения предыдущей. Если на шаге 7 произойдет ошибка, Airflow автоматически уведомит ответственных, а после исправления можно перезапустить процесс именно с этого шага.
Сравнение: NiFi vs Airflow — что и когда выбирать?
Давайте проведем детальное сравнение, чтобы вы могли сделать выбор осознанно.
|
Критерий |
Apache NiFi |
Apache Airflow |
|---|---|---|
|
Основная парадигма |
Визуальный Low-Code, потоковая обработка |
Код на Python (Python-as-Code), оркестрация задач по расписанию |
|
Объект управления |
Отдельный файл или сообщение (FlowFile) |
Задача (Task) как часть рабочего процесса (DAG) |
|
Гарантия доставки |
Высокая, встроенная, на уровне каждого файла |
Зависит от реализации задач; требует дополнительных усилий |
|
Мониторинг и отладка |
Просмотр содержимого каждого файла на каждом шаге, полный аудит lineage |
Мониторинг статусов задач, логи выполнения; отладка требует анализа логов |
|
Порог входа |
Низкий, подходит для аналитиков и junior-разработчиков |
Высокий, требуется знание Python и парадигмы оркестрации |
|
Идеальные сценарии |
Непрерывная потоковая передача данных, миграция данных между системами, обработка файлов в реальном времени |
Сложные ETL-пакеты, запускаемые по расписанию (ежедневно, еженедельно), ML-пайплайны, оркестрация разнородных задач |
Замеры производительности NiFi vs Airflow на практике
В рамках нашего тестирования оба инструмента показали сопоставимые результаты при обработке пакета CSV-файлов общим объемом 2.61 ГБ и их загрузке в чистый ClickHouse. Airflow справился за 48 секунд, NiFi — за 40 секунд. Это доказывает, что оба инструмента эффективны с точки зрения производительности. Выбор должен основываться не на этих секундах, а на соответствии инструмента именно вашим бизнес-процессам.
Риски, ошибки и общие рекомендации
Самая частая и дорогая ошибка — пытаться использовать Airflow для простой потоковой перекачки файлов или пытаться заставить NiFi выполнять сложную пакетную логику с ветвлениями. Это приводит к созданию "костылей", низкой поддерживаемости и в итоге — к переписыванию системы. Поэтому всегда четко формулируйте свои требования. Нужен ли вам непрерывный поток или ежедневный пакетный расчет?
Помните о том, что в Airflow существует риск потери данных. "Из коробки" Airflow не гарантирует доставку каждого сообщения. Если задача упала, обработанные ею данные могут быть потеряны навсегда. Для критически важных данных обязательно используйте идемпотентные операции (повторное выполнение не навредит) и проектируйте DAG-и так, чтобы они могли безопасно перезапускаться.
Кроме того, помните про риск усложнения поддержки в NiFi. Визуальная простота может сыграть злую шутку. Слишком разросшиеся и плохо документированные потоки превращаются в "спагетти-код", разобраться в котором невозможно. Соблюдайте правила "чистой архитектуры": используйте группы процессов для модуляции, давайте понятные имена и активно используйте комментарии.
Не забывайте и про риск недостаточного мониторинга. После запуска пайлайна о нем часто забывают. Проблема обнаруживается только тогда, когда данные устарели на несколько дней. Внедрите централизованный мониторинг и оповещения. Настройте уведомления в Telegram или Slack при любых сбоях в NiFi или Airflow.
В заключении хотелось бы сказать, что не всегда выбор стоит между "или-или". В сложных корпоративных средах NiFi и Airflow идеально дополняют друг друга. NiFi может отвечать за надежную, непрерывную доставку "сырых" данных в Data Lake, а Airflow — оркестровать сложные ETL-процессы, которые по расписанию забирают эти данные, преобразуют и загружают в витрины ClickHouse для конечных отчетов и дашбордов.
Мы помогаем нашим клиентам не просто выбрать инструмент, а выстроить целостную, надежную и масштабируемую архитектуру управления данными. Позвольте вашим данным работать на вас с максимальной эффективностью. Обращайтесь, и мы найдем оптимальное решение для вашей уникальной задачи.


