

Интеграция каталогов с Spark
Этот раздел посвящен интеграции каталогов с Apache Spark в рамках курса Настройка и использование каталогов для Iceberg Lakehouse. Цель главы — дать новичку понятную и практическую картину того, зачем нужны каталоги в Iceberg, какие типы каталогов существуют, как они работают вместе со Spark, какие конфигурации применяются на практике и какие риски могут возникнуть при их внедрении. Мы разберем термины, методики проектирования архитектуры каталога, приведем конкретные примеры настройки (как открытые решения, так и российские способы реализации через локальные инфраструктуры), а также предложим набор практических рекомендаций по безопасной и устойчивой работе. В конце главы — блок вопросов и ответов, который поможет закрепить материал и систематизировать полученные знания.
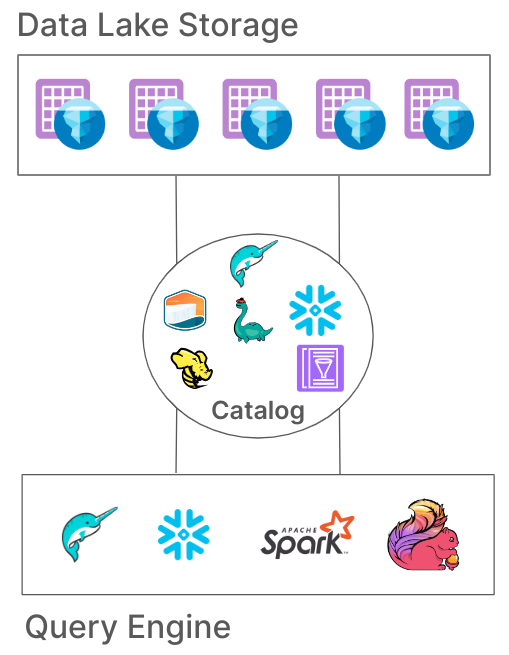
Каталог в Iceberg — что это и зачем
Iceberg — это таблицы больших данных, которые поддерживают транзакции, совместную навигацию по версиям данных и эффективное управление метаданными. Каталог в Iceberg — это слой абстракции над механизмами хранения и метаданными о таблицах: он отвечает за поиск, именование и доступ к таблицам внутри пространства имен (namespace) и баз данных (schemas). Каталог обеспечивает адресацию таблиц без прямого обращения к физическим файлам, упрощает управление версиями, обеспечивает единый интерфейс доступа к данным независимо от того, где и как хранятся данные.
Зачем нужен каталог в Spark
Spark, как движок обработки данных, работает с источниками данных через API DataFrame API и SQL. Интеграция Iceberg с Spark требует устойчивого механизма регистрации и поиска таблиц Iceberg. Каталог предоставляет:
- единый путь к метаданным таблиц Iceberg;
- управление пространством имен (наборами баз данных и таблиц);
- возможность явного выбора каталога при создании и чтении таблиц (например, CREATE TABLE my_catalog.default.customers USING ICEBERG);
- поддержку многоузловой архитектуры и масштабируемости: каталоги могут работать на разных уровнях инфраструктуры (локальный HadoopCatalog, Hive Metastore, удаленный REST-сервис и т. п.);
- улучшение безопасности через централизованный контроль доступа к метаданным.
Типы каталогов Iceberg и их особенности
В контексте Spark существует несколько реализаций каталога, каждая из которых имеет свои trade-off:
- HiveCatalog (через Hive Metastore): хранение метаданных Iceberg в Hive Metastore, база данных и таблицы находятся в Metastore-хранилище; удобно для организаций, уже работающих на Hive и использующих Kerberos и LDAP. Применение: spark.sql.catalog.my_catalog=org.apache.iceberg.spark.SparkCatalog; spark.sql.catalog.my_catalog.type=hive; spark.sql.catalog.my_catalog.uri=thrift://metastore-host:9083.
- HadoopCatalog (локальная файловая система или HDFS): метаданные Iceberg хранятся рядом с данными в файловой системе; прост в настройке, не требует внешнего метастора; полезен для автономных кластерах и небольших проектов. Применение: spark.sql.catalog.my_catalog=org.apache.iceberg.spark.SparkCatalog; spark.sql.catalog.my_catalog.type=hadoop; spark.sql.catalog.my_catalog.warehouse=/path/to/warehouse.
- RestCatalog (REST-сервис Iceberg): метаданные обслуживаются через REST API; подходит для распределенных архитектур, где метаданные централизованы и обслуживаются отдельным сервисом, например в мультиоблачной среде. Применение: spark.sql.catalog.my_catalog=org.apache.iceberg.spark.SparkCatalog; spark.sql.catalog.my_catalog.type=rest; spark.sql.catalog.my_catalog.uri=http://iceberg-rest-host:8181.
- SparkCatalog (локальный SparkSessionCatalog): внутренний механизм Spark для регистрации Iceberg-таблиц; может использоваться с различными подтипами через дополнительные параметры и совместится с другими каталогами. Это скорее инфраструктурная деталь, которая помогает Glueи метео-слоям работать с Iceberg внутри SparkSession.
- InMemoryCatalog (для тестирования): временный подкаталог в памяти; применяется только в тестах и примерах, не для продуктивной эксплуатации.
Как Spark «видит» каталоги
Spark управляет каталожной системой через набор конфигурационных параметров, обычно начинающихся с префикса spark.sql.catalog. Примеры:
  spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
  spark.sql.catalog.my_catalog.type = hive (или hadoop, или rest)
  spark.sql.catalog.my_catalog.uri = thrift://metastore-host:9083 (если type=hive)
  spark.sql.catalog.my_catalog.warehouse = /path/to/warehouse (для type=hadoop; путь в файловой системе)
Эти параметры позволяют Spark читать и писать таблицы Iceberg через указанный каталог. В рамках одного проекта можно использовать несколько каталогов разных типов, адресуя их через разные имена (my_catalog, another_catalog и т. д.).
Практические примеры
Пример 1: Open-Source HadoopCatalog с Spark и HDFS
Цель: локальное и простое хранение таблиц Iceberg в HDFS без внешнего Hive Metastore.
Архитектура: Spark на кластере, HDFS как файловое хранилище, HadoopCatalog для метаданных.
Конфигурация (пример на SparkSession в Scala/Java или PySpark):
spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
spark.sql.catalog.my_catalog.type = hadoop
spark.sql.catalog.my_catalog.warehouse = hdfs://namenode:8020/user/iceberg/warehouse
Загрузка и создание таблицы:
CREATE TABLE my_catalog.default.customers (id INT, name STRING) USING ICEBERG;
Вставка данных и выборка:
  INSERT INTO my_catalog.default.customers VALUES (1, 'Иван'), (2, 'Мария');
  SELECT * FROM my_catalog.default.customers;
Пояснения:
- Все данные и метаданные Iceberg хранятся в указанном каталоге (warehouse). Метаданные Iceberg (snapshots, manifests) создаются и обновляются в процессе записи.
- Преимущества: простота, отсутствие внешних зависимостей, хорошо подходит для локальных дата-центров.
- Недостатки: ограниченная совместимость с внешними сервисами метаданных; менее подходит для больших мультиобластных сценариев без централизованного метастора.
Пример 2: HiveCatalog с Hive Metastore
Цель: интеграция в инфраструктуру с существующим Hive Metastore и Kerberos-администированием.
Архитектура: Spark + Iceberg + Hive Metastore; Metastore доступен по RPC; данные могут храниться в HDFS или S3-совместимом хранилище.
Конфигурация:
spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
spark.sql.catalog.my_catalog.type = hive
spark.sql.catalog.my_catalog.uri = thrift://metastore-host:9083
spark.sql.catalog.my_catalog.warehouse = hdfs://namenode:8020/user/iceberg/warehouse
Создание и использование таблиц:
CREATE TABLE my_catalog.sales.orders USING ICEBERG (order_id BIGINT, amount DOUBLE);
INSERT INTO my_catalog.sales.orders VALUES (1001, 250.0);
SELECT * FROM my_catalog.sales.orders WHERE amount > 100;
Пояснения:
- Hive Metastore управляет схемами и пространствами имен; Iceberg хранит физические данные и версии таблиц.
- Безопасность: Kerberos и TLS для метастора, а также политики доступа к данным (Sentry/ Ranger или IAM-права в зависимости от среды).
- Преимущества: единый реестр метаданных, совместимость с существующими процессами ETL, учетчики безопасности и аудит.
Пример 3: REST Catalog и распределенное хранилище
Цель: отдельный централизованный каталог для мультиоблачной архитектуры.
Архитектура: Iceberg RESTCatalog через сервис управления метаданными; Spark обращается к REST-API для доступа к каталогам и таблицам.
Конфигурация:
spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
spark.sql.catalog.my_catalog.type = rest
spark.sql.catalog.my_catalog.uri = http://iceberg-rest-service:8181
spark.sql.catalog.my_catalog.warehouse = s3a://iceberg-warehouse/
Пример запросов:
CREATE TABLE my_catalog.analytics.kpis (date STRING, kpi_name STRING, value DOUBLE) USING ICEBERG;
SELECT date, AVG(value) FROM my_catalog.analytics.kpis GROUP BY date, kpi_name;
Пояснения:
- RESTCatalog удобен, если метаданные должны обслуживаться унифицированно независимому центру управления данными. Хорошо подходит для мультиоблачной среды.
- Недостатки: зависимость от доступности REST-сервиса; добавляется задержка в реальном времени по сравнению с локальными каталогами.
- Безопасность: TLS и аутентификация к REST-сервису, интеграция с корпоративной SSO.
Пример 4: Российский опыт — локальные развёртывания и практика
Цель: демонстрация того, как организации в России применяют Iceberg и каталоги в условиях локальных дата-центров, строгих требований к безопасности и локализации данных.
Архитектура: чаще всего применяют комбинацию HadoopCatalog или HiveCatalog с локальным Hive Metastore, размещенным в локальном дата-центре, с Kerberos-авторизацией и использованием S3-совместимого хранилища (например, «облако-локальный» вариант или частные облака). В рамках российских проектов встречаются сценарии:
- Локальный Hive Metastore и Kerberos-авторизация для контроля доступа к метаданным; Catalog использует HiveCatalog.
- Хранилище данных — в рамках локального HDFS или S3-совместимого хранилища внутри частного облака; Iceberg хранит данные и метаданные в каталоге warehouse.
- Управление данными и безопасность через корпоративные политики и организации процессов аудита.
Пример конфигурации (локальная версия HiveCatalog):
spark.sql.catalog.ru_catalog = org.apache.iceberg.spark.SparkCatalog
spark.sql.catalog.ru_catalog.type = hive
spark.sql.catalog.ru_catalog.uri = thrift://metastore.local:9083
spark.sql.catalog.ru_catalog.warehouse = hdfs://datacenter.local:8020/user/iceberg/warehouse
Практическая польза:
- Соответствие требованиям локализации данных и регулятивным требованиям ФЗ о персональных данных и обработке данных граждан.
- Возможность использования существующих инструментов мониторинга и аудита в рамках российского корпоративного стекa.
- Поддержка Kerberos и корпоративной аутентификации для защиты метаданных и таблиц.
Пояснение к рискам и вызовам:
- Необходимость устойчивого и доступного Metastore внутри данных центров; сбои Metastore могут привести к недоступности списков таблиц.
- Важно обеспечить резервирование и миграцию каталога, особенно при переходах на новые версии Iceberg.
- Безопасность: конфигурации TLS, интеграция с LDAP/AD и управление секретами (ключи, токены).
Конфигурационные параметры и принципы работы
Общие принципы:
  spark.sql.catalog.<имя_каталога> = org.apache.iceberg.spark.SparkCatalog
  spark.sql.catalog.<имя_каталога>.type = hive|hadoop|rest|inmemory
  spark.sql.catalog.<имя_каталога>.uri = адрес метастора (для type=hive) или REST-адрес (для type=rest)
  spark.sql.catalog.<имя_каталога>.warehouse = путь к корневому каталогу Iceberg-метаданных (для type=hadoop)
HiveCatalog:
- Требуется Hive Metastore (обычно через vše Kryberos)
- uri — thrift-звонок к Metastore
- warehouse — местоположение баз данных Iceberg и файлов данных
HadoopCatalog:
- warehouse — корень каталога на файловой системе (HDFS, локальная FS, S3-совместимое хранилище)
- Без внешнего Metastore; метаданные Iceberg хранятся в каталоге warehouse
RESTCatalog:
- uri — адрес REST-сервиса Iceberg
- warehouse — необязательна; многие REST-каталоги управляют метаданными отдельно от реального хранения данных
Безопасность и доступ
- Kerberos: использование Kerberos-сервисов для аутентификации пользователей Spark и Metastore
- TLS/SSL: шифрование трафика между Spark-клиентами, Metastore и REST-службами
- LDAP/AD: централизованный контроль доступа к пользователям
- Роли и политики: использование Ranger, Sentry или встроенных механизмов Spark/ Iceberg для аудита и ограничений доступа
Хранилище данных и формат файлов
- Iceberg хранит данные в формата Parquet/AVRO/ORC; файлы упакованы в каталоге warehouse
- Метаданные Iceberg: metadata.json, snapsho и manifests — хранятся внутри каталога
- Контроль версии и времени восстановления: Iceberg поддерживает time travel через версии таблиц
Очередность и миграции
- Миграции между каталогами (например, из HadoopCatalog в HiveCatalog) требуют careful планирования и миграций
- В Spark можно писать скрипты миграции: экспорт таблиц, повторное создание в новом каталоге с конвертацией
Управление и мониторинг каталога
- Логирование и аудит: включение логирования для Iceberg и Metastore; сбор метрик через JMX/Prometheus
- Мониторинг производительности: длительные операции сканирования, метаданные обновления, частота сборки метаданных
- Резервирование и отказоустойчивость: репликация каталога, резервное копирование метаданных и данных
- Управление версиями Iceberg: резервное копирование и откат к нужной версии, мониторинг изменений схемы
- Контроль доступа: интеграция с централизованной системой идентификации и прав доступа
Риски и ограничения
Зависимость от внешних сервисов: Hive Metastore, REST-сервис Iceberg, Kerberos-окружение
- Проблемы доступности METASTORE или REST-API могут привести к невозможности чтения/записи таблиц
Масштабируемость и производительность
- При большом количестве таблиц или частой модификации схемы каталоги могут испытывать задержки на обновление метаданных
- Сложности управления большими наборами таблиц в одном каталоге (монтирования, разделение по namespaces)
Совместимость между версиями Iceberg и Spark
- Новые версии Iceberg могут требовать обновления Spark, соответствующих конфигаций и зависимостей
Безопасность и соответствие требованиям
- В регионах с локальными политиками данных (российское законодательство о локализации данных) важно обеспечить локальный метастор и хранение данных в рамках локального центра
- Необходимо соблюдать требования по шифрованию данных и аудиту доступа
Косвенные риски
- Недоконтроль версий таблиц (Edits) и некорректные миграции
- Неправильная конфигурация данных, включая неверный путь к warehouse
- Потеря ключей шифрования или неправильная настройка Kerberos может заблокировать доступ к данным
Ограничения функциональности
- Различные типы каталогов поддерживают разные сценарии: HiveCatalog хорошо для компаний с существующим метастором, RESTCatalog удобен для мультиоблачных архитектур, HadoopCatalog прост при локальном использовании
- Некоторые функции Iceberg доступны не для всех типов каталогов или требуют определённых версий
Интеграция каталогов с Spark в Iceberg — фундаментальная часть инфраструктуры Data Lakehouse. Каталоги предоставляют единый интерфейс доступа к множеству таблиц, упрощают управление метаданными, обеспечивают масштабируемость и работу в условиях обеспечения безопасности. Выбор типа каталога зависит от инфраструктуры, требований к управлению метаданными, политики безопасности и архитектуры хранилища. Hive Metastore удобен для тех, кто уже имеет устоявшийся стек Hadoop/Hive и желает единообразного доступа к данным через Iceberg. HadoopCatalog хорош для локальных проектов без внешних метасторов. RESTCatalog подходит для мультиоблачных сценариев и сервисно-ориентированной архитектуры. Российские проекты часто конфигурируют локальные каталоги через HiveCatalog с локальным Metastore и Kerberos, чтобы соответствовать требованиям локализации данных и корпоративной безопасности. Внедрение каталогов требует планирования миграций, устойчивости сервисов и контроля доступа, а также мониторинга и регулярного аудита. При правильной конфигурации каталоги SparkIceberg обеспечивают надежное, масштабируемое и безопасное хранение данных в lakehouse-модели.
FAQ — Вопрос–ответ
1) Что такое каталог Iceberg и зачем он нужен в Spark?
Каталог Iceberg — это слой, который регистрирует и управляет пространством имен и таблиц Iceberg, позволяя Spark находить таблицы и работать с ними. Он упрощает доступ к множеству таблиц в разных структурах хранения, обеспечивает единый путь к метаданным и поддерживает транзакции и версионность. Без каталога Spark должен напрямую оперировать файловой структурой и метаданными, что усложняет управление и снижает масштабируемость.
2) Какие типы каталогов существуют и чем они отличаются?
Существуют HiveCatalog, HadoopCatalog, RESTCatalog и SparkCatalog (как механизм регистрации внутри Spark). HiveCatalog использует Hive Metastore и обеспечивает интеграцию с существующим стеком Hive/ Kerberos. HadoopCatalog хранит метаданные локально в файловой системе; не требует внешнего Metastore, но ограничен в гибкости. RESTCatalog обслуживает метаданные через REST API — удобно для мультиоблачной архитектуры. SparkCatalog — общий механизм интеграции Iceberg с Spark, работающий через настройки spark.sql.catalog.* и подтип каталога, который вы выбираете.
3) Как выбрать подходящий каталог для проекта?
Выбор зависит от существующей инфраструктуры и требований к управлению метаданными:
- Если у вас уже есть Hive Metastore и вы хотите единый контроль доступа — HiveCatalog.
- Если проект локален и вам не нужен внешний метастор, HiveMetastore не обязателен — HadoopCatalog.
- Если нужна мультиоблачная архитектура и централизованный API для метаданных — RESTCatalog.
- Если вы хотите тесно встроиться в Spark и запрашивать каталоги через SparkSession — SparkCatalog в сочетании с нужным типом.
Учтите требования по безопасности, доступности и регулятивные требования, а также инфраструктурные ограничения.
4) Как настроить Hive Metastore в Spark?
Необходимы:
- Наличие Hive Metastore и его доступности по RPC (Thrift, обычно thrift://host:9083).
- Конфигурация Spark: spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog; spark.sql.catalog.my_catalog.type = hive; spark.sql.catalog.my_catalog.uri = thrift://metastore-host:9083; spark.sql.catalog.my_catalog.warehouse = /path/to/warehouse.
- Убедитесь в совместимости версий Spark, Iceberg и Hive Metastore; включите Kerberos и TLS, если требуется.
- Создавайте таблицы через Iceberg SQL, например: CREATE TABLE my_catalog.default.customers USING ICEBERG (id INT, name STRING);
5) Какие риски существуют при использовании HiveCatalog?
Риски включают зависимость от доступности Hive Metastore, необходимость поддерживать совместимость версий и конфигураций, возможное увеличение задержек при запросах к метаданным, а также необходимость сложной конфигурации безопасности (Kerberos, TLS). Важно обеспечить резервирование Metastore и план миграции при обновлениях.
6) Как обеспечить безопасность и доступ к каталогам?
Обеспечение безопасности включает Kerberos-подключение для аутентификации пользователей, TLS для защиты сетевого трафика, интеграцию с LDAP/AD и централизованными системами аудита (Ranger/Sentry или аналогами). Также важно правильно настроить политики доступа к таблицам Iceberg через Iceberg-метаданные и к данным — на уровне файла и на уровне сервиса.
7) Как мигрировать данные и каталоги между типами?
Миграции обычно требуют:
- Экспорт существующих таблиц и схем;
- Создание аналогичных таблиц в целевом каталоге;
- Перемещение файлов данных и обновление метаданных Iceberg (snapshots, manifests);
- Тестирование на предмет корректности чтения и записи;
- Учет временных фаз, чтобы минимизировать простой.
Такая миграция может потребовать временного дубликата данных и полного тестирования на тестовом окружении.
8) Какие практики мониторинга и эксплуатации каталогов рекомендуются?
Рекомендуются:
- Включение детального логирования Iceberg и Metastore и сбор метрик через Prometheus/JMX;
- Мониторинг задержек на чтение/запись метаданных и частоты обновления метаданных;
- Регулярное резервирование и тестовые откаты версии таблиц;
- Оценка производительности сканирования и оптимизация файлового формата (Parquet/ORC) и настройки чтения;
- Регулярная проверка прав доступа и аудит изменений в каталогах.
9) Как обстоит вопрос локализации данных в российских проектах?
В российских проектах часто применяется локальная инфраструктура: Hive Metastore внутри дата-центра, Kerberos, локальные хранилища (HDFS или аналогичные S3-совместимые хранилища в частном облаке). Это обеспечивает соответствие требованиям локализации и регулятивным нормам, позволяет интегрировать Iceberg с существующим корпоративным стеком и упрощает аудит данных.
10) Какие шаги можно предпринять прямо сейчас, чтобы начать работу с каталогами в Spark?
- Определите текущую инфраструктуру и требования к каталогу: нужен ли Hive Metastore, допускается ли локальное хранение метаданных.
- Выберите тип каталога, который соответствует требованиям.
- Настройте SparkSession с нужными параметрами каталогов.
- Создайте тестовую Iceberg-таблицу и проверьте чтение/запись.
- Включите мониторинг и аудит, настройте безопасность.
- Планируйте миграции и резервирования для перехода на новые версии Iceberg/ Spark.
FAQ — Вопрос–Ответ (на основе материала)
1) В чем принципиальная разница между HiveCatalog и HadoopCatalog?
HiveCatalog опирается на Hive Metastore для регистрации и управления схемами и именами таблиц, что упрощает интеграцию в существующую инфраструктуру Hive, а HadoopCatalog хранит только метаданные Iceberg в файловой системе без внешнего метастора. HadoopCatalog проще в настройке и хорош для локальных проектов, но HiveCatalog предоставляет более богатый функционал управления метаданными и интеграцию с существующим стеком безопасности.
2) Что дает RESTCatalog и когда его целесообразно использовать?
RESTCatalog предоставляет централизованный доступ к метаданным Iceberg через REST API. Он подходит для мультиоблачной архитектуры, где метаданные могут обслуживаться отдельной службой, что упрощает масштабирование и единый доступ к набору таблиц. Важные моменты — доступность REST-сервиса и необходимость TLS/аутентификации.
3) Какую роль играет конфигурация spark.sql.catalog в Spark?
Эта конфигурация задает, какой каталог используется для доступа к Iceberg и как он реализован (Hive, Hadoop, REST и т. д.). Она позволяет Spark адресовать таблицы Iceberg через указанный каталог, поддерживая несколько каталогов в рамках одного приложения.
4) Какие риски чаще всего возникают при внедрении каталогов в Iceberg?
Наиболее частые риски — сбои внешних сервисов (Metastore, REST-сервис), проблемы совместимости версий между Iceberg и Spark, сложности с безопасностью и аудитом, затраты на мониторинг и резервирование, а также проблемы миграции между каталогами при эволюции инфраструктуры.
5) Какие меры безопасности критически важны при работе с каталогами?
Критически важны Kerberos-авторизация и TLS-шифрование для всех взаимодействий, интеграция с LDAP/AD для управления пользователями и группами, настройка политик доступа на уровне данных и метаданных (через Ranger/Sentry или эквивалент), а также защита секретов и ключей доступа к хранилищам.
6) Как выбрать между локальным HadoopCatalog и HiveCatalog для нового проекта?
Если у вас уже есть Hive Metastore и вы хотите единый контроль через существующий стек, HiveCatalog — разумный выбор. Если же проект локален и автономен без необходимости внешнего Metastore, HadoopCatalog может оказаться проще и быстрее в развёртывании.
7) Что нужно проверить перед миграцией каталога?
План миграции должен включать аудит текущих таблиц, совместимость версий Iceberg и Spark, стратегию переноса метаданных, резервное копирование, тестовую миграцию в тестовой среде и план минимизации простоя, а также обеспечение аудита и безопасности на обоих этапах.
8) Какие практики помогут лучше мониторить каталоги Iceberg?
Логируйте и собирайте метрики операций по чтению/записи метаданных, мониторьте задержки в обновлении метаданных, устанавливайте оповещения на аномальные паттерны, используйте распределённый трейсинг, чтобы отслеживать время выполнения операций над таблицами Iceberg.
9) Какие преимущества Iceberg Catalog приносит Spark-проектам?
Каталоги позволяют централизовать доступ к множеству Iceberg-тables, обеспечить единое пространство имен, поддерживать транзакции и версионность, упрощают миграцию между окружениями и обеспечивают безопасность метаданных, что критично для крупных бизнес-аналитических систем.
10) Как начать работу с каталогами при ограниченном времени?
Начните с выбора типа каталога, подходящего вашей инфраструктуре; настройте минимальный SparkSession с каталогом; создайте небольшую тестовую таблицу и выполните полный цикл чтения/записи; включите мониторинг и аудит; постепенно расширяйте использование каталогов на продакшн-слой.
Итак, вы получили подробную главу о интеграции каталогов с Spark в рамках Iceberg Lakehouse: как каталоги устроены, какие типы существуют, как их настраивать и какие риски учитывать. Практические примеры дают вам конкретные шаги по настройке и использованию в разных сценариях, включая открытые решения и локальные российские практики, а FAQ поможет быстро освежить ключевые моменты.


