

Создание и управление таблицами через каталог
Создание и управление таблицами через каталог представляет одну из ключевых задач современного дата-латы Iceberg Lakehouse. Каталог в рамках Iceberg — это не просто место, где хранятся метаданные таблиц. Это механизм организации пространств имен (неймспейсов), доступа к ним и маршрутизации запросов к конкретным наборам файлов данных и их схемам. В рамках курса вы узнаете, как проектируются и эксплуатируются каталоги, какие типы каталогов существуют, какие операции можно выполнять через каталог, как выбирать подходящий тип каталога под задачи вашей команды, какие риски связанные с каталогами следует учитывать и какие практические примеры применяемых решений применимы в открытой экосистеме и в российской инфраструктуре.
Цель этой главы — дать новичку полное представление о принципах создания и управления таблицами через каталог, показать реальную практику на примерах с использованием открытых решений и описать типовые сценарии внедрения в российской среде. Мы разберем термины и концепции, пройдемся по методологиям проектирования неймспейсов и таблиц, а также рассмотрим вопросы безопасности, мониторинга и устойчивости к изменениям схемы. В конце главы вы найдете раздел FAQ с вопросами и подробными ответами, которые закрепят ваши знания и подготовят к реальным задачам.
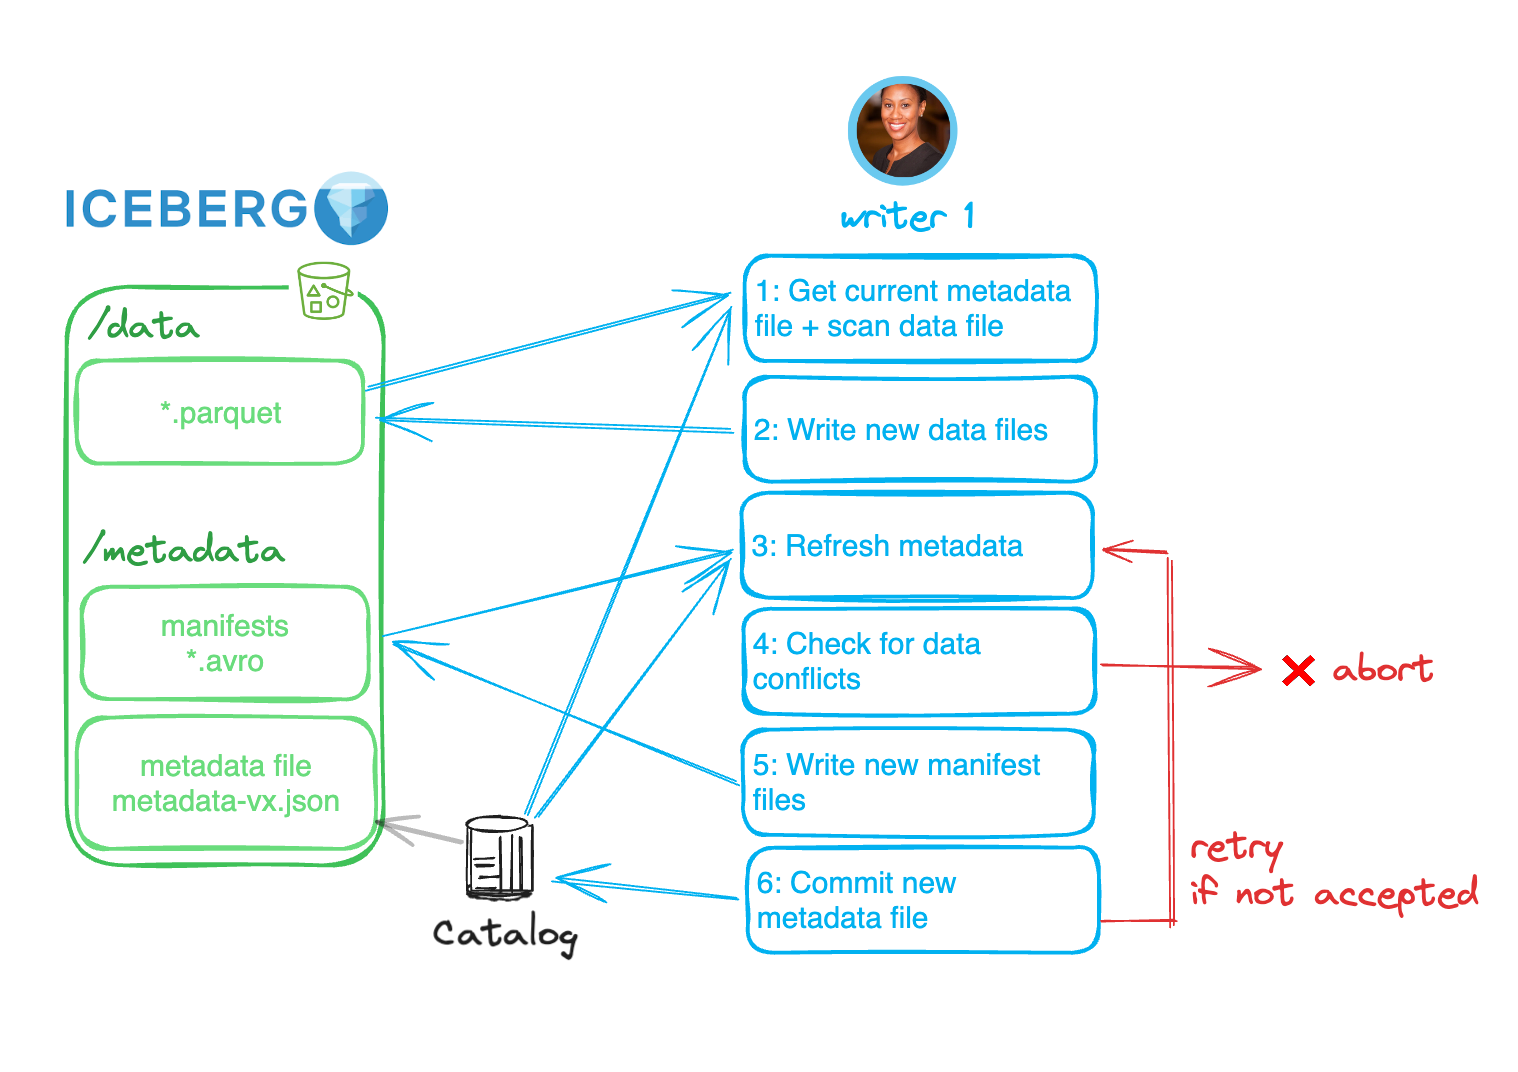
Что такое каталог в Iceberg и зачем он нужен
Iceberg — это таблица уровня Lakehouse, которая хранит метаданные таблиц отдельно от самих файлов данных и обеспечивает концепции ACID, схеми разделения эволюции, версии метаданных и безопасного чтения. Каталог — это компонент, через который Iceberg узнает, где именно лежат метаданные конкретной таблицы, как к ней обращаться, как найти схему, копии файлов и какие правила распространить на чтение и запись. Каталог управляет неймспейсами (базами данных в рамках Iceberg) и таблицами внутри них, а также точками доступа к их метаданным.
Термины и базовые концепции
- Каталог (Catalog): механизм регистрации неймспейсов и таблиц, а также способ доступа к их метаданным. Каталог выбирается как источник метаданных и определяет, как и где Iceberg хранит и ищет информацию о таблицах.
- Неймспейс/база данных (Namespace/Database): логическое разделение таблиц в каталоге, позволяет структурировать множество таблиц и обеспечивать управляемость.
- Таблица Iceberg: набор файлов данных (форматы Parquet/ORC/Avro и т. п.) и связанных с ними файлов метаданных (метаданные,Manifests, metadata.json и последующие версии).
- metadata.json: основной файл метаданных таблицы, который хранит сведения о схеме, разделе таблицы, политике разделения и других параметрах.
- manifest-файлы: список данных и их местоположения; Iceberg использует манифесты для эффективного чтения и фильтрации при выполнении запросов.
- Partition spec (список разделов): определяет, как распарсить и организовать данные по разделам (например, по дате, по клиенту и т. д.).
- Schema evolution (эволюция схемы): процесс добавления, удаления или изменения полей таблицы без потери совместимости с существующими данными.
- Transactional semantics: Iceberg обеспечивает транзакционность на уровне таблицы, что важно для согласованности данных в распределенной среде.
- Типы каталогов: HiveCatalog, HadoopCatalog, REST Catalog, NessieCatalog и другие варианты в зависимости от версии Iceberg и используемой экосистемы.
- Метаданные и безопасность: каталоги обычно поддерживают механизмы контроля доступа, интеграцию с Kerberos/LDAP, аудит и другой функционал управления доступом к данным.
Типы каталогов и принципы их использования
- HiveCatalog: наиболее распространенный и широко поддерживаемый в составе Apache Hadoop-экосистемы. Для работы с HiveCatalog Iceberg использует Hive Metastore (Metastore) как источник информации о базах данных и таблицах. Это позволяет централизованно управлять схемами и неймспейсами и обеспечивает совместимость с существующими процессами обработки данных в экосистемах Hadoop и Spark.
- HadoopCatalog: каталог, который хранит все метаданные в файловой системе (обычно в каталоге warehouse), без необходимости внешнего Hive Metastore. Это упрощение развертывания и хорошо подходит для локальных тестовых окружений или сценариев, где метаданные должны быть автономны от внешнего сервиса.
- REST Catalog: поддерживает централизованный доступ к каталогу через REST API. Это позволяет различным сервисам и клиентам общаться с каталогом независимо от языка и окружения и обеспечивает удобство развертывания в облаке и контейнеризованных средах.
- Nessie Catalog: проект Nessie обеспечивает консистентный и распределяемый каталог как сервис. Nessie предоставляет единый источник истины для всех таблиц и неймспейсов, поддерживая версии и схемы, позволяя нескольким сервисам параллельно работать с таблицами и безопасно управлять эволюцией схемы.
- Другие варианты: в зависимости от версии Iceberg и окружения могут существовать локальные расследования по поддержке облачных каталогов (AWS Glue Catalog и т. д.). В рамках российского контекста часто рассматривают HiveCatalog и HadoopCatalog в сочетании с локальными Metastore и локальной файловой системой, чтобы соответствовать требованиям локализации данных.
Методологии проектирования каталогов
- Выбор типа каталога: для крупных корпоративных инфраструктур с существующим Hive Metastore и центрами данных на базе Hadoop чаще выбирают HiveCatalog. Для полностью облачных или мультиоблачных сред может быть предпочтительным REST Catalog или Nessie Catalog для упрощения управления версиями и координации между сервисами.
- Архитектура неймспейсов и неймсток (namespace design): проектирование неймспейсов должно учитывать организации и бизнес-подразделения, данные по бизнес-доменам, требования к безопасному доступу и атрибутику. Хорошая практика — отделять данные по доменам и отделам, чтобы упростить управление правами доступа и хранение политики.
- Управление версиями и эволюцией схем: Iceberg поддерживает безопасную эволюцию схемы таблицы без прерывания чтения/записи. Он позволяет добавлять или удалять столбцы, изменять типы и формат данных, сохраняя совместимость с существующими данными. Важна политика миграции и регламент обновления для минимизации риска.
- Безопасность и соответствие требованиям: в корпоративной среде каталоги должны быть интегрированы с существующими механизмами идентификации и авторизации (Kerberos, LDAP/AD), аудитом, политиками шифрования и управления ключами. Это критично для российских проектов, где требования по локализации и контролю доступа особенно жесткие.
- Мониторинг и операционная устойчивость: рекомендуется внедрить мониторинг состояния каталога, доступности Hive Metastore (или Nessie REST сервиса), журналирование операций изменения схемы и политики доступа. Также стоит рассмотреть резервное копирование метаданных и возможность быстрого восстановления.
- Миграции и переходные сценарии: если у вас уже есть существующая структура данных без Iceberg, планируйте миграцию в несколько этапов: создать каталоги и базы данных-микрослужбы, перенести через временные таблицы, проверить совместимость и обратить внимание на совместимость форматов. В условиях локальной инфраструктуры это позволяет минимизировать риск.
Практические примеры
Общие принципы работы через каталог
1) Пример на открытом исходном коде: использование HiveCatalog через Spark
Контекст: у вас есть существующий Hive Metastore, доступный в вашем кластере. Вы хотите создать новую таблицу Iceberg и управлять ей через HiveCatalog.
Конфигурация и настройка:
На стороне Spark указываем каталог Iceberg как Hive Catalog:
    spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
    spark.sql.catalog.my_catalog.type = hive
    spark.sql.catalog.my_catalog.uri = thrift://metastore-host:9083
Создаем базу данных и таблицу:
    CREATE DATABASE IF NOT EXISTS my_catalog_db;
    USE my_catalog_db;
    CREATE TABLE my_catalog_db.orders (
        order_id BIGINT,
        customer_id INT,
        order_date DATE,
        amount DECIMAL(10,2)
      )
      USING ICEBERG
      PARTITIONED BY (order_date);
Как это работает: Iceberg хранит метаданные таблицы в метасторе Hive и сам набор файлов данных в файловой системе (обычно HDFS). Запросы Spark будут использовать Catalog для обращения к metadata и чтения данных.
Преимущества: единая точка консистентности через Hive Metastore, удобство миграции существующих проектов, интеграция с уже настроенной авторизацией и безопасностью.
Что проверить: доступность Hive Metastore, валидность схемы и разделение, корректность чтения после выполнения операций DDL.
2) Пример на открытом исходном коде: Nessie REST Catalog
Контекст: вы используете Nessie как централизованный REST-каталог, который хранит версии схем и таблиц.
Основные шаги:
Развернуть Nessie в тестовом окружении (например, через docker-compose) и поднять сервис Metastore-совместимого уровня для Iceberg.
Настроить клиентскую часть на использование Nessie как каталога:
    iceberg.catalog.nessie = com.netflix.iceberg.catalog.NessieCatalog
    iceberg.catalog.nessie.uri = http://nessie-host:19120
Создать базу данных и таблицу:
    CREATE TABLE nessie_catalog_db.sales (...)
      USING ICEBERG
      PARTITIONED BY (sale_date);
Преимущества: версии схем и таблиц отслеживаются в Nessie, упрощается параллельная работа нескольких команд, можно откатиться к предыдущей версии схемы.
Что проверить: согласованность версий, доступность Nessie, корректность работы с миграциями схем.
3) Пример на открытом исходном коде: HadoopCatalog (локальная файловая система)
Контекст: упрощенный сценарий для локального тестирования или небольших проектов без внешнего Hive Metastore.
Конфигурация и работа:
В Spark указать тип каталога как Hadoop и указать путь к warehouse:
    spark.sql.catalog.my_catalog = org.apache.iceberg.spark.SparkCatalog
    spark.sql.catalog.my_catalog.type = Hadoop
    spark.sql.catalog.my_catalog.warehouse = file:///tmp/iceberg/warehouse
Создать таблицу:
CREATE TABLE my_catalog.orders (...) USING ICEBERG PARTITIONED BY (order_date);
Преимущества: простота развёртывания, отсутствие зависимостей от внешних сервисов.
Ограничения: ограниченная функциональность по управлению метаданными и безопасность по сравнению с HiveMetastore или Nessie.
Российские решения и локальные сценарии
Важно подчеркнуть: в российской инфраструктуре часто встречаются требования локализации данных, ограничений по доступу к внешним сервисам и требования к соответствию регуляторным нормам. Ниже приведены типовые подходы и примеры, ориентированные на отечественные условия, без привязки к конкретным коммерческим продуктам.
Пример 4. Локальная развертка Hive Metastore и Iceberg в отечественном дата-центре
- Архитектура: Hive Metastore развернут локально на российских серверах; база данных Metastore может быть PostgreSQL или MySQL, доступ к нему ограничен корпоративной сетью; Iceberg работает через HiveCatalog.
- Безопасность: Kerberos для аутентификации пользователей, LDAP/AD для управления учетными записями, интеграция с корпоративной системой аудитирования; сеть между кластерами ограничена через firewall; данные в HDFS или локальной файловой системе с шифрованием на уровне диска.
- Практика: создаете базу данных и таблицы через Hive Metastore, управляете схемами и разделами через Iceberg, применяете политики хранения и резервного копирования метаданных.
- Преимущества: полная локализация данных, соответствие требованиям к хранению и аудиту, совместимость с существующими процессами и пользователями.
- Ограничения: требования к администрированию Hive Metastore и к настройкам Kerberos/LDAP, дополнительные затраты на поддержание локального имени пространства и резервного копирования.
Пример 5. REST/Nessie-каталог внутри отечественной инфраструктуры
- Архитектура: Nessie-развертывание внутри локального дата-центра; доступ к Nessie ограничен через внутреннюю сеть; Iceberg в клиентах (Spark/Flink) настраиваются на использование NessieCatalog.
- Безопасность: аналогично — Kerberos/LDAP, сетевые ограничения, аудит, контроль версий.
- Практика: управление версий схем и таблиц для нескольких команд и проектов, координация изменений через единый сервис.
- Преимущества: централизованная координация без зависимости от внешних облачных сервисов, явная история изменений, упрощенная миграция между окружениями.
- Ограничения: потребность в стабильном Nessie-сервисе, поддержка на уровне клиентских коннекторов, адаптация к локальным требованиям к сетям и доступности.
Структура метаданных и эволюция схем
Метаданные Iceberg разделяются на несколько уровней и файлов:
- metadata.json: корневой файл метаданных таблицы, который описывает схему, политики разделения, порядок чтения и записи, чистку версий и прочие параметры.
- manifest-файлы: списки файлов данных и их местоположения; каждый манифест относится к определенному набору файлов и содержит информацию о строках и разделах.
- data файлы: сами файлы данных в Parquet/ORC/Avro и их местоположения в warehouse/partition directories.
Эволюция схемы и разделов:
- Iceberg поддерживает безопасное добавление столбцов, изменение типов, добавление/изменение разделов и другие изменения без прерывания существующих запросов.
- При изменениях Iceberg сохраняет версии metadata.json и соответствующие манифесты, чтобы можно было откатиться к любой предыдущей версии схемы.
Хранение данных и формат файлов
- Iceberg поддерживает Parquet, ORC и Avro. Выбор формата зависит от вашей экосистемы (Spark, Flink, Presto) и требований к сжатию, скорости чтения и поддержки типов.
- Данные физически хранятся в файловой системе (HDFS, S3, локальная файловая система), а метаданные — в каталоге каталога и в Hive Metastore/Nessie.
- Применение фильтров и чтение файлов происходят через метаданные и манифесты, что позволяет Iceberg эффективно пропускать файлы, не читая их.
Безопасность и доступ к каталогам
- Интеграция с Kerberos/LDAP: архитектура каталога позволяет внедрять централизованную аутентификацию и авторизацию, что особенно важно для корпоративной и государственной инфраструктуры.
- Разделение доступа на уровне неймспейсов и таблиц: можно задавать политики доступа на уровне неймспейса и конкретной таблицы, ограничивая доступ отдельных команд.
- Аудит и журналирование: в целом реализуется через средства аудита к Hive Metastore, Nessie или через регистрируемые события в менеджерах инфраструктуры.
Мониторинг и управление производительностью
- Мониторинг состояния каталога, доступности Hive Metastore или Nessie, производительности чтения и записи метаданных.
- Мониторинг размера и количества файлов metadata, манифестов и таблиц для планирования миграций и масштабирования.
- Резервное копирование и восстановление: рекомендуется разрабатывать планы резервного копирования для метаданных (metadata.json и Hive Metastore) и данных, включая тестовые сценарии восстановления.
Риски и ограничения внедрения
- Зависимость от внешних сервисов: Hive Metastore, Nessie или REST Catalog — их отказ может повлиять на доступ к таблицам. Необходимо иметь планы отказоустойчивости и репликации метаданных.
- Совместимость версий: обновления Iceberg и связанных сервисов могут приводить к несовместимостям в формате метаданных, поэтому важно тестировать обновления в стенде перед продакшном.
- Безопасность и локализация данных: в российских условиях часто требуется строгая локализация и соответствие регуляторным требованиям; внедрение должно учитывать требования к сетям, аудиту и хранению данных.
- Сложность интеграции: интеграция каталога с существующими системами (неймспейсы, роли, политики) может быть непростой и потребовать доработок в процессах деплоймента и операционного управления.
- Производительность метаданных: плохо спроектированная архитектура каталогов может привести к задержкам при больших числах таблиц и частых изменениях схем. Необходимо планировать и тестировать баланс между количеством таблиц и эффективностью метаданных.
Создание и управление таблицами через каталог — это фундаментальная практика для эффективной организации и управления данными в Iceberg Lakehouse. Каталоги предоставляют структурированную и масштабируемую схему хранения метаданных, позволяют централизовать управление неймспейсами и таблицами, обеспечивают возможность безопасной эволюции схемы и разделения данных, а также выступают связующим звеном между обработчиками данных (Spark, Flink, Presto) и файловым хранилищем. Выбор типа каталога зависит от вашей инфраструктуры, требований к локализации данных, существующих сервисов метаданных и требований к безопасности. В открытой экосистеме у вас есть богатый набор инструментов: HiveCatalog, HadoopCatalog, Nessie Catalog и REST Catalog — каждый со своими преимуществами и сценариями применения. В российской инфраструктуре часто встречаются сценарии локального развёртывания Hive Metastore и локальных Nessie-каталогов, что позволяет обезопасить данные, соответствовать локальным требованиям и обеспечить контроль доступа.
FAQ (Вопрос–Ответ)
1) Что такое каталог Iceberg и чем он отличается от простого хранения таблицы?
Каталог Iceberg — это системный уровень, который управляет неймспейсами и таблицами, хранит ссылки на метаданные и обеспечивает связь между таблицами и их физическими файлами. В отличие от обычной файловой структуры, каталог хранит структуры, версии схем и разделов, версии метаданных и обеспечивает безопасный доступ к данным, координацию между сервисами и поддержку эволюции схемы без потери данных.
2) Какие типы каталогов доступны и как выбрать подходящий?
Доступны HiveCatalog (через Hive Metastore), HadoopCatalog (локальная файловая система), REST Catalog (через REST API), Nessie Catalog (сервис Nessie для версий метаданных). Выбор зависит от ваших требований: нужна ли централизованная версия схем (Nessie), нужна ли интеграция с Hive Metastore (HiveCatalog), нужна локальная автономная работа без внешних сервисов (HadoopCatalog). В крупных корпоративных проектах часто применяют HiveMetastore + Nessie или REST Catalog для удобства управления версиями и совместной работы.
3) Как создать таблицу через каталог?
Сначала выберите каталог и настройте соответствующую конфигурацию клиента (Spark/Flink) на использование этого каталога. Затем выполните DDL, например: CREATE TABLE catalog.db.table (колонки...) USING ICEBERG PARTITIONED BY (...). Iceberg создаст необходимые метаданные и укажет местоположение файлов данных. В зависимости от типа каталога команда может немного отличаться по параметрам конфигурации, но общая идея одинакова: создание таблицы через указанный каталог.
4) Как управлять неймспейсами и таблицами?
Через SQL DDL (CREATE DATABASE/CREATE SCHEMA), команды SHOW DATABASES/SHOW TABLES, и DDL-команды ALTER/RENAME/DROP. Многие клиенты Iceberg поддерживают DDL экосистем Spark/Flink и позволяют перечислять неймспейсы, создавать новые пространства имен и упорядочивать таблицы по бизнес-областям.
5) Какие риски связанны с внедрением каталогов?
Основные риски: отказ внешних сервисов (Hive Metastore, Nessie), несовместимости версий между Iceberg и каталогами, сложности управления безопасностью и аудитом, возможные задержки в работе при огромном количестве таблиц и часто меняющихся схемах, а также требования к локализации данных и соответствие регуляторам в рамках российского рынка. Решения включают резервирование, мониторинг, тестовые стенды и план миграций, а также разумную архитектуру неймспейсов и политик доступа.
6) Как обеспечить безопасность и доступ к каталогам?
Интеграция с Kerberos/LDAP для аутентификации, настройка ролей и политик доступа на уровне неймспейсов и таблиц, аудит действий и мониторинг доступа к каталогу. В российских условиях это особенно важно — обеспечение локализации данных и соблюдение регуляторных требований. В реальных проектах часто используют Kerberos + LDAP, шифрование на уровне дисков и сетевые ограждения.
7) Как мигрировать существующие данные в Iceberg через каталог?
План миграции обычно включает: создание нового каталога и баз данных, миграцию схем через эволюцию, поэтапную миграцию таблиц и данных, валидацию совместимости и тестовый прогон. В случае больших наборов данных рекомендуется выполнить миграцию в тестовом окружении, проверить производительность и корректность запросов, затем постепенно перенести в продакшн, сохраняя возможность отката.
8) Какие практики мониторинга и резервирования стоит внедрить?
Мониторинг доступности метаданных, состояния Hive Metastore/Nessie, журналирования изменений схем, мониторинг количества таблиц и манифестов, резервное копирование metadata.json и Metastore базы данных, проверку целостности файлов на хранении данных и репликацию в случае отказа узлов. Регулярно тестируйте восстановление из резервной копии и план действий на случай аварий.
9) Как поддерживать эволюцию схем и разделов без потери совместимости?
Iceberg поддерживает безопасную эволюцию схемы (добавление столбцов, изменение типов, удаление полей) и изменение разделов. Важна политика релизов и миграций: выносить изменения в новой версии таблицы, тестировать совместимость чтения между версиями и поддерживать обратную совместимость на период перехода.
10) Где искать официальную документацию и дополнительные примеры?
Официальную документацию Iceberg можно найти на сайте проекта и в репозитории GitHub. Там содержатся актуальные инструкции по настройке конкретныхCatalog-типов, примеры конфигураций и инструкций по миграциям. Также рекомендуется проследить за блогами и примерами по Spark/Flink/Trino, чтобы подобрать примеры под вашу технологическую стековую конфигурацию.
Создание и управление таблицами через каталог — это ключ к устойчивому, масштабируемому и управляемому дата-лэйку Iceberg Lakehouse. Правильный выбор типа каталога, грамотное проектирование неймспейсов и таблиц, а также внедрение безопасных, мониторируемых и документированных процессов позволят вашей команде работать эффективно и безопасно в условиях растущего объема данных и требований к соответствию регуляторным нормам.


