

SCD Type 1 перезапись и отсутствие истории
SCD (Slowly Changing Dimensions) — это понятие, которое часто встречается при проектировании хранилищ данных и моделях измерений. Оно описывает, как хранить изменяющиеся атрибуты измерений во времени. Одним из базовых подтипов SCD является Type 1: перезапись и отсутствие истории. Этот подтип применяется, когда нам не нужна историческая цепочка значений атрибута: важно сохранять только текущее состояние объекта. Например, телефонный номер клиента, адрес электронной почты или зафиксированное название товара — если изменения происходят часто, но историческая справка не требуется, Type 1 может быть оптимальным выбором. Эта глава призвана помочь новичку в вашей компании понять, что такое SCD Type 1, какие инженерные подходы применяются на практике, как реализовать перезапись в разных окружениях и какие риски сопровождают такой подход.
Определения и базовые понятия
- SCD или Slowly Changing Dimensions — это концепция управления изменениями в измерениях, где со временем меняются характеристики объектов бизнес-контекста (клиенты, продукты, локации и т. п.).
- Type 1 (Перезапись, отсутствие истории) — подход, при котором любое изменение атрибутаdimension заменяет старое значение новым, при этом никакой цепочки изменений не сохраняется. В результате в таблице измерения остаётся только текущее состояние. История изменений не сохраняется.
- Dimension таблица — таблица, содержащая атрибуты измерений и служащая для удобного анализа. Часто в схеме звездой dimension имеет внешнюю связь с фактами через суррогатный ключ, но для Type 1 сам факт наличия истории исчезает.
- Surrogate-key (суррогатный ключ) — искусственный первичный ключ (например, целое число), который используется внутри хранилища для уникальной идентификации каждой версии записи, независимо от бизнес-ключа. В Type 1 суррогатный ключ обычно сохраняется без изменений при обновлении записи, а смена бизнес-ключа может потребовать соответствующего поведения.
- Natural-key (естественный ключ) — бизнес-ключ, по которому уникально идентифицируются сущности вне хранилища (например, customer_id, product_sku). В Type 1 на него ориентируются для определения того, какие записи нужно перезаписать.
- Upsert (upsert) — объединение операций вставки и обновления: если запись существует — обновляется ее содержимое; если нет — вставляется новая. В разных СУБД реализуется разными командами (MERGE, INSERT ... ON CONFLICT DO UPDATE и т. п.).
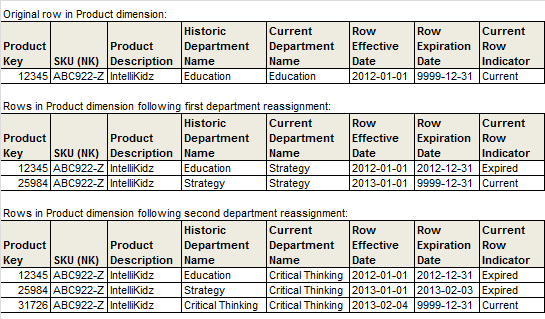
- История против текущего состояния — в Type 1 история отсутствует, в других типах SCD история сохраняется: Type 2 сохраняет каждую версию, Type 3 сохраняет ограниченную историю в полях версии и т. п.
Когда использовать Type 1
- Атрибуты, которые считаются текущими и не требуют аудита изменений: адрес клиента, номер телефона, текущий статус, код города и т. д.
- Атрибуты, для которых прошлые значения не нужны для аналитики, соответствия или регуляторных требований.
- Ускорение запросов и упрощение моделей: поскольку не требуется хранить историю, операции обновления обычно быстрее, а схему проще.
- В сценариях, где изменения происходят часто и автоматической очисткой версии управлять проще, чем хранить их.
Преимущества и ограничения
Преимущества Type 1:
- Простота реализации: не нужно проектировать и поддерживать историю, достаточно заменить значения в текущем ряде.
- Производительность: меньшая нагрузка на запись при отсутствии версии и сложных временных операторов.
- Простота аналитики: запросы к текущему состоянию понятны и прямолинейны.
Ограничения и риски:
- Потеря истории: невозможно восстановить прошлые значения атрибута или понять, как менялись данные во времени.
- Регуляторные требования: для некоторых областей может потребоваться сохранение изменений и аудита.
- Сложность в объединении с фактами: если в каком-то отчёте нужна история, Type 1 требует доп. архитектурных решений или слоёв.
- Риск неконсистентности: параллельные загрузки без идемпотентности могут привести к конфликтам и дублированию.
Методологии реализации
- Базовый подход через upsert: при загрузке данных из источника проверяем наличие записи по естественному ключу. Если запись существует — обновляем значения полей, если нет — вставляем новую. В результате в таблице держится только одно актуальное состояние по каждому ключу.
- Уменьшение количества обновлений: чтобы не производить обновление, можно вычислять контрольную сумму (хэш) значений изменяемых полей и сравнивать с текущим значением в хранилище; если хэши совпадают — пропуск обновления.
- Точное «как можно более атомарно» — использовать механизмы транзакций (ACID) СУБД: если один источник обновляет несколько атрибутов, лучше выполнять единственный оператор upsert или несколько связанных команд в рамках транзакции.
- Архитектурное разделение: хранение текущего состояния в одной таблице Dimension, а истории — в другой (например, отдельная таблица history). Но в рамках Type 1 история не требуется, поэтому можно обходиться только текущим состоянием. В случаях, когда в будущем возможно переход к Type 2, можно заложить архитектуру так, чтобы минимизировать переработку: добавлять отдельную «историческую» таблицу и хранить текущую копию в основной dimension. Такой подход облегчает миграцию, но требует дополнительных расходов на поддержание синхронизации.
Практические примеры
Пример 1: реализация Type 1 в PostgreSQL (open-source)
Сценарий: у нас есть таблица источника customers_src с полями customer_id (естественный ключ), name, address, email. Нужно привести dimension-таблицу dim_customer к текущему состоянию по каждому customer_id. В dim_customer уже есть суррогатный ключ (customer_key), но для Type 1 мы сохраняем его и обновляем остальные поля.
Схема dim_customer:
customer_key BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY
customer_id TEXT UNIQUE NOT NULL
name TEXT
address TEXT
email TEXT
updated_at TIMESTAMP WITHOUT TIME ZONE
Схема источника (для понимания процесса):
customer_id TEXT
name TEXT
address TEXT
email TEXT
source_load_ts TIMESTAMP
Процесс до загрузки:
- Загружаем новые данные в staging table: customers_stg (customer_id, name, address, email, source_load_ts)
SQL-процесс upsert:
- В PostgreSQL можно использовать конструкцию INSERT ... ON CONFLICT DO UPDATE. Пример:
INSERT INTO dim_customer (customer_id, name, address, email, updated_at)
VALUES ('C123', 'Иванов Иван', 'ул. Пушкина, д. 10', 'ivanov@example.ru', NOW())
ON CONFLICT (customer_id) DO UPDATE
SET name = EXCLUDED.name,
address = EXCLUDED.address,
email = EXCLUDED.email,
updated_at = EXCLUDED.updated_at;
Как это работает:
- Если запись с данным customer_id уже есть в dim_customer, выполняется обновление полей name, address, email и updated_at.
- Если такой записи нет, создаётся новая запись с новым surrogate key и указанными полями.
- История не сохраняется: предыдущие значения заменяются новыми.
Практический комментарий:
- В реальных системах можно сначала загрузить в staging, затем выполнить MERGE-подобную операцию (если база поддерживает MERGE) или пакетно выполнить upsert, чтобы минимизировать число операций. В PostgreSQL отдельный подход через time-stamped обновления может быть полезен, если в будущем всё же планируется переход к Type 2. Но для чистого Type 1 достаточно upsert-операции на уровне естественного ключа.
Пример 2: реализация Type 1 через MERGE (на базе Snowflake, BigQuery, SQL Server поддерживают MERGE)
Условие: ваша СУБД поддерживает оператор MERGE. Нужно выполнить слияние между staging-данными и текущей dimension-наборке по естественному ключу. Результат аналогичен upsert, но абстракция MERGE может быть удобнее для больших наборов данных и обеспечивает единый атомарный паттерн.
Пример общего вида:
MERGE INTO dim_customer AS t
USING customers_stg AS s
ON (t.customer_id = s.customer_id)
WHEN MATCHED THEN UPDATE SET
t.name = s.name,
t.address = s.address,
t.email = s.email,
t.updated_at = CURRENT_TIMESTAMP
WHEN NOT MATCHED THEN INSERT (customer_id, name, address, email, updated_at)
VALUES (s.customer_id, s.name, s.address, s.email, CURRENT_TIMESTAMP);
Пример 3: реализация Type 1 в Delta Lake (open-source, на базе Apache Spark)
Delta Lake поддерживает upsert через MERGE INTO, что удобно в рамках больших массивов данных и ELT-подходов. Это пример для сценария «популярно в открытом стеке».
- Предположим, у нас есть таблица dim_customer в Delta формате и staging-таблица delta_staging_customer.
- Запрос MERGE INTO dim_customer AS t USING delta_staging_customer AS s ON t.customer_id = s.customer_id
WHEN MATCHED THEN UPDATE SET t.name = s.name, t.address = s.address, t.email = s.email, t.updated_at = current_timestamp()
WHEN NOT MATCHED THEN INSERT (customer_id, name, address, email, updated_at) VALUES (s.customer_id, s.name, s.address, s.email, current_timestamp());
Практические заметки по Delta Lake:
- Delta поддерживает ACID-транзакции и время исполнения, что полезно для постоянной консистентности.
- Вы можете планировать MERGE как часть вашего ELT-пайплайна, используя dbt или PySpark.
- Для Type 1 здесь вы получаете единый подход к обновлениям с возможностью отражать изменения в рамках одной транзакции.
Пример 4: российские и локальные решения в контексте Type 1
- Яндекс.Облако и YaCloud: в рамках облачных платформ часто можно развернуть managed PostgreSQL или ClickHouse. Для Type 1 вы будете использовать Upsert-операции на естественном ключе. В YaCloud вы можете выбрать managed PostgreSQL и выполнять INSERT ... ON CONFLICT DO UPDATE или MERGE (если поддерживается конкретной версией). Russian-поддержка инфраструктуры делает такие подходы доступными с точки зрения локализации хранения данных, соответствия требованиям локализации и контрактной поддержки.
- ClickHouse (проект с открытым исходником, активно поддерживается в России): для реализации Type 1 можно использовать таблицы с подходящими механиками обновления через ReplacingMergeTree или через обновления, которые становятся доступны в новых версиях. В типичном сценарии для ClickHouse Type 1 достигается за счет использования одной основной таблицы с обновлением через операции REPLACE или создается вспомогательная «current» версия, которая всегда отражает текущее состояние. В реальных проектах часто комбинируют ETL-слой и материализованные представления для достигаемого эффекта. Важно помнить, что ClickHouse исторически строился как OLAP-решение и принципы обновления отличаются от транзакционных СУБД; планируйте обновления пакетно и тестируйте влияние на производительность.
Схема и моделирование
- Базовая архитектура Type 1: dim таблица с естественным ключом как уникальным индексом (или с уникальным ограничением). Суррогатный ключ может сохраняться для совместимости с факт-таблицами, но не требуется создавать новые версии в рамках Type 1. В большинстве моделей суррогатный ключ остаётся фиксированным для текущей записи и не изменяется при обновлениях.
- Хранение текущего состояния без истории часто требует либо отдельного столбца updated_at, либо поля last_updated, чтобы понимать, когда запись обновлялась в последний раз.
Индексы и производительность
- В Postgres: уникальный индекс на customer_id (естественный ключ). В идеале создать индекс на те атрибуты, которые чаще всего участвуют в фильтрах, например, по адресу или по email, если такие фильтры распространены на практике.
- В больших хранилищах: пакетная загрузка с минимизацией количества операций записи — идеальный путь. Используйте batch upsert с большим количеством строк за одну операцию.
- В Delta Lake и подобных системах: MERGE-процедуры работают лучше при больших объемах данных, однако нужно учитывать затраты на вычисление хэшей и логически объединение.
Контроль качества и аудит
- Даже если мы реализуем Type 1, полезно хранить лог загрузок и хотя бы одну колонку updated_at для понимания времени последнего обновления.
- При отсутствии истории полезно использовать отдельную логическую «точку входа» для источника, чтобы можно было отследить, когда и что именно было обновлено.
Обновление и транзакции
- В транзакционных СУБД (PostgreSQL, SQL Server, Oracle) обновления выполняются в рамках транзакции. Это обеспечивает атомарность: либо все обновления применяются, либо ничего не меняется.
- В распределённых и аналитических системах (Delta Lake, Apache Iceberg) обновления часто реализуются через MERGE, что позволяет гарантировать консистентность данных в рамках одной операции.
Советы по проектированию
- Определение кандидатов на Type 1: соберите список полей и согласуйте с бизнес-сторонами, какие атрибуты не требуют истории.
- Поддержка идемпотентности: архитектура загрузки должна обеспечивать повторную обработку без дублирования. Upsert с использованием уникального ключа естественного ключа обычно обеспечивает идемпотентность.
- План перехода: если в будущем может понадобиться хранение истории, заранее продумайте разделение текущего состояния и истории (например, dim_current и dim_history) — это упростит миграцию к Type 2 без значительных переработок.
- Валидация изменений: после загрузки можно сравнивать хэш-суммы строковых полей между исходной и целевой записью, чтобы не выполнять обновления, если значения не изменились.
Риски и ограничения
- Потеря истории и регуляторные требования: если ваша отрасль требует аудита и хранения изменений, Type 1 может не подходить. Перед выбором убедитесь, что потери истории допустимы.
- Производительность обновлений: частые обновления одной и той же записи могут привести к блокировкам и задержкам в больших системах. Рассмотрите пакетные обновления, индексацию и, при необходимости, миграцию к Type 2 или смешанному подходу.
- Сложности в аналитике: некоторые аналитические задачи, которые требуют времени изменений, будут невозможны или потребуют дополнительной архитектуры для эмуляции истории.
- Конфликты и дубликаты: в распределённых ETL-пайплайнах возможны гонки за запись в одну и ту же запись. Сделайте ETL-слой идемпотентным и предусмотрите повторную загрузку без изменения результата.
- Совместимость инструментов: разные СУБД реализуют upsert по-разному. Убедитесь в поддержке вашей платформой MERGE или INSERT ... ON CONFLICT DO UPDATE и согласуйте поведения в случае конфликтов.
- Управление версиями и тестирование: внедрите тесты на соответствие текущему состоянию таблицы после загрузки и регулярные проверки на дубликаты по естественным ключам.
- Масштабируемость: для очень больших наборов данных обновления могут быть ресурсоёмкими. Планируйте горизонтальное масштабирование, партиционирование и оптимизацию нагрузок.
SCD Type 1 — мощный и простой инструмент для ситуаций, когда актуальное состояние объекта важно, а история изменений не нужна. Внедрение требует ясного бизнес-обоснования, аккуратной реализации на уровне базы данных (upsert, уникальные ключи, индексы) и продуманного процесса ETL/ELT. В открытом источнике и в российской экосистеме есть устойчивые решения: PostgreSQL с INSERT ... ON CONFLICT DO UPDATE, MERGE в Snowflake/BigQuery/SQL Server и Delta Lake в контексте Apache Spark. Российские решения чаще всего опираются на YaCloud или Яндекс.Облако с поддержкой управляемых баз данных и анализом данных на базе открытых форматов (PostgreSQL, ClickHouse, Delta Lake). Выбор конкретного подхода зависит от объема данных, частоты обновлений, требований к регуляторике и степени готовности перейти к более сложным типам SCD в будущем. В любом случае, при проектировании Type 1 следует сфокусироваться на идемпотентности загрузок, качестве входных данных и прозрачности процессов обновления.
- Определяйтесь с атрибутами, требующими сохранения только текущего значения, и исключайте их из архитектуры, если история не нужна.
- Выбирайте инструмент и технику upsert, соответствующие вашей СУБД: PostgreSQL — INSERT ... ON CONFLICT DO UPDATE; поддерживаемые системы — MERGE.
- Планируйте архитектуру так, чтобы в перспективе можно было добавить Type 2 или смешанный подход без крупных переработок.
- Обеспечьте мониторинг и логирование обновлений: updated_at, источник загрузки, количество обновлённых записей.
- Тестируйте обновления на больших данных и в условиях задержек сети, чтобы гарантировать идемпотентность и корректность.
Вопрос–Ответ (FAQ)
1) Что такое SCD Type 1 и зачем он нужен?
SCD Type 1 — это метод хранения измерений, при котором любые изменения атрибутов приводят к перезаписи текущего значения, а история изменений не сохраняется. Он нужен, когда важна только текущая актуальная информация и нет требований к аудиту изменений. Пример: обновление адреса электронной почты клиента. Исторических версий значения не требуется, поэтому достаточно того, что хранится сейчас.
2) В чем разница между SCD Type 1 и Type 2?
Type 1 сохраняет только текущее состояние, не хранит прошлые значения. Type 2 сохраняет каждую версию записи в рамках отдельной версии (или строки) с временными метками, позволяя реконструировать изменение по времени. Type 2 полезен для анализа изменений во времени, аудита и регуляторных требований. Однако Type 2 требует более сложной модели и большего объёма данных.
3) Какие технические методы реализуют Type 1?
Наиболее распространены: upsert-процедуры (MERGE, INSERT ... ON CONFLICT DO UPDATE), пакетная загрузка staging-таблиц и обновление текущего состояния в dim-таблице. В Delta Lake можно выполнять MERGE INTO, что обеспечивает атомарность и удобство для больших объемов. В ClickHouse можно использовать подходы с ReplacingMergeTree или обновлениями через MV. Выбор зависит от используемой СУБД и инфраструктуры.
4) Какие риски связаны с применением Type 1 и как их минимизировать?
Риски: потеря истории и соответствия требованиям; потенциальная нагрузка на обновления при частых изменениях; возможность конфликтов в распределённых ETL-пайплайнах. Минимизация: заранее определите атрибуты без истории; используйте идемпотентные ETL-процессы; внедрите аудит изменений (updated_at, источник), поддерживайте логи загрузок; планируйте переход к Type 2 или смешанным подходам в будущем при необходимости.
5) Как выбрать подход в зависимости от СУБД?
- PostgreSQL: INSERT ... ON CONFLICT DO UPDATE или MERGE (если доступен в вашей версии).
- Snowflake / BigQuery / SQL Server: MERGE INTO обеспечивает единый атомарный паттерн upsert.
- Delta Lake (open-source): MERGE INTO позволяет реализовать Type 1 в рамках Spark-ETL.
- ClickHouse (российская экосистема): использовать ReplacingMergeTree или обновления через MV в соответствии с версией таблицы; планировать пакетные обновления и контролировать влияние на производительность.
6) Какие этапы внедрения рекомендуется пройти новичку?
- Определить список атрибутов, которые не требуют истории.
- Спроектировать таблицу dimension с уникальным естественным ключом и суррогатным ключом (при необходимости).
- Выбрать подход к загрузке: upsert через MERGE или INSERT ... ON CONFLICT.
- Реализовать тесты идемпотентности и проверку дубликатов.
- Настроить мониторинг обновлений (updated_at, логи, метаданные загрузок).
- Протестировать производительность на больших данных и при частых обновлениях.
- При необходимости спроектировать переход к Type 2 в будущем.
7) Нужно ли сохранять историю вообще, если мы используем Type 1?
Нет, если бизнес-тотребование явно не требует сохранения истории. Однако стоит заранее определить, какие сценарии аналитики всё же могут потребовать знания о прошлом значении атрибута. В случае сомнений можно рассмотреть гибридную архитектуру: основная таблица текущего состояния и отдельная таблица истории, чтобы постепенно перейти к более сложной модели (Type 2) в будущем.
8) Как тестировать ETL-процесс Type 1?
Покройте тестами ключевые сценарии: добавление новой записи, обновление существующей записи, отсутствие изменений (и, следовательно, отсутствие обновления), а также случаи дубликатов и ошибок источника. Включите контрольные примеры: данные с разными значениями атрибутов и убедитесь, что dim-состояние соответствует ожиданиям. Регулярно запускайте тесты на регрессии для предотвращения случайной потери значений.
9) Можно ли реализовать Type 1 без суррогатного ключа?
Да, но в рамках star-схемы суррогатный ключ часто упрощает связь фактов и измерений и обеспечивает устойчивость к изменению естественного ключа. Если вы решаете не использовать суррогатный ключ, вам нужно будет обеспечить уникальность по естественному ключу и потенциально управлять версионированием в другом слое. Выбор зависит от вашей архитектуры и потребностей аналитики.
10) Что рекомендуется для перехода к более сложным типам SCD в будущем?
Планируйте разделение текущих состояний и истории на разные таблицы (dim_current и dim_history) или внедрите таблицу истории внутри той же dimension, чтобы в будущем можно перевести часть атрибутов на Type 2 без значительных изменений в архитектуре. Важно предусмотреть контракт между источниками данных и хранилищем: какие поля можно обновлять, как хранить даты изменений, как обрабатывать ошибочные обновления и т. п.
SCD Type 1 — понятный и эффективный подход для сценариев, где важен только текущий вид данных и история изменений не требуется. Ваша задача как инженера — выбрать правильный инструмент под ваши требования, грамотно спроектировать таблицы и процессы загрузки, обеспечить идемпотентность и надежность, а также быть готовым к переходу к другим типам SCD в случае необходимости. Используйте открытые решения (PostgreSQL, Delta Lake) и современные российские экосистемы для эффективной реализации — это позволит вам строить надежные, понятные и масштабируемые хранилища данных.


