

SCD Type 3 ограниченная история через добавочные поля
SCD Type 3 ограниченная история через добавочные поля — это один из способов реализации сохранения истории в измерениях (dimension) с ограниченным числом изменений, которые мы хотим хранить. В практике analytics и хранилищ данных он применяется тогда, когда нужно увидеть последний известный прошлый значение для выбранного атрибута, но не требуется полная история всех изменений. Такой подход может быть удобен для бизнес-пользователей и аналитиков, которым важна возможность сравнить текущее значение атрибута с его предыдущим значением без усложнения модели и без резкого разрастания таблиц. В этой главе мы подробно разберем теорию, методологии, практические примеры, технические детали и риски внедрения SCD Type 3 через добавочные поля. Мы будем говорить на понятном языке новичка, приводить примеры и конкретные SQL-решения, а также расскажем о реальных инструментах и практиках — как в открытом стеке, так и в российских реалиях.
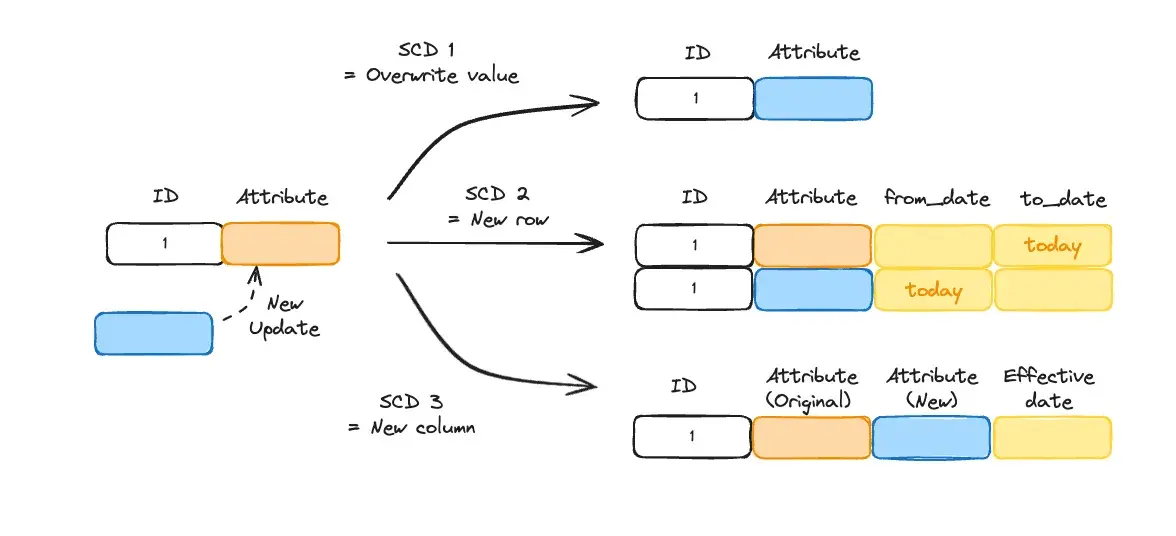
Что такое SCD и какие типы существуют
SCD (Slowly Changing Dimensions) — это подход к хранению изменений в измерениях так, чтобы аналитика могла понимать, как менялись характеристики объектов во времени. Существует несколько видов изменений и несколько способов их фиксации. Наиболее известны Type 1, Type 2 и Type 3:
- SCD Type 1: перезапись значения без сохранения истории. Аналитика видит только текущее состояние; прошлые значения теряются.
- SCD Type 2: полная история изменений. При изменении атрибута добавляется новая запись в таблицу измерения (часто с surrogate key), сохраняется вся история изменений.
- SCD Type 3: ограниченная история через добавочные поля. Сохраняется текущее значение и только одно предыдущее значение (для каждого атрибута, который мы решили «версировать»). История ограничена двумя версиями: текущей и одной прошлой.
Что означает Type 3 и что такое ограниченная история
Type 3 предполагает, что для выбранных атрибутов мы создаем добавочные поля:
- текущие значения атрибутов (например, city, status);
- значения этих атрибутов в прошлом (city_old, status_old);
- даты или временные метки, когда прошлое значение стало «историческим» (city_changed_on, status_changed_on).
Идея: хранить только недавно изменившееся значение и предыдущее значение, чтобы можно было сравнить текущее состояние с последним изменением. Преимущество — меньшая размерность и простота запросов по сравнению с Type 2. Недостаток: ограниченная история, сложности аналитики, если понадобятся более ранние версии или анализ кросс-атрибутных комбинаций во времени.
Когда подходит SCD Type 3
- Нужна ограниченная история для отдельных атрибутов (например, город или статус клиента) и нет необходимости хранить каждую версию.
- Бизнес-требование позволяет видеть текущее значение и последнее предыдущее без требования полного аудита изменений.
- Важно контролировать размер таблиц измерения и упрощать ETL-процессы.
- В некоторых случаях данные в фактах и измерениях пересекаются: наличие двух версий атрибута может быть достаточно для корректной аналитики.
Модель данных и термины
- Business key (натуральный ключ): уникальный идентификатор бизнес-объекта (например, customer_id).
- Surrogate key: уникальный идентификатор записи измерения в DW (часто числовой ключ, который не меняется).
- current_value (текущее значение): актуальное состояние атрибута.
- previous_value (прошлое значение): предыдущее состояние атрибута.
- changed_on (время изменения): дата/время, когда значение стало прошлым, или когда текущее значение было установлено.
- attribute_group: набор атрибутов, для которых мы поддерживаем ограниченную историю (например, city и region могут быть в одном наборе, status — в другом).
Паттерны реализации Type 3
- Паттерн "двойные колонки": для каждого атрибута имеет пару колонок current_value и previous_value (с соответствующей датой изменения). Например: city и city_old, city_changed_on.
- Паттерн "одна пара на атрибут" против "нескольких атрибутов в одной записи": можно хранить для city и status отдельно, либо держать все в одной строке по бизнес-ключу.
- Управление изменениями: при обнаружении обновления вETL-слое мы переносим текущее значение в "previous" и записываем новое в текущее. Время изменения фиксируется в соответствующей метке.
Методы внедрения: ELT-подход и логика ETL
- Логика проста: получить новые данные из источника (staging), проверить, есть ли в целевой таблице запись по бизнес-ключу.
- Если ключ отсутствует — вставка (current значения инициализация, previous-колонки пустые).
- Если ключ найден и изменились значения атрибутов, перенести текущее значение в соответствующее previous-поле и записать новое значение в текущее; зафиксировать изменение даты.
- Если изменений нет — обновить временные метки/флажки (если нужно).
Ограничения и критические риски Type 3
- Ограниченная история: если требуется отслеживать более старые версии атрибутов, Type 3 не подходит.
- Согласование с фактами: возможна несогласованность временных границ, если факты на основе «неполной» истории.
- Проблемы с аналитикой: при сложных запросах, когда нужно вернуться к нескольким этапам изменений, может оказаться неудобно.
- Разворот бизнес-логики: при изменении наборов атрибутов нужно поддерживать согласованную схему и naming convention для добавочных полей.
- Увеличение ширины таблиц: добавочные колонки растут с числом атрибутов; для большого числа атрибутов это приводит к очень «широким» таблицам, что влияет на производительность некоторых СУБД.
Практические примеры
1) Сценарий и дизайн таблиц
Предположим, что у нас есть мерное измерение клиентов с ограниченной историей по атрибутам city и status. Мы решаем хранить две версии для каждого атрибута: текущее значение и предыдущее значение, а также дату последнего изменения.
Дизайн таблицы dim_customer_scd3 (упрощенный пример)
sk BIGINT PRIMARY KEY
customer_key VARCHAR(50) NOT NULL UNIQUE
name VARCHAR(100)
city VARCHAR(100)            -текущее значение
city_old VARCHAR(100)        -предыдущее значение
city_changed_on TIMESTAMP
status VARCHAR(20)             -текущее значение
status_old VARCHAR(20)         -предыдущее значение
status_changed_on TIMESTAMP
updated_at TIMESTAMP DEFAULT now()
2) Пример DDL (PostgreSQL)
CREATE TABLE dim_customer_scd3 (
  sk BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  customer_key VARCHAR(50) NOT NULL UNIQUE,
  name VARCHAR(100),
  city VARCHAR(100),
  city_old VARCHAR(100),
  city_changed_on TIMESTAMP,
  status VARCHAR(20),
  status_old VARCHAR(20),
  status_changed_on TIMESTAMP,
  updated_at TIMESTAMP DEFAULT now()
);
3) Пример загрузки через ETL: шаги
Источник данных: staging-таблица stg_dim_customer(customer_key, name, city, status)
Целевая таблица: dim_customer_scd3
4) Пример SQL-паттерна (PostgreSQL)
a) Обновление при изменении значений
UPDATE dim_customer_scd3 d
SET
  city_old = CASE WHEN s.city <> d.city THEN d.city ELSE d.city_old END,
  city = CASE WHEN s.city <> d.city THEN s.city ELSE d.city END,
  city_changed_on = CASE WHEN s.city <> d.city THEN COALESCE(d.city_changed_on, NOW()) ELSE d.city_changed_on END,
  status_old = CASE WHEN s.status <> d.status THEN d.status ELSE d.status_old END,
  status = CASE WHEN s.status <> d.status THEN s.status ELSE d.status END,
  status_changed_on = CASE WHEN s.status <> d.status THEN COALESCE(d.status_changed_on, NOW()) ELSE d.status_changed_on END,
  updated_at = NOW()
FROM stg_dim_customer s
WHERE d.customer_key = s.customer_key
  AND (s.city <> d.city OR s.status <> d.status);
b) Вставка новой записи, если бизнес-ключ отсутствует
INSERT INTO dim_customer_scd3 (customer_key, name, city, city_old, city_changed_on, status, status_old, status_changed_on, updated_at)
SELECT s.customer_key, s.name, s.city, NULL, NULL, s.status, NULL, NULL, NOW()
FROM stg_dim_customer s
WHERE NOT EXISTS (
  SELECT 1 FROM dim_customer_scd3 d WHERE d.customer_key = s.customer_key
);
5) Альтернативы с использованием MERGE (PostgreSQL 15+)
MERGE INTO dim_customer_scd3 AS d
USING stg_dim_customer AS s
ON d.customer_key = s.customer_key
WHEN MATCHED AND (s.city <> d.city OR s.status <> d.status)
  THEN UPDATE SET
    city_old = d.city,
    city = s.city,
    city_changed_on = NOW(),
    status_old = d.status,
    status = s.status,
    status_changed_on = NOW(),
    updated_at = NOW()
WHEN NOT MATCHED
  THEN INSERT (customer_key, name, city, city_old, city_changed_on, status, status_old, status_changed_on, updated_at)
       VALUES (s.customer_key, s.name, s.city, NULL, NULL, s.status, NULL, NULL, NOW());
6) Практические советы по реализации
- Выбор СУБД и окружения: для Type 3 часто используют PostgreSQL или MS SQL Server; они хорошо поддерживают MERGE (MS SQL Server и PostgreSQL 15+).
- Индексирование: создайте уникальный индекс по business key (customer_key); для ускорения обновлений можно добавить индекс на (customer_key, city_changed_on) или аналогичные поля, если нужны быстрые отчеты по времени изменений.
- Нормализация добавочных полей: используйте единый стиль именования для всех атрибутов, чтобы избежать путаницы и упростить автоматизацию ETL.
- Контроль версий: храните updated_at, city_changed_on и status_changed_on для аудита изменений.
- Верификация изменений: после загрузки проверяйте, что количество строк в dim_customer_scd3 не увеличилось без необходимости (в случае Type 3 мы обычно не добавляем новые строки для существующих бизнес-ключей).
7) Open-source и российские решения
Open-source стеки:
- PostgreSQL, как база для DW и реализации SCD Type 3 через SQL-ETL-скрипты. Хорошо подходит для обучения и прототипирования.
- Apache NiFi или Apache Hop для потоков интеграции и orchestration добавления данных в staging и затем их обработку.
- Airbyte для извлечения данных из источников и загрузки в целевые БД; можно реализовать логику SCD3 в трансформациях на стороне БД.
- dbt (data build tool) для моделирования и тестирования представлений и инкрементных обновлений, включая логику обновления полей current/previous.
Российские/локальные решения и практики:
- В российских компаниях часто используются 1С:Предприятие как источник данных и связи с хранилищами на базе PostgreSQL/MS SQL Server. В этом контексте типичная схема — экспорт данных из 1С в staging и применение SCD Type 3 в PostgreSQL или MS SQL Server с использованием SQL-скриптов и ETL-процессов. 1С предоставляет механизмы обмена данными и API (ODBC, REST, файловый экспорт), что позволяет внедрять подобную логику без необходимости покупки дорогих коммерческих ETL-платформ.
- Локальные решения часто опираются на хорошо изученные открытые технологии (PostgreSQL, MySQL, Spark) и адаптируют их под требования российского рынка, включая регламенты по безопасности данных и соответствие локальным дата-центрам. При этом специалисты применяют практики на стороне ETL-слоя: staging -> SCD3 logic -> DW.
- Пример практики: сбор данных по клиентам из собственной ERP, выгрузка в staging, и обработка в PostgreSQL через скрипты на PL/pgSQL или Python-скрипты внутри ETL-проекта, затем миграции в dim_customer_scd3. Такой подход позволяет сочетать доступность open-source инструментов и реальный бизнес-процесс под российские регуляторные требования.
Архитектура и процессная логика
- Источник данных ( Source ): системы ERP, CRM, файловые экспорты и т. п.
- Этап обработки ( ETL/ELT ): загрузка данных в staging, сравнение и применение изменений для dim_customer_scd3.
- Целевая модель: dim_customer_scd3 с ограниченной историей (одна предшествующая версия для каждого атрибута).
- Время обработки: ночной пакет или частые инкременты, в зависимости от частоты изменений бизнес-объектов.
Дизайн таблицы и сигнатуры
- Основной принцип: одна запись на бизнес-ключ, но с двумя версиями атрибутов для каждого изменяемого поля.
- Поля для атрибутов-изменяемости: city, city_old, city_changed_on; status, status_old, status_changed_on.
- Другие общие поля: customer_key (уникальный бизнес-ключ), name (если нужно), updated_at (последнее обновление).
Типы данных и индексы
- city, city_old: VARCHAR(100) или аналогичный строковый тип, зависящий от максимальной длины данных.
- status, status_old: VARCHAR(20–50) в зависимости от значений.
- city_changed_on, status_changed_on: TIMESTAMP без TZ или WITH TIME ZONE, в зависимости от политики временных зон в вашей среде.
- updated_at: TIMESTAMP WITH TIME ZONE (лучше хранить всегда с TZ).
- customer_key: VARCHAR(50) или другой допустимый размер, уникальный индекс.
-
Схема индексов:
- UNIQUE (customer_key)
- INDEX (customer_key) для ускорения соединений
- При необходимости: индекс на (customer_key, city_changed_on) или (customer_key, status_changed_on) для ускорения аналитических запросов по времени изменений.
Обновления и согласованность
- Обновление должно быть атомарным: либо все поля обновлены в рамках одной транзакции, либо ничего не изменяется.
- В случае использования MERGE (PostgreSQL 15+) это упрощает логику: MATCHED — обновление текущих и предшествующих значений; NOT MATCHED — вставка новой строки.
- Вариант через UPSERT (INSERT ... ON CONFLICT) требует более явной логики «перемещения» текущего значения в предыдущие поля.
Пример кода: PostgreSQL
Создание таблицы (как выше):
CREATE TABLE dim_customer_scd3 (
  sk BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  customer_key VARCHAR(50) NOT NULL UNIQUE,
  name VARCHAR(100),
  city VARCHAR(100),
  city_old VARCHAR(100),
  city_changed_on TIMESTAMP,
  status VARCHAR(20),
  status_old VARCHAR(20),
  status_changed_on TIMESTAMP,
  updated_at TIMESTAMP DEFAULT now()
);
Обновление/перемещение значений при изменении
UPDATE dim_customer_scd3 d
SET
  city_old = CASE WHEN s.city <> d.city THEN d.city ELSE d.city_old END,
  city = CASE WHEN s.city <> d.city THEN s.city ELSE d.city END,
  city_changed_on = CASE WHEN s.city <> d.city THEN COALESCE(d.city_changed_on, NOW()) ELSE d.city_changed_on END,
  status_old = CASE WHEN s.status <> d.status THEN d.status ELSE d.status_old END,
  status = CASE WHEN s.status <> d.status THEN s.status ELSE d.status END,
  status_changed_on = CASE WHEN s.status <> d.status THEN COALESCE(d.status_changed_on, NOW()) ELSE d.status_changed_on END,
  updated_at = NOW()
FROM stg_dim_customer s
WHERE d.customer_key = s.customer_key
  AND (s.city <> d.city OR s.status <> d.status);
Вставка новой записи, если бизнес-ключ отсутствует
INSERT INTO dim_customer_scd3 (customer_key, name, city, city_old, city_changed_on, status, status_old, status_changed_on, updated_at)
SELECT s.customer_key, s.name, s.city, NULL, NULL, s.status, NULL, NULL, NOW()
FROM stg_dim_customer s
WHERE NOT EXISTS (
  SELECT 1 FROM dim_customer_scd3 d WHERE d.customer_key = s.customer_key
);
Альтернатива с MERGE (PostgreSQL 15+):
MERGE INTO dim_customer_scd3 AS d
USING stg_dim_customer AS s
ON d.customer_key = s.customer_key
WHEN MATCHED AND (s.city <> d.city OR s.status <> d.status)
  THEN UPDATE SET
    city_old = d.city,
    city = s.city,
    city_changed_on = NOW(),
    status_old = d.status,
    status = s.status,
    status_changed_on = NOW(),
    updated_at = NOW()
WHEN NOT MATCHED
  THEN INSERT (customer_key, name, city, city_old, city_changed_on, status, status_old, status_changed_on, updated_at)
       VALUES (s.customer_key, s.name, s.city, NULL, NULL, s.status, NULL, NULL, NOW());
Рекомендации по реализации в реальных системах
- Соблюдайте конвенции именования колонок и согласуйте их между всеми источниками данных.
- При проектировании используйте тестовые наборы данных, чтобы проверить, как ETL-логика работает на сценариях изменения атрибутов и отсутствия изменений.
- Документируйте сигнатуры добавочных полей (какие атрибуты покрываются, какие значения считаются изменением, какие поля заполняются и когда).
- Придерживайтесь одного подхода к времени изменений (UTC/TZ) и единых временных зон.
SCD Type 3 через добавочные поля — полезный подход, когда цель состоит в ограниченной истории атрибутов и когда нужно контролировать размерность DW. Он упрощает работу аналитиков, позволяя быстро увидеть текущее значение и его предыдущее состояние, без необходимости обслуживания полного архива изменений. Но этот подход имеет ограничения: история ограничена двумя версиями атрибута, не подходит, если нужно отслеживать долгую эволюцию данных или сложные кросс-атрибутные зависимости. При выборе подхода к изменению данных важно учитывать требования бизнеса, частоту обновлений и объём данных. Важно обеспечить надлежащий процесс ETL, тестирование и мониторинг, чтобы поддерживать согласованность между источником и DW. В конечном счете, Type 3 — это компромисс между простотой и полнотой истории, который может быть эффективным решением для множества бизнес-кейсов.
FAQ — Вопрос–Ответ
1) Что такое SCD Type 3 и чем он отличается от Type 2?
Ответ: SCD Type 3 — это ограниченная история изменений. Для выбранных атрибутов хранится текущее значение и одно предыдущее значение (например, city и city_old) вместе с датами изменений. Type 2 же сохраняет полную историю изменений, обычно создавая новую строку измерения при каждом изменении атрибута. Разница в объёме истории и в сложности обновлений: Type 3 проще и меньше по объему, но ограничен в функциональности истории.
2) Какие атрибуты стоит держать в Type 3?
Ответ: Обычно выбирают атрибуты, которые изменяются редко и для которых достаточно знать последнее значение и предыдущее (например, город, статус клиента, регион). Нельзя применять Type 3 ко всем атрибутам—это приводит к избыточной ширине и сложности поддержки; выбирать нужно только те, где двухступенчатая история действительно полезна.
3) Какой дизайн лучше выбрать для добавочных полей: одна пара полей на атрибут или несколько пар?
Ответ: Оба варианта работают. Одновариантная пара на атрибут проста в реализации и понимании (city + city_old), однако если атрибутов несколько и нужно держать их в рамках одной строки, можно реализовать одну пару на каждый атрибут в единой схеме (city, city_old, status, status_old и т. д.). Вопрос в объеме полей и удобстве поддержки: чаще выбирают один паттерн и придерживаются его.
4) Как реализовать SCD Type 3 в PostgreSQL?
Ответ: Через две фазы ETL: загрузку данных в staging и затем обновления целевой Dim. Реализация может быть сделана через MERGE (PostgreSQL 15+) для атомарного обновления текущих и прошлых значений, или через последовательные UPDATE и INSERT с проверками. Пример паттерна: при изменении city/ status переносим текущее значение в city_old/status_old и устанавливаем новое значение в city/status с записью даты изменения.
5) Какие риски и ограничения существуют?
Ответ: Ограниченная история может привести к потере важных деталей изменений, если в будущем понадобится полноценно аналитировать множество версий атрибута. Таблица Dim Type 3 может вырасти по ширине при наличии множества атрибутов; сложность ETL-процесса выше, чем у Type 1, но ниже, чем у Type 2. Необходимо четко документировать правила изменений и поддерживать согласованность между источниками и целевой моделью.
6) Какие инструменты можно использовать для реализации Type 3?
Ответ: Open-source: PostgreSQL + SQL-ETL-скрипты, dbt для моделирования и тестирования, Apache NiFi или Apache Hop для потоков интеграции, Airbyte для загрузки данных. Российские практики чаще опираются на открытые стеки (PostgreSQL, MS SQL Server, 1С как источник данных) и применяют собственные скрипты ETL для реализации логики SCD3 на стороне базы данных.
7) Можно ли реализовать SCD Type 3 без использования SQL-скриптов?
Ответ: Теоретически можно, но в практике наиболее надёжно и прозрачно это сделать через SQL-ETL-скрипты или через инструмент моделирования (dbt) в связке с базой данных. Собственные ETL-инструменты часто позволяют вынести логику в отдельные шаги и тестировать изменения отдельно от бизнес-логики.
8) Как тестировать решение SCD Type 3?
Ответ: Привести набор тестов, включая: вставку новой записи для нового business_key; обновление city и status и проверку, что city_old и status_old заполнены корректно; отсутствие изменений — поля city_old и status_old не изменяются; повторная загрузка — поведение должно быть детерминированным. Тестируйте как успешные обновления, так и случаи отсутствия изменений.
9) Какие сценарии аналитики поддерживает Type 3?
Ответ: Можно сравнивать текущее значение с последним прошлым (city vs city_old), анализировать динамику за короткий период, смотреть на «когда» произошли изменения. Но для более сложной аналитики изменений по времени (например, как менялся city на протяжении трех обновлений) Type 3 не подходит без дополнительных расширений.
10) Как выбрать между SCD Type 2 и Type 3?
Ответ: Выбор зависит от бизнес-целей и требований к истории.
- Type 2: если необходима полная история изменений, поддержка аудита и высокую гибкость аналитики по времени изменений — выбирайте Type 2.
- Type 3: если ограниченная история подходит бизнесу, нужно простое и быстрое внедрение, а также важна экономия пространства — Type 3 может быть лучшим выбором.
Ожидается, что в проектах часто применяют комбинированные подходы: Type 2 для ключевых атрибутов, Type 3 для небольшого набора атрибутов, где достаточно ограниченной истории.
Данная глава дала представление о SCD Type 3 как методе реализации ограниченной истории через добавочные поля. Мы рассмотрели теорию, принципы моделирования, практические примеры на языке SQL и обсудили технические детали, риски и ограничения внедрения. Также мы рассмотрелиopen-source и российские реалии, где такой подход может быть реализован через гибридные архитектуры с использованием PostgreSQL и локальных инструментов, а 1С может выступать источником данных для такого процесса. В конце представлены ответы на частые вопросы, которые помогают закрепить понимание концепции и практических действий для начинающего специалиста.
Обратите внимание: при внедрении SCD Type 3 в вашей среде обязательно тестируйте сценарии изменения атрибутов, следите за качеством данных, и документируйте правила изменений и сигнатуры полей. Это поможет не только сохранить корректность аналитики, но и обеспечить устойчивость ETL-процесса к изменению требований бизнеса.


