

Выбор типа SCD под бизнес-требования
Эффективная работа над данными в хранилищах требует умения хранить не только текущее состояние объектов бизнес-доменов, но и их историю. Это особенно важно в аналитике: клиенты меняют адреса, сотрудники переводятся между департаментами, товары обновляют характеристики — и бизнес-подразделения хотят видеть, как эти изменения происходили во времени. Slowly Changing Dimensions (SCD) — категория паттернов хранения изменений dimension-таблиц в хранилищах данных. Выбор типа SCD под конкретные бизнес‑требования влияет на точность аналитики, требования к хранению и производительность ETL‑процессов.
Цель этой главы — помочь новичку понять, как правильно выбирать тип SCD в зависимости от бизнес‑правил и практических ограничений, какие типы существуют, чем они отличаются и как их реализуют на практике. Мы рассмотрим теорию, приведем примеры реализации как на открытых технологиях, так и на российских решениях, обсудим риски и ограничения, а затем дадим готовые практические рекомендации.
Что такое SCD и зачем он нужен
SCD означает хранение изменений характеристик сущности (dimension) во времени. В дата‑хранилищах это позволяет отвечать на вопросы вроде: «Какое имя у клиента в декабре 2023 года?», «Какой был адрес клиента в момент обращения в сервис в 2022 году?» и т. п. Главная идея — не просто текущее состояние, а временная история изменений, с привязкой ко времени.
Основные термины:
- Нормальная (natural) ключевые данные: набор уникальных полей, которые бизнес считает идентификатором сущности (например, customer_id, product_code). Это не суррогатный ключ.
- Суррогатный ключ (surrogate key): искусственный уникальный идентификатор записи dimension‑таблицы, который обеспечивает неизменность ключа внутри истории.
- Истина история (history): набор версий одной и той же сущности за разные периоды времени.
- Действующая запись (current row): запись, которая отражает текущее состояние на данный момент времени.
- Valid_from / Valid_to (или effective_from/effective_to): интервалы времени, когда запись была действительна.
- is_current / is_active: флаг, указывающий, является ли запись текущей.
- Версии (version): числовой счетчик версий, который помогает отличать разные состояния одной и той же сущности.
- Типы SCD: набор моделей хранения изменений, различающихся правилами обновления/добавления строк и хранения истории.
- Tempo и объем изменений: важные метрики, которые влияют на выбор типа SCD: частота обновлений, количество изменений на объект, политика аудита.
Типы SCD и их особенности
SCD Type 1 (обновление текущего значения без истории)
- Что делает: замещает старое значение новым без сохранения истории.
- Когда использовать: когда история изменений не нужна или она не имеет ценности для аналитики (например, исправление ошибки в имени предприятия без необходимости видеть прошлые значения).
- Преимущества: простота, высокая производительность для чтения текущих значений.
- Недостатки: теряется история изменений, аудит невозможен.
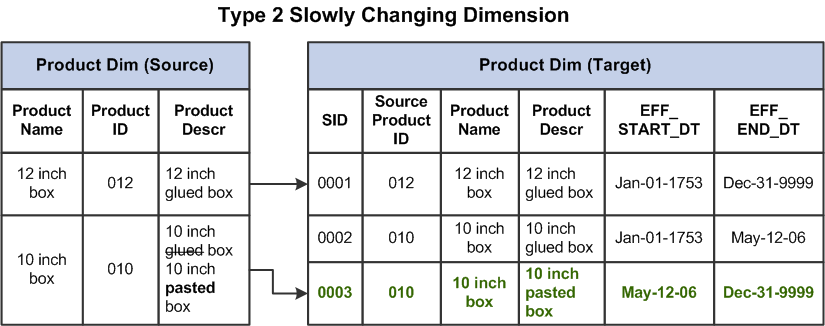
SCD Type 2 (добавление новой версии с сохранением истории)
- Что делает: при изменении создается новая запись с новым суррогатным ключом, старую запись помечают как неактивную (end_date) или выключают флагом is_current.
- Когда использовать: когда нужно сохранять полную историю изменений, поддерживать точное состояние на любой момент времени.
- Преимущества: полнота истории, аналитика по эволюции.
- Недостатки: более сложная ETL‑логика, больше объема хранения, потенциально более сложные запросы.
SCD Type 3 (ограниченная история в одной или нескольких колонках)
- Что делает: сохраняет предыдущие значения в дополнительных столбцах (например, previous_address).
- Когда использовать: когда важна только часть истории (последнее изменение), а полный историзм не нужен.
- Преимущества: простое моделирование, меньшая занимаемая память по сравнению с Type 2.
- Недостатки: ограниченная история, не подходит для долгосрочного аудита.
SCD Type 4 (история в отдельной таблице)
- Что делает: текущие значения хранятся в одной таблице, а история — в другой (архивная/историческая таблица).
- Когда использовать: если хочется отделить текущие данные от исторических, упрощать запросы к текущим данным.
- Преимущества: ясный раздел истории и текущего состояния, гибкость в архитектуре.
- Недостатки: необходимость синхронизации между двумя таблицами, сложность запросов, поддержка сложных связей.
SCD Type 6 (hybrid — сочетание Type 1/2/3)
- Что делает: комбинирует подходы, например, хранит текущие значения как Type 1, но при изменениях добавляет версию и может хранить несколько признаков в отдельных столбцахиль.
- Когда использовать: когда нужны свойства и текущего состояния, и истории, при этом требуется умеренная сложность ETL.
- Преимущества: баланс между историей и простотой, гибкость.
- Недостатки: сложнее поддерживать, требует четких правил.
Расширенные концепции: би temporal SCD
- Что значит: хранение и системного времени (когда данные были записаны в систему) и валидного времени (когда они действительны в бизнес‑контексте).
- В практике: добавляют две временные границы (system_from/system_to и valid_from/valid_to).
Как выбрать тип SCD — общие принципы
- Цели аналитики: нужна ли история полностью или достаточно текущего состояния?
- Юридические и регуляторные требования: аудит изменений, сохранение данных для соответствия требованиям к данным.
- Частота изменений: как часто происходят обновления в dimension? При высокой частоте Type 2 требует более мощной ETL.
- Объем данных: хранение версий увеличивает размер таблиц; планируется ли архивирование?
- Производительность запросов: чтение текущего состояния должно быть быстрым; чтение истории может быть менее частым и допускается более медленная обработка.
- Интеграция с другими системами: как запросы к dimension будут использоваться в BI‑инструментах и моделях?
- Управление и поддержка: сложность разработки и обслуживанием ETL‑потоков.
Как принимать решение на практике
- Начинайте с бизнес‑правил: каковы требования к истории конкретной бизнес‑объектной размерности (клиенты, продукты, локации и т.д.)?
- Определяйте для каждого поля: хранить ли значение и когда оно изменялось, какие изменения считаются важными.
- Оцените риски хранения больших объемов версий и требования к быстродействию.
- Рассмотрите альтернативы: иногда можно реализовать Type 4 (историческую таблицу) в сочетании с текущей таблицей, чтобы упростить доступ к текущей версии и сохранить историю в архиве.
- Планируйте миграцию и эволюцию схемы: как вы будете переходить от одного типа к другому, если требования изменятся.
Практические примеры
1) Пример применения SCD Type 2 на базе Apache Spark и Delta Lake (открытое решение)
Сценарий: клиентская dimension, где нужно сохранять полную историю изменений адресов и имен клиентов. Источник: staging‑таблица со свежими данными, цель — dim_customer_scd2 с суррогатным ключом.
Архитектура: Delta Lake на базе Spark. Таблица dim_customer_scd2 содержит поля: surrogate_key (BIGINT, автоинкремент), customer_id (STRING), name (STRING), address (STRING), phone (STRING), valid_from (TIMESTAMP), valid_to (TIMESTAMP), is_current (BOOLEAN).
ETL‑логика (упрощенная, но понятная): при загрузке из staging мы ищем существующую текущую запись по customer_id; если изменений нет — ничего не делаем; если изменения есть — закрываем текущую версию (устанавливаем valid_to = текущая_время, is_current = false) и вставляем новую версию с новыми значениями и свойством is_current = true, valid_from = текущая_время.
Пример SQL MERGE (упрощенный, ориентирован на Delta Lake):
MERGE INTO dim_customer_scd2 AS d
USING staging AS s
ON d.customer_id = s.customer_id AND d.is_current = true
WHEN MATCHED AND (d.name <> s.name OR d.address <> s.address OR d.phone <> s.phone)
  THEN UPDATE SET valid_to = current_timestamp(), is_current = false
WHEN NOT MATCHED THEN INSERT (surrogate_key, customer_id, name, address, phone, valid_from, valid_to, is_current)
VALUES (NEXTVAL('dim_customer_scd2_seq'), s.customer_id, s.name, s.address, s.phone, current_timestamp(), NULL, true)
WHEN MATCHED AND (d.name <> s.name OR d.address <> s.address OR d.phone <> s.phone)
  THEN INSERT (surrogate_key, customer_id, name, address, phone, valid_from, valid_to, is_current)
       VALUES (NEXTVAL('dim_customer_scd2_seq'), s.customer_id, s.name, s.address, s.phone, current_timestamp(), NULL, true);
Замечания:
- Delta Lake обеспечивает надёжную консистентность, поддержку транзакций и возможности временных запросов.
- В реальном проекте добавляются проверки на дубликаты, обработка ошибок и мониторинг ETL.
2) Пример реализации SCD Type 2 в PostgreSQL (классическая OLAP‑история)
Сценарий: аналогично предыдущему, но без Delta Lake. Таблица dim_customer_scd2 с полями: id (BIGINT, суррогатный ключ), customer_id (TEXT, естественный ключ), name, address, phone, valid_from, valid_to, is_current.
Логика: при каждём изменении создаётся новая запись. Предыдущая версия помечается как завершённая.
SQL‑пример:
CREATE TABLE dim_customer_scd2 (
  id BIGINT PRIMARY KEY,
  customer_id TEXT NOT NULL,
  name TEXT,
  address TEXT,
  phone TEXT,
  valid_from TIMESTAMP NOT NULL,
  valid_to TIMESTAMP,
  is_current BOOLEAN NOT NULL
);
-предположим, что staging имеет те же поля без id (id генерируем)
WITH up AS (
  SELECT s.customer_id, s.name, s.address, s.phone, NOW() AS now_ts
  FROM staging s
)
INSERT INTO dim_customer_scd2 (id, customer_id, name, address, phone, valid_from, valid_to, is_current)
SELECT NEXTVAL('dim_customer_scd2_id_seq'), u.customer_id, u.name, u.address, u.phone, u.now_ts, NULL, true
FROM up u
ON CONFLICT (customer_id) DO UPDATE
SET valid_to = EXCLUDED.now_ts, is_current = false
WHERE dim_customer_scd2.customer_id = EXCLUDED.customer_id AND dim_customer_scd2.is_current = true;
Замечания:
- Здесь мы используем upsert‑операцию и управляющий триггер для сохранения истории.
- В реальности потребуется более точная логика сравнения изменений и защиты от гонок.
3) Пример SCD Type 3 (ограниченная история)
Сценарий: для каждого клиента сохраняем в одном поле предыдущее значение адреса. Это даёт простую историческую памятку, но не полную историю.
Таблица: dim_customer_scd3 (customer_id, name, address, previous_address, valid_from, valid_to, is_current)
SQL‑пример:
UPDATE dim_customer_scd3
SET previous_address = address, address = $new_address, valid_from = NOW(), valid_to = NULL, is_current = true
WHERE customer_id = $customer_id AND is_current = true;
Если адрес не изменился, ничего не делаем.
4) Пример SCD Type 4 (историческая таблица)
Сценарий: текущие данные держим в dim_customer_cur, а история — в dim_customer_hist. При изменении вставляется новая запись в историческую таблицу, актуальная версия в текущей таблице обновляется.
SQL‑пример:
На входе: обновление данных клиента.
-Обновляем текущую запись
UPDATE dim_customer_cur
SET name = $name, address = $address, phone = $phone
WHERE customer_id = $customer_id;
-Вставляем в историю
INSERT INTO dim_customer_hist (customer_id, name, address, phone, changed_at)
VALUES ($customer_id, $name, $address, $phone, NOW());
5) Пример SCD Type 6 (гибрид)
Сочетаем простоту Type 1 для части полей и Type 2 для сохранения истории по ключу. Также можно сочетать с Type 3.
SQL‑подход в общем виде:
- Текущие значения — в dim_customer_cur.
- История — в dim_customer_hist.
- При изменении отдельных полей добавляем новую запись в историю, обновляем текущую запись.
6) Пример на российском решении — ClickHouse и концепции
ClickHouse — популярная в РФ аналитическая СУБД с открытым исходным кодом. Для SCD можно использовать одну из следующих стратегий:
- Использовать Replace‑Merge‑Tree (или ReplacingMergeTree) с полем version.
- Либо держать текущие значения в одной таблице и полную историю — в другой, и синхронизировать их через ETL.
Пример упрощённого определения таблицы под Type 2 с ReplacingMergeTree:
CREATE TABLE dim_customer_clickhouse
(
  customer_id String,
  name String,
  address String,
  phone String,
  version UInt64,
  is_current UInt8
) ENGINE = ReplacingMergeTree(version)
ORDER BY (customer_id, version);
Иллюстрация поведения: новая версия добавляется как новая строка с increment version; старые версии остаются в таблице, но исключаются из итоговой выборки через фильтр is_current = 1. В более продвинутых конфигурациях можно использовать материализированные представления или сложную логику обновлений через ALTER UPDATE, чтобы пометить старые версии как неактивные.
Практическая роль dbt и open-source инструментария
- dbt (data build tool) прекрасно подходит для реализации моделей SCD: вы разделяете логику в моделях, тестируете трансформации и пишете репозитории тестов на изменения. В сочетании с выбором конкретной СУБД (PostgreSQL, Snowflake, BigQuery, Snowflake/Delta) вы получаете управляемые и повторяемые ETL‑потоки.
- Apache NiFi / Apache Airflow — orchestration и потоки данных, которые помогают в части извлечения и загрузки, а dbt — в трансформациях.
- Delta Lake / Apache Iceberg / Apache Hudi — хранение версий и управление историей на уровне lakehouse: упрощают реализацию Type 2 и логики обновления в больших дата‑сетах.
- В качестве российского контекста стоит упомянуть ClickHouse — он широко применяется в аналитике в РФ и поддерживает гибкие схемы обновления и версий, что позволяет реализовать решение в реальном производстве на отечественной инфраструктуре.
Архитектура данных и моделирование
Выберите ключи:
- natural_key (естественный ключ): соответствует бизнес‑идентификатору, например customer_id.
- surrogate_key (суррогатный ключ): уникален внутри dimension‑таблицы и обеспечивает стабильность ссылок.
Поля признаков:
- name, address, phone и т. д. — в зависимости от домена.
- временные поля: valid_from, valid_to, is_current или аналогичные булевы признаки.
Хранение истории:
- Type 2 часто требует дополнительных полей.
- Type 3 — добавляет ограниченную историческую информацию.
- Type 4 — хранение истории в отдельной таблице упрощает запросы к текущим данным.
Временные параметры:
- valid_from/valid_to: использовать точные временные отметки (UTC) для аудита.
- system_time (для некоторых сценариев): для регуляции изменений в СУБД, которые происходят вне бизнес‑логики.
Стратегии изменения данных и upsert
Публичный паттерн upsert: сравниваете входной набор с текущей версией и, если различия есть, вставляете новую версию и проставляете end_date у старой версии.
Хэш идеи изменений: вычисляйте хэш по набору значений полей, чтобы быстро определить факт изменения без сравнения каждого столбца.
Механизмы поддержки массовых обновлений:
- MERGE (или аналогичные команды в конкретной СУБД).
- Upsert‑логика через INSERT ... ON CONFLICT (PostgreSQL) / INSERT ... SELECT + UPSERT в Snowflake/BigQuery.
- В ClickHouse — UPDATE via ALTER UPDATE или через ReplacingMergeTree с версионированием.
Производительность и хранение
Индексация и партиционирование:
- В традиционных RDBMS это часто по внешнему ключу и временным полям (valid_from).
- В современных lakehouse‑архитектурах стоит рассмотреть кластеризацию по natural_key + valid_from + is_current, чтобы ускорить запросы по текущей версии.
Архивирование и retention:
- Храните историю в отдельных архивах, если она не нужна для повседневных запросов.
- Учитывайте регуляторные сроки хранения (GDPR, финансовая отчётность) и согласуйте политику удаления/аномалий.
Конкурентность ETL:
- Обеспечьте идемпотентность и контроль версий, чтобы несколько параллельных потоков не создавали конфликтов.
Контроль качества данных и тесты
Тесты на SCD:
- Проверяйте качество изменений: корректное обновление is_current, корректная установка valid_from/valid_to.
- Тестируйте сценарии “нет изменений” — чтобы не создавались лишние версии.
Мониторинг ETL:
- Сцены задержки обработки, пропуски обновлений, расхождения между текущей и исторической таблицами.
- Наборы валидаторов для покрытия аномалий по времени и версиям.
Риски и ограничения внедрения
Увеличение объема хранения:
- Type 2 создаёт версионные копии; в больших dimension может потребоваться разделение на архив и текущие данные.
Сложность ETL‑логики:
- Требуется аккуратная реализация и тестирование, чтобы избежать дублирования версий или пропуска изменений.
Производительность чтения истории:
- Запросы на историю могут быть тяжелыми; решение — денормализация в архиве, оптимизация индексов и кэширования.
Комплаенс и безопасность:
- Исторические данные могут содержать PII; нужно реализовывать маскирование, ограничение доступа по ролям, аудит изменений.
Регуляторные риски:
- Требования к хранению, времени хранения и прав доступа могут меняться; архитектура должна выдержать миграцию в будущем.
Технические ограничения конкретной СУБД:
- В некоторых системах обновления и upserts могут быть дорогими; выбор типа SCD должен учитывать особенности движка (например, в ClickHouse UPDATE через ALTER UPDATE имеет стоимость).
Сложности миграции:
- Переход от одного типа SCD к другому требует планирования миграции данных, тестирования и нормализации процессов.
Практические советы по выбору
Начинайте с требований к истории:
- Нужна полная история изменений по каждому полю? Type 2 или Type 6.
- Нужна частичная история? Type 3 или Type 4.
Оцените нагрузку на ETL:
- Высокие объемы изменений — возможно, стоит рассмотреть Type 2 в рамках отдельной схемы и использовать оптимизированные методы upsert.
Учитывайте аналитические запросы:
- Если основной спрос — текущее состояние, можно держать облегчённую текущую таблицу и архив для истории.
Учитывайте технологическую экосистему:
- В lakehouse-архитектурах удобно использовать Delta Lake / Iceberg / Hudi для эффективного управления версиями.
- В российских условиях можно рассмотреть ClickHouse для аналитики и реализацию SCD Type 2 через версионирование и/или ALTER UPDATE.
Выбор типа SCD — не абстрактная теоретическая задача, а практическое решение, которое должно соответствовать бизнес‑правилам и операционным ограничениям. Основной настройкой является баланс между сохранением истории и простотой ETL. Type 1 подходит для случаев, когда история не критична и важны лишь текущее состояние. Type 2 дает полную историю изменений и аудитацию, но требует более сложной ETL‑логики и большего пространства. Type 3 и Type 4 предлагают компромиссные варианты, когда нужна ограниченная история или разделение текущего состояния и истории. Type 6 — гибридный подход, который может сочетать преимущества нескольких паттернов, но требует устойчивых правил управления.
Включение в практику открытых технологий и российских решений позволяет выбрать оптимальный набор инструментов под конкретный контекст: от Delta Lake и Iceberg (мощные решения для lakehouse) до ClickHouse (популярный в РФ аналитический движок). В любом случае ключами к успешному внедрению являются: четко сформулированные бизнес‑правила по истории изменений, продуманная архитектура хранения, надежная ETL‑логика и регулярный мониторинг качества данных.
Вопрос–Ответ (FAQ)
1) Что такое SCD и зачем он нужен в хранилищах данных?
SCD — это подход к хранению изменений в dimension‑таблицах во времени. Он позволяет сохранять историю изменений, а не только текущее состояние, чтобы можно было отвечать на вопросы о прошлых состояниях бизнеса, анализировать эволюцию клиентов, продуктов и процессов. Это критически важно для аудита, регуляторных требований и полноты аналитики.
2) Какие основные типы SCD существуют и чем они отличаются?
Самые распространенные — Type 1, Type 2, Type 3, Type 4 и гибридные варианты вроде Type 6. Type 1 просто перезаписывает значение без сохранения истории. Type 2 добавляет новую версию записи с сохранением всей истории (старые версии остаются в таблице). Type 3 хранит ограниченную историю (одна или несколько прошлых версий в дополнительных столбцах). Type 4 разделяет текущие данные и историю в разных таблицах. Type 6 — гибридный подход, сочетает элементы нескольких типов. В реальных проектах часто комбинируют Type 2 и Type 3/4 в зависимости от требований к аналитике и аудит‑правилам.
3) Какие критерии помогают выбрать конкретный тип SCD?
Важно учесть: требуется ли сохранение полной истории, какие поля изменяются чаще всего, объем изменений, требования к аудиту, регуляторные сроки хранения, производительность запросов и сложности ETL. Если история критична, чаще выбирают Type 2 или Type 6; если изменения редки и важна простота — Type 1 или Type 3/4 как компромисс.
4) Какие практические примеры реализации существуют на открытых технологиях?
- Delta Lake (Apache Delta Lake) + Spark — типичная реализация Type 2 в lakehouse: используйте MERGE‑операции для закрытия старой версии и вставки новой версии с is_current = true.
- PostgreSQL/MySQL — реализация Type 2 через upsert, вставку новой версии и закрытие старой через valid_to / end_date.
- dbt — инструмент для моделирования и тестирования трансформаций, помогающий поддерживать повторяемые и тестируемые SCD‑потоки.
- ClickHouse — Elasticsearch‑подобные паттерны версии с ReplacingMergeTree или UPDATE через ALTER UPDATE; применяется для больших аналитических нагрузок в РФ.
5) Какие практические преимущества и риски использования Type 2?
Преимущества: полная история изменений, возможность анализа эволюции и аудита. Риски: затратность на хранение и вычисления, сложность ETL, возможные задержки в обновлениях и сложные запросы к историческим данным. Если история не критична, можно рассмотреть Type 1 или Type 3/4 как облегченный вариант.
6) Какие российские и открытые решения можно использовать на практике?
- Open source: Delta Lake, Apache Iceberg, Apache Hudi — поддерживают версии и упрощают управление историей в lakehouse‑архитектурах.
- Российские/локальные решения: ClickHouse — широко используемая в РФ аналитическая СУБД; поддерживает версии через ReplaceMergeTree и возможности обновления, что позволяет реализовать SCD Type 2 в отечественной инфраструктуре. Также стоит учитывать локальные deployment‑платформы и BI‑инструменты, которые интегрируются с ClickHouse и другими отечественными экосистемами.
7) Какие риски стоит учитывать при внедрении SCD в больших дата‑моделях?
- Риск переполнения схемы и нехватки пространства для хранения версий.
- Риск ошибок ETL‑логики при обновлениях и версии: нужно обеспечить идемпотентность и тестирование.
- Риск ухудшения производительности при частых обновлениях и сложных запросах к истории; решение — архитектурная мобилизация (архивы, партиционирование, денормализация текущих данных).
- Риск нарушения комплаенса и безопасности за счет хранения исторических данных; требует строгого контроля доступа и аудита.
- Риск миграции между типами SCD: нужно планировать миграцию с тестированием и обеспечивать совместимость.
8) Как начать внедрение SCD под ваши бизнес‑потребности?
- Шаг 1: сформулируйте требования к истории: какие сущности будут хранить историю, на какие поля она распространяется и как долго сохраняется.
- Шаг 2: выберите тип SCD для каждой размерности и сформируйте архитектуру (таблицы текущего состояния и истории, если применимо).
- Шаг 3: спроектируйте суррогатные ключи и естественные ключи, определите правила обновления и детализируйте ETL‑потоки.
- Шаг 4: реализуйте и протестируйте в пилотном окружении с типовыми сценариями изменений.
- Шаг 5: внедрите мониторинг и тестирование качества данных, настройте регламент миграций и ретенции.
- Шаг 6: по мере необходимости оптимизируйте запросы к истории и масштабируйте хранилище.
9) Какие рекомендации по выбору техники для российской инфраструктуры?
- Если основная аналитика строится на ClickHouse и вам нужна мощная фильтрация по времени, рассмотрите реализации SCD с версионированием и разделением текущих и исторических данных.
- В случаях, когда требуется интеграция с открытыми lakehouse‑технологиями, используйте Delta Lake / Iceberg / Hudi вместе с dbt и Apache Spark.
- При ограничениях в инфраструктуре или отсутствии возможностей для больших холодных архивов — подумайте об Type 4 с текущей таблицей и архивной таблицей для истории, чтобы облегчить запросы к текущему состоянию и ограничить размер исторических секций.
10) Что делать, если требования изменились после внедрения?
- Планируйте миграцию: сначала определитесь, можно ли просто адаптировать ETL‑потоки под новый тип SCD, или нужна полная переработка архитектуры.
- Поддерживайте тестовую среду: тестируйте миграции на реальных сценариях изменений перед выпуском в продакшн.
- Обеспечьте обратную совместимость: сохраняйте ссылки на natural_key и обеспечивает ссылки на суррогатные ключи для согласованности исторических данных.
- Обновляйте документацию: четко отражайте новые правила и поведение системы в вашем Data Catalog и метаданных.
FAQ ч. 2
Вопрос: Что такое суррогатный ключ и зачем он нужен в SCD?
Ответ: Суррогатный ключ — это искусственный уникальный идентификатор записи в dimension‑таблице, который не меняется при обновлениях бизнес‑поля. Он обеспечивает стабильность ссылок и позволяет хранить историю без риска путаницы из-за изменений естественных ключей.
Вопрос: Когда предпочтительнее использовать SCD Type 2?
Ответ: Когда необходима полная история изменений по каждому объекту и возможность анализировать состояние на конкретный момент времени. Type 2 обеспечивает аудируемость и полноту истории, но требует дополнительного объема хранения и более сложной ETL‑логики.
Вопрос: Какие преимущества дает использование Type 4?
Ответ: Type 4 помогает разделить текущие данные и историю в разных таблицах, что упрощает запросы к текущему состоянию и позволяет изолировать архивную логику. Однако это требует синхронизации между таблицами и удлинённой ETL‑логики.
Вопрос: Какие решения можно использовать на открытом коде для реализации SCD?
Ответ: Delta Lake, Apache Iceberg, Apache Hudi — это lakehouse‑платформы, которые поддерживают эффективное управление версиями, upsert‑операции и гибкую архитектуру. Они работают с Spark и позволяют реализовать Type 2 на больших данных.
Вопрос: Как российские решения влияют на выбор архитектуры?
Ответ: В РФ одним из ключевых инструментов аналитики является ClickHouse. Он предлагает эффективные паттерны для версионирования и обновления больших объемов данных, а также интеграцию с отечественными BI‑платформами. Это позволяет реализовать SCD в локальной инфраструктуре и с учётом локальных регуляторных требований.
Вопрос: Какие риски связаны с внедрением SCD и как их минимизировать?
Ответ: Основные риски — увеличение объема хранения, сложность ETL, производительность запросов к истории и вопросы безопасности. Минимизировать можно за счет архитектурной 분리, использования архивов, продуманных тестов и мониторинга, а также применения подходящих инструментов (lakehouse‑платформы, dbt, orchestration).
Вопрос: Что лучше выбирать для начинающего проекта — Type 1 или Type 2?
Ответ: Для новичка чаще разумнее начать с Type 1, чтобы быстро увидеть результаты текущего состояния. Но если бизнес ожидает аудит и анализ изменений во времени, стоит перейти к Type 2 или добавить Type 3/4 как компромисс. В любом случае рекомендуется сначала провести пилот и определить требования к истории.
Вопрос: Какие шаги предпринимать при миграции существующей схемы к новому типу SCD?
Ответ: Планируется миграция на нескольких этапах: (1) анализ текущего состояния и требований к истории, (2) проектирование новой схемы и ETL‑потоков, (3) создание миграционного плана с минимизацией простоев, (4) тестирование на тестовом окружении, (5) поэтапный запуск в продакшн с мониторингом и откатами, (6) обновление документации и обучающие материалы для команды.
Вопрос: Как начать внедрение SCD в нашей организации?
Ответ: Начните с формирования требований к истории по каждой dimension, затем выберите тип SCD для каждой из них, спроектируйте архитектуру и ETL, подготовьте пилотную реализацию в тестовой среде, проведите тесты и оценку производительности, настройте мониторинг и регуляторные политики, после чего переходите к полномасштабному развёртыванию.
Этот материал охватывает теорию, методологии, практические примеры, технические детали и риски, связанные с выбором типа SCD под бизнес‑требования. В реальном проекте важно адаптировать эти принципы под конкретную предметную область, инфраструктуру и регуляторные требования компании.


