

Архитектура данных для DDP: интеграция BI, DWH и Distributed Deception Platform (DDP)
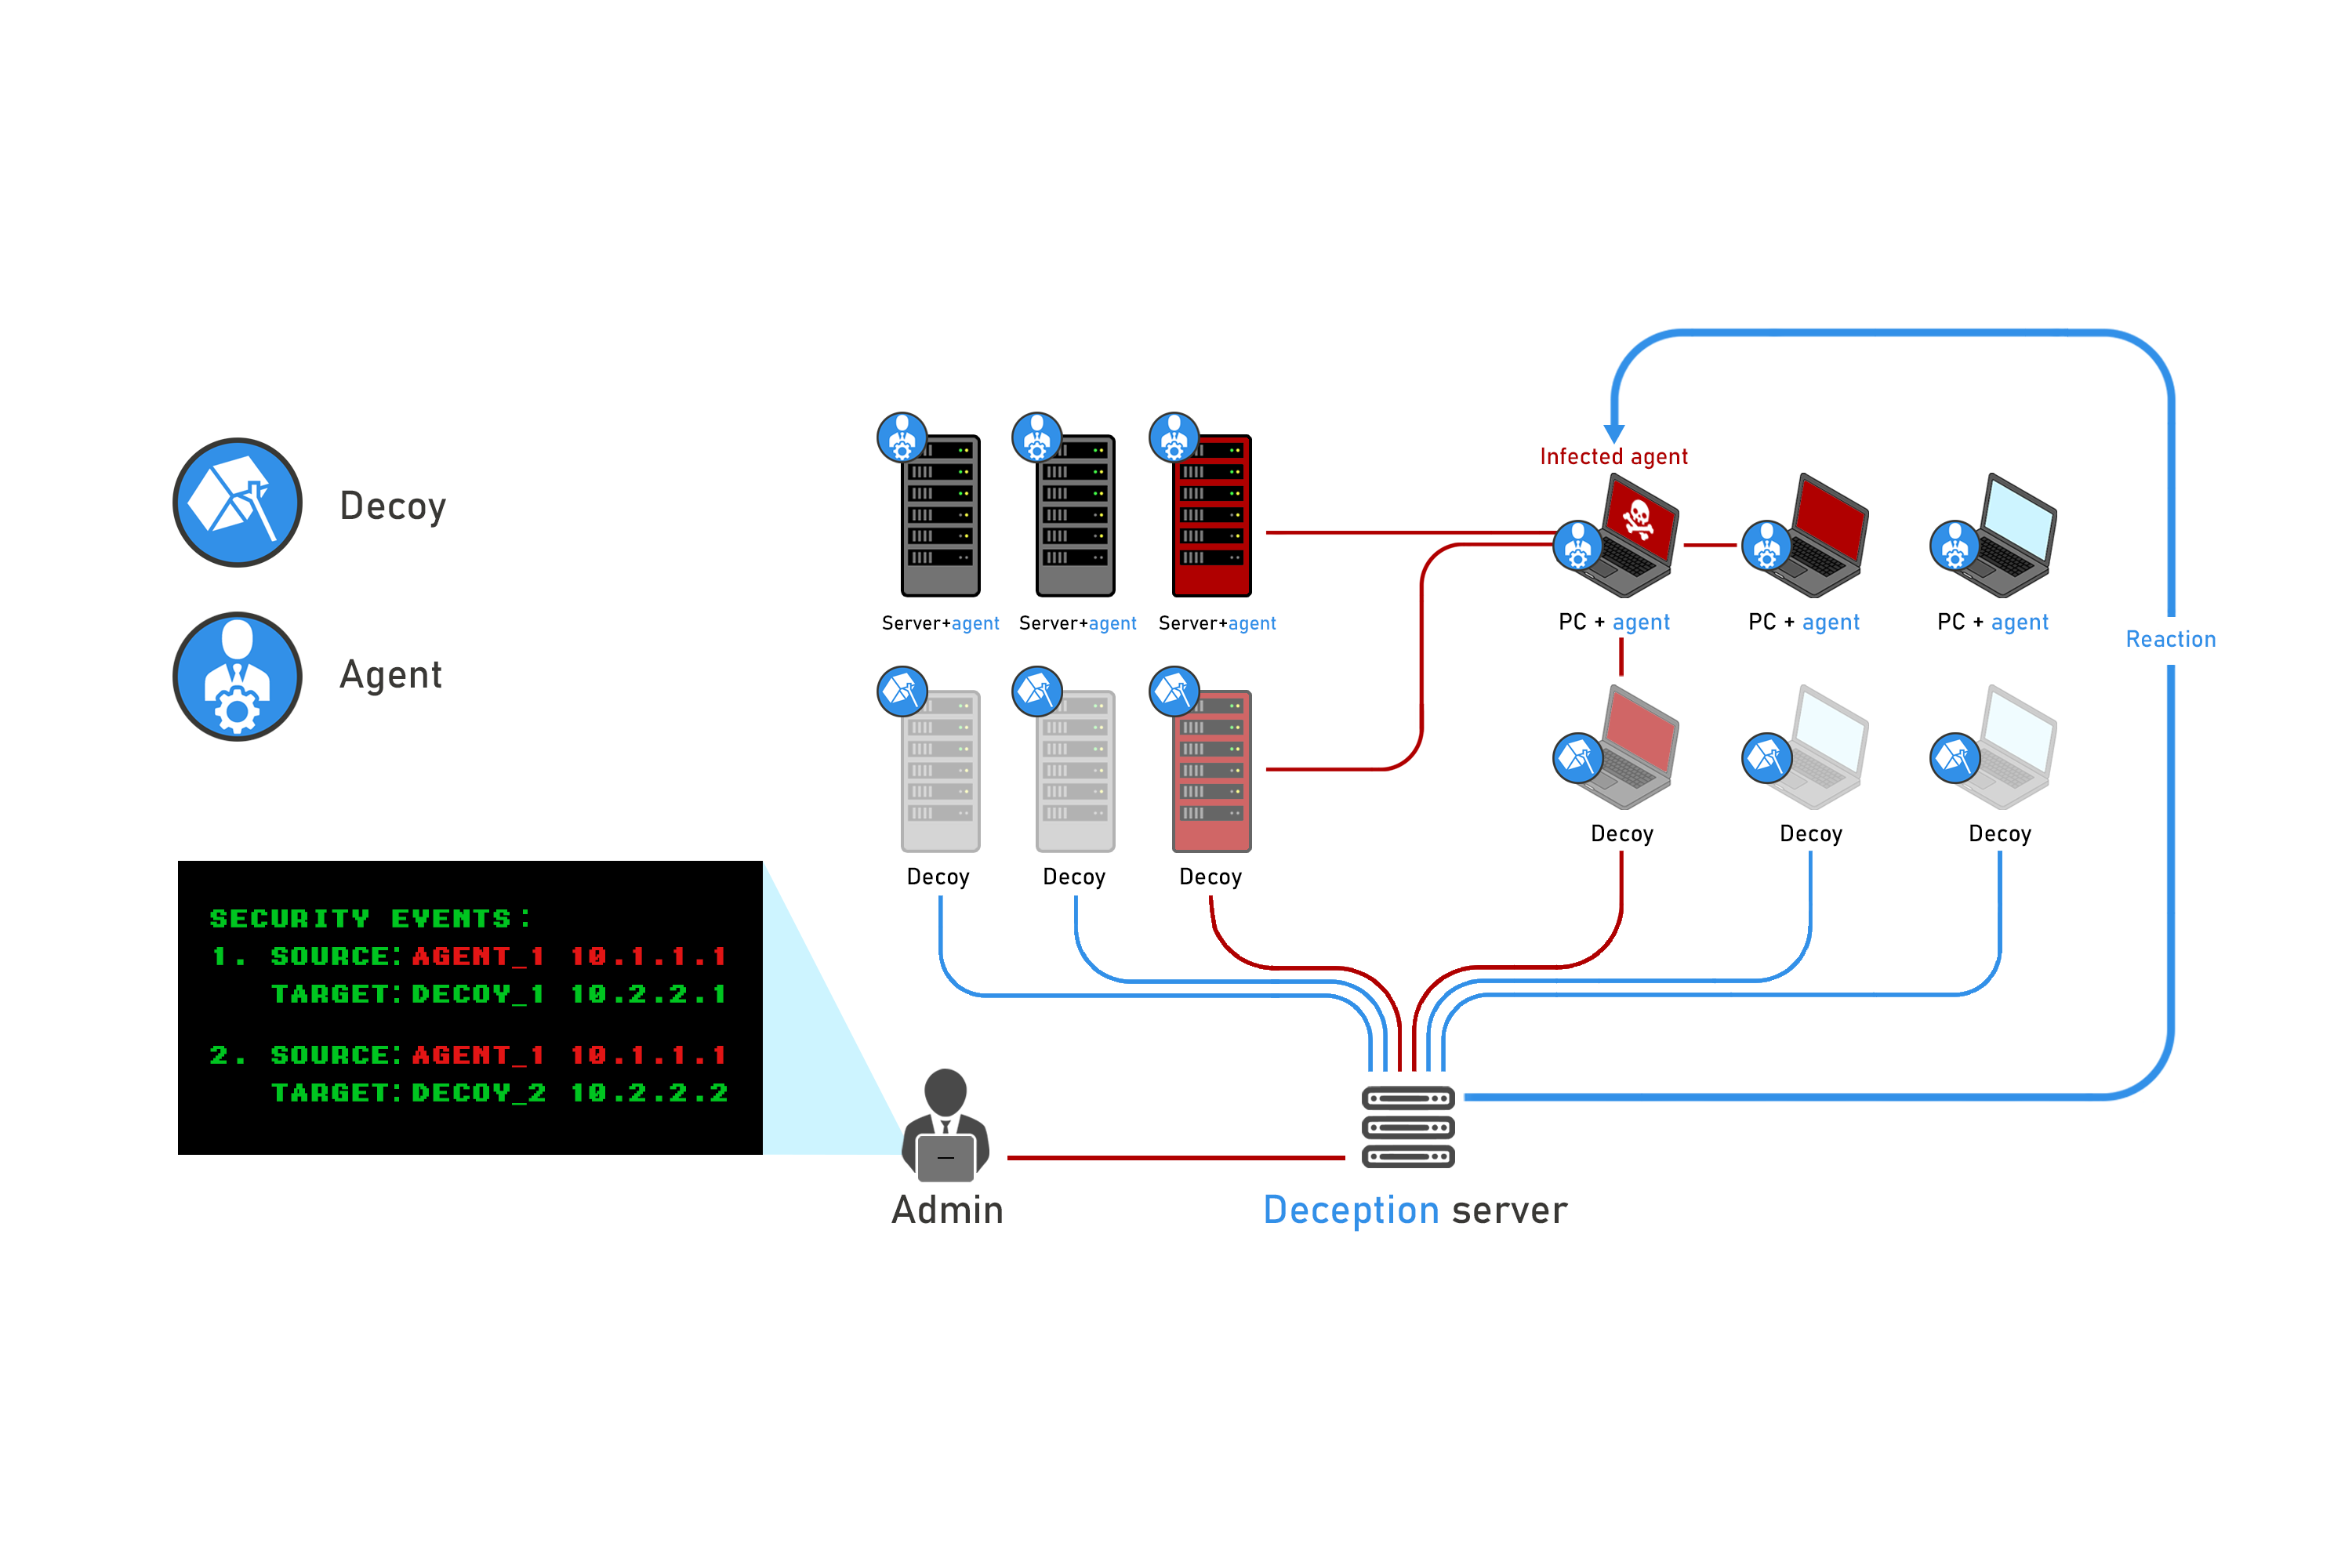
Современная организация часто сталкивается с необходимостью объединить бизнес-интеллект (BI), хранилище данных (DWH) и передовую технологию Distributed Deception Platform (DDP). BI дает возможность бизнес-аналитикам и руководителю видеть общую картину по ключевым показателям, DWH обеспечивает единый источник правды и управляемые данные для отчетности, а DDP добавляет слой защиты и разведки за счет децой (ложных объектов) и генерации телеметрии, которую можно анализировать для повышения устойчивости к киберугрозам. Взаимная дополняемость этих подходов позволяет не только строить эффективные аналитические панели, но и получать сигналы об аномалиях, подозрительных сценариях и попытках злоумышленников взаимодействовать с атакованными моделями в среде организации. Архитектура данных для DDP должна обеспечивать надежный поток данных между источниками, переработку и нормализацию телеметрии, хранение в безопасном DWH и доступ BI-слоя, а также обратную связь от аналитики к управлению ловушками и поверхностями обмана. Главная задача главы — показать, как проектировать такие интеграции: какие слои архитектуры выбрать, какие сущности данных моделировать, какие стандарты и практики внедрять, чтобы обеспечить устойчивость, безопасность и масштабируемость.
Термины и концепции
- Архитектура данных: совокупность принципов и моделей, определяющих, как данные в организации консолидируются, хранятся, обрабатываются и используются для принятия решений. В контексте DDP архитектура должна объединять слои источников данных, инжекции данных, хранилище и аналитическую поверхность, а также слой действий платформы обмана.
- BI (Business Intelligence): совокупность инструментов и методологий, предназначенных для конверсии данных в управленческую информацию, представления в дашбордах, отчетах и прогнозах.
- DWH (Data Warehouse): централизованное хранилище структурированных данных для аналитики. В DWH обычно применяются схемы «звезда» или «снежинка», агрегации и исторические данные.
- ETL/ELT: процессы извлечения, трансформации и загрузки данных. В эпоху больших данных часто применяется ELT (перенос данных в целевое хранилище без предварительной трансформации), чтобы использовать вычислительные мощности DWH или аналитического слоя для обработки.
- Data Lake: невструктурированные и полуструктурированные данные, хранящиеся в сыром формате; служит источником для анализа и подготовки данных перед загрузкой в DWH.
- Data Mesh/Data Fabric: подход к распределенной обработке данных, где ответственность за данные лежит на разных доменных командах (data owners), и взаимодействие между ними упрощается через стандартизированные объекты и сервисы.
- Data Catalog и Data Lineage: каталог метаданных и прослеживаемость происхождения данных, позволяющие понять, откуда взялись конкретные значения и как они преобразовывались.
- Data Governance и Compliance: правила управления данными, доступами, качеством, политиками хранения и защиты информации в соответствии с требованиями регуляторов.
- Deception и Distributed Deception Platform (DDP): набор техник обмана и ловушек в информационной среде, которые задерживают и отслеживают злоумышленников, создают ложные поверхности и фальшивую ценность, собирают телеметрию и сигналы для реагирования. DDP может взаимодействовать с данными из BI/DWH для определения эффективности стратегий обмана и корректировок политики.
Архитектурные паттерны интеграции BI, DWH и DDP
- Потребность в единном слое телеметрии: DDP генерирует события об атакуемых поверхностях, сервисах и взаимодействиях. Эти события должны попадать в DWH и BI-пайплайны для анализа, что позволяет корректировать настройки ловушек и сценариев. В ответ BI может формировать дашборды, показывающие эффективность обманной инфраструктуры и риск-метрики.
- Разделение зон ответственности: данные источников и телеметрия проходят через слой инжекции и обработчиков, после чего попадают в DWH для хранения и в BI-суррогаты для аналитики. Одновременно часть телеметрии может направляться в SIEM/EDR для более оперативной реакции и корреляции с инцидентами.
- Модульность и масштабируемость: использовать микросервисы и сервис-ориентированную архитектуру, где каждый модуль отвечает за конкретную часть — ingestion, transformation, storage, analytics, deception control, monitoring.
- Категоризация данных: различать данные бизнес-аналитики (например, продажи, финансы) и данные телеметрии DDP (события об атакующих попытках, контекст ловушек, данные об обманных ресурсах). В DWH эти данные могут храниться в разных слоях, обеспечивая легкую сегментацию и управление доступом.
- Управление данными и безопасность: строгая модель доступа (least privilege), шифрование на транспортном уровне и в покое, аудит действий пользователей и сервисов, управление секретами (secret management) и безопасная интеграция между слоями.
Модели данных и схемы на практике
- Факт- и справочные таблицы для телеметрии: факт-таблица "FactTelemetryEvent" с полями timestamp, source, event_type, decoy_id, session_id, user_id, ip_address, payload_hash и т.д. Декоративная таблица "DimEventType", "DimSource", "DimDecoy", "DimUser".
- Данные DDP в BI: витрина или слой представлений, который агрегирует телеметрию в безопасной форме, где можно строить метрики вроде коэффициента конверсии обманных поверхностей, времени реакции на инцидент, точности идентификации ложных событий.
- Метаданные и линейность: через Data Catalog (Amundsen, Apache Atlas и т.д.) хранить схемы сущностей, зависимости, версионирование моделей данных, обеспечивать прослеживаемость (data lineage) для аудита и соответствия.
Технические ролики и механизмы реализации (обобщённо)
- В качестве источников данных используются как бизнес-операционные системы, так и телеметрия DDP. В качестве транспорта чаще всего применяется Apache Kafka, а для хранения — ClickHouse как мощное колоночное DWH, S3 или локальные данные Lake.
- Интеграционная платформа: ETL/ELT-пайплайны через Apache Airflow или Dagster (или их аналоги). Для реального времени — потоковая обработка через Apache Flink или Spark Structured Streaming.
- Аналитика и BI: Metabase или Apache Superset в качестве фронтендов BI; доступ к данным через прямые подключения к ClickHouse или через слой бизнес-логики API.
- Каталог и управление данными: Amundsen/Apache Atlas для метаданных и lineage, Dbt для управляемых трансформаций и тестирования качества данных.
- Безопасность и управление доступом: интеграция с системами IAM, роль-based access control (RBAC), шифрование TLS/SSL для потоков и шифрование данных в покое (AES-256 и аналоги), управление секретами через Vault или аналогичные системы.
Практические примеры (open-source и российские решения)
Пример 1. Открытая стековая архитектура
- Источники данных: системные логи, сетевые события, события DDP, данные пользователей.
- Ингест: Apache Kafka как сервис сообщений для потоков телеметрии и бизнес-данных.
- Обработка: Apache Spark для пакетной трансформации и Flink для стриминговой обработки.
- DWH: ClickHouse как высокоскоростное колоночное хранилище, поддерживающее масштабируемые аналитические запросы.
- Data Lake: S3 совместимый хранилище или MinIO для хранения сырых данных.
- Оркестрация: Apache Airflow или Dagster, управление зависимостями и расписанием.
- BI: Metabase или Apache Superset для визуализации и анализа.
- Метаданные: Amundsen как каталог метаданных и lineage.
- Пример сценария: телеметрия DDP записывается в Kafka, затем в Spark преобразуется в схему фактов “FactTelemetryEvent” и попадает в ClickHouse для аналитики BI. Одновременно источник данных регистрируется в Amundsen. BI-слой может строить KPI по ловушкам и реакциям на инциденты, а сигналы анализа используются для регулировки политики обмана.
Пример 2. Росcийский контекст и локальные решения
- Базовые компоненты: ClickHouse как основное DWH, Kafka для потоков, Yandex DataSphere как платформа обработки данных и оркестрации ML/Аналитики, Metabase как BI-слой, Amundsen для каталогизации.
- Преимущества российского стека: локализация поддержки, возможность соответствия определенным регуляторным требованиям, гибкость в настройке инфраструктуры под российские сети и требования по локализации данных.
- Пример сценария: телеметрия об атакующих попытках через DDP поступает в Kafka, затем в ClickHouse и параллельно управляющий слой DDP в DataSphere обеспечивает обработку сигналов и адаптацию ловушек. BI-панели отображают динамику риска и эффективность обмана, администраторы получают уведомления и могут управлять конфигурациями ловушек через DataSphere management панели.
- Важные нюансы: лицензии и доступность поддержки, соответствие требованиям по локализации, совместимости между версиями компонентов и миграциями, тестирование на реальных данных при сохранении конфиденциальности.
Технические детали и дизайн-практики
- Структура данных: разделение по доменам (финансы, операции, безопасность) и по типам данных (операционные данные, телеметрия DDP, метаданные). В DWH строится витрина для аналитики и отдельная витрина для телеметрии, чтобы не перегружать BI-слой сложными событиями.
- Модели данных: реализация по принципу «факт-измерения» и «измерения» (Dim) — фактTelemetry, DimSource, DimDecoy, DimEventType, DimUser. Важно поддерживать версионирование схем и понятные названия столбцов.
- Эталонные процессы: ELT-пайплайн, где данные попадают в DWH в сыром виде, затем проводится трансформация с учетом качества. Трансформации должны быть тестируемыми через dbt или аналогичные средства.
- Метаданные и lineage: Amundsen/Atlas регистрируют источники, зависимости трансформаций, версии схем. Это особенно важно для обеспечения прослеживаемости телеметрии и контроля доступа к данным, чтобы изменить только легитимную часть бизнес-аналитики.
- Ключевые показатели качества данных: уровень полноты данных, точность телеметрии DDP, задержки обработки, доля ошибок. Внедряются тесты качества функций и ограничительные правила.
- Безопасность данных: шифрование в транспортировке и на покое, настройка RBAC-сценариев, аудит действий. В DDP особое внимание к этическим и юридическим ограничениям на сбор и использование телеметрии, особенно если она включает данные пользователей.
- Управление версиями и развёртывание: инфраструктура как код (IaC), использование Terraform/Ansible для развёртывания кластеров, версионирование конфигураций и откат.
- Масштабируемость и отказоустойчивость: горизонтальное масштабирование компонентов (Kafka, Spark/Flink, ClickHouse), репликация данных, мониторинг и алертинг (Prometheus, Grafana, Zabbix). План резервного копирования и дублирования данных, сценарии восстановления после сбоев.
- Производительность BI: кэширование, оптимизация запросов к DWH, материализованные представления, индексы в ClickHouse, настройка пулов соединений. В BI-слое следует предусмотреть безопасный доступ и ограничение на загрузку больших наборов данных в клиенты BI.
Риски и ограничения внедрения
- Риски архитектуры: чрезмерная сложность, неясная ответственность за данные между доменами, риск несогласованных изменений схем, что может привести к несостыковкам в телеметрии и отчетности.
- Безопасность и комплаенс: хранение телеметрии может содержать чувствительные данные. Нужно обеспечить минимизацию объема персональных данных, контроль доступа и аудит. Необходимо соответствие требованиям регуляторов (например, локализация данных, хранение и обработка персональных данных).
- Скорость изменений и устойчивость: внедрение DDP требует тестирования и управления конфликтами между обновлениями в BI и DWH и обновлениями систем обмана. Частые изменения в ловушках требуют внимательного управления конфигурациями.
- Технические ограничения: задержки в потоках данных, задержки в обработке телеметрии, ограничения вычислительных ресурсов в кластерных средах. Необходимо продуманное планирование ресурсов и мониторинг.
- Интероперабельность компонентов: в open-source стеке возможны несовместимости версий, миграции между версиями и зависимость от сообщества поддержки. В российском контексте — дополнительные требования к локализации и сертификации, а также аспекты эксплуатации в рамках корпоративной инфраструктуры.
- Этические и юридические риски: обманная инфраструктура должна предотвращать злоупотребления, не создавать ложные угрозы для законных пользователей и не ухудшать бизнес-процессы. Важно аудит и проверки соответствия политики обмана корпоративным нормам и регуляциям.
- Управление данными и качество: риск плохого качества входных данных, чтоскажает аналитические выводы и решения. Необходимо внедрять тесты на качество данных, поддержку lineage и автоматизированную валидацию трансформаций.
- Вопросы приватности: телеметрия DDP может содержать данные о пользователях и активности. Нужно обеспечить минимизацию сбора данных, анонимизацию, агрегирование и защиту конфиденциальной информации.
- ROI и управляемые итерации: внедрение DDP — долгосрочная инвестиция. Рекомендуется старт с MVP, чтобы быстро получить ценные данные и проверить гипотезы об эффективности обмана, а затем расширять функциональность.
Архитектура данных для интеграции BI, DWH и DDP требует продуманного подхода к данным, их потокам, управлению метаданными и безопасностью. Принципы модульности, разделения ответственности, прослеживаемости и управления качеством являются фундаментом устойчивой реализации. Эффективная интеграция BI и DWH с DDP позволяет не только строить аналитическую картину по бизнесу, но и оперативно адаптировать стратегию обмана по мере развития угроз, что усиливает киберзащиту и улучшает показатели безопасности. Важным аспектом является выбор стека — сочетание открытых технологий (Kafka, Spark, ClickHouse, Amundsen, Metabase, Superset) с отечественными решениями (ClickHouse как российское происхождение, Yandex DataSphere как российская платформа) для обеспечения локальной поддержки, соответствия регуляциям и управляемости инфраструктуры. Внедрение должно начинаться с пилота, обеспечивать качественную телеметрию и прозрачную линейность данных, чтобы достигать быстрых побед и постепенно расширять архитектуру на новые домены и сценарии обмана.
FAQ — Вопрос–Ответ
1) Что такое Distributed Deception Platform и как она сочетается с BI и DWH?
DDP — это набор техник обмана, ловушек и ложных поверхностей, предназначенных для задержки и видоизменения поведения злоумышленников, а также сбора телеметрии об их действиях. Интеграция с BI и DWH обеспечивает хранение телеметрии, ее анализ, визуализацию и поддержку решений по настройке ловушек. BI-дашборды дают бизнесу и администраторам оперативную картину эффективности обмана, а DWH служит единым источником правды, обеспечивает качество, аудит и соответствие данных.
2) Какие данные важны для DDP и как их безопасно хранить?
Важны телеметрические события об атаках, данные об взаимодействии с декой, контекст сети, временные метки и идентификаторы объектов. Безопасное хранение требует шифрования на транспорт и в покое, ограничение прав доступа, аудит и хранение минимально необходимого объема персональных данных. Необходимо хранить данные в изолированных слоях и обеспечить строгую политику доступа к DDP-данным для разных групп пользователей.
3) Какой стек технологий подходит для интеграции BI и DWH с DDP в открытом формате?
Открытый стек часто включает Kafka для потоков, Spark или Flink для обработки, ClickHouse как DWH, S3/MinIO как Data Lake, Airflow или Dagster как оркестратор, Metabase или Superset как BI-инструменты, Amundsen или Apache Atlas для каталога метаданных. Такой комплект обеспечивает масштабируемость, прозрачность и возможность безопасной интеграции между аналитикой и обманной инфраструктурой.
4) Какие риски связаны с внедрением и как их управлять?
Основные риски: сложность архитектуры, нарушение согласованности данных между слоями, проблемы с безопасностью и комплаенсом, задержки потоков, несовместимость версий, риски этики и приватности. Управлять ими можно через четкую архитектуру слоев, документирование и lineage, внедрение RBAC, контроль версий схем, пилотные проекты (MVP), тестирование трансформаций и постоянный мониторинг.
5) Какие примеры практического внедрения существуют в открытом и российском контексте?
Open-source: Kafka + Spark/Flink + ClickHouse + Airflow + Metabase/Superset + Amundsen. Российские решения: ClickHouse, Yandex DataSphere как платформа обработки и аналитики. В частности, ClickHouse широко применяется в российском сообществе за счет скорости и гибкости, а Yandex DataSphere может служить дополнительным средством orchestration и аналитики в рамках российского цифрового контекста.
6) Какой подход к моделям данных лучше применить для DDP и аналитики?
Рекомендуется использовать смешанную модель: фактовая таблица для телеметрии и декой, Dimension-таблицы для источников, типов событий, пользователей и поверхностей обмана. Важно иметь ясную схему линейности и версионирование, чтобы отслеживать происхождение данных и возможность аудита. В DDP можно также применять схемы « events-driven » и согласованно хранить события в DWH с периодическими агрегациями для BI.
7) Как сохранить приватность пользователей при использовании телеметрии DDP?
Необходимо минимизировать сбор персональных данных, использовать агрегацию и анонимизацию, реализовать политику минимизации данных. Важно проводить регулярную оценку рисков приватности, получать согласия, обеспечивать возможность удаления данных и соответствие требованиям регуляторов. В архитектуре лучше отделять персональные данные от телеметрии общих событий и ограничивать доступ к чувствительным данным.
8) Как оценивать эффективность внедрения DDP и интеграции BI/DWH?
Эффективность оценивается через показатели времени реакции на инциденты, точность идентификации ложных событий, количество сгенерированной телеметрии, улучшение в управлении ловушками и сокращение времени на подготовку отчетности. Важно формировать KPI в пилотной фазе и постепенно расширять их по мере роста архитектуры.
9) Какие требования к компетенциям сотрудников?
Необходимо сочетание знаний по BI и аналитике, DWH, управлению данными, безопасности и киберзащите, а также навыки DevOps и работы с облачными сервисами. Важно формировать межфункциональные команды: аналитиков, инженеров данных, специалистов по безопасности и инженеров по платформе DDP.
10) Какие шаги подходят для внедрения поэтапно?
Начинайте с MVP: определить ключевые источники телеметрии, создать базовую витрину в DWH и BI, реализовать базовый набор дашбордов по эффективному обману. Затем расширяйте набор источников и ловушек, добавляйте управление данными и линейность, улучшаем безопасность, вводим аудит и управление изменениями. Важна регулярная валидизация данных и адаптация к новым угрозам.


