

Источники данных и подготовка
Источники данных и подготовка являются базой для успешного внедрения методов и инструментов process mining. Без надежного, качественного и связного набора данных любые выводы из анализа процесса будут неполными или вводящими в заблуждение. В этой главе мы рассмотрим, какие данные чаще всего служат исходной базой для майнинга процессов, какие характеристики этих данных критичны для корректности анализа, какие этапы подготовки данных необходимы, какие методики и стандарты применяются на практике, а также приведём примеры реализации на открытых и отечественных решениях. Мы начнем с определения основных понятий, затем перейдем к практическим подходам к сбору и очистке данных, и завершим обзором рисков и ограничений, с которыми сталкиваются команды внедрения.
Основные термины и концепции
- Process mining: область анализа бизнес-процессов по данным, получаемым из систем учета и регистрирования событий. Она позволяет восстанавливать реальную последовательность действий, выявлять узкие места, отклонения и варианты исполнения процессов.
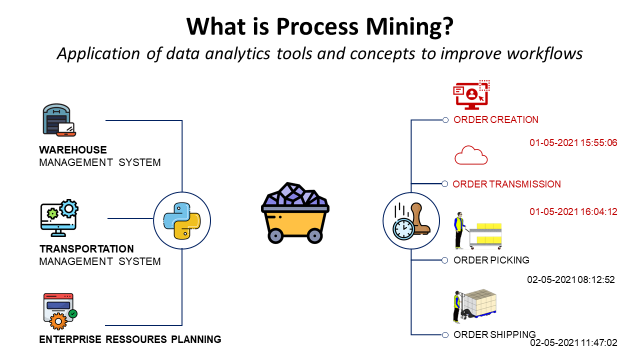
- Источник данных для майнинга: любая система или набор систем, в которых регистрируются события или транзакции и которые содержат временные метки. Наиболее частые источники: ERP (планирование ресурсов предприятия), CRM, WMS/TMS, финансовые системы, IT-системы управления услугами (ITSM), билетные системы, сервисные и производственные журналирования, ETL-пайплайны и данные логов веб-приложений.
- Лог событий (event log): структурированная запись, представляющая последовательность событий, сгруппированных по идентификатору дела (case_id). Каждое событие имеет атрибуты: activity (действие), timestamp (время события), और иногда ресурс (кто выполнил действие), coste/amount, и дополнительные атрибуты.
- Форматы и стандарты: XES (XML-based standard для представления event logs), CSV/Parquet как удобная промежуточная форма, proprietary форматы систем; перевод между форматами необходим для совместной работы разных инструментов.
- Качество данных: полнота (missing data), точность временных меток, согласованность идентификаторов, дубли, временная последовательность, нулевые или аномальные значения. Низкое качество данных может привести к неверной реконструкции процесса и неверным выводам.
- ETL и подготовка: процессы извлечения, преобразования и загрузки данных, нормализация схем, консолидация идентификаторов, устранение дубликатов, привязка ко времени, приведение к единому часовому поясу, обеспечение линковки между источниками.
- Гигиена данных и конфиденциальность: очистка личной информации, анонимизация, минимизация доступа к чувствительным данным, согласование с регуляторикой (например, требования по защите персональных данных, ГОСТ/ФСТЭК в РФ), применение принципа минимального доступа.
Типы источников данных и их характеристики
- ERP: данные по закупкам, продажам, запасам, счетам, оплатам. Часто содержат ID транзакций, даты событий и связи между документами (заказ — оплату — отгрузку). В ERP могут быть обеспечены обычные периоды жизни операций.
- CRM: данные по взаимодействиям с клиентами, статусам сделок, звонкам, встречам. Хороший источник для анализа исполнительных процессов на фронт-офисе.
- WMS/TMS: данные о логистике, перемещениях грузов, маршрутах, погрузке-разгрузке. Внесение событий с привязкой к складам и транспортным единицам.
- ITSM и сервис-инфраструктура: заявки, инциденты, изменения, обслуживание. Полезны для процессов поддержки и обеспечения услуг.
- Логи приложений и инфраструктуры: веб-сервисы, API, данные аудита, pipeline-логи. Эти данные помогают понять техническую сторону процессов и автоматизацию.
- Финансовые системы: платежи, проводки, контроли. В некоторых случаях важны для контекстной аналитики затрат.
- Специализированные источники: BI-дашборды, ETL-ленты, дата-архивы, внешние сервисы.
Методология подготовки данных
- Шаг 1: Определение цели анализа и границ процесса. Решите, какие дела будут моделироваться, какие ресурсы и временной диапазон нужны для интерпретации.
- Шаг 2: Выбор источников и идентификаторов. Определите, какие источники будут объединяться и какой clean key будет использоваться как case_id. Обычно это уникальные идентификаторы документов или заказов, иногда требуется составной ключ.
- Шаг 3: Извлечение данных. Получите необходимую выборку полей: case_id, activity, timestamp, и дополнительную информацию (resource, cost, location). Важно сохранить временные метки с максимально возможной точностью.
- Шаг 4: Приведение во временную систему. Приведите временные зоны к единому часовому поясу, нормализуйте формат времени, устраните неоднозначности в временных метках.
- Шаг 5: Нормализация и согласование схем. Приведите названия полей к единому формату, сопоставьте названия активностей и идентификаторы ресурсов между источниками.
- Шаг 6: Объединение источников и создание базового event log. Объедините данные по case_id и упорядочите события по времени. Убедитесь, что для каждого дела соблюдена последовательность событий.
- Шаг 7: Очистка данных. Удалите дубликаты событий, исправьте некорректные временные метки, отметьте пропуски и заполните недостающие значения там, где это возможно без нарушения достоверности.
- Шаг 8: Обогащение и обоснование атрибутов. Добавьте дополнительные атрибуты, которые могут быть полезны для анализа: ответственное подразделение, стадия процесса, длительности между шагами, стоимость выполнения и т.д.
- Шаг 9: Верификация качества. Выполните проверки на полноту (есть ли заказы без событий?), на корректность структуры (нет ли противоречий во времени между связанными событиями?) и на согласованность идентификаторов.
- Шаг 10: Преобразование в формат для майнинга. Преобразуйте готовый набор данных в формат, поддерживаемый выбранным инструментом майнинга (XES или CSV). Убедитесь, что поля соответствуют требованиям инструмента к названию и порядку.
- Шаг 11: Документация и трассируемость. Введите метаданные о источниках данных, версиях схем, датах выгрузок и применяемых преобразованиях, чтобы обеспечить воспроизводимость анализа.
- Шаг 12: Обеспечение безопасности и соответствия. Оцените чувствительные данные, ограничьте доступ и применяйте меры по защите данных, соответствуя локальным требованиям.
Технические детали и практические примеры
Общие принципы реализации
- Этапы сбора и очистки данных могут выполняться как локально в рамках дата-центра, так и в облаке. В России часто предпочтительно локальное развёртывание в рамках ГОСТ/ФСТЭК требований, с контролируемыми сетями и ограничением выведения данных за пределы страны.
- Для совместимости между системами удобно использовать промежуточные форматы: CSV как простой обменной формат и XES для самого майнинга. В некоторых случаях целесообразно хранить данные в Parquet для эффективной обработки больших объемов.
- Важна единая модель идентификаторов: case_id (идентификатор дела), activity (название операции/действия), timestamp (время), resource (ответственный сотрудник или система). Дополнительные атрибуты следует вести как необязательные поля, к которым можно обратиться по мере необходимости.
- Валидация и качество данных — постоянный процесс. Рекомендуется внедрить цикл Data Quality в процесс эксплуатации майнинг-системы: периодическая проверка на полноту, точность, дубликаты и несовпадения между источниками.
Практический пример 1: открытый стек на базе PM4Py и Apromore (open-source)
- Сценарий: анализ процесса обработки заказов в компании, включающий два источника: ERP (заказы и оплаты) и CRM (фазы обслуживания клиента). Цель: реконструировать жизненный цикл заказа и выявлять узкие места.
-
Этапы реализации:
- Извлечение данных: выгрузка заказов и оплат из ERP: поля case_id (order_id), activity (order_created, order_paid, order_shipped, order_delivered), timestamp, ресурс; выгрузка взаимодействий из CRM: order_id, activity (customer_contacted, support_followup), timestamp, агент.
- Нормализация: приведение всех названий активностей к единому словарю, привязка к одному case_id в обеих выборках.
- Объединение и создание event log: в результате получаем таблицу с полями case_id, activity, timestamp, resource, source (ERP/CRM), и дополнительные атрибуты.
- Преобразование в XES/CSV: сохраняем в формате XES для PM4Py/ProM или в CSV, если планируется последующая обработка в Python.
- Очистка: устранение дубликатов событий, коррекция временных меток, удаление пропусков в критических полях.
- Анализ: запуск простого контура процессной модели в PM4Py или Apromore, анализ доли случаев, времени цикла, выявление петлей и больших задержек.
- Технические детали: PM4Py позволяет загрузить CSV и автоматически построить знакомый клон графа процесса; Apromore (community edition) предоставляет визуальный интерфейс для реконструкции модели, фильтрацию по атрибутам и анализ соответствий.
- Преимущества: линейный путь к результату, открытые инструменты, хорошая поддержка сообщества, возможность локального развёртывания.
- Ограничения: требует навыков работы с Python и базовыми знаниями в области процесса майнинга; качество данных критично.
Практический пример 2: российские решения и локализация
- Сценарий: внедрение майнинга процессов в крупной компании в РФ с требованиями локализации данных и соблюдения ГОСТ/ФСТЭК. Цель — автоматизировать анализ выполнения ключевых бизнес-процессов и соответствие нормативам, а также минимизировать риск утечек данных.
-
Подход: настройка локального стека, где данные из ERP/1C:ERP и ITSM собираются в рамках отечественных дата-центров под контрольلمي администратора. Вместо полного перехода на англоязычные облачные сервисы выбираются отечественные решения интегратора, которые обеспечивают:
- локализацию хранения event logs и метаданных;
- интеграцию с российскими средствами идентификации и сетевой безопасностью;
- поддержку протоколов передачи логов и безопасную маршрутизацию в рамках локальной инфраструктуры
- Реализация: сбор событий из ERP и ITSM через отечеальные коннекторы, нормализация полей case_id и activity, добавление атрибутов, важных для локальных регуляторов (например, подразделение, проект, код договора), преобразование в формат, совместимый с локальным майнинг-решением, и запуск анализа на внутритранзитной инфраструктуре.
- Роль отечественных решений: такие решения позволяют соблюдать требования к данным, обеспечивать сертификацию и контроль доступа, а также интегрироваться с инфраструктурой заказчика — например, через локальные хранилища logs, локальные индексы и локальные ворота доступа. В рамках проекта обычно применяется гибридный подход: открытые инструменты для анализа (например, PM4Py) и отечеальные платформы для хранения и визуализации, адаптированные под регуляторные требования.
- Преимущества и ограничения: высокая соответствие требованиям РФ, контроль над данными, возможность детальной адаптации под корпоративные регламенты. Недостатки — более высокая стоимость и необходимость сотрудничества с отечественными системными интеграторами, а также возможные ограничения по функциональности и скорости обновлений по сравнению с международными open-source решениями на англоязычном сообществе.
Технические детали
- Форматы и конвертация: основной рабочий формат — XES, но часто используется и CSV/Parquet. Важно сохранить структуру case_id, activity, timestamp и атрибуты. Конвертация между CSV и XES может потребоваться, если интеграции между инструментами разные.
- Временные данные: одно важное требование — корректность временных меток. Разница между часовыми поясами и временными зонами может привести к неверной последовательности событий. Рекомендуется приводить все временные метки к единому часовому поясу и использовать UTC внутри логов, если это возможно.
- Очистка и дедупликация: дубликаты часто возникают при синхронизации между источниками или в результате повторной выгрузки. Важно различать повторные события и повторную запись одного события.
- Метаданные и атрибуты: помимо обязательных полей case_id, activity, timestamp, добавляйте атрибуты, которые могут быть полезны для анализа, например, подразделение, проект, указание лицензии/контракта, ответственный сотрудник, канал взаимодействия.
- Безопасность и соответствие: на уровне инфраструктуры применяйте принципы разделения полномочий, аудит доступа, шифрование в покое и в транзите, а также соблюдение локальных требований по обработке персональных данных и корпоративной безопасности.
-
Инструменты и стек:
- Open-source: PM4Py, ProM, Apromore community edition. Эти инструменты поддерживают работу с XES/CSV и позволяют строить процессную модель, анализировать конформность, задержки, варианты исполнения и т.д.
- Российские решения: в рамках локализации данные и панели анализа разворачиваются на отечественных серверах, часто в составе полного пакета от системного интегратора или в рамках ERP-платформы. Реализация обычно предусматривает локальные коннекторы к источникам (1C, ERP, ITSM), локальное хранилище и локальные компоненты визуализации и анализа.
Риски и ограничения внедрения
- Данные надёжности: данные могут быть неполными, непоследовательными или содержать пропуски. Это сильно влияет на качество реконструированной модели и выводов. Решение: внедрить процессы регулярного контроля качества данных, а также проектировать сбор данных с учетом минимально необходимого набора полей и идентификаторов.
- Временная несогласованность: различия между временными зонами, задержки и асинхронность между системами приводят к неверной последовательности событий. Рекомендация: унифицировать временные метки на входе и поддерживать единый формат времени.
- Дубли и ликвидная идентификация: дубликаты и несогласованные идентификаторы делают анализ сложнее. Необходимо обеспечить их дедупликацию и устойчивое сопоставление событий между источниками.
- Согласование бизнес-логики: Activities могут быть представлены по-разному в разных системах. Важно создать единый словарь активностей и определить правила нормализации имен.
- Законодательство и безопасность: особенно важна защита персональных данных, ограничение доступа к данным, соответствие требованиям ГОСТ/ФСТЭК, локализация и аудит доступа. В Российской практике это требует сотрудничества с ИТ-безопасностью и юристами.
- Сопротивление изменениям: сотрудники могут относиться скептически к новым методам анализа, сомневаясь в сохранении рабочих мест и смысле анализа. Рекомендация: внедрять майнинг как инструмент для улучшения процессов, участия людей и прозрачности, а не как средство контроля.
- Технические ограничения: на больших данных и сложных ландшафтах может потребоваться масштабируемая инфраструктура, параллелизация обработки и оптимизация SQL-запросов. Внесение изменений в существующие интеграции может требовать времени.
- Ресурсные ограничения и стоимость: реализация процесса подготовки данных и майнинга требует ресурсов, времени и навыков. Важно планировать пилоты и поэтапное внедрение, чтобы управлять рисками и стоимостью.
Источники данных и подготовка — это ключ к корректному анализу процессов с применением методов майнинга. Ключевые принципы: четко определить цели, выбрать источники, обеспечить консолидацию и качество данных, а затем безопасно и прозрачно преобразовать данные в формат, пригодный для майнинга. В рамках практикиopen-source решения в сочетании с локальными или отечественными платформами позволяют компании быстро начать пилотный анализ, выявлять узкие места и проводить управляемые итерации по улучшению процессов. Важно помнить, что качество данных, грамотная подготовка и правильное управление проектом — залог успешного внедрения и устойчивого эффекта.
- В большинстве предприятий источники данных для process mining — это сочетание ERP/CRM/WMS/ITSM и логов приложений. Создание качественного event log требует точной идентификации кейсов, аккуратной привязки к времени и согласования между источниками.
- Подготовка данных — это не одноразовый акт, а повторяющийся цикл: извлечение, нормализация, объединение, очистка, валидация и преобразование в формат майнинга.
- Технические решения варьируются от полностью открытых инструментов (PM4Py, ProM, Apromore community) до локальных российских стэков, обеспечивающих соответствие требованиям государства и безопасности. Выбор зависит от регуляторных требований, инфраструктуры и целей анализа.
- Риски внедрения связаны с качеством данных, правовой и нормативной базой, скоростью изменений в процессах, а также с необходимостью подготовки персонала. Управление этими рисками требует планирования, пилотирования и соответствующей коммуникации с бизнес-воротами.
- Практический подход к внедрению в РФ должен учитывать локализацию данных, безопасность и соответствие требованиям, а также сотрудничество с отечественными системными интеграторами, которые помогают адаптировать инструменты под регуляторные рамки.
FAQ — Вопрос–Ответ
1) Что именно считается источником данных для process mining и зачем важно их качество?
Источники данных — это системы, которые регистрируют события в ходе исполнения бизнес-процессов: ERP, CRM, WMS, ITSM и логи приложений. Качество данных определяет корректность реконструкции процессов: полнота, точность временных меток, отсутствие дубликатов и консистентность идентификаторов. Плохое качество приводит к неверной модели, неверным задержкам и ошибочным управленческим выводам.
2) Какие форматы рекомендуется использовать для event logs и почему?
Чаще всего используют XES как стандартный формат для майнинга: он поддерживает структурированные события, кейсы и атрибуты. CSV/Parquet часто применяются как промежуточный формат для извлечения и подготовки, потому что они проще обрабатывать в ETL-слое. Далее формат приводится к XES или импортируется напрямую в инструмент майнинга. Важно обеспечить наличие полей case_id, activity и timestamp.
3) Как организовать процесс подготовки данных на практике?
Сначала определить границы процесса и набор кейсов. Затем выбрать источники и идентификаторы для case_id. Далее извлечь данные, привести временные метки к единому часовому поясу, нормализовать названия активностей, объединить источники по case_id, провести дедупликацию и очистку. В конце преобразовать к формату майнинга и документировать все преобразования. Важна обратная связь с бизнес-частью для корректировок и верификации.
4) Какие инструменты можно использовать на открытом рынке?
Open-source инструменты: PM4Py (Python-библиотека для анализа процессов), ProM (пакет плагинов), Apromore Community Edition (интерфейс и инструменты анализа). Эти решения позволяют строить процессные модели, анализировать конформность, вычислять метрики задержек, времени цикла и соответствий между реальным исполнением и моделью.
5) Что учитывать при внедрении process mining в российских условиях?
Необходимо учитывать локализацию данных, требования к безопасности и законодательство РФ. Часто применяют локальные развёртывания и интеграцию с отечественными ERP-системами (например, 1C и другие российские платформы). Важно выбирать решения, которые поддерживают локализацию интерфейсов, соответствие требованиям по хранению данных и аудиту доступа, а также работают с российскими каналами передачи данных.
6) Какие риски связаны с внедрением и как их минимизировать?
Ключевые риски: низкое качество данных, неполные наборы, несоответствие загруженных событий реальной последовательности, нарушение конфиденциальности и регуляторных требований, высокий уровень сопротивления изменениям. Чтобы минимизировать риски, внедряйте пилотные проекты, создавайте процесс управления качеством данных, обеспечьте защиту данных и прозрачность для бизнес-пользователей, обучайте команду и устанавливайте управляемые роли и доступы.
7) Какую роль играет data governance в Process Mining?
Data governance обеспечивает управляемость, качество и безопасность данных. В контексте process mining это означает определение источников и владельцев данных, регламенты по доступу, методы очистки и верификации данных, хранение истории изменений, а также обеспечение воспроизводимости анализа.
8) Можно ли начинать с простого пилота и постепенно масштабировать?
Да. Рекомендуется начать с минимального набора кейсов и проверки работоспособности пайплайна: извлечение данных, создание event log, проведение базового анализа и визуализации. По мере consolidations и доказательств эффекта можно расширять охват, добавлять новые источники и усложнять модели.
9) Как выбрать инструмент или стек для конкретной компании?
Выбор зависит от регуляторных требований, инфраструктуры и кадров. Открытые инструменты хороши для быстрого старта и гибкости, но требуют специалистов по данным. Российские решения обеспечивают локализацию и соответствие требованиям, но могут быть дороже и менее гибкими на этапе старта. Решение часто состоит в гибридном подходе: использовать открытые инструменты на локальной инфраструктуре и интегрировать их с отечественными платформами для хранения и визуализации.
10) Какие шаги сделать для начала пилота в компании?
Определите цель пилота (например, выявление задержек на этапе обработки заказов), сформируйте команду, соберите данные из 2–3 источников, подготовьте event log, проведите первый анализ в открытом инструменте, интерпретируйте результаты совместно с бизнес-заинтересованными лицами и подготовьте план расширения пилота. Важно документировать логи изменений, проделанные ETL-операции и принятые решения.


