

Модели данных и метаданные
Данная глава посвящена основам работы с моделями данных и метаданными в контексте внедрения и использования Process mining. Process mining опирается на реальные данные о ходе бизнес-процессов, поэтому качество и структура данных — ключевые факторы успешности проекта. Здесь мы разберем, что такое модели данных в процессе майнинга, какие существуют типы метаданных и зачем они нужны, какие форматы логов используются в индустрии, какие open-source и отечественные решения помогают воплотить идеи в жизнь, а также обсудим практические подходы к организации данных в компании, роли команд, ответственность за качество данных и принципы безопасности.
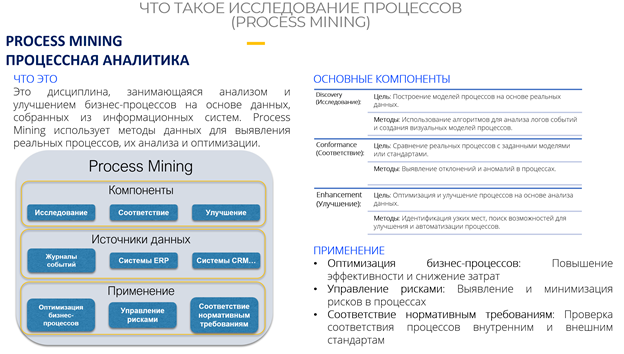
Основные концепции моделей данных для Process mining
- Event log как основа: в процесс майнинге лог событий представляет собой последовательность записей, где каждый элемент содержит как минимум идентификатор случая (case-id), наименование активности (activity), временную метку (timestamp) и ресурс (resource). Дополнительные атрибуты могут включать идентификатор заказа, подразделение, клиента, продукт, статус и т.д. Эти данные необходимы для реконструкции жизненного цикла процесса и построения моделей.
- Traces и events: traces — последовательности событий, представляющие маршрут одного случая через процесс. Events — сами точки во времени, связанные с определённой активностью и кейсом. Совокупность traces образует полную картину процесса.
- Метаданные и provenance: метаданные объясняют происхождение и контекст данных. Это включает источники данных, методы извлечения, преобразования и загрузки (ETL), единицы измерения временных меток, настройку времени (timezone), версионность данных, а также параметры качества данных. Provenance (происхождение) позволяет отслеживать путь данных от источника до конечного анализируемого результата.
- Данные качества и ограничений: полнота, уникальность ключей, точность временных меток, согласованность значений атрибутов, дубликаты и пропуски. При майнинге неправильно заданные данные могут давать неверные модели и misleading insights.
- Модели данных процесса: къмнификация моделей, такие как BPMN, Petri nets, процессные деревья (Process Trees), а также теоретические и эвристические модели, применяемые в алгоритмах обнаружения (discovery). В процессе майнинга чаще всего полезны конверсии между структурами событий и графами процессов для визуализации и анализа.
- Форматы и стандарты: XES (eXtensible Event Stream) — стандартный формат для хранения логов событий, который поддерживает расширяемость атрибутов и обеспечивает переносимость между инструментами. CSV/JSON логи широко применяются на практике на этапе подготовки, но для полноценной совместимости чаще используют XES или интегрированные форматы инструментов.
- Метаданные о процессах: словари процессов (process dictionaries), справочники деятельностей (activity catalogs), бизнес-правила и ограничения (например, допуски на переходы, временные лимиты), а также метаданные о версиях процессов и изменениях в процессной карте. Эффективная работа со словарями снижает расхождения между разными системами и упрощает сопоставление логов из разных источников.
Что такое данные и метаданные в контексте Process mining
- Данные: сами логи, которые отражают фактическое исполнение процессов: кто, что, когда, в каком порядке. Надежные данные позволяют воспроизводить путь каждого случая и сравнивать реальные маршруты с идеальными моделями.
- Метаданные: информация о данных: источник, формат, преобразование, качество, контекст. Метаданные обеспечивают прозрачность в аналитике и помогают в аудите, повторном использовании и соблюдении требований regulators.
- Взаимосвязь между данными и метаданными: данные без контекста могут быть непригодны; метаданные позволяют понять, почему и как данные были собраны, какие трансформации применялись, и как интерпретировать результаты анализа.
Применение стандартов и схем моделирования
- Использование XES: обеспечивает единый формат для импорта и экспорта логов между инструментами. Расширения XES позволяют добавлять кастомные атрибуты (например, регион, канал продаж, тип клиента), сохраняя совместимость.
- Расширяемость метаданных: набор полей, которые можно добавлять к каждому событию или к каждому кейсу. Примеры: источники данных, версия комплектующего ПО, единицы измерения времени, согласование с бизнес-правилами.
- Модель процессов и их связь с логами: процессные модели (Petri nets, индикативные деревья) помогают визуализировать поток и анализировать узкие места. Сопоставление модели и лога оценивает соответствие реальности и ожидаемым процессам.
Терминология и методология
- Data governance: организация ролей и обязанностей по управлению данными, чтобы обеспечить качество и доступность данных для процессов майнинга.
- Data lineage и provenance: набор методов отслеживания происхождения данных и преобразований. В контексте Process mining это позволяет понять, как данные попали в лог, какие этапы обработки проходили и как это влияет на результаты майнинга.
- Quality checks: проверки полноты, точности временных меток, отсутствия дубликатов, согласованности значений атрибутов.
- Hierarchical data modeling: построение иерархий атрибутов (например, предприятие — подразделение — команда) для детализированного анализа и фильтрации в рамках анализа процессов.
- Data integration: интеграция логов из разных систем (ERP, CRM, MES, BPM-системы) с согласованием схем и сопоставлением идентификаторов кейсов.
Риски и вызовы на теоретическом уровне
- Неполные или неточные логи: пропуски, дубликаты и неверные временные метки приводят к искажению моделей.
- Разнородность источников: разные системы имеют разные схемы логов; требуется нормализация и привязка атрибутов к единым концепциям.
- Большие объёмы данных: масштабируемость хранения и обработки логов; качество анализа может снижаться без оптимизированной архитектуры.
- Правовые и этические ограничения: обработка персональных данных, конфиденциальная информация, требования локализации и защиты данных.
Практические примеры
1. Пример на open-source стеке: PM4Py и ProM
- Сценарий: крупная производственная компания хочет понять, как проходит обработка заказов от поступления до отгрузки. Источник логов — ERP-система и MES-устройства. Мы создаем единый event log в формате XES, где каждый кейс — это заказ; активность — шаг процесса (приём заказа, планирование, изготовление, контроль качества, отгрузка, счёт). Атрибуты: время начала и окончания шага, ответственный исполнитель, регион, тип заказа, статус заказа.
- Этапы реализации: сбор логов из ERP и MES, привязка идентификаторов кейсов (order_id) к общему плану, нормализация временных меток к единому часовому поясу, устранение дубликатов. Затем мы используем PM4Py для обнаружения модели с индикатором Inductive Miner и визуализации процесса. Сравниваем полученную модель с ожидаемой бизнес-логикой и ищем узкие места (например, задержки между этапами).
- Результаты и выводы: выявление узких мест, таких как задержки на этапе планирования и долгие переходы между стадиями в зависимости от региона. Рекомендации по изменению нарративов и перераспределению ресурсов.
2. Пример с ProM
- Сценарий: сервисная компания хочет понять, почему обращения клиентов не попадают в SLA. Лог событий содержит обращения, стадии выполнения, время начала/окончания, техников. В ProM загружается log в формате XES; применяется метод Inductive Miner для построения дерева процессов. Анализируется соответствие реального процесса эталону SLA и выявляются отклонения.
- Что даёт этот подход: наглядная карта путей клиента, список предпочтительных маршрутов и отклонения. В результате можно перераспределить ресурсы или переработать правила маршрутизации так, чтобы увеличить долю SLA-комплайенса.
3. Пример российского подхода: интеграция с отечественными ERP и локальная обработка
- Сценарий: региональная розничная сеть вынуждена соблюдать локальные требования по локализации данных и работать в рамках отечественных облачных и локальных инфраструктур. Источники: 1С:Предприятие, локальные базы данных, складские системы, CRM. Интерфейс пользователей приводит к большим объемам логов.
- Подход: собираем логи из 1С и сопутствующих систем, нормализуем поля, связываем события между системами через общие идентификаторы (case-id). Логи конвертируемы в формат XES. Использование российского ПО для обработки и визуализации: локальный PM-стек, ProM или PM4Py, развёрнутый в отечеких дата-центрах под требования локализации. Важно обеспечить доступ к инструментам через локальные сети и соблюдать требования ФСТЭН/Госстандарт.
- Что получает бизнес: возможность увидеть узкие места в цепочке поставок и клиентского обслуживания прямо в рамках отечественной инфраструктуры, с соблюдением локальных правил хранения данных.
4. Практический подход к данным и метаданным в кейсах
- Интеграция источников: ERP (например, 1С), CRM, MES, BPM-системы, файловые хранилища. Общее согласование полей: case-id, activity, timestamp, resource, а также дополнительная информация по бизнес-объектам (заказ, клиент, продукт, регион).
- Схема логов: структура должна позволять легкую связь для анализа: case-id — activity — timestamp — role — атрибуты процесса. Важно сохранять время события в одном временном масштабе (например, UTC) и хранить исходную временную метку для аудита.
- Метаданные: набор полей: источник лога, версия системы, схема данных, бизнес-правила, используемая временная зона, соответствие регуляторным требованиям, фильтры и этапы трансформации. Привязка к provenance-подходу: запись об операциях, которые выполнялись над логами во время их подготовки.
- Практические советы по качеству данных: де-дуplikatsiya, нормализация единиц измерения, устранение противоречий между полями, проверка временных последовательностей.
Структура данных и форматы
- Основной набор полей в log: case_id (идентификатор кейса), activity (название действия), timestamp (момент выполнения), resource (исполнитель), optional attributes ( regional, product_id, order_id, customer_id, status и т.д.).
- Форматы: XES как стандарт для хранения логов; CSV/JSON для промежуточной подготовки и передачи; возможность конвертации в XES для совместимости инструментов.
- Метаданные на уровне структуры: metadata о источнике, версии, конфигурации, операционной среде, консоли аудита.
Инструменты и решения (open-source)
- PM4Py: Python-библиотека для процесс майнинга, поддерживает загрузку логов, преобразование форматов, алгоритмы обнаружения процессных моделей, конвертацию в визуализацию, метрики и сравнение моделей. Хорошо подходит для гибкой интеграции в пайплайны данных.
- ProM: Универсальная платформа на Java с богатым набором алгоритмов обнаружения, соответствия моделей, анализа эффективности. Может работать как standalone, так и в виде плагинов в другие среды.
- Apromore: открытое решение для процесс майнинга, с удобной визуализацией и инструментами анализа. Поддерживает импорт XES, работу с моделями и метриками качества.
- Совместная работа инструментов: PM4Py и ProM часто используются вместе: PM4Py для подготовки данных и извлечения метрик, ProM — для расширенного анализа и визуализации.
Инструменты и решения (российские и локальные подходы)
Российские практики чаще ориентируются на локальные источники данных и отечественные инфраструктуры. В рамках российских проектов используются:
- 1С:Предприятие как источник событий: логи транзакций, операции по заказам, состояниям складам и т.д. Необходимо обеспечить конвертацию данных из 1С в единый формат события и дальнейшее использование в процесс майнинге.
- Локальные облака и дата-центры: развёртывание отечественных инфраструктур для хранения и обработки логов, соответствующих требованиям локализации и ФСТЭН.
- Интеграции с отечественными ERP и системами управления: настройка коннекторов к данным системам, преобразование и синхронизация полей для унификации моделей.
Практическая польза: соответствие требованиям к конфиденциальности, контроль над данными, возможность оперативной поддержки локальных бизнес-единиц.
Проектная архитектура данных и пайплайны
- Этапы: сбор логов из разных систем, нормализация полей, сопоставление идентификаторов кейсов, составление единого event log, сохранение логов в формате XES, анализ и визуализация.
- Применение W3C PROV или аналогичных подходов к provenance: документирование того, как данные были получены, какие преобразования применялись, какие версии инструментов использовались.
- Хранение и безопасность: шифрование при передаче и хранении, доступ по ролям, аудит изменений, соответствие локальным и международным требованиям по защите данных.
Примеры сценариев внедрения архитектурно
- Централизованный пайплайн: центральный накопитель логов, из которого данные подгружаются в анализ в PM4Py/ProM, результаты визуализируются в дашбордах. Преимущества: единая точка контроля качества; минусы: требует аккуратной настройки прав доступа и загрузки больших объемов данных.
- Децентрализованный пайплайн: локальные сервисы майнят на местах, данные агрегируются в центральном репозитории в виде агрегированных метрик и выборочных логов. Преимущества: уменьшение сетевой нагрузки и соблюдение локализации; минусы: синхронизация и согласование моделей может быть сложнее.
Риски и ограничения в техническом плане
- Проблемы качества данных: если логи неполные или содержат ошибки, процесс майнинга может привести к неверным заключениям.
- Разнородность и несовместимость форматов: необходимо стандартизировать логи и атрибуты, чтобы избежать потерь информации.
- Масштабируемость: при больших объемах данных требуется инфраструктура для хранения и обработки (Hadoop/Spark или облачные решения). Производительность алгоритмов майнинга может быть ограничена, особенно при применении сложных эвристических методов.
- Безопасность и правовые аспекты: обработка персональных данных требует соблюдения требований локальных законов и регуляций. В рамках российской локализации следует учитывать требования ФЗ-152 и ФСТЭН.
- Культурные и организационные риски: недопонимание бизнес-логики и путаница между подразделениями при сопоставлении процессов может привести к неверным выводам. Важно вовлекать бизнес-обладателей данных и устанавливать правила управления данными.
Практические руководства по внедрению
- Определение источников и полей: четко определить, какие системы будут служить источниками событий, какие поля критичны, какие дополнительные атрибуты нужны. Документировать это в приземленной спецификации.
- Нормализация и сопоставление идентификаторов: обеспечить единые идентификаторы кейсов и действий, чтобы случаи из разных систем можно сопоставлять.
- Контроль качества на каждом этапе: проводить проверки целостности данных, тестировать на кросс-системной совместимости, оценивать полноту и точность данных.
- Прозрачность и аудит: сохранять provenance и версионность лога, чтобы можно было повторить анализ и подтвердить результаты.
- Партнерство с бизнес-единицами: обеспечивать участие бизнес-обладателей данных в процессе определения целей анализа и валидации моделей.
Модели данных и метаданные — краеугольный камень успешного внедрения Process mining. Четко определенные поля, единый формат логов, продуманная структура метаданных и грамотная архитектура пайплайна позволяют не только обнаруживать узкие места и улучшать процессы, но и обеспечивают прозрачность, повторяемость и соответствие регуляторным требованиям. Важно начинать с ясной концепции дизайна данных, постепенно расширяя спектр источников и атрибутов, внедряя процессы управления данными и обеспечивая сотрудничество между ИТ и бизнесом. Open-source инструменты, такие как PM4Py и ProM, дают гибкость и мощь для начальных проектов и экспансий. Российские решения в arquitetura владения локальной инфраструктурой и интеграции с отечественными системами 1С и локальными ERP позволяют соответствовать требованиям локализации и приватности. В целом, грамотная работа с данными и метаданными повышает качество аналитики процессов, ускоряет внедрение решений и приносит ощутимую бизнес-ценность.
FAQ — Вопрос–Ответ
1) Что такое event log и зачем он нужен в Process mining?
Event log — это структурированная запись событий, отражающая ход выполнения бизнес-процесса. В Process mining он служит исходным материалом для реконструкции путей маршрутов, обнаружения моделей процесса, анализа задержек и отклонений от эталона. Без корректного event log анализ становится гипотетическим и менее полезным.
2) Какие ключевые поля должны быть в логе для Process mining?
Минимальный набор: case_id (идентификатор кейса), activity (название шага), timestamp (время выполнения шага), resource (исполнитель). Дополнительно рекомендуется атрибуты: region, department, product_id, order_id, status, стоимость и т.д. Их наличие позволяет детальнее анализировать пути, узкие места и поведение по сегментам.
3) Что такое XES и зачем нужен формат логов?
XES — это открытый стандарт для представления логов событий в виде структурированного XML-документа. Он поддерживает расширяемость атрибутов и совместимость между инструментами. Использование XES упрощает обмен логами между системами и инструментами анализа, а также обеспечивает воспроизводимость анализов.
4) Какие существуют открытые инструменты и чем они полезны?
PM4Py — гибкая Python-библиотека для подготовки данных, анализа и визуализации процессов; ProM — широкая платформа с обширным набором алгоритмов; Apromore — современная платформа с удобной визуализацией и поддержкой импорта XES. Эти инструменты позволяют реализовать полный цикл от подготовки данных до визуализации моделей и оценки их качества.
5) Как связать Process mining с российскими системами (например, 1С)?
Единая стратегия включает извлечение событий из 1С и сопутствующих систем, нормализацию полей и идентификаторов кейсов, перевод логов в единый формат (XES), развёртывание на отечественных инфраструктурах и соблюдение локальных требований к защите и хранению данных. Это позволяет анализировать процессы в рамках локальной экосистемы без передачи данных в иностранные облака.
6) Какие риски возникают при внедрении?
Ключевые риски: качество данных (недостаточность, дубликаты, неверные временные метки); несовместимость источников и форматирование; масштабируемость и производительность обработки больших логов; безопасность и регуляторные требования; риск неверной интерпретации моделей без вовлечения бизнес-специалистов; возможный саботаж изменений и сопротивление сотрудников.
7) Какой подход к данным и метаданным обеспечивает устойчивость проекта?
Необходимо внедрить data governance: роли и ответственности за данные, процедуры контроля качества, политику по provenance и data lineage, документирование источников и преобразований. Важно обеспечить аудит и версионность логов, а также поддержку нормализации атрибутов и единых процедур миграции логов между системами.
8) Какие практические шаги можно предпринять на старте проекта?
- Определить источники логов и ключевые атрибуты.
- Разработать единую схему логов и карту соответствий между системами.
- Настроить сбор и конвертацию логов в формат XES.
- Установить подход к provenance и метаданным.
- Добавить первый набор атрибутов для анализа и провести первый discovery через PM4Py/ProM.
- Вовлечь бизнес-партнёров и пройти валидацию моделей на реальных сценариях.
9) Какие преимущества дает внедрение Process mining в компании?
Обнаружение реальных путей процессов, выявление узких мест и задержек, снижение временных потерь, повышение конверсий и SLA-достижений, улучшение качества услуг и прозрачность процессов. Правильно организованные данные и метаданные позволяют достичь повторяемости результатов, ускорить внедрение изменений и повысить доверие к аналитике.
10) Где найти дополнительные ресурсы и обучение?
Начните с документации по XES, руководств по PM4Py и ProM, учебных курсов по процессному майнингу, материалов по data governance и data provenance. Обязательно изучите практические кейсы в отраслевых публикациях и примеры из open-source сообществ.


