

Архитектура BI и DWH для расчета CLTV
Архитектура бизнес-интеллекта и хранилища данных (BI и DWH) для расчета Customer Lifetime Value (CLTV) — это сочетание теоретических основ моделирования поведения клиентов и практических решений по сбору, хранинию и анализу больших объемов данных. В реальных условиях задача CLTV — не просто посчитать сумму доходов по каждому клиенту; она требует связки источников данных, устойчивой модели представления customers и времени, продуманного подхода к вычислению будущей ценности клиентов с учетом задержек, скидок и риска ухода. Эта глава рассчитана на новичков и тех, кто в задаче CLTV только начинает систематически строить архитектуру BI/DWH. Мы пройдем по основам теории, обсудим принципы моделирования и архитектурные паттерны, рассмотрим практические примеры на открытых и российских технологиях, разберем риски внедрения и приведем четкие шаги к реализации в реальной компании.
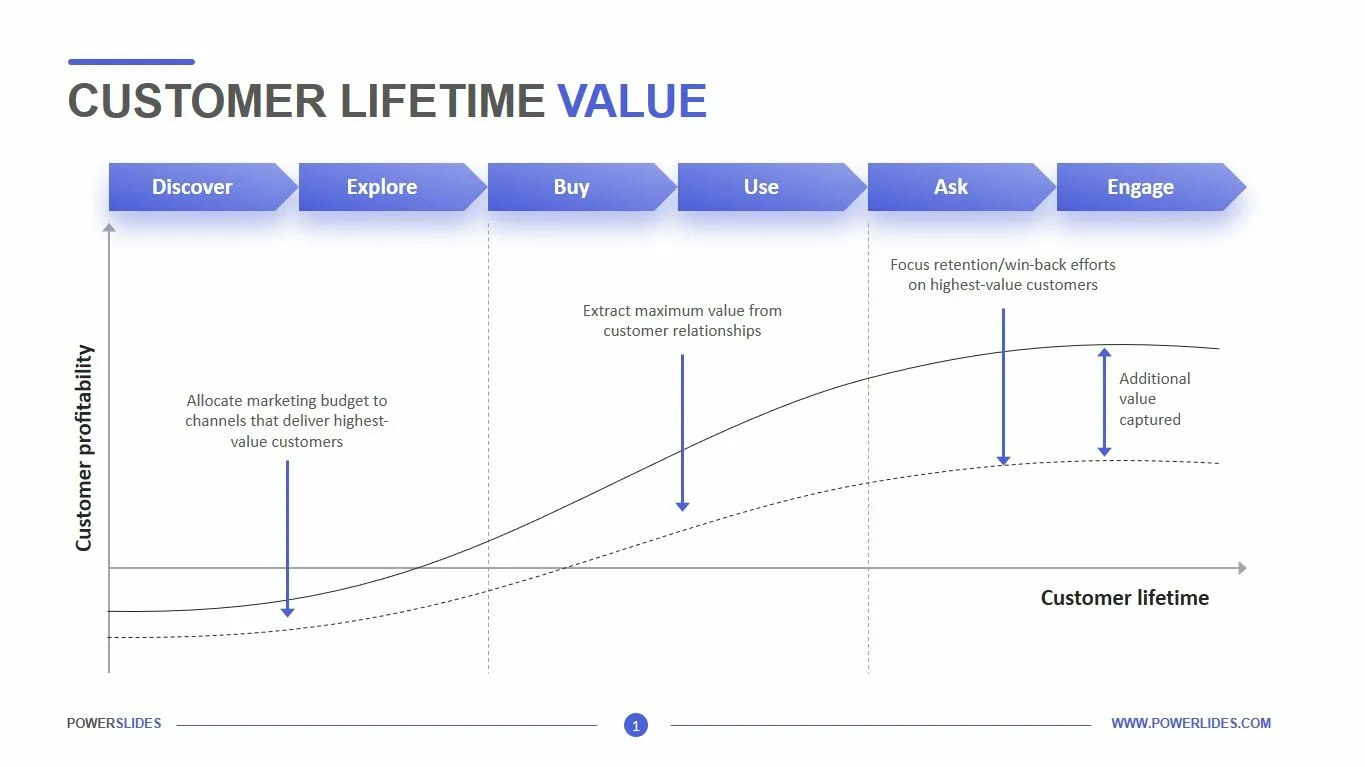
Что такое BI и DWH и зачем они нужны для CLTV
BI — это набор процессов, методик и инструментов для извлечения знаний из данных и поддержки управленческих решений. DWH — это специализированное хранилище данных, оптимизированное под аналитические запросы и агрегацию по предметной области. Для CLTV BI/DWH позволяют:
- объединять данные из разных систем: CRM, продаж, сервисного обслуживания, маркетинга, логистики, платежей.
- приводить данные к единой бизнес-словарной единице (customer_id, order_id, date_id и т.д.).
- строить исторические и предиктивные модели, проводить ретроспективный анализ и обновлять расчеты CLTV в режиме реального времени или near real-time.
- обеспечивать управление качеством данных, прослеживаемость источников и соблюдение регуляторных требований.
Архитектурные паттерны и концепции
- Архитектура централизованного экземпляра DWH: единое хранилище бизнес-данных, в которое сходятся все источники (CRM, ERP, веб-аналитика, платежи). Преимущества — консистентность, единая точка доступа, простота управления безопасностью. Недостатки — потенциальная задержка синхронизации и высокая сложность миграций.
- Data Lake и Data Warehouse как две компоненты: данные в raw и refined формате попадают в Data Lake, затем подготавливаются и мигрируют в DWH для аналитики OLAP. В условиях CLTV это хорошо для хранения больших объемов транзакционных данных и событий, а затем — для моделирования etl-пайплайнами.
- Data Mart: подмножество DWH, ориентированное на конкретную предметную область, например, CLTV или маркетинг. Это ускоряет запросы и упрощает доступ аналитиков к данным, не перегружая общий DWH.
- Хранение в колоннарной форме и партиционирование: для больших таблиц фактов выгодно использовать колоночные форматы (ClickHouse, Apache Parquet/ORC) и вертикальное/горизонтальное партиционирование по времени и клиентам.
- Реaltime vs batch: для CLTV можно сочетать пакетную обработку для ретроспективной оценки и потоковую обработку для обновления прогноза в near real-time (через Kafka/CDC).
Модели данных для расчета CLTV
- Схема «звезда» (star schema): факт-таблица по действиям (fact_revenue, fact_orders) и размерные таблицы (dim_customer, dim_date, dim_product, dim_channel, dim_campaign). Такой подход облегчает агрегацию по времени, сегментам и каналам.
- Схема «снежинка» (snowflake): нормализация размерных таблиц для экономии места и повышения гибкости моделей. Удобна, когда есть множество атрибутов в измерениях.
- Важные атрибуты и взаимосвязи: customer_id, date_id, product_id, channel_id, campaign_id, revenue_amount, order_amount, order_date, churn_flag, retention_days.
- Derivations и горизонты прогноза: CLTV может считаться как суммарная ожидаемая выручка по клиенту за заданный период, дисконтированная к настоящему моменту; в предиктивных моделях — как прогноз будущей выручки с учетом вероятности повторной покупки и задержек между покупками.
Методы расчета CLTV
- Исторический (retrospective) CLTV: простая сумма выручки по каждому клиенту за установленный период. Пример метрики: historical_cltv = SUM(revenue) за выбранный период.
- Предиктивный (predictive) CLTV: использование регрессии или машинного обучения для прогноза будущей выручки на основе исторических поведенческих признаков (частота покупок, средний чек, Recency, сезонность, лояльность, промо-активности).
- Вероятностная (probabilistic) CLTV: модели на базе вероятностных процессов, например BG/NBD и Gamma-Gamma для прогнозирования частоты покупок и среднего чека, а затем дисконтирование. Такой подход требует статистической подготовки и достаточного объема данных.
- Учет дисконтирования и времени: CLTV часто оценивается как приведенная стоимость будущей прибыли с учетом ставки дисконтирования (Discount Rate). В финансовых расчетах это учитывает время и риск, и позволяет сравнивать стоимости клиента в разных временных рамках.
- Метрики качества данных и валидности моделей: MAE, RMSE для предиктивного CLTV; валидность кросс-валидации, стабильность по сегментам; мониторинг drift-моделей.
Методы внедрения и управление данными
- ETL vs ELT: традиционные ETL-процессы позволяют трансформировать данные до загрузки в DWH. ELT-подход использует мощь хранилища для трансформации уже после загрузки. Для больших объемов событий, особенно в реальном времени, ELT часто бывает предпочтительнее и эффективнее.
- Управление качеством данных: профилирование, очистка, согласование правил валидации, обработка пропусков, дубликатов и неконсистентностей. Инструменты: Great Expectations, dbt (data build tool) для трансформаций и качественных тестов.
- Мета-данные и каталог данных: описание источников, обработок, зависимостей, владельцев. Важна способность аудита и прослеживаемости.
- Безопасность и соответствие: разделение прав доступа, маскирование личных данных, анонимизация, локализация данных в соответствии с регуляциями (GDPR и российские требования по локализации данных).
- Управление версиями и разворот моделей: контроль версий схем и моделей, управление изменениями и откатами.
- Мониторинг и операционная устойчивость: здоровье пайплайнов, тайминги выполнения, предупреждения при ошибках, устойчивость к сбоям.
Практические примеры
Типичный сценарий источников и архитектуры
- Источники данных: CRM (клиенты, статусы), ERP (заказы, платежи), веб-аналитика (события), платёжные шлюзы и банки (транзакции), рассылки (кампании), службы поддержки (тикеты).
- Архитектура: источники -> стейджинг/модуль выгрузки ( staging area) -> DWH (или Data Lake) -> Март (Data Mart) -> BI-инструменты.
- Технологический стек (open-source): PostgreSQL или ClickHouse как хранилище аналитики; Apache Kafka для потока событий; Apache Airflow для оркестрации ETL/ELT-процессов; Apache Spark для сложной обработки больших данных; dbt для трансформаций; Metabase или Apache Superset для визуализации.
- Технологический стек (российские решения): ClickHouse как отечественный высокий показатель производительности для аналитики; Яндекс DataLens как BI-инструмент; Яндекс Облако/Кластеризация и репозитории данных; 1C:Enterprise как источник данных и ERP-система; интеграционные решения на базе Kafka/airflow и локальная инфраструктура.
Пример расчета исторического CLTV
- Источник данных: факты продаж в fact_orders (order_id, customer_id, order_date, revenue), dimension_customer (customer_id, segment, region), dim_date (date_id, year, month, day).
- Пример SQL-запроса для исторической CLTV по клиенту за год:
SELECT c.customer_id, SUM(f.revenue) AS historical_cltv
FROM fact_orders f
JOIN dim_customer c ON f.customer_id = c.customer_id
JOIN dim_date d ON f.order_date = d.date_id
WHERE d.year = 2024
GROUP BY c.customer_id;
- Интерпретация: данный показатель демонстрирует фактическую накопленную выручку клиентов за 2024 год и может быть основой для сегментации и планирования маркетинга.
Пример предиктивного CLTV-метода (общее описание)
- Прогнозируемые признаки: Recency (последняя покупка), Frequency (количество покупок за период), Monetary (средний чек), churn_risk (вероятность ухода), marketing_channel, сезонность.
- Итог: прогнозируемая будущая выручка за период T, приводимая к настоящему времени с использованием дисконтирования.
- Внедрение: экспорт признаков в процесс моделирования (Python/R), обучение модели на исторических данных, экспорт модели в production-среду и интеграция с пайплайном для обновления в DWH. Пример: использовать регрессию или градиентный бустинг на признаках Recency/Frequency/Monetary, затем превратить прогноз в CLTV и сохранить в сквозной таблице cltv_forecast.
Пример вероятностной модели CLTV (базовая концепция)
- BG/NBD для прогнозирования частоты покупок, Gamma-Gamma для оценки среднего чека. Эти методы дают оценку вероятности повторной покупки и ожидаемой выручки на клиента, после чего применяется дисконтирование.
- Внедрение: требования к данным — длительный временной горизонт, стабильная идентификация клиентов, понятные метрики. Реализация чаще всего осуществляется в статистическом стекe (Python/R) с экспортом результатов в DWH для дальнейшей аналитики.
Интеграция в инструмент BI
- Использование KPI-карт CLTV в метриках, дашборды по сегментам (по регионам, каналам, сегментам клиентов), сравнение реального CLTV и прогноза.
- Примеры визуализаций: распределение CLTV по сегментам, динамика CLTV в разрезе по месяцам, коэффициенты конверсии к повторной покупке, доля дохода по топ-10% клиентов.
- В России и в мире популярны инструменты визуализации: Metabase, Apache Superset, Яндекс DataLens. В рамках отечественных реалий DataLens хорошо интегрируется с ClickHouse и российскими облаками.
Практические советы по реализации
- Начинайте с малого: реализуйте историческую CLTV по одному источнику и постепенно подключайте остальные; затем добавляйте разделение по каналам и географиям.
- Выберите подходящую модель и расширяйте ее: начните с простейшей суммы (historical CLTV), затем переходите к предиктивной и по возможности к вероятностной модели.
- Разделяйте данные по слоям: staging, raw/bronze, cleaned/silver, transformed/gold. Это облегчает тестирование и разворачивания.
- Обеспечьте качество и прослеживаемость: держите источники в каталоге данных, регистрируйте зависимые пайплайны, тестируйте каждую трансформацию.
- Внедряйте мониторинг: следите за задержками пайплайнов, валидностью данных и стабильностью моделей. Используйте автоматическую перезапуск пайплайнов при сбоях.
- Регуляторика и безопасность: реализуйте маскирование PII в данных, настройку доступа по ролям, локализацию данных и соответствие требованиям закона.
Архитектура данных и модель данных
- Архитектура: источники данных -> staging area -> DWH (или data lake) -> data mart CLTV -> BI/аналитика.
- В DWH применяем star schema: dim_customer (customer_id, name_hash, segment, region, churn_flag), dim_date (date_id, year, quarter, month, day_of_week), dim_campaign (campaign_id, channel, medium, campaign_name), dim_product (product_id, product_category) и факт-факты: fact_revenue (order_id, customer_id, date_id, campaign_id, product_id, revenue, quantity).
- Хранение в ClickHouse или PostgreSQL: ClickHouse — столбцовый столб, очень быстрые аналитические запросы; PostgreSQL — универсальная база, хорошо сочетается с dbt и pg_stat_statements. В российской среде ClickHouse часто рекомендуется за производительность, DataLens — для визуализации.
Интеграционные процессы и оркестрация
- Ингестинг через ETL/ELT: источники отправляют данные через ETL-скрипты или потоковую интеграцию. В реальности часто применяют ELT: загрузка в DWH, затем трансформации в самом DWH.
- Оркестрация пайплайнов: Apache Airflow или Russian-ориентированные инструменты как Kedro или собственные решения на базе Python. Пример DAG — задачи extract_from_crm, load_to_staging, transform_to_star, calculate_cltv, refresh_dashboards.
- Потоковая обработка: Apache Kafka, CDC-решения (например Debezium) для обновления данных в реальном времени.
Хранение и производительность
- Хранение: Parquet/ORC в Data Lake, а затем загрузка в DWH (или прямое использование ClickHouse). Партиционирование по date_id и по region для ускорения запросов.
- Оптимизация запросов: создание materialized views для часто запрашиваемых агрегатов CLTV; индексация по customer_id; использование агрегатных функций и оконных функций для динамических показателей.
- Безопасность и соответствие: ACL, шифрование на диске, интеграция с IAM, маскирование PII, аудит доступа.
Примеры конфигураций и сценариев реализации
Пример конфигурации пайплайна (Open-source):
- Источник: CRM через API, выгрузка в staging_postgres.
- Интеграция: Airflow DAG: extract_crm -> stage_transform -> load_star_schema -> compute_cltv -> update_dashboards.
- База данных: PostgreSQL как DWH; материализованные представления для CLTV; Metabase для визуализации.
Пример конфигурации на российских решениях:
- Хранилище: ClickHouse как основная аналитическая БД.
- Визуализация: Яндекс DataLens, интеграция через ClickHouse.
- Источники: 1C:Enterprise как источник данных, веб-аналитика и платежные сервисы, миграция через CDC.
- Оркестрация и конвейеры — Airflow или собственные решения на базе Python и Kafka.
Пример SQL-запросов (коротко):
- Исторический CLTV:
    SELECT c.customer_id, SUM(f.revenue) AS historical_cltv
    FROM fact_revenue f
    JOIN dim_customer c ON f.customer_id = c.customer_id
    GROUP BY c.customer_id;
- CLTV по месяцам с разрезом по сегментам:
    SELECT s.segment, d.month, SUM(f.revenue) AS cltv
    FROM fact_revenue f
    JOIN dim_customer s USING (customer_id)
    JOIN dim_date d ON f.date_id = d.date_id
    GROUP BY s.segment, d.month;
-
Прогнозная CLTV (псевдокод):
- извлечь признаки Recency-Frequency-Monetary, churn_risk, channel
- обучить модель в Python (регрессия/GBM)
- записать прогноз в cltv_forecast и объединить с фактическим CLTV в отчеты
Рекомендации по выбору инструментов в контексте российских реалий
- Open-source и глобальные решения: ClickHouse для аналитики, PostgreSQL как универсальная база, Apache Spark для обработки больших данных, Apache Airflow для оркестрации, dbt для трансформаций, Apache Superset или Metabase для аналитики. Эти инструменты широко поддерживаются и легко интегрируются в различные инфраструктуры.
- Российские решения: Яндекс ClickHouse и DataLens обеспечивают быструю аналитическую обработку и визуализацию в рамках российского стека; 1C может выступать источником данных для финансовых и ERP-процессов; хранение и обработка в рамках локальных решений помогают соответствовать требованиям локализации. В сочетании с открытыми инструментами это дает гибкую архитектуру.
Риски и ограничения
Качество данных и интеграции
- Риск: расхождение между источниками (разные определения customer_id, дубликаты, пропуски).
- Меры: единая идентификационная карта клиента, регламент обработки дублей, процедуры профилирования данных, мониторинг качества, синхронные тесты в CI/CD пайплайнах.
Модели CLTV и уровень неопределенности
- Риск: CLTV зависит от множества факторов (экономика, сезонность, промо-акции, изменения продукта). Модели могут давать смещенные прогнозы.
- Меры: использование нескольких подходов (историческая, предиктивная, вероятностная) и регулярная валидация моделей; тестирование на отложенной выборке; пересмотр гиперпараметров.
Масштабируемость и стоимость
- Риск: рост объема данных может привести к высоким затратам на хранение и обработку.
- Меры: переход на колоночные СУБД, партиционирование по времени, материализованные представления, автоматическое удаление устаревших данных согласно политике retention.
Управление безопасностью и соответствием
- Риск: обработка персональных данных в условиях регуляторики.
- Меры: минимизация сбора PII, маскирование, разграничение доступа, аудит действий пользователей, локализация данных в соответствии с требованиями.
Зависимость от инструментов и риски выборов
- Риск: зависимость от конкретного поставщика или технологии (vendor lock-in), риск устаревания.
- Меры: выбор гибких архитектур, модульная миграция и возможность адаптации под другие инструменты, использование стандартных форматов данных и REST/SQL-интерфейсов.
Внедрение и компетенции
- Риск: нехватка экспертов по BI/DWH и моделям CLTV.
- Меры: обучение сотрудников, внедрение стандартов работы, сотрудничество с внешними консультантами на начальных этапах, создание документации и пошаговых руководств.
Возможности GDPR и локализации в России
- Риск: требования по хранению данных и их обработке.
- Меры: локальные кластеры, контроль доступа и анонимизацию, политика хранения, согласие пользователей на обработку данных.
Выводы Архитектура BI и DWH для расчета CLTV требует хорошего баланса между теоретическими моделями и практическими технологиями. Основная идея заключается в создании единообразного слоя данных, который позволяет агрегировать, обогащать и анализировать данные клиентов. Правильная архитектура позволяет:
- объединять данные из разных источников в единое представление клиента;
- применять как простые, так и сложные модели CLTV — от исторических сумм до предиктивных и вероятностных подходов;
- оперативно обновлять расчеты, чтобы бизнес мог быстро реагировать на изменения в поведении клиентов;
- безопасно управлять данными, обеспечивать соответствие правовым требованиям и локализацию.
Ключ к успеху — поэтапность реализации, четкие governance-процедуры, выбор гибких и совместимых инструментов (как open-source, так и российских решений), а также постоянный мониторинг и улучшение моделей. В итоге вы получите архитектуру, которая не только предоставляет точные метрики CLTV, но и поддерживает принятие бизнес-решений в области удержания клиентов, арбитража маркетинговых бюджетов и оптимизации операционных процессов.
FAQ — Вопрос–Ответ
1. Что такое CLTV и зачем нужна BI/DWH-архитектура для него?
CLTV — это оценка суммарной ценности клиента за весь период взаимодействия. BI/DWH-архитектура обеспечивает сбор, унификацию и аналитику большого объема данных из разных источников, чтобы надежно рассчитывать CLTV, внедрять предиктивные модели и визуализировать результаты для принятия решений.
2. Какие основные архитектурные паттерны наиболее подходят для CLTV?
Наиболее распространены паттерны централизованного DWH и Data Lake/warehouse с данными в разных слоях (bronze/silver/gold). В CLTV часто применяют star schema для удобной агрегации и анализа по клиентам, времени и каналам.
3. Какие инструменты стоит выбрать в открытом стеке для российского рынка?
Open-source: ClickHouse (быстрая аналитика), PostgreSQL ( OLTP/OLAP-совместимость), Apache Airflow (оркестрация), Apache Kafka (потоковые данные), dbt (трансформации), Metabase или Apache Superset (визуализация). Российские решения: Яндекс ClickHouse и DataLens, 1C как источник данных, локальные облачные сервисы для хранения данных.
4. Какой подход к моделированию CLTV выбрать?
Начните с исторического CLTV, чтобы понять реальное поведение. Затем добавьте предиктивную модель (регрессия/гибридные методы) и, при наличии данных и компетенций, вероятностные модели (BG/NBD, Gamma-Gamma). Важно валидировать модели на отложенной выборке и обновлять их по расписанию.
5. Какие данные нужны для расчета CLTV?
Данные о клиентах (customer_id, сегменты), транзакции (order_id, date, revenue), каналы и кампании, поддержка и обслуживание. Важно иметь единые идентификаторы клиентов, согласованные определения для дат и monetary-values, а также архивацию изменений характеристик.
6. Какие риски связаны с внедрением такой архитектуры?
Качество данных, сложности интеграции, неопределенность моделей, масштабируемость, затраты на хранение и обработку, требования к локализации и соблюдению регуляторики. Риск управляется через governance, тестирование, мониторинг и поэтапное внедрение.
7. Как организовать работу команды при внедрении CLTV-проекта?
Разделите роли: data engineer (интеграция и пайплайны), data architect (модель данных), data scientist (модели CLTV), BI-аналитик (дашборды), data governance/officer (качество и соответствие). Вводите поэтапно, начинайте с малого и расширяйтесь по мере готовности инфраструктуры и компетенций.
8. Что важно учесть в плане безопасности и соответствия?
Персональные данные должны быть маскированы или анонимизированы при необходимости, доступ к данным ограничен по ролям, используйте локальные кластеры там, где это требуется законом. Введите журнал аудита и контроль доступа, соответствие требованиям GDPR и локальным регуляциям.
9. Как оценить успех проекта CLTV?
Ключевые показатели: точность предиктивной модели (MAE/RMSE), точность исторического CLTV, скорость обновления расчета, качество данных (уровень пропусков, дубликатов), экономический эффект (увеличение удержания, эффективности маркетинга, рентабельность инвестиций в рекламу).
10. Какие шаги следуют сделать на практике в первые 90 дней?
- определить источники данных и идентификаторы;
- построить staging и простой star-схему в выбранной БД;
- реализовать первый пайплайн загрузки и расчет исторического CLTV;
- настроить визуализации для базового CLTV;
- внедрить мониторинг качества данных и ошибок;
- постепенно добавить предиктивные модели и расширить набор источников.


