

Паттерны проектирования агентов: координация, мемоизация, дедуктивность
В бизнес-среде нас интересуют сценарии, где несколько агентов работают совместно над задачей: управление проектами, обработка входящих заявок, аналитика, натурное тестирование гипотез. Эти паттерны помогают структурировать решение так, чтобы оно было устойчивым, повторяемым и носило минимальные издержки на обслуживание.
Ключевые концепции:
- Координация агентов — механизм согласования действий между агентами, обмена знаниями, распределения задач и обработки конфликтов.
- Мемоизация — хранение результатов вычислений и полученных знаний для ускорения повторного использования и снижения затрат на вычисления.
- Дедуктивность — способность агента выводить новые знания и выводы из имеющихся фактов и правил; в контексте AI-агентов это часто реализуется через логическую обработку, правила и причинно-следственные связи.
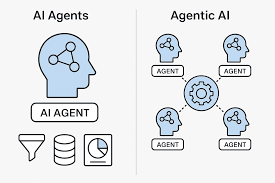
Эти паттерны часто реализуются в связке: агент-планировщик вырабатывает стратегию, набор вспомогательных агентов выполняет подзадачи, память сохраняет результаты, а дедуктивный модуль позволяет делать новые выводы на основе доступной информации.
Паттерны в контексте агентов
Паттерн координации (Coordination Pattern)
- Опора на централизованный координационный узел (оркестратор) vs децентрализованные координационные принципы (месседжинг, протоколы согласования).
- Пример: оркестровка задач в проекте: один агент планирует этапы, другие агент-исполнители выполняют задачи и сообщают статус.
Паттерн мемоизации (Memoization Pattern)
- Запоминание результатов и ключевых промежуточных состояний вычислений для повторного использования.
- В контексте агентов это позволяет снижать задержки и вычислительные затраты при повторных запросах, а также сохранять контекст принятия решений.
Паттерн дедуктивности (Deductive Pattern)
- Дедуктивные рассуждения основаны на правилах и фактах: если известно A и правило A → B, то B следует.
- В агентах эти правила могут быть реализованы через экспертные системы, логические движки, правила бизнес-логики и интеграцию с большими языковыми моделями, которые выводят новые знания на основе имеющегося фактического контекста.
Архитектурные принципы
- Разделение ответственности: диспетчер задач, модули дедуктивности, память и инструменты (Tools).
- Интероперабельность: стандартные интерфейсы API между агентами, структура сообщений и протоколы обмена.
- Репликация и консистентность памяти: как и какие данные реплицируются между агентами, и как поддерживать консистентность в распределённой среде.
- Безопасность и соответствие: контроль доступа к данным, аудит действий агентов, обеспечение соответствия требованиям регуляторов (например, хранение журналов действий, ограничение доступа к конфиденциальной информации).
Ключевые термины
- Agent (агент): автономная или полуна автономная единица, которая имеет цель и может пользоваться инструментами для выполнения действий и обмена информацией.
- Tools (инструменты): внешние сервисы или внутренние модули, которые агент может вызывать для выполнения задач (например, поиск, календарь, база знаний, API интеграции).
- Memory / State (память, состояние): хранилище контекста и результатов, которое обеспечивает повторное использование информации и ускоряет будущие запросы.
- Planner (планировщик): компонент, который формулирует последовательность действий агентов для достижения цели.
- DeductionEngine (дедуктивный двигатель): модуль логического вывода, который формирует новые знания и выводы на базе правил и фактов.
- Orchestrator (оркестратор): координационный механизм, часто центральный, который распределяет задачи между агентами и собирает результаты.
Методологии проектирования
- Контекстно-зависимое моделирование агентов: агент должен быть сконфигурирован под конкретный бизнес-процесс и защиту данных.
- Эскалации и аварийные сценарии: предусмотрены механизмы возврата в безопасное состояние при сбоях.
- Мониторинг и аналитика: метрики производительности, частоты запросов к памяти, задержки между агентами, доля ошибок.
- Тестирование агентов: unit-тесты для отдельных модулей и end-to-end тестирование координации.
Практические примеры
Здесь мы приведём сценарии и конкретные примеры реализации паттернов координации, мемоизации и дедуктивности в рамках корпоративных задач. Мы разделим примеры на общие open-source техники и примеры, ориентированные на российские решения и практику.
Пример 1: Координационный агент для обработки входящих заявок
Цель: автоматизировать распределение заявок между отделами, сбор информации и эскалацию.
Архитектура:
- Агент-оркестратор: координирует поток заявок, вызывает подагентов-консультантов (информационные агенты), чтобы собрать необходимые данные.
- Агент-катафалк-помощник: фильтрует, нормализует данные заявки.
- Инструменты: база знаний, календарь, CRM, внешний поиск по корпоративной документации.
Прагматическая реализация (open-source стек):
- Логика планирования на базе LangChain Agents и Tools.
- Меморизация: кэширование результатов проверки доступности сотрудников, статусов заявок.
- Дедуктивность: правила по определению приоритетов заявки и маршрутизации.
Пример кода (Python, упрощённый, иллюстративный):
# Пример упрощённой архитектуры координационного агента
from langchain.agents import initialize_agent, AgentType
from langchain.tools import Tool
from langchain.llms import OpenAI
from functools import lru_cache

llm = OpenAI(model="gpt-4", temperature=0.1)

# Инструменты
class CRMTool(Tool):
    name = "crm"
    description = "Получает статус заявки из CRM и обновляет этап обработки"
    def _run(self, request):
        # Псевдо-логика обращения к CRM
        return f"Статус заявки: {request['id']} -> {request['status']}"

class KnowledgeBaseTool(Tool):
    name = "kb"
    description = "Поиск по корпоративной документации"
    def _run(self, query):
        return "Найдено: документ ABC123, секция 4.2"

tools = [CRMTool(), KnowledgeBaseTool()]

def orchestrate_request(request):
    # мемоизация часто встречающихся запросов
    @lru_cache(maxsize=1024)
    def cached_plan(q):
        return llm.run(f"Планируй обработку заявки: {q}")

    plan = cached_plan(str(request))
    # далее агент следуя плану вызывает инструменты
    # контекст-поддержка: записываем результаты в память
    return plan

# Инициализация агента
agent = initialize_agent(tools, llm, agent=AgentType.CHAT_TRANSLATE, verbose=True)
Что это даёт:
- Быстрая адаптация под новые типы заявок.
- Снижение задержек за счёт мемоизации часто встречающихся сценариев.
- Координация действий между CRM и базой знаний.
Российские и локальные аспекты:
- Можно локализовать данные в рамках корпоративного облака, применяя хранилище и журналы доступа в рамках политики ФЗ.
- В качестве локального NLP можно подключить DeepPavlov для предварительной обработки текста.
Пример 2: Мемоизация в аналитическом агенте
Цель: ускорить повторяемые запросы к базы данных и вычислениям.
Архитектура:
- Агент-запросчик: получает запрос, проверяет память (мемоизованный кеш) на предмет повторного запроса.
- Мемориальная база: локальное Redis/SQLite для слепков контекста.
Реализация (псевдо-код):
import redis
import hashlib
import json
from time import time

r = redis.Redis(host='localhost', port=6379, db=0)

def memoized_query(query, ttl=3600):
    key = f"memo:{hashlib.md5(query.encode()).hexdigest()}"
    if r.exists(key):
        value = r.get(key)
        return json.loads(value.decode())
    # Эмуляция сложной аналитики
    result = {"query": query, "result": "computed_result", "ts": time()}
    r.set(key, json.dumps(result), ex=ttl)
    return result

def analyze(user_query):
    # Разбор запроса и вызов аналитических операций
    return memoized_query(user_query)
Что даёт мемоизация:
- Значительное сокращение времени на повторные запросы.
- Повторное использование результатов, особенно в ETL/BI сценариях.
Применимость к корпоративной среде:
- Кэширование часто выполняемых аналитических запросов и расчётов.
- Контроль над временем жизни записей в памяти.
Пример 3: Дедуктивность через правила бизнеса
Цель: автоматическое выведение новых выводов на основе фактов и правил.
Архитектура:
- Дедуктивный движок (rules engine): хранит правила, применяет их к фактам.
- Факт-источник: собранные данные из систем мониторинга, CRM, документооборота.
- Интеграция с LLM: для сложных рассуждений или формирования выводов для человека.
Пример реализации:
# Пример простого дедуктивного правила
rules = [
    {"if": {"priority": "high", "status": "open"}, "then": {"escalate": True}},
    {"if": {"sla_remaining": "<= 2 days"}, "then": {"notify": "On-Call"}}
]

def apply_rules(facts):
    actions = []
    for r in rules:
        cond = r["if"]
        if all(facts.get(k) == v for k, v in cond.items()):
            actions.append(r["then"])
    return actions

facts = {"priority": "high", "status": "open", "sla_remaining": "3 days"}
print(apply_rules(facts))
# Вывод: [{"escalate": True}]
Интеграция с LLM:
- При сложных условиях, когда правила не охватывают все случаи, можно использовать LLM для анализа контекста и подсказок потенциальных выводов, а затем транслировать результат в формальные правила.
Преимущества:
- Прозрачность и объяснимость решений.
- Возможность строгого аудита бизнес-логики.
Таблица: Сравнение паттернов
| Паттерн | Основная идея | Применение | Преимущества | Ограничения |
|---|---|---|---|---|
| Координация | Центр/ распределенная координация действий между агентами | Мультиагентные задачи, эскалации, синхронизация | Гибкость, устойчивость к сбоям, масштабируемость | Сложность синхронизации, риск гонок данных |
| Мемоизация | Кэширование результатов вычислений | Частые повторяющиеся запросы, аналитика, ETL | Быстрые ответы, уменьшение затрат | Требуется стратегия обновления кеша, риск устаревших данных |
| Дедуктивность | Правила и факты ведут к выводам | Логика бизнес-процессов, контроль соответствия | Прозрачность, объяснимость | Ограниченность правил, необходимость обновления правил |
Архитектурные принципы реализации
Архитектура с центром и агентами-совершателями:
- Оркестратор управляет потоками задач.
- Агенты-исполнители выполняют конкретные задачи.
- Мемория и дедуктивная часть доступны через API-слой оркестратора.
Контейнеризация и развёртывание:
- Используйте Docker/Kubernetes для изоляции агентов и их зависимостей.
- Логирование и мониторинг: Prometheus, OpenTelemetry, ELK/EFK.
Интеграция с Open-source стеками:
- LangChain для организации агентов и инструментов.
- DeepPavlov для локальной NLP-подсистемы на русском языке.
- Redis/SQLite/PostgreSQL для памяти и кэша.
Безопасность и контроль доступа:
- аутентификация и авторизация для доступов к данным.
- аудит действий агентов.
- ограничение доступа к критическим данным.
Технические примеры кода
Пример с использованием LangChain и мемоизации:
# Упрощенная демонстрация координационного агента с мемоизацией
from langchain.agents import initialize_agent, Tool, AgentType
from langchain.llms import OpenAI
from functools import lru_cache

llm = OpenAI(model="gpt-4", temperature=0.2)

class CalendarTool(Tool):
    name = "calendar"
    description = "Проверяет доступность участника"

    def _run(self, participant, time_slot):
        # Сюда бы интегрировался реальный календарь
        return f"Доступно: {participant} на {time_slot}"

tools = [
    CalendarTool(),
]

@lru_cache(maxsize=1024)
def plan_request(request_summary):
    return llm.run(f"План обработки задачи: {request_summary}")

def orchestrate(request):
    plan = plan_request(str(request))
    # здесь можно регистрировать план и вызывать инструменты
    return plan

agent = initialize_agent(tools, llm, agent_type=AgentType.ZERO_SHOT_REACT_DESCRIPTION, verbose=True)
Пример дедуктивного рассуждения на основе правил (псевдо-язык):
# Простая реализация правил
facts = {
    "priority": "high",
    "issue_type": "outage",
    "sla_remaining_days": 1
}

rules = [
    {"if": {"priority": "high", "issue_type": "outage"}, "then": {"action": "notify_on_call"}},
    {"if": {"sla_remaining_days": 1}, "then": {"action": "escalate"}}
]

def infer(facts, rules):
    actions = []
    for r in rules:
        if all(facts.get(k) == v for k, v in r["if"].items()):
            actions.append(r["then"])
    return actions

print(infer(facts, rules))
# [{'action': 'notify_on_call'}, {'action': 'escalate'}]
Российские решения и локализация
- DeepPavlov (opensource) для NLP и диалоговых систем: предоставляет инструменты для обработки естественного языка на русском, включая Intent Recognition, Entity Extraction и диалоговые менеджеры. Применимо как часть дедуктивного и мемоизационного слоя для обработки входящих запросов и формирования разумных выводов.
- Локализация данных: хранение данных внутри корпоративного облака/инфраструктуры, соблюдение требований к защите данных и аудита. Использование русскоязычных моделей и локализации терминов снижает риск ошибок перевода и повышает точность.
- Применение на практике: интеграция DeepPavlov в связке с LangChain и Redis для сценариев поддержки клиентов, автоматизации бизнес-процессов и внутреннего мониторинга.
Примечание: в российский рынок можно адаптировать открытые решения под требования регуляторов, внедряя строгие политики доступа, хранение журналов действий и аудит профессиональной ответственности.
Риски и ограничения внедрения
Данные и конфиденциальность:
- Неправильное хранение или передача конфиденциальной информации между агентами и внешними сервисами может привести к утечкам.
- Решение: локализация данных в частном облаке, шифрование, аудит доступа.
Контроль качества выводов:
- Мемоизация сохраняет старые знания, что может привести к устаревшим выводам при изменении данных.
- Решение: периодическое обновление кеша, invalidate-практики, тестирование на предмет Drift.
Эскалации и безопасность:
- Неоптимальная координация может привести к пропуску шагов или дублированию работы.
- Решение: разработка чётких протоколов эскалации и контрактов между агентами.
Ограничения дедуктивного подхода:
- Правила-базированная дедуктивность может оказаться недостаточной для сложных бизнес-задач; это может потребовать гибридного подхода с LLM для обработки сложных рассуждений.
- Решение: сочетание правил и языковой модели, качественный контроль контекста.
Масштабирование и доступ к инструментам:
- При большом количестве агентов рост коммуникаций может привести к задержкам и перегрузке канатов.
- Решение: применение асинхронности, очередей, лимитирования запросов и стратегий балансировки.
Юридические и регуляторные риски:
- В бизнесе необходимо соблюдать требования к обработке персональных данных, архивированию и хранению журнала действий.
- Решение: внедрение политики данных и соответствие требованиям регуляторов в рамках контракта.
Мониторинг и обслуживание:
- Требуется поддерживать мониторинг состояния агентов, трассировку запросов и журналов.
- Решение: полноценный стек мониторинга, алертинг и ротация секретов.
Выводы
- Паттерны координации, мемоизации и дедуктивности являются мощными инструментами для обеспечения устойчивой и эффективной работы корпоративных AI-агентов.
- Комбинация этих паттернов позволяет строить мультиагентные системы, которые не только выполняют задачи, но и учатся на прошлом опыте, вырабатывают новые выводы и корректируют поведение в зависимости от контекста.
- Важно учитывать риски: безопасность данных, соответствие регуляторным требованиям, качество выводов и устойчивость к изменениям бизнес-процессов.
- Open-source стеки (например, LangChain, DeepPavlov) в сочетании с локализацией и российскими практиками дают сильную основу для реализации корпоративных решений.
- Рекомендации по внедрению: начинать с малого масштаба, внедрять кэширование и дедуктивные правила постепенно, использовать валидаторы и тесты, регулярно обновлять обучение и контекст агентов.
FAQ (вопросы и ответы)
1) Что такое паттерн координации и зачем он нужен в агентной архитектуре?
- Ответ: Координация — это способ организовать совместную работу нескольких агентов, чтобы они не дублировали усилия, эффективно обменивались информацией и достигали общей цели. В бизнес-сценариях это критично для скоринга заявок, обработки инцидентов и принятия решений с участием нескольких отделов.
2) Что такое мемоизация в рамках AI-агентов и когда её применять?
- Ответ: Мемоизация — сохранение результатов вычислений и контекстов для повторного использования. Это ускоряет повторные запросы, снижает нагрузку на сервисы и помогает быстро отвечать на повторяющиеся задачи, например, частые аналитические запросы или запросы к документации.
3) Какие типичные дедуктивные концепции применяются в агентных системах?
- Ответ: Правила и факты, логические выводы, причинно-следственные рассуждения, использование экспертных правил и иногда гибридный подход с языковыми моделями для расширенного контекста. Они обеспечивают объяснимость и прозрачность решений, что важно в корпоративной среде.
4) Какие open-source инструменты наиболее подходят для построения агентов?
- Ответ: LangChain (агенты, Tools, Memory), HuggingFace-инструменты и интеграции, DeepPavlov для русскоязычных задач NLP. Эти инструменты позволяют строить координацию, мемоизацию и дедуктивность в рамках одного решения.
5) Какие российские решения можно использовать в связке с американскими инструментами?
- Ответ: DeepPavlov как локальная NLP-библиотека с поддержкой русского языка; локальная настройка и развёртывание в рамках корпоративного облака помогают соблюдать требования к данным и регуляторным нормам.
6) Какие риски связаны с внедрением этих паттернов?
- Ответ: Утечки данных, устаревшие выводы, задержки в координации, сложность сопровождения, регуляторные требования, а также риск неправильной интерпретации результатов дедуктивных рассуждений.
7) Как минимизировать риск устаревших данных в мемоизации?
- Ответ: Реализовать процесс обновления кеша, invalidate-практики, TTL, аудит изменений и периодическую переработку результатов на основе живого контекста.
8) Как начать проект с такими паттернами в компании?
- Ответ: Начать с малого кейса с хорошо определённой целью, выбрать стек инструментов (например, LangChain + DeepPavlov), определить требования к хранению данных, реализовать основной оркестратор, добавить мемоизацию и дедуктивность, затем понаблюдать за результатами и расширять.
9) Какие метрики полезны для оценки агентной координации?
- Ответ: Время реакции, доля успешно выполненных задач, средняя задержка на этап, процент эскалаций, количество повторных запросов к кешу, точность выводов дедуктивного механизма (по аудиту).
10) Какие шаги для безопасного внедрения в корпоративной среде?
- Ответ: Обеспечить локальное хранение данных и аудит действий агентов; использовать минимально необходимый набор прав и доступов; встроить механизм журналирования; контролировать качество выводов и периодически обновлять знания в памяти.


