

Стратегия внедрения AI: от идеи к операционной модели
Стратегия внедрения искусственного интеллекта (AI) в крупные бизнес-подразделения требует не только грамотного выбора технологий, но и формирования операционной модели, которая позволяет идеи превращать в управляемые процессы, измеримую ценность и устойчивые бизнес-результаты. Эта глава посвящена тому, как пройти путь от идеи к рабочей операционной модели на примере четырех доменов: финансы, цепи поставок, маркетинг и операции. Мы рассмотрим теоретические основы, методологии, практические примеры (как open-source, так и российские решения), технические детали реализации, риски и ограничения, а также дадим ответы на частые вопросы.
Ключевые цели главы:
- понять, какие organizational capabilities нужны для зрелости AI.
- освоить рамки MLOps и управление данными в рамках операционной модели.
- увидеть практические примеры внедрения в разных бизнес-контекстах.
- разобраться в рисках, регуляторике и этике при внедрении AI.
- получить набор инструментов и примеры артефактов для старта.
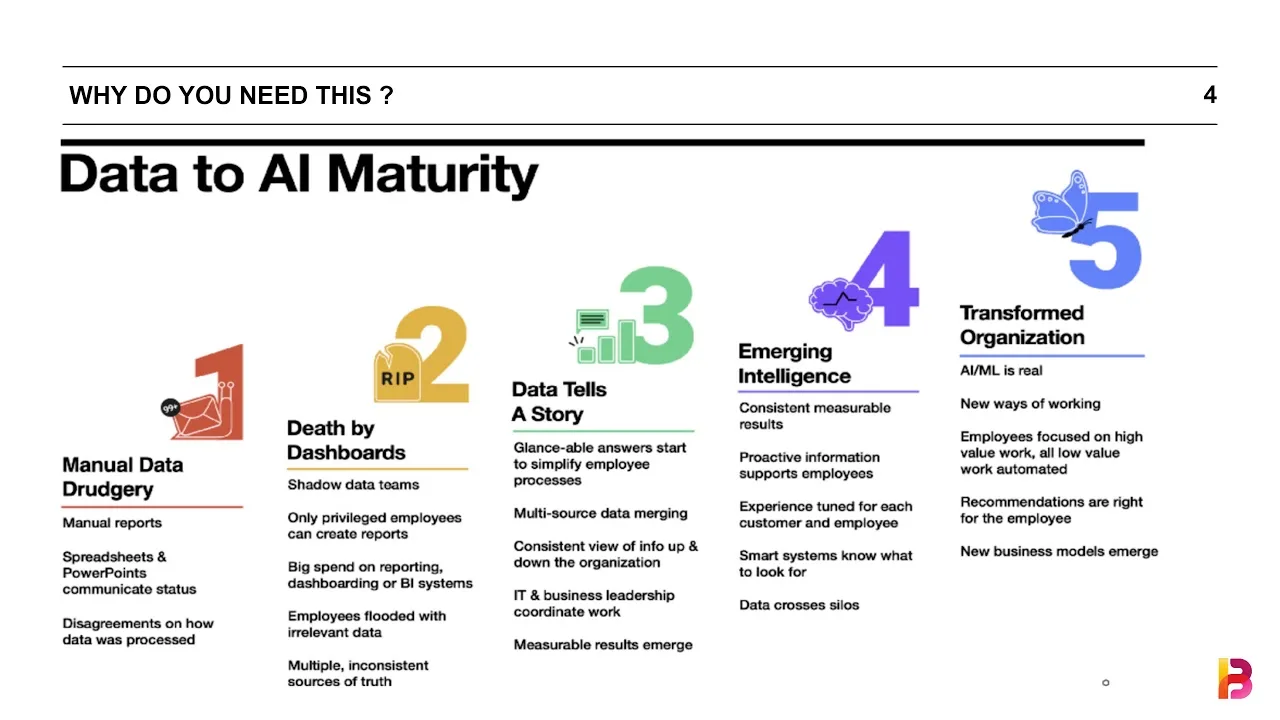
Что такое AI Maturity и операционная модель
AI Maturity (зрелость AI) — это способность организации системно применять искусственный интеллект для создания ценности, с устойчивыми процессами разработки, внедрения, мониторинга и управления рисками. Модель зрелости соединяет стратегию, процессы и технологии в единую систему, где каждый уровень предполагает конкретные компетенции, роли и показатели эффективности.
Операционная модель AI — это набор процессов, ролей, технологических стэков, политики данных, механизмов мониторинга и управления изменениями, благодаря которым AI-инициатива превращается в устойчивый бизнес-процесс. Она включает:
- управление данными: сбор, очистку, каталогизацию, обеспечение качества и приватности;
- методологии разработки: CRISP-DM, KDD, OSEMN и современные практики MLOps;
- жизненный цикл моделей: разработка, тестирование, внедрение, мониторинг, обновление;
- управление изменениями: способы вовлечения стейкхолдеров, коммуникацию и обучение сотрудников;
- регуляторику и этику: соответствие требованиям, аудит, объяснимость моделей.
Модели зрелости AI
Типичная дорожная карта зрелости может выглядеть так:
- Foundational — базовые данные и пилотные эксперименты;
- Managed — управляемый портфель проектов, начальные практики MLOps;
- Scaled — централизованный доступ к инструментам, повторяемые шаблоны, внедрения по функциям;
- Optimized — масштабная автоматизация, продвинутые системы управления рисками и мониторинг на уровне предприятия;
- Transformational — трансформация бизнес-моделей и создание новой ценности через AI.
Ключевые метрики для оценки зрелости:
- экономическая ценность: ROI, NPV, TCO;
- скорость вывода в прод;
- покрытие процессов: доля процессов с активным AI-обеспечением;
- качество данных: полнота, точность, доступность;
- операционная дисциплина: частота релизов, устойчивость пайплайнов;
- управление рисками: количество инцидентов, регуляторные нарушения.
Архитектура и инженерная дисциплина
Чтобы перейти от идеи к операционной модели, важно понимать архитектуру стэка и роль MLOps. Основные компоненты:
- источники данных и ingestion: базы данных, файлы, внешние сервисы;
- обработка данных: очистка, обогащение, подготовка признаков;
- слой моделей: фреймворки и обучающие пайплайны;
- хранение признаков: feature store;
- управление экспериментами: трекинг вариантов, репродукция;
- развёртывание и эксплуатация: сервисы, оркестрация, K8s;
- мониторинг и аудит: качество данных, производительность модели, сигналы риска;
- обеспечение безопасности и соответствия: доступы, приватность, регуляторные требования.
Популярные методологии и стандарты:
- CRISP-DM / CRISP-ML (модернизированная версия для ML);
- MLOps и LMOps: практики DevOps для моделей;
- Data Governance: каталогизация, линейность данных, версия данных (DVC, Data Catalog);
- Model Governance: реестр моделей, версии, аудит, тестирование и валидация;
- Responsible AI: объяснимость, fairness, безопасность, защита данных.
Практические примеры
В этой части мы рассмотрим конкретные сценарии внедрения AI в четыре домена: финансы, цепи поставок, маркетинг и операции. Для каждого домена перечислим задачи, типы данных, примеры моделей и ожидаемые бизнес-метрики.
Финансы
Примеры задач:
- скоринг кредитных рисков и мошенничество;
- прогнозирование денежных потоков и ликвидности;
- автоматизация финансовых прогнозов и управленческих отчётностей.
Типы данных:
- транзакционные данные, история платежей, кредитные бюро, рыночные цены;
- внешние источники: экономические индикаторы, инфляция.
Примеры моделей и подходов:
- градиентные деревья (XGBoost, LightGBM), CatBoost;
- нейронные сети для временных рядов (DeepAR, Prophet как базовый инструмент);
- обнаружение аномалий и мошенничества (Isolation Forest, Autoencoders, графовые методы).
Метрики:
- AUC-ROC, F1-score для классификации рисков;
- MAE, RMSE для прогнозной части;
- экономическая ценность на каждую точку принятия решения (P&L impact).
Практический кейс (псевдореализация):
- построение скоринга дефолтов с использованием CatBoost и временных признаков; мониторинг деградации и обновления модели.
Цепи поставок
Задачи:
- спрос и предложение, прогнозирование спроса по SKU;
- оптимизация запасов, планирование перевозок, маршрутная оптимизация;
- предиктивная поддержка оборудования и логистическая аналитика.
Данные:
- товарооборот, складские остатки, поставки, данные по поставщикам;
- данные по транспортировке, погодные данные, геолокация.
Технологии и подходы:
- Prophet/ML-библиотеки для прогнозирования спроса;
- графовые модели для сетевой оптимизации поставок;
- модели для маршрутизации (Route optimization) и реального времени.
Метрики:
- точность прогноза спроса, скорость доставки, снижение запасов, TCO.
Маркетинг
Задачи:
- персонализация рекомендаций, сегментация клиентов, ценообразование и таргетинг;
- генерация контента и A/B тестирование, прогноз откликов.
Данные:
- поведение пользователей, клика/покупка, демография, каналы коммуникации.
Технологии:
- рекомендательные системы (нейронные сети, факторизация матриц), BERT/генеративные модели для контента;
- A/B тестирование с анализом статистики сигнала;
- платформы для управления контентом и персонализацией.
Метрики:
- CTR, конверсия, CTR этого сегмента, ROI маркетинга.
Операции
Задачи:
- прогноз технического обслуживания и отказоустойчивость оборудования;
- оптимизация энергопотребления, планирование графиков, автоматизация кадровых процессов.
Данные:
- данные датчиков, логи оборудования, расписания и загрузки, энергопотребление.
Технологии:
- моделирование временных рядов, anomaly detection, predictive maintenance;
- роботизированная автоматизация процессов (RPA) в сочетании с ML.
Метрики:
- доступность систем, годы экономии на ремонтах, сниженная простоя.
Таблица сопоставления доменов и требований
| Домен | Тип данных | Основные модели | Частые метрики | Риски и регуляторика |
|---|---|---|---|---|
| Финансы | транзакции, кред. бюро, рыночные данные | CatBoost, XGBoost, LSTM | AUC-ROC, P&L impact | Модельный риск, соответствие регуляторике,_PRIVACY |
| Цепи поставок | продажи, запасы, логистика | Prophet, графовые модели, RF, GBM | точность прогноза, запас, OTD | устойчивость к задержкам, качество данных |
| Маркетинг | поведение, клики, покупки | BERT, нейросети, рекомендатели | CTR, конверсия, ROI | этика, персонализация, фокус на приватности |
| Операции | датчики, обслуживание, энергия | Time series, anomaly detection, maintenance ML | uptime, CAPEX/OPEX | безопасность, регуляторика по данным |
Архитектура стека и пайплайны
Источники данных и ingestion:
- ETL/ELT-пайплайны: Airbyte, Apache NiFi, Logstash.
- Облачные/локальные хранилища: S3/MinIO, HDFS, Delta Lake.
Обработка данных и признаки:
- Spark/Flink для больших наборов данных;
- Feature store: Feast (open-source), psyintros для российского рынка, локальные решения на базе DVC и локальных хранилищ признаков.
Модели и экспериментирование:
- ML фреймворки: PyTorch, TensorFlow, CatBoost, LightGBM;
- Управление экспериментами: MLflow, Weights & Biases (W&B);
- Репозитории моделей: MLflow Model Registry, DVC.
Развертывание и эксплуатация:
- Оркестрация: Kubernetes, Argo Workflows;
- Сервисы и модельные серверы: Seldon Core, KFServing (KServe);
- Мониторинг: Prometheus, Grafana, Evidently AI.
Управление качеством и данными:
- Great Expectations для проверок качества данных;
- Data Quality Dashboard; мониторинг с OpenTelemetry.
Безопасность и соответствие:
- IAM/определение уровней доступа, приватность данных, шифрование;
- аудит и журнал изменений, регуляторные модули (GDPR, локальные требования).
Пример технического стека (open-source)
- Data ingestion: Apache Airflow + Apache Kafka
- Storage: Delta Lake + PostgreSQL
- Feature store: Feast
- Model training: PyTorch / CatBoost
- Experiment tracking: MLflow
- Model registry: MLflow
- Serving: Seldon Core (Kubernetes)
- Monitoring: Prometheus + Grafana
- Quality checks: Great Expectations
- Orchestration: Kubeflow (как альтернатива Argo)
Пример кода: базовый пайплайн обучения и логирования в MLflow
# Простой пример обучения и регистрации модели с использованием MLflow
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_breast_creast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# Подготовка данных
X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)

# Запуск эксперимента
with mlflow.start_run():
    n_estimators = 200
    max_depth = 8
    model = RandomForestClassifier(n_estimators=n_estimators, max_depth=max_depth, random_state=42)
    model.fit(X_train, y_train)
    preds = model.predict(X_test)
    acc = accuracy_score(y_test, preds)

    mlflow.log_param("n_estimators", n_estimators)
    mlflow.log_param("max_depth", max_depth)
    mlflow.log_metric("accuracy", float(acc))
    mlflow.sklearn.log_model(model, "model")

print("Model registered and metrics logged.")
Этот пример демонстрирует базовую структуру MLOps: параметры, метрики, сохранение модели. В реальном проекте код дополняется верификацией данных, тестами на регрессии, логированием датасетов, экспонированием метрик в дашборды.
Российские решения и варианты локализации
- CatBoost (от Yandex): поддерживает русскоязычные данные, хорошие результаты на табличных данных, встроенная обработка категориальных признаков, мощная поддержка регуляторики за счет прозрачности моделей.
- DeepPavlov: открытая платформа для NLP на русском языке, готовые модели «под ключ» для чат-ботов, классификации и чат-моделей, полезна для маркетинга, поддержки клиентов и сервиса.
- Yandex DataSphere: платформа для разработки и развёртывания ML-моделей, поддерживает экспериментирование, обучение, мониторинг, совместную работу над проектами, может быть использована как локально, так и в облаке Яндекс.
- Применение российских правовых норм: учитывайте требования локализации данных, хранение персональных данных в РФ, аудит и журнал доступа; CatBoost и DeepPavlov предоставляют инструменты для обработки данных на русском языке и соответствия требованиям локального рынка.
Риски и ограничения внедрения
Риск данных:
- качество данных, неполные или несогласованные источники;
- проблемы приватности и GDPR/регуляторные требования в РФ (FZ-152), необходимость анонимизации и локализации данных.
Риск моделей:
- злоупотребление и искажение данных, смещение модели (data drift);
- модельный риск: недостоверные предсказания, уязвимости к манипуляциям;
- ответственность за решения, требующая прозрачности и аудита.
Риск эксплуатации:
- сложности интеграции с существующими системами (ERP, SAP, CRM, WMS);
- зависимость от облачных/локальных инфраструктур и возможные ограничения по масштабируемости.
Риск людей и процессов:
- нехватка компетенций и непрозрачная коммуникация между подразделениями;
- сопротивление изменениям и культурные барьеры;
- разницу в скорости принятия решений между бизнес-единицами.
Риск регуляторики и безопасности:
- персональные данные и доступ к ним;
- безопасность модели и инфраструктуры (атаки, подмена данных, инферфейс);
- требования к аудиту и прозрачности вывода моделей.
Ограничения:
- ограниченность вычислительных ресурсов на старте;
- дефицит кадров в специализированных областях (MLOps-инженеры, дата-специалисты, инженеры по данным);
- необходимость поддержки компетентной кадровой политики и обучения.
Методы минимизации рисков
- Внедрение Data Governance и Data Quality программы с использованием Great Expectations и пайплайнов в ELT-режиме.
- Построение Model Governance: реестр моделей, документация, версии и аудит решений.
- Прототипирование в рамках пилотов с чётким определением целевых метрик и шага к масштабированию.
- Модульная архитектура: микросервисы, чётко ограниченные контрактами API.
- Контрольная среда (sandboxes) и тестирование на деградацию, мониторинг в продакшне: Drift detection, E2E in-silico тесты.
- Этичность и безопасность: внедрение Explainability (SHAP, LIME), проверка на bias, соответствие требованиям регуляторов.
Практические рекомендации по внедрению
- Определение дорожной карты зрелости AI: где мы находимся, куда идём, какие контрольные точки.
- Формирование кросс-функциональной команды: данные инженеры, ML-инженеры, бизнес-аналитики, продукт-менеджеры, юридическая и риск-служба.
- Стратегия данных: инвентаризация источников, качество, доступ, политика приватности и хранения данных.
- Выбор технологического стека: ориентироваться на требования к интеграции, масштабу и совместимости с российскими решениями (CatBoost, DeepPavlov, Yandex DataSphere).
- Пилоты с предопределенными KPI: экономическая ценность, улучшение ключевых бизнес-показателей.
- План по масштабированию: готовность к масштабным проектам, централизованный фундамент, архитектура признаков и модели.
- Градиент к управлению изменениями: обучение сотрудников, поддержка проектов и коммуникации.
Выводы
- Успешное внедрение AI требует не только технологий, но и устойчивой операционной модели, где данные, процессы и люди работают в связке.
- Математическая и бизнес-ценность должны быть привязаны к конкретным функцииям, KPI и этапам внедрения.
- Важна прозрачность и governance: управление данными, моделями и рисками на уровне всей организации.
- Российские решения и open-source стеки позволяют собрать эффективный и адаптивный набор инструментов, не ограничивая инновации, а наоборот — ускоряя путь от идеи к операционной модели.
Вопрос–Ответ (FAQ)
1) Что такое AI Maturity и зачем она нужна бизнесу?
- AI Maturity — это способность организации системно и последовательно развивать и внедрять AI для достижения устойчивой бизнес-ценности. Она помогает перейти от отдельных проектов к масштабируемой, управляемой и этичной практике, связывая стратегию, данные, процессы и людей.
2) Какие этапы проходить от идеи до операционной модели?
- Идея -> пилот -> валидированная бизнес-ценность -> операционная модель (процессы, governance, данные) -> масштабирование -> устойчивое управление и развитие.
3) Какие данные нужны и как с ними работать?
- Нужно иметь качественные данные из основных источников: ERP/CRM, транзакции, логистика, датчики и т.д. Важны качество, полнота и доступность. В рамках governance — каталог источников, линейность данных, версия данных (DVC, Data Catalog). Вводится приватность и безопасность.
4) Какие open-source решения стоит рассмотреть?
- TensorFlow, PyTorch, CatBoost, LightGBM, Prophet, MLflow, Kubeflow, Apache Airflow, Feast, Great Expectations, DVC, DeepPavlov (для NLP) и др.
5) Какие российские решения применимы в нашем стеке?
- CatBoost (ведомоство от Yandex), DeepPavlov (NLP), Yandex DataSphere (платформа MLOps), а также локальные решения для интеграции и аудита данных. Важно соблюдать локальные требования к хранению и обработке данных.
6) Как оценивать экономическую ценность AI проекта?
- Определение ROI и NPV на этапе пилота, сравнение с текущими затратами, расчёт экономии и улучшения качества. Важно устанавливать KPI до запуска и отслеживать drift и деградацию.
7) Какие риски чаще всего возникают и как их минимизировать?
- Риск данных, риск моделей, риск эксплуатации и регуляторики. Минимизировать через governance, QA-процессы, тестирование, мониторинг, а также этическую и законную ответственность.
8) Как обеспечить масштабирование и повторяемость?
- Централизованный стек, единый реестр моделей, пайплайны, стандартные шаблоны, мониторинг, CI/CD для ML, контейнеризация и оркестрация Kubernetes.
9) Какие регуляторные требования стоит учитывать в РФ и за пределами?
- Локализация данных, хранение персональных данных, аудит и прозрачность моделей, ответственность за решения и безопасность. Нужно соблюдать требования по приватности и корпоративной информационной безопасности.
10) Как выбрать между облаком и локальной инфраструктурой?
- Выбор зависит от регуляторики, требований к задержкам, стоимости и масштабируемости. Часто применяется гибридный подход: чувствительные данные локально, вычисления и обучение — в облаке, с управлением доступов и аудита.
Мы помогаем компаниям переходить от экспериментов с AI к промышленным решениям с учетом безопасности данных и реального ROI. Проведем консультацию и предложим дорожную карту внедрения под задачи вашего бизнеса.


