

AI в цепях поставок: спрос, запасы и логистика
Добро пожаловать в одну из ключевых глав курса по теме AI Maturity в бизнес-подразделениях: финансы, цепи поставок, маркетинг и операции. Здесь мы подробно разберем, как искусственный интеллект влияет на три взаимосвязанных пространства: спрос, запасы и логистика. Мы рассмотрим теоретические основы, практические подходы, технические детали и реальные примеры внедрения — включая open-source инструменты и российские решения. В конце — FAQ, чтобы вы могли быстро уточнить спорные моменты и применить знания на практике.
Цепь поставок — это набор процессов и участков, где материальные потоки превращаются в денежные. В XXI веке добавилась цифровая составляющая: данные о спросе, запасах, поставках, маршрутах, ценах и промо-акциях служат сырьем для моделей, которые могут предсказывать будущие потребности, помогать принимать решения об уровне запасов и оптимизации логистических маршрутов. Важная мысль: AI-модели работают лучше не сами по себе, а в связке с бизнес-процессами, данными и управлением изменениями. Матричная структура «модель — данные — операционная система» должна быть спроектирована так, чтобы прогнозы становились actionable: понятными для менеджера по запасам, логистики и продаж.
Ключевые KPI, которые мы будем учитывать в рамках этой главы:
- прогноз точности спроса: MAE, RMSE, MAPE, sMAPE
- сервис-уровень и заполнение запасов: fill rate, stock-out rate
- финансовые показатели: оборот запасов (inventory turnover), средний срок хранения (DIO)
- эффективность логистики: коэффициент использования фургонов, среднее время доставки, расходы на перевозку на единицу продукции
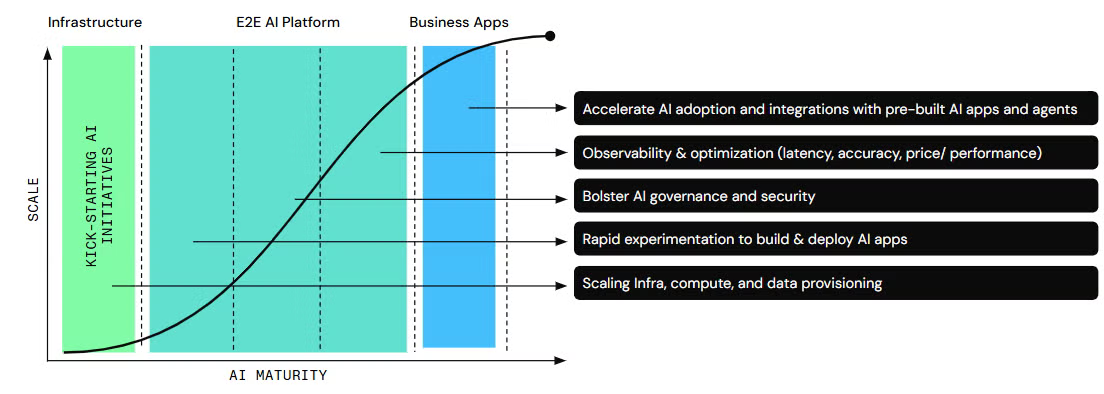
Мы не ограничимся теорией: вы увидите практические примеры, код и инструкции по сборке пайплайнов данных, обучению моделей, мониторингу и развертыванию. Особое внимание уделим контексту российских реалий: локализации данных, интеграции с отечественными ERP-системами, а также применению доступных российских инструментов и библиотек.
Что такое спрос, запасы и логистика в контексте AI?
- Спрос: совокупность потребностей клиентов по SKU, по регионам и каналам продаж. В прогнозировании спроса важно учитывать сезонность, промо-акции, внешние факторы (погода, экономическая конъюнктура), а также влияние конкурентов.
- Запасы: материалы на складе, готовая продукция и товары в пути. Оптимизация запасов — баланс между издержками хранения и риском дефицита. В основе — политики заказов, такие как EOQ, R, S-политики, ABC/XYZ-классификация.
- Логистика: маршрутизация, распределение по складам, поп-доставки, складская обработка, управление перевозчиками, отслеживание грузов и выполнение SLA. Модели логистики часто связаны с задачами оптимизации маршрутов и графики пополнения запасов.
Архитектуры AI в цепях поставок
End-to-end пайплайн:
- Ингестинг данных из ERP/OMS/CRM, сенсоров и внешних источников
- Очистка и нормализация данных
- Инженерия признаков (фичи): лаги по спросу, скользящие средние, праздники, акции, погодные и экономические факторы
- Обучение моделей: прогноз спроса, оптимизация запасов, предиктивная логистика
- Инференс и принятие решений в операционной системе
- Обратная связь: мониторинг качества, обновления моделей, управление дрейфом Hierarchical and local/global forecasting: распределение прогноза на SKU, склад, регион и канал. В реальных системах часто применяют иерархический прогноз или моделирование на уровне линеек SKU.
MLOps и управление данными:
- Feature store для управления признаками
- Контроль качества данных, мониторинг дрейфа и производительности моделей
- Контейнеризация и оркестрация (Docker, Kubernetes)
- Контроль версий моделей, эксперимент tracking (MLflow, DVC, Weights & Biases)
Модели и методы
- Временные ряды и классические методы: ARIMA, SARIMA, ETS (exponential smoothing), TBATS. Хороши для базового уровня и baseline.
- Прогнозирование на табличных данных с помощью машинного обучения: градиентные бустинги (XGBoost, LightGBM, CatBoost), случайные леса, регрессия на основе линейных и нелинейных моделей.
- Глубокое обучение для временных рядов: LSTM, Temporal Convolutional Networks (TCN), трансформеры для временных рядов, например, Transformer-based подходы.
- Графы и иерархии: hierarchical forecasting, они позволяют прогнозировать спрос на уровне SKU и на уровне группы SKU, затем агрегировать.
- Объяснимость и доверие: SHAP, LIME, встроенные механизмы объяснимости в CatBoost. В логистике объяснимость помогает бизнесу понять, почему модель принимает то или иное решение.
Метрики и оценка качества
- Прогноз на уровне одного шага: MAE, RMSE, MAPE
- Прогноз на горизонтах: с ростом горизонта ошибки часто растут; полезно использовать sMAPE для сравнения
- Кросс-валидация по времени: preserve order of time, avoid leakage
- Оценка по бизнес-показателям: влияние на уровень сервиса, оборот запасов, затраты на хранение и перевозку
- Мониторинг дрейфа: как мышление бизнеса меняется, а данные — нет; нужны детекторы изменений
Интеграция AI в процессы планирования
- Совмещение с ERP/планированием запасов: BI-дашборды и отчеты, которые объясняют, как прогноз влияет на решения по заказам, пополнению запасов, маршрутизации
- Гибридные решения: сочетание машинного прогноза с экспертной настройкой. В начале проекта часто запускают простые baselines и постепенно добавляют сложные модели
- Data governance и безопасность: локализация данных, контроль доступа, аудит изменений моделей и данных
Риски и ограничения
- Качество данных и интеграция: несогласованность данных между системами, пропуски, дубли
- Концепт-дриф и нестабильность спроса: макроэкономика, санкции, сезонность
- Перезакрепление решений: слишком частые обновления моделей без учета операционных ограничений могут вызвать провал внедрения
- Прозрачность: некоторые модели «черные ящики» в корпоративной среде недопустимы
- Оценка ROI: сложность точной оценки экономического эффекта на старте проекта
- Правовые и локальные требования: хранение данных в регионе, экспорт и импорт критической информации
- Уровень компетенции: взаимодействие между аналитиками, ИТ-отделами и бизнес-подразделениями
Практические примеры
Ниже — примеры сценариев с кодом, которые иллюстрируют принципы и методики. Мы используем как открытые инструменты, так и решения, которые хорошо применимы в российской практике.
Пример 1: Прогноз спроса для мульти-SKU с использованием Prophet и CatBoost
Цель: получить baseline прогноз спроса на каждый SKU по регионам на следующий период, используя сезонность и промо-акции, а затем улучшить прогноз через ML-модель.
- Простой baseline: Prophet (open-source)
- Улучшение: CatBoostRegressor с учетом признаков
Код (Python):
# Базовый импорт
import pandas as pd
from prophet import Prophet
from sklearn.metrics import mean_absolute_error
from catboost import CatBoostRegressor

# Пример данных: столбцы ['date', 'store_id', 'product_id', 'demand', 'promo', 'price', 'holiday']

# Подготовка данных
df = pd.read_csv('supply_chain_demand.csv', parse_dates=['date'])
df = df.sort_values(['store_id', 'product_id', 'date'])

# Baseline Prophet по SKU+регион
def forecast_with_prophet(df_grouped):
    m = Prophet(yearly_seasonality=True, weekly_seasonality=True, daily_seasonality=False)
    m.fit(df_grouped.rename(columns={'date':'ds','demand':'y'}))
    future = m.make_future_dataframe(periods=28)
    forecast = m.predict(future)
    return forecast[['ds','yhat']]

# Объединяем прогнозы по всем группам (SKU-region)
# Пример упрощения: один процесс для демонстрации
df_prophet = df.groupby(['store_id','product_id']).apply(
    lambda g: forecast_with_prophet(g[['date','demand']].rename(columns={'date':'ds','demand':'y'}))
).reset_index()

# ML-подход CatBoost
features = df.copy()
# Пример фичей: лаги спроса, скользящие средние, промо, праздники
def add_features(df):
    df['week'] = df['date'].dt.isocalendar().week.astype(int)
    df['month'] = df['date'].dt.month
    df['lag_1'] = df.groupby(['store_id','product_id'])['demand'].shift(1)
    df['rolling_mean_7'] = df.groupby(['store_id','product_id'])['demand'].transform(lambda x: x.shift(0).rolling(window=7).mean())
    return df

df_feat = add_features(df)

# Катбогс регрессор
cat_features = ['store_id','product_id','promo','holiday']
X = df_feat.drop(columns=['demand','date'])
y = df_feat['demand']

model = CatBoostRegressor(iterations=500, depth=6, learning_rate=0.05, loss_function='MAE', verbose=False)
model.fit(X, y, cat_features=cat_features, eval_set=(X, y), verbose=False)

# Прогнозируем на тестовом периоде
X_test = X.copy()
y_pred = model.predict(X_test)

mae = mean_absolute_error(y, y_pred)
print("CatBoost MAE:", mae)
Примечания:
- Prophet даёт быстрый baseline и хорошо работает с сезонностью, однако может быть менее точной при наличии множества взаимодополняющих факторов (промо, цена, внешний контекст).
- CatBoost хорошо обрабатывает категориальные признаки и может работать на табличных данных без большого объема ручной генерации признаков. В российской практике CatBoost активно применяется за счет своей эффективности и поддержки русского сообщества.
Пример 2: Оптимизация запасов и политика пополнения
Цель: определить оптимальный корректирующий размер заказа и точку повторного размещения заказа.
Код (упрощенный пример на Python):
import numpy as np
import pandas as pd

# Параметры: спрос S (ежемесячно), уровень обслуживания beta, стоимость заказа K, стоимость хранения h
S = 1200  # средний месячный спрос
K = 50    # стоимость заказа
h = 0.5   # стоимость хранения за единицу в месяц
L = 1     # лаг поставки (поставщик: 1 месяц)

# EOQ
Q_opt = np.sqrt((2 * K * S) / h)
print("Оптимальный размер заказа (EOQ):", Q_opt)

# Рекомендация по точке пополнения: reorder point
mean_lead = 1.0  # среднее время доставки в месяцах
ROP = S * mean_lead
print("Точка повторного размещения заказа (ROP):", ROP)
Этот пример иллюстрирует базовую идейную логику: использовать спрос и издержки для определения оптимального объема заказа и уровня запасов. В реальной системе ROP рассчитывается по каждому SKU и складу с учетом вариативного спроса, сезонности и ограничений по поставкам.
Пример 3: Оптимизация маршрутов и VRP
Цель: минимизировать суммарные перевозочные издержки и время доставки, распределив заказы по маршрутам.
Код (OR-Tools, упрощенный пример):
from ortools.linear_solver import pywraplp

# Пример данных: узлы (склады), клиенты, расстояния между ними
distance = [
    [0, 5, 9, 4],
    [5, 0, 6, 7],
    [9, 6, 0, 3],
    [4, 7, 3, 0]
]

num_vehicles = 2
depot = 0

# Простая реализация VRP с использованием OR-Tools
# Детали реализации опущены ради краткости; в реальном проекте вы строите модель
# маршрутов, лимит по объему и времени, и используете поиск по комбинациям.

print("VRP-задача подготовлена к запуску через OR-Tools (реальная реализация — в документации).")
OR-Tools — один из наиболее мощных и открытых инструментов для решения задач маршрутизации и логистической оптимизации, включая VRP, VRPB (с ограничениями по времени) и другие сценарии.
Архитектура data-pipeline
Источники данных:
- ERP/OMS: заказы, отгрузки, запасы, поставщики
- CRM: продажи по каналам
- Сенсорные и внешние источники: погода, праздники, экономические индикаторы
Этапы:
- Интеграция и ETL: извлечение, трансформация, загрузка (Spark, Airflow, Prefect)
- Очистка и качество данных: устранение дубликатов, приведение единиц измерения, dealing with missing values
- Инженерия признаков: лаги спроса, скользящие средние, сезонные признаки, промо-поддержка
- Обучение и валидация: time-series cross-validation, гиперпараметрическая настройка
- Развертывание: Docker-контейнеры, Kubernetes, CI/CD
- Мониторинг и обновление: Evidently AI, MLflow, дрифт-ловушки, A/B-тесты
Инженерия признаков и примеры фич
- Временные признаки: год, месяц, неделя, день недели, праздники
- Lag-фичи: спрос за прошлые периоды (1, 2, 4 недели)
- Скользящие средние: 7, 14, 28 дней
- Факторы акций и цен: бинарные индикаторы промо, изменение цены
- Дополнительные факторы: погодные условия, локальные события, номенклатура (категории)
Модели и выбор инструментов
- Prophet — базовый baseline для сезонности и тенденций; простота и доступность
- CatBoost — для табличных данных с категориальными признаками; хорошая точность, поддержка категорий без большого количества преобразований
- XGBoost/LightGBM — мощные бустинговые модели для больших наборов признаков
- Darts / PyTorch Forecasting — глубокие методы для временных рядов, позволяющие комбинировать признаки и нейронные блоки
- MLOps: MLflow, Kubeflow, Feast (feature store) — для воспроизводимости и мониторинга
Примеры российских инструментов и практик
- CatBoost от Yandex (российская разработка) хорошо подходит для табличных данных с большим количеством категориальных признаков, часто применяется в российских проектах по спросу и запасам.
- Российские ERP- и BPM-экосистемы (например, 1C и интеграционные решения) позволяют внедрять ML‑модели в существующие процессы планирования запасов и распределения.
- Встроенные в экосистемы инструменты визуализации и отчетности для российского бизнеса: Power BI / Grafana с локальными данными.
- Открытые библиотеки как базис для локальных решений: CatBoost, Prophet, scikit-learn, PyTorch, Darts.
Пример пайплайна внедрения
- Шаг 1: собрать данные по складам, SKU, регионам, времени, акций и внешним факторам
- Шаг 2: построить feature store через Feast или аналог
- Шаг 3: обучить baseline модель (Prophet) на сегме SKU-лок
- Шаг 4: добавить ML-модель (CatBoost) с учетом категориальных признаков
- Шаг 5: внедрить инференс в ERP/планировщик запасов, организовать обратную связь
- Шаг 6: настроить мониторинг дрейфа, регламент обновления моделей и регулятивные проверки
Ключевые аспекты для практического внедрения: документация по требованиям к данным, соглашения об уровне сервиса, безопасность и контроль доступа, а также культура использования данных внутри команды.
Риски и ограничения внедрения
- Данные и интеграция: несоответствия между системами, пропуски и несогласованность единиц измерения
- Концепт-дрифт: спрос может изменяться вслед за экономикой или внешними факторами; модели должны обновляться
- Ригидность процессов: бизнес-подразделения могут сопротивляться изменениям или требовать слишком сложных интерпретаций
- Прозрачность и доверие: многие бизнес-пользователи требуют объяснимых прогнозов и понятных концепций
- Безопасность и локализация: требования к хранению данных в регионе, соответствие законам
- ROI и валидность: доработки моделей занимают время, и эффект может быть не мгновенным; важно начать с пилота и измерять ROI на ранних этапах
- Ограничения по компетенциям: для устойчивого внедрения требуется межфункциональная команда аналитиков, ИТ-специалистов и бизнес-экспертов
- Ограничения инфраструктуры: необходимость адаптировать существующие инфраструктуры, ERP-системы и процессы к AI-решениям
Выводы
- AI-подходы к спросу, запасам и логистике позволяют уменьшить издержки, повысить уровень сервиса и улучшить финансовые показатели. Важно не только выбрать правильные модели, но и выстроить устойчивый пайплайн данных и эффективную операционную систему (MLOps).
- В российской практике ценится применение отечественных решений и инструментов, особенно CatBoost и другие открытые технологии, интегрированные в локальные ERP/CRM системы и инфраструктуру хранения данных.
- Успешное внедрение требует совместной работы бизнес-подразделений, ИТ и аналитиков, четкой стратегии по управлению данными и плану пилотирования, чтобы избежать ловушек избыточной сложности и неэффективности.
- В итоге ROI достигается за счет последовательного масштаба внедрения: сначала baseline, затем улучшения, затем полная интеграция в планирование запасов и маршрутизацию в реальном времени.
Таблица: сравнение подходов к прогнозированию спроса
| Подход | Описание | Преимущества | Ограничения | Тип данных |
|---|---|---|---|---|
| Prophet | Базовый baseline для сезонности | Быстрое разворачивание, понятные параметры | Может быть слабым на сложные паттерны и промо-эффекты | Временные ряды, сезонность |
| CatBoost | Градиентный бустинг с поддержкой категориальных признаков | Высокая точность на табличных данных, без большого объема кодирования | Требуется качественная подготовка признаков | Табличные данные, регрессия |
| XGBoost / LightGBM | Мощные бустинговые модели | Выдающаяся точность, масштабируемость | Требуют аккуратной предобработки | Табличные данные |
| Darts / PyTorch Forecasting | Глубокие и гибкие модели для временных рядов | Модели со сложной динамикой | Требуют вычислительных ресурсов | Временные ряды, FNN/Transformer |
| OR-Tools (VRP) | Оптимизация маршрутов | Эффективная маршрутизация, экономия затрат | В примерах — сложная настройка | Логистика, маршрутизация |
Практические заметки по внедрению
- Начинайте с пилота на одном складе и ограниченном наборе SKU, затем расширяйтесь
- Старайтесь строить прозрачные метрики и KPI, чтобы убедиться в бизнес-ценности
- Интеграция с ERP/OMS должна быть умеренно агрессивной: не перегружайте систему изменениями за один заход
- Регулярно обновляйте данные и пересматривайте модели на основе фактически полученных результатов
- Внедряйте мониторинг дрейфа и инструментов объяснимости, чтобы бизнес мог понять решения модели
Эта глава демонстрирует, что AI в цепях поставок — это не только прогнозирование спроса, но и целостная экосистема: данные, инженерия признаков, выбор моделей, пайплайны MLOps, связь с ERP и бизнес-решениями, а также управление рисками. Реальные примеры с использованием open-source инструментов и русскоязычных решений показывают, как можно быстро начать с базовых подходов и постепенно переходить к более сложным, с учётом конкретных условий рынка и регуляторной среды. В конечном счете, успех в AI-мaturity цепей поставок достигается через четкое определение целей, прозрачную архитектуру данных, устойчивые пайплайны и тесное взаимодействие между бизнесом и ИТ.
Вопрос–Ответ (FAQ)
1) Что такое AI-мaturity в контексте цепей поставок и почему это важно?
- AI-мaturity — это стадия развитости организации в применении искусственного интеллекта к бизнес-процессам. В цепях поставок это означает систематическое прогнозирование спроса, оптимизацию запасов и маршрутизации с использованием данных, интеграцию AI в ERP/OMS, настройку MLOps и способность оперативно реагировать на изменения рынка. Важно для снижения затрат, повышения сервиса и увеличения гибкости цепи поставок.
2) Какие данные нужны для эффективного прогнозирования спроса?
- Исторические продажи по SKU и регионе, цены и акции, запасы и поставки, информация о промо-акциях, календарные признаки (праздники, сезонность), внешние факторы (погода, экономические индикаторы), данные по каналу продаж и любые внешние события. Хороший набор — это чистые, согласованные данные без множества дубликатов и пропусков.
3) Какие модели подходят для разных горизонтов прогноза?
- Краткосрочные горизонты: Prophet, CatBoost/XGBoost с соответствующими признаками, учитывающими промо и сезонность. Для дальних горизонтов можно использовать комбинированные подходы: иерархический прогноз, нейросетевые модели (TCN/LSTM/Transformer) в сочетании с классическими методами. Важно проводить кросс-валидацию по времени.
4) Как выбрать между Prophet, CatBoost и глубоким обучением?
- Prophet хорош для быстрой базовой оценки сезонности и трендов и простоты использования. CatBoost эффективен для табличных данных с большим количеством категориальных признаков и без сложной предобработки. Глубокие модели (Darts, PyTorch Forecasting) предполагают доступ к вычислительным ресурсам и дают преимущества при сложной динамике, но требуют большего объема данных и настройки.
5) Как организовать данные и ML-операции?
- Рекомендую построить feature store (Feast или аналог), централизованную репозиторий признаков, пайплайн ETL, модельный регламент, мониторинг производительности и дрейфа. Используйте контейнеризацию (Docker), оркестрацию (Kubernetes), инструмент для экспериментов (MLflow) и тестовую среду для регрессии.
6) Какие риски связаны с внедрением и как их снижать?
- интеграция, концепт-дрифт, ограничение по ресурсам и смена бизнес-воли. Снижаются через пилоты, четко определенный план данных и KPI, прозрачность моделей, объяснимость и участие бизнес-пользователей в процессе.
7) Как адаптировать подход в российской среде?
- Используйте отечественные инструменты: CatBoost для работы с табличными данными, интегрируйте модели в локальные ERP/1C/OMS-системы, учитывайте требования локализации данных и регулятивные нормы. Учитывайте российские каналы и сезонность, промо-акции и праздники, которые влияют на спрос.
8) Какие KPI наиболее полезны для оценки успеха?
- Прогнозная точность (MAE, RMSE, MAPE, sMAPE), сервис-уровень, заполнение запасов, оборот запасов, DOS/DIO, стоимость перевозки на единицу продукции, время цикла поставки. Важно фиксировать не только точность, но и бизнес-эффект на через ROI и изменение сервиса.
9) Какие открытые инструменты стоит изучить и как использовать в практике?
- Prophet для базового прогноза. CatBoost для табличных данных и категориальных признаков. XGBoost/LightGBM для дополнительных моделей. OR-Tools для маршрутизации и VRP. Feast для feature store. Evidently AI или Alibi Detect для мониторинга дрейфа. Примеры кода и наборы данных можно найти в открытом доступе.
10) Что сделать в начале проекта по AI в цепях поставок?
- Определить крючевые KPI и цели, собрать команду из бизнес-специалистов и ИТ, выбрать пилот на одном складе/регионе, собрать и очистить данные, построить baseline, выбрать модель, реализовать пайплайн и начать мониторинг. Постепенно масштабировать после достижения первых результатов и демонстрации ROI.
Мы помогаем компаниям переходить от экспериментов с AI к промышленным решениям с учетом безопасности данных и реального ROI. Проведем консультацию и предложим дорожную карту внедрения под задачи вашего бизнеса.


