

Инструменты мониторинга Lakehouse: выбор стека (Prometheus, Grafana, Spark)
Мониторинг Lakehouse-платформ требует слаженной работы нескольких слоев: инфраструктуры, инструментов обработки данных и самих данных. Чтобы обеспечить надежность, управляемость затратами и соответствие требованиям безопасности и регуляторики, целостное решение должно охватывать:
- инфраструктурные метрики (CPU, память, диск, сеть, кластерная активность);
- метрики приложений и сервисов Lakehouse (Spark jobs, Delta/Lakehouse-зависимости, транзакции и операции чтения/записи);
- бизнес-метрики использования и затрат (стоимость хранения, вычислений, прочие ресурсы по проектам/пользователям);
- безопасность и контроль доступа (аудит, RBAC, мониторинг доступа к данным);
- соответствие требованиям (логирование, хранение метрик, защита данных в транзисторе и в покое, регуляторные регламенты).
Выбор стека чаще всего опирается на классический тройной набор: Prometheus для сбора и хранения метрик, Grafana для визуализации и дешбордов, а Spark — как источник и потребитель данных внутри Lakehouse, который имеет собственные способы экспорта метрик. В этом разделе мы разберем теоретические основы, архитектуру и практические подходы, включая альтернативные решения, доступные на открытом исходном коде и в российских экосистемах.
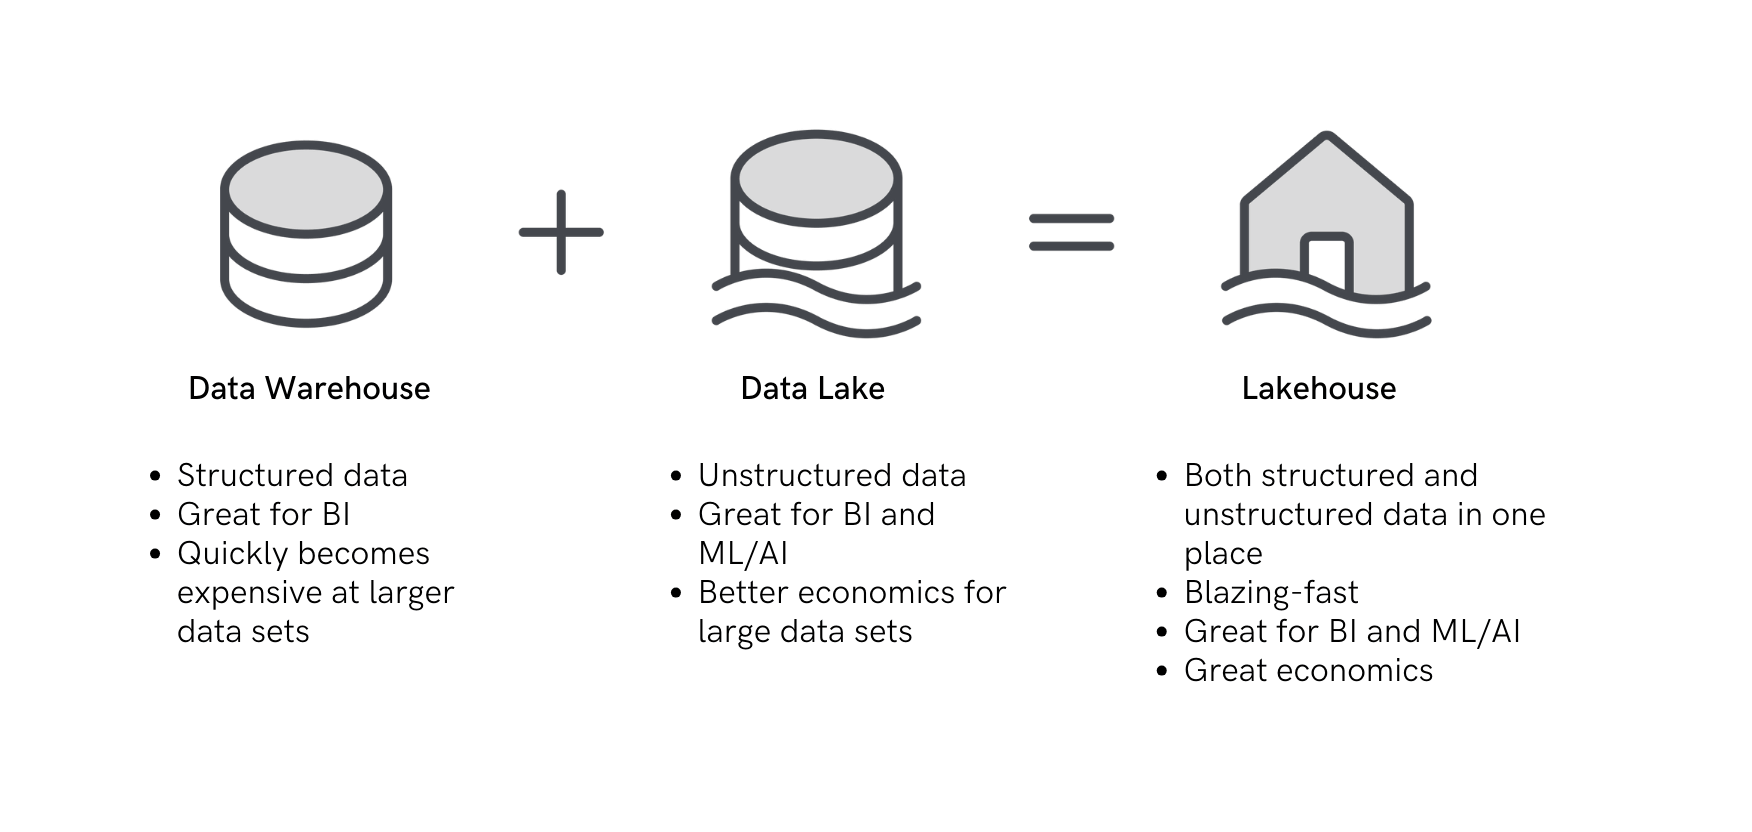
Что такое observability в Lakehouse?
Observability (наблюдаемость) — это способность понять внутреннее состояние системы по внешним феноменам: метрикам, логам и трассам. В контексте Lakehouse это включает:
- обещания по своевременности (RUM-сбор данных, задержки);
- полноту (покрытие критических метрик, включая операции чтения/записи и метрики данных);
- точность (согласованность метрик между слоями, единицы измерения и калибровки).
Сама по себе архитектура Lakehouse добавляет сложности: слои параллельной обработки (Spark), слой хранения данных, оркестрацию задач и многопользовательский доступ. Поэтому концептуально полезно рассматривать три слоя мониторинга:
- Инфраструктурный слой: хосты, кластеры Kubernetes/кластеры Spark, база данных хранения.
- Приложенческий слой: Spark-эксплуатация, задачи обработки, обмен данными между микросервисами.
- Данные и операции: загрузка данных, кеширование, транзакционные операции, качество данных, регуляторные события.
Архитектура стека: Prometheus + Grafana + Spark
Prometheus — система мониторинга и база временных рядов с pull-моделью. Основные элементы:
- Prometheus Server: сбор метрик, хранение в TSDB (time-series database), выполнение PromQL-запросов.
- Exporters: специальные агенты/модули, которые собирают метрики из систем и exposing их через HTTP endpoints.
- Alertmanager: централизованное управление оповещениями, маршрутизация по уведомлениям (e-mail, Slack, PagerDuty и пр.).
- Примеры экспортёров: node_exporter (инфраструктура), blackbox_exporter (доступ к внешним сервисам), mysqld_exporter, JVM-exporter (JMX/JVM-метрики).
Grafana — платформа визуализации и дашбордов. Позволяет соединяться с Prometheus (и многими другими источниками), строить интерактивные панели и алерты, управлять доступом.
Spark в Lakehouse — источник/потребитель данных. Метрики Spark могут экспортироваться в Prometheus несколькими способами:
- JVM-метрики Spark через JMX-экспортёр или Prometheus-совместимый экспортёр.
- Метрики из Spark Metrics System (через конфигурацию spark.metrics.conf) в Prometheus, иногда через сторонний адаптер (spark-prometheus sink).
- Метрики выполнения задач, стадии, задержки ввода/вывода, использования памяти, GC и т. д.
Архитектурное взаимодействие:
- Spark-узлы и Driver expose JVM/приложенческие метрики.
- Prometheus опрашивает экспортёры на HTTP-эндпойнтах.
- Grafana строит панели по Prometheus и/или другим источникам.
- Alertmanager отправляет уведомления при порогах и инцидентных правилах.
Важный момент: архитектура должна поддерживать сегментацию по проектам/пользователям, обеспечивает RBAC в Grafana и санкцированные политики доступа к данным и метрикам.
Метрики и методология
Категории метрик:
- Инфраструктурные: нагрузка CPU, использование памяти, IO, задержки сети, диск, состояние узлов.
- Приложенческие: время выполнения Spark задач, throughput, число тасков/шагов, количество ошибок, задержки очередей задач.
- Хранилище и данные: метрики операций чтения/записи, скорость записи/чтения, размер файлов, статистика транзакций Delta/Apache Iceberg.
- Безопасность и аудит: попытки входа, успешные/неуспешные аутентификации, события аудита доступа к данным.
- Затраты и эффективность: вычислительная стоимость, расход памяти, задержка SLA, потребление ресурсов на конкретные пайплайны.
Принципы дизайна:
- Кардинальность: избегайте слишком высокого cardinality, чтобы не перегрузить TSDB.
- Наследование и единство единиц измерения: используйте единицы (сек, миллисекунд, байты).
- Релевантность: фокус на самых критичных метриках и предупреждениях.
- Аудит и доступ: сбор только тех данных, которые разрешены по регуляторике.
Практические подходы к сбору и агрегации
Pull vs Push:
- Prometheus по умолчанию работает по Pull (опрашивает endpoints). Это удобно для большинства систем, но требует открытых endpoints в сетях.
- В некоторых сценариях можно использовать Pushgateway для пакетной отправки произвольных задач, которые не могут быть опрошены напрямую.
Экспортёры:
- node_exporter для инфраструктуры.
- JMX Exporter для JVM-метрик Spark.
- Prometheus JVM Metrics (инструментальные принципы).
- Spark-exporters, которые собирают Spark-метрики и репортят их в Prometheus.
Хранение и хранение резервных копий:
- Прямое хранение в Prometheus (локальное) или использованием внешних TSDB (VictoriaMetrics, Mimir/ Cortex, Thanos) для масштабирования и долговременного хранения.
Визуализация и алерты:
- Grafana dashboards с использованием PromQL запросов.
- Alertmanager правила для ошибок выполнения, задержек и аномалий.
Практические примеры
Ниже приводятся конкретные примеры конфигураций и сценариев внедрения, которые можно адаптировать под реальный Lakehouse.
Пример 1: Базовый стек Prometheus + Grafana для Lakehouse
Архитектура:
- Prometheus Server
- Node Exporter на каждом узле кластера
- JVM Exporter на драйвере Spark и на исполнителях (или Prometheus JMX Exporter)
- Grafana сервер
- Alertmanager
Конфигурация Prometheus (простой пример prometheus.yml):
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'linux'
    static_configs:
      - targets: ['node1.example.com:9100', 'node2.example.com:9100']

  - job_name: 'spark-jvm'
    static_configs:
      - targets: ['spark-driver.example.com:9500', 'spark-executor1.example.com:9500', 'spark-executor2.example.com:9500']

  - job_name: 'spark-jmx'
    static_configs:
      - targets: ['spark-driver.example.com:9999', 'spark-executor1.example.com:9999']
    metrics_path: /metrics
    scheme: http
Конфигурация JMX Exporter (пример для spark-driver на /opt/jmx_exporter/config.yaml):
startDelaySeconds: 0
hostName: localhost
ssl: false
lowerCaseOutputName: true
lowerCaseOutputNameQueue: true
rules:
  - pattern: "java.lang (.*)"
    name: "jvm_
    type: GAUGE
Пример дашборда Grafana (JSON/GUI можно экспортировать). Включает панели:
- CPU и память узлов
- Время выполнения Spark задач
- Количество активных задач и стадий
- Скорость чтения/записи в Delta Lake
- Нагрузки по проектам/пользователям
Примеры запросов PromQL:
- Средняя задержка выполнения Spark задач за 15 мин: avg by(job) (spark_executor_duration_seconds_sum / spark_executor_duration_seconds_count)
- Использование памяти в JVM Spark: jvm_memory_bytes_used
Пример 2: Мониторинг затрат и эффективности
Цель: отслеживать затраты на вычисления и хранение по проектам.
Метрики:
- costs_compute_usd_total (если интегрируете данные затрат из облака)
- storage_cost_usd_total (стоимость хранения)
- throughput_per_project
Архитектура:
- Prometheus получает данные из облачных слоёв отчета затрат (через API) и отдельных метрик из Spark.
- Grafana: панели по затратам, распределение по проектам, траты на пайплайны.
Пример запросов:
- Ряд затрат по проекту за месяц: sum by(project) (costs_compute_usd_total[30d])
- Средняя скорость обработки по пайплайну: avg by(pipeline) (spark_job_duration_seconds)
Пример 3: Российские решения и Open-Source альтернативы
Виктория Метрики (VictoriaMetrics):
- Совместим с Prometheus API, может выступать как TSDB замена Prometheus, снижая требования к памяти и увеличивая горизонтальную масштабируемость.
- Интеграция с Grafana через тот же источник: VictoriaMetrics поддерживает PromQL-подобные запросы.
- Пример конфигурации: prometheus.yml может использовать VictoriaMetrics как удалённое хранилище через remote_write:
remote_write:
  - url: http://victoriametrics.example.com/api/v1/write
Zabbix (российская система мониторинга):
- Хорош для инфраструктурных метрик, агентов на серверах и сетевых узлах.
- Может быть интегрирован с Prometheus через пулы агентов и прокси, для обеспечения дополнительного контроля на уровне корпоративной сети.
Примеры полезных инструментов:
- spark-prometheus (адаптер/плагин для экспорта Spark-метрик в Prometheus)
- JMX Exporter для JVM Spark-метрик
- Prometheus Pushgateway для пакетной отправки метрик из нестандартных задач
- Grafana Loki для логов, связанных с Spark и данными
Примечание: при выборе российского стека или интеграции, важно учитывать соответствие локальным нормативам и лицензирование. VictoriaMetrics и Zabbix — примеры открытых инструментов с сильной поддержкой в российской IT-среде и содействием к локализации.
Архитектура и компоненты
Prometheus:
- Сервер сбора метрик, хранение в TSDB, язык запросов PromQL.
- Exporters: node_exporter, jmx_exporter, spark_exporter (или jjmx/прямые источники через spark.metrics).
Grafana:
- Панели, дашборды, алерты, доступ через роли.
- Поддержка плагинов: панели, типы графиков, таблицы, алерты.
Alerting:
- Alertmanager: маршрутизация оповещений, группы уведомлений, деплой по кластерам.
Spark Metrics:
- Встроенный Spark Metrics System (Dropwizard-based) позволяет настраивать sinks.
- Пример конфигурации spark.metrics.conf (часть):
*.sink.prometheusServlet.class=org.apache.spark.metrics.sink.PrometheusSink
*.sink.prometheusServlet.path=/metrics
Альтернативы: spark-metrics, spark-prometheus, Prometheus JMX Exporter.
Безопасность и соответствие
Безопасность метрик:
- TLS для endpoints Prometheus/JMX Exporter.
- Аутентификация доступа к Prometheus и Grafana (LDAP, OAuth2, SSO).
- Ограничение доступа к метрикам, чтобы не раскрывать чувствительную информацию.
Контроль доступа и RBAC:
- GrafanaRBAC: роли пользователей по проектам.
- Разделение пространств имён/пользователей в Prometheus (несколько экземпляров, отдельные endpoints) или через владельцев/пользователей в источниках Grafana.
Регуляторные требования:
- Хранение логов и метрик в рамках политики хранения (например, соответствие требованиям по аудиту и сохранению данных).
- Защита персональных данных и бизнес-метрик — минимизация чувствительных данных в метриках.
- Возможность аудитирования доступа к данным и метрикам.
Модели хранения и масштабирование
Выбор хранилища:
- Prometheus: локальное хранение для небольших кластеров.
- VictoriaMetrics, Cortex, Thanos для масштабирования и долговременного хранения.
Масштабирование:
- Горизонтальное масштабирование Prometheus (несколько экземпляров) с глобальной агрегацией через Thanos или VictoriaMetrics.
- Grafana: централизованные дашборды на основе нескольких источников/кластеров. Кардинальность:
- Контроль cardinality: избегайте использования уникальных значений (таких как идентификаторы сессий) в метриках, если это не требуется.
- Пример: вместо метрических label, включайте более общие поля (project, environment, job) и минимизируйте уникальные значения.
Практические принципы внедрения
Этап 1: база и пилот
- Развернуть Prometheus + Grafana на одном кластере, собрать базовые метрики инфраструктуры и Spark.
- Настроить базовые дашборды: узлы, операции Spark, чтение/запись в Delta Lake.
Этап 2: углубление наблюдаемости
- Добавить экспортёры JVM, настройку Spark Metrics, мониторинг затрат и производительности.
- Внедрить RBAC и базовую защиту endpoints.
Этап 3: масштабирование и соответствие
- Переписать хранилище метрик на VictoriaMetrics или аналог, настроить долговременное хранение.
- Включить логи и трассировку (OpenTelemetry) для полноты наблюдаемости.
Этап 4: стандарты и процессы
- Разработать политики уведомления и SLA по мониторингу.
- Регламентировать периодичность ретенции метрик, архивирование и удаление.
Примеры кода и конфигураций
Пример конфигурации Prometheus для Prometheus Server:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'spark'
    static_configs:
      - targets: ['spark-driver.example.com:9876', 'spark-executor1.example.com:9876', 'spark-executor2.example.com:9876']
Пример конфигурации Spark Metrics для Prometheus (spark.metrics.conf):
*.sink.prometheusServlet.class=org.apache.spark.metrics.sink.PrometheusSink
*.sink.prometheusServlet.path=/metrics
Пример конфигурации JMX Exporter для Spark JVM-метрик (config.yaml):
startDelaySeconds: 0
hostName: localhost
rules:
  - pattern: 'java.lang:type=(.{1,})'
    name: 'jvm_type_$1'
    type: GAUGE
Пример дашборда Grafana (ключевые панели):
- Panel: Spark job duration (seconds)
- Panel: Delta Lake read/write throughput
- Panel: JVM memory usage
- Panel: Node CPU/memory utilization
- Panel: Cost/usage by project (если есть данные затрат)
Риски и ограничения внедрения
Кардинальность и производительность:
- Сбор большого числа уникальных лейблов может привести к перегрузке Prometheus и ухудшению производительности.
- Решение: стандартные лейблы, ограничение cardinality, агрегация на уровне exporters.
Стоимость хранения и инфраструктуры:
- Долговременное хранение больших массивов метрик требует дополнительных затрат на хранилище и вычисления.
- Решение: перейти на VictoriaMetrics или Cortex/Thanos для горизонтального масштабирования и экономии.
Безопасность:
- Метрики могут раскрывать информацию о системе или нагрузке; важно ограничить доступ и использовать TLS/аутентификацию.
Зависимость от инфраструктуры:
- Объем и качество сетевых и серверных ресурсов влияют на точность и своевременность опросов.
Регуляторика:
- Моменты сохранения и доступа к метрикам должны соответствовать требованиям конфиденциальности и аудита.
Вендорная и технологическая зависимость:
- Привязка к конкретному стеку (Prometheus/Grafana) может ограничить возможности перехода на альтернативы. Использование открытых стандартов PromQL, Grafana dashboards и совместимых TSDB снижает риск.
Выводы
- Выбор стека Prometheus + Grafana + Spark обоснован ясной архитектурой, поддержкой сообщества, гибкостью и возможностью расширения под требования Lakehouse.
- Включение Spark-метрик в набор мониторинга позволяет видеть не только состояние инфраструктуры, но и эффективность обработки данных, задержки и качество транзакций в Lakehouse.
- Российские решения (VictoriaMetrics, Zabbix) могут быть эффективной составляющей, особенно для локализации данных и интеграции в существующую IT-инфраструктуру. Они предлагают совместимость с Prometheus API и возможность снижения затрат на хранение и масштабирование.
- Основные риски — кардинальность метрик, стоимость хранения, безопасность, регуляторика и зависимость от конкретного стека. Умеренное планирование, этапность внедрения и продуманная архитектура позволяют снизить риски.
- Важнейшие практики: сегментирование метрик по проектам, RBAC в Grafana, TLS/аутентификация, долговременное хранение и планирование ретенции, регулярные тесты алертов и обновления.
FAQ (Вопрос–Ответ)
1) Что такого важного в выборе Prometheus + Grafana для Lakehouse?
- Prometheus обеспечивает гибкое хранение временных рядов и мощный язык запросов PromQL, Grafana обеспечивает наглядную визуализацию и алерты. Вместе они позволяют быстро обнаруживать проблемы в обработке данных (Spark), задержки в загрузке/выгрузке данных и аномалии в использовании кластера.
2) Как экспортировать Spark-метрики в Prometheus?
- Существуют разные подходы: использовать Spark Metrics с Prometheus sink через spark.metrics.conf, или разворачивать JVM-метрики Spark через JMX Exporter. Также можно использовать spark-prometheus адаптеры, чтобы собирать специфические показатели Spark. Важно обеспечить доступность эндпоинтов на драйвере и исполнителях для Prometheus.
3) Какие российские решения можно сочетать с Open-Source стеком?
- VictoriaMetrics как альтернативное TSDB, совместимое с PromQL; Zabbix как дополнительный инструмент для инфраструктурного мониторинга и аудита; OpenTelemetry для трассировки и распределённой мониторинга. Эти инструменты позволяют адаптировать стек под локальные требования, регуляторику и безотлагательную экономию.
4) Как избежать перегрузки Prometheus по количеству метрик?
- Ограничьте cardinality через выделение ключевых лейблов (project, environment, service) и избегайте уникальных значений в метриках. Применяйте агрегацию на стороне экспортёров и используйте фильтры при запросах PromQL. Можно рассмотреть переход к внешнему TSDB (VictoriaMetrics) для долговременного хранения.
5) Какие аспекты безопасности критичны для мониторинга Lakehouse?
- Шифрование в транзите (TLS) между Prometheus, Grafana, экспортёрами и кластерами. Ограничение доступа к эндпоинтам метрик (аутентификация и авторизация). RBAC в Grafana и разделение доступа к данным. Журналы аудита и соответствие регуляторным требованиям.
6) Какие примеры конфигурации полезны на старте проекта?
- Пример prometheus.yml с базовым pull-моделью, node_exporter и Spark JVM-метриками. Пример spark.metrics.conf для экспорта в Prometheus. Пример конфигурации JMX Exporter для драйвера Spark и исполнителей. Примеры дашбордов Grafana включают панели по задержкам, загрузке кластера, IO и затратам.
7) Как учитывать затраты и экономическую эффективность мониторинга?
- Включите метрики затрат и планируйте хранение. Подключите данные об операционных расходах через облачные API (costs), и добавьте панели в Grafana для анализа затрат по проектам. В случае больших объемов метрик выберите более экономичное хранение ( VictoriaMetrics ) и продуманные retention policies.
8) Как обеспечить устойчивость и масштабируемость стека?
- Развернуть Prometheus в кластере с несколькими инстансами и использовать VictoriaMetrics/Cortex/Thanos для долговременного хранения. Распределение по зонам доступности и кластеризация Grafana для высокой доступности.
9) Как улучшить наблюдаемость Spark помимо метрик?
- Добавьте трассировку распределённых задач через OpenTelemetry; журналы Spark агрегируйте в лог-аналитику (например, Loki) и связывайте логи с метриками по идентификаторам заданий. Это позволяет быстро идентифицировать проблемы на уровне пайплайна.
10) Что важно учесть при внедрении в российской компании?
- Соблюдать локальные регуляторные требования по хранению данных и аудиту, учитывать лицензионные ограничения и интеграцию с локальными решениями. Использование российских инструментов (VictoriaMetrics, Zabbix) в связке с Open-Source стеком может снизить риск задержек и уменьшить затраты на сетевой трафик и хранение. Важно также предусмотреть локализацию интерфейсов и технических специалистов.
Lakehouse — это основа современной data-стратегии и масштабируемой аналитики. Узнайте, как мы внедряем Lakehouse-архитектуру, которая объединяет данные, снижает издержки и ускоряет принятие управленческих решений.


