

Каталог данных: концептуальная архитектура, реализация и миграция к OpenMetadata в контексте сравнительного анализа DataHub, OpenMetadata и Amundsen
Каталог данных представляет собой систематизированное хранилище описаний источников, их метаданных и бизнес‑терминов, призванное обеспечить единое восприятие данных и прозрачность их использования внутри организации. В условиях зрелой цифровой трансформации предприятия задача состоит не только в каталогизации объектов, но и в создании надёжного “единого источника правды” об источниках, преобразованиях, владении ответственностями и требованиях к качеству данных. В данном исследовании мы опишем путь создания каталога данных в рамках крупной розничной сети и обсудим стратегию миграции к платформе OpenMetadata на фоне сравнения с DataHub и Amundsen.
Цели проекта охватывают несколько взаимодополняющих аспектов. Во‑первых, повысить обнаружимость источников данных и их связей через единый механизм описания, что снижает время на поиск информации и уменьшает дублирование отчетов. Во‑вторых, обеспечить управляемость качеством заполнения описаний: верифицируемость форм заполняемой информации, регламент реджекта некорректных данных и аудит изменений. В‑третьих, зафиксировать бизнес‑глоссарий и родительско‑детерминированные связи между терминами для унификации трактовки бизнес‑показателей и снижения культурных различий между командами. В‑четвёртых, зафиксировать и визуализировать lineage данных и преобразований, обеспечивая трассируемость от источников к отчетам и метрикам, лежащим в их основе.
Изначальная реализация осуществлялась «с нуля» с опорой на локальные ресурсы и отдельные инструменты: команда из системного аналитика, инженера данных и BI‑аналитика реализовала архитектуру, схему хранения и фронтенд‑интерфейс. В качестве MVP основное внимание было уделено описанию и документированию отчетов Power BI: от отбора приоритетных отчетов до детальной регистрации полей, расчетов и влияния на бизнес‑показатели. Это позволило оперативно запустить инфраструктуру описания и собрать раннюю обратную связь от пользователей. В ходе проекта возникли крупные выводы: визуальные и функциональные ограничения коммерческих BI‑платформ во взаимодействии с текстово‑ориентированной бизнес‑метаинформацией, необходимость единого механизма качества описаний и значимое влияние дизайна модели хранения на скорость реализации. В последующем был проведён переход к готовому решению по управлению данными OpenMetadata, что открыло путь к масштабируемой интеграции, более полноценно заточенной под требования будущей эволюции каталога.
Стратегия развития базируется на итерациях: начиная с ограниченного MVP, затем рост функционала через бизнес‑глоссарий и метаданные, расширение линейности и согласование терминов, внедрение продвинутых механизмов поиска и анализа, а затем полноценно‑модульная миграция на OpenMetadata c возможной синергией с DataHub и Amundsen. Такой подход сочетает: а) быстрый вывод на рынок и получение обратной связи; б) системную архитектуру, ориентированную на расширение и устойчивое сопровождение; в) возможности для конкуренции на рынке управляемых данных за счёт открытых стандартов метаданных и гибкости интеграций.
В рамках статьи мы систематизируем опыт проекта по каталогу данных, приводя принципы, методы и практические решения, которые можно адаптировать к аналогичным контекстам — от малых и средних организаций до крупных корпоративных ландшафтов. В заключении представим дорожную карту внедрения каталога данных в разных секторах экономики и базовые метрики эффективности, которые помогут оценивать прогресс и ценность для бизнеса.
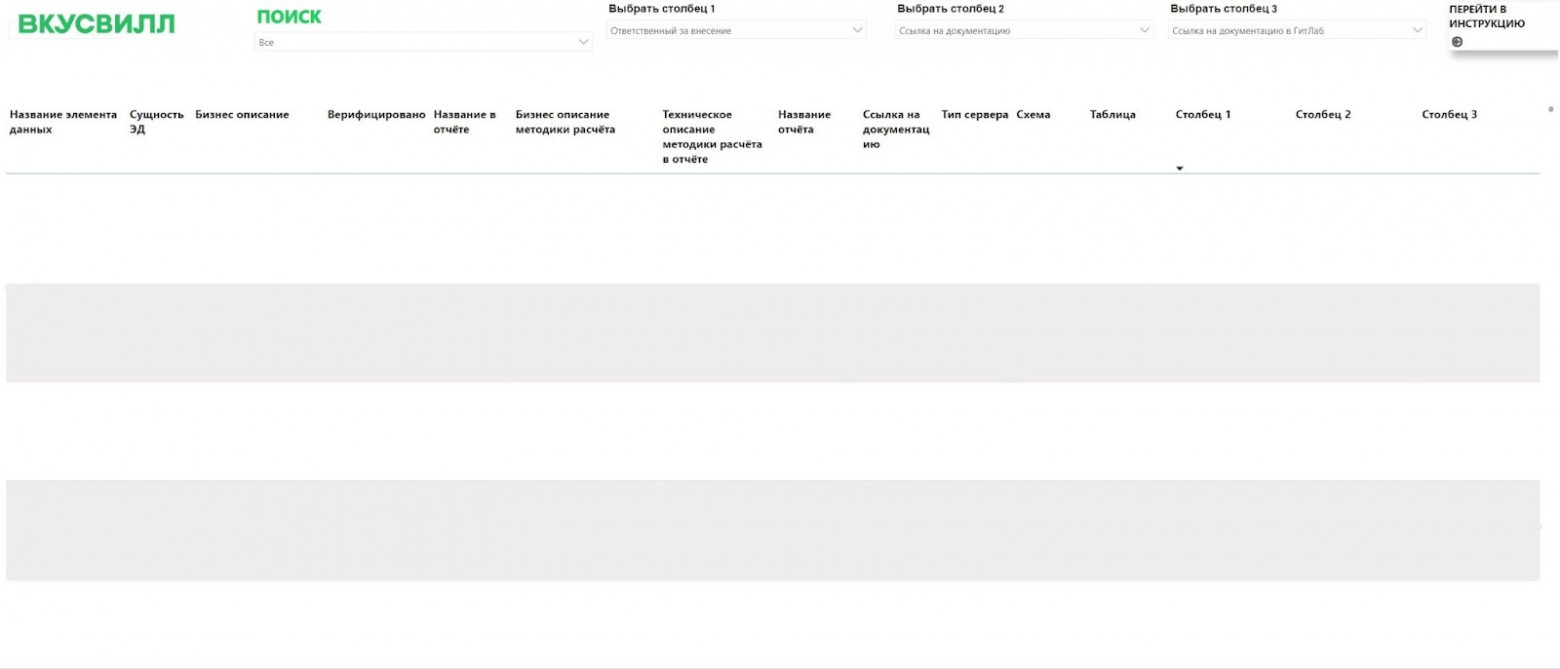
Контекст, мотивация и требования к каталогу: поиск источников и единый источник правды
Современная информационная экосистема предприятия характеризуется фрагментацией источников данных, дезориентацией пользователей и большим количеством повторяющихся или схожих отчетов. В такой среде задачи по поиску данных, их описанию и управлению ими становятся критическими для обеспечения скорости принятия решений и снижением рисков. В нашем контексте мотивация формировалась вокруг нескольких факторов:
- Распылённость источников информации: множество баз данных, таблиц и файловых хранилищ, плюс внешние источники (например, листы Google Sheets, на которых собирались данные для описаний). Это создаёт сложности для аналитиков при повторной работе, дублировании труда и расхождениях в трактовке показателей.
- Неполнота и непоследовательность описаний: в отчетах встречались неоднозначные названия полей, разные формулировки терминов и несогласованные определения показателей, что приводило к неправильной интерпретации бизнес‑метрик.
- Неопределённость статуса прав владения данными и ответственность за качество: без единого источника правды трудно определить, кто ответственен за актуальность и корректность описаний, lineage и т.д.
- Необходимость единой линии к действующим требованиям регуляторики и внутреннего контроля качества: бизнес‑терминология, согласование форматов и структур данных создают базу для аудита и сертификации данных.
Исходя из этих факторов, требования к каталогу были сформулированы как набор функциональных и нефункциональных аспектов:
- Поиск и навигация по источникам: единая индексация объектов данных с поддержкой глобального поиска по ключевым полям, схемам, таблицам, терминам и описаниям.
- Унификация терминов: формирование бизнес‑глоссария, связанный с технической метаданной информацией, включая родительско‑детерминированные связи между терминами и их вариативностью в отчетности.
- Линейность данных и их преобразований: возможность трассировки данных от источника до отчета, включая правила расчета и алгоритмы обработки.
- Качество заполнения и управление отклонениями: определения стандартов заполнения, валидации форм и система реджектов для некорректных или нерелевантных записей.
- Архитектура хранения и её эволюция: выбор подходящей модели хранения (изначально ориентированной на скорость внедрения и простоту, далее — на масштабируемость и поддерживаемость).
- Интеграция с инструментами анализа и управления данными: взаимодействие с существующими инструментами и план миграции к специализированной платформе управления метаданными, минимизируя риск и downtime.
- Пользовательский интерфейс и опыт: интуитивно понятный фронтенд, достаточный набор функций для аналитиков, минимальные барьеры входа и понятные процессы онбординга.
Унифицированный подход к требованиям предполагает сбор ожиданий и приоритетов через взаимодействие с основными пользователями каталога — Управлением Аналитики. В частности, ключевые критерии отбора для MVP включали важность и популярность отчетов: чем чаще они используются и чем шире их охват аудитории, тем выше приоритет их описания. В результате мы смогли зафиксировать потребности в описаниях, прежде всего, в отношении расположения таблиц и схем данных, а затем — в деталях полей, формул расчета и скриптов формирования отчетов. Этот процесс позволил перейти к архитектурной схеме хранения описаний и определить требования к источникам и методам загрузки.
Важно подчеркнуть, что мотивация заключалась не только в создании каталога как технологии, но и в организации процессов управления данными и их использования. Созданный каталог должен стать основой для стандартизации терминологии, повышения согласованности между аналитическими командами и руководством IT‑архитектуры, а также служить механизмом контроля качества и аудита данных.
Команда проекта: роли, MVP, онбординг аналитиков и этапы внедрения
Эффективное развитие каталога данных невозможно без хорошо структурированной команды и управляемого процесса внедрения. Изначальная команда проекта была компактной, но функциональной и сфокусированной на быстрой реализации MVP. В состав вошли:
- Системный аналитик: осуществлял проектирование архитектуры решения, методологию описания данных и регламенты взаимодействия между компонентами каталога.
- Инженер данных: формировал базу данных, разрабатывал загрузчики описаний и реализовал процессы контроля качества заполнения, а также механизм реджектов для некорректных данных.
- BI‑аналитик: отвечал за фронтенд‑часть проекта, дизайн пользовательского интерфейса и визуализацию результатов в рамках MVP; в частности, реализовал доминантный сценарий отображения описаний отчетов Power BI.
Ключевые принципы команды заключались в минимизации внешних ресурсов и работе «из коробки» с доступными инструментами. Такой подход позволял быстро получить работающий MVP и проверить основные гипотезы: достаточна ли текущая постановка задачи для описания отчетов Power BI и исправления основных проблем в процессе описания? По мере развития проекта состав команды расширялся за счет привлечения дополнительного системного аналитика, что позволило нарастить темпы и охватить больший объём объектов метаданных.
Этапы внедрения включали следующие шаги:
- Этап 1: сбор требований, определение целевых показателей и формирование MVP. В этот этап вошло оперативное описание Power BI‑отчетов, сбор информации об источниках и полях, а также инициирование процесса формирования облака синонимов для единообразия терминов.
- Этап 2: реализация архитектуры хранения данных и первичной загрузки описаний. Выбор схемы хранения (первично экспериментировавшая с Data Vault 2.0, затем переходящая к классической звезде) и построение загрузчиков из Google Sheets с внедрением базовых проверок качества.
- Этап 3: внедрение фронтенда, первоначальная визуализация и настройка глобального поиска. На стороне фронтенда применялся Power BI, что потребовало решения ряда ограничений и адаптаций под текстовую метаинформацию.
- Этап 4: оценка ограничения и поиск альтернатив. В процессе эксплуатации стало ясно, что Power BI может не наилучшим образом поддерживать сложный текстовый контент и долговременное развитие каталога. Был выбран путь миграции к OpenMetadata, после чего проект перешёл к более устойчивой и масштабируемой конфигурации.
- Этап 5: масштабирование, развитие глоссария и описания таблиц. За первые 9 месяцев каталог достиг значительных объёмов: сопоставимо 1300 бизнес‑терминов и более 200 таблиц хранилища данных. В рамках этого этапа усилия по онбордингу пользователей и сбору обратной связи превратились в систематическую работу, включая регулярные опросы и формирование бэклога.
Для успешной адаптации аудитории и снижения риска сопротивления изменениям крайне важно строить культуру итеративной разработки и вовлекать пользователей на ранних этапах. Рекомендовано проводить минимальные обучающие сессии, демонстрировать практические сценарии использования каталога, собирать обратную связь и оперативно вносить корректировки в правила заполнения и интерфейс.
Архитектура каталога данных: концептуальные принципы, слои и эволюция моделей
Архитектура каталога данных формируется вокруг нескольких ключевых концептуальных принципов, задач и слоёв, которые обеспечивают гибкость, масштабируемость и управляемость:
- Слоёвость архитектуры. Архитектура разделена на три базовых слоя: (1) слой источников и инжиниринга (описания таблиц, полей, скриптов формирования значений), (2) слой метаданных и бизнес‑терминологии (техническая метаинформация, словарь терминов и отношения между ними), (3) слой представления и поиска (UI/ UX, глобальный поиск, визуализация линейности и описаний).
- Концептуальные принципы хранения. Первоначальная реализация предполагала использование Data Vault 2.0 как модель хранения, что обеспечивает устойчивость к изменениям бизнес‑логики и хранение больших объёмов связей между объектами. Однако в процессе внедрения была замечена ограниченность масштабируемости и сложность при визуализации в BI‑инструментах. В итоге принято решение перейти к более традиционной «звезде» (Star Schema), где фактический центр — фактовая таблица и связанные с ней размерности, что ускоряет разработку и упрощает интеграцию с BI‑платформами.
- Эволюция моделей. Эволюционно мы перешли от гибридной модели к целевой архитектуре, ориентированной на оперативную реализацию и возможность последующей миграции на OpenMetadata. Такую эволюцию можно рассматривать как отражение практики: начать с быстрой реализации на корневых моделях, затем нарастить инфраструктуру управления данными, а в дальнейшем перенастроить модель под требования инструментов управления метаданными и Open Metadata, сохраняя возможность безболезненной миграции.
- Роль бизнес‑глоссария и родительско‑детерминированных связей. В рамках архитектуры ключевую роль играет бизнес‑глоссарий — набор терминов, их определений и формальная связь с техническими метаданными. Связь родительской сущности (корректного бизнес‑определения) и дочерних вариантов (вариантов употребления термина в отчетах и полях) позволяет единообразно согласовать трактовку показателей и обеспечивать устойчивую коннотацию между бизнесом и техникой.
- Линея к открытым стандартам. Выбор OpenMetadata на последующих этапах архитектуры предусматривает переход к открытым стандартам метаданных, что улучшают совместимость с внешними решениями, обеспечивают развитие экосистемы и позволяют проводить миграцию поэтапно и безопасно.
- Глобальный поиск и представление информации. Для поддержки пользователей реализуется единый механизм поиска по полям, таблицам, схемам и терминам, что является критическим элементом для повышения эффективности работы аналитиков и ускорения процессов онбординга.
Эта структура обеспечила основу для последовательности изменений. В начале проекта мы планировали быстрый прогон через схему Data Vault 2.0 и последующую модернизацию. Однако практические ограничения приводили к пересмотру архитектуры в пользу Star Schema, что на практике дало более быструю развёртку функционала и упрощённую интеграцию с инструментами анализа и визуализаций. Эволюция моделей является характерной чертой решения: она отражает баланс между скоростью внедрения и доведённостью архитектуры до степени, пригодной для долгосрочного сопровождения и миграций.
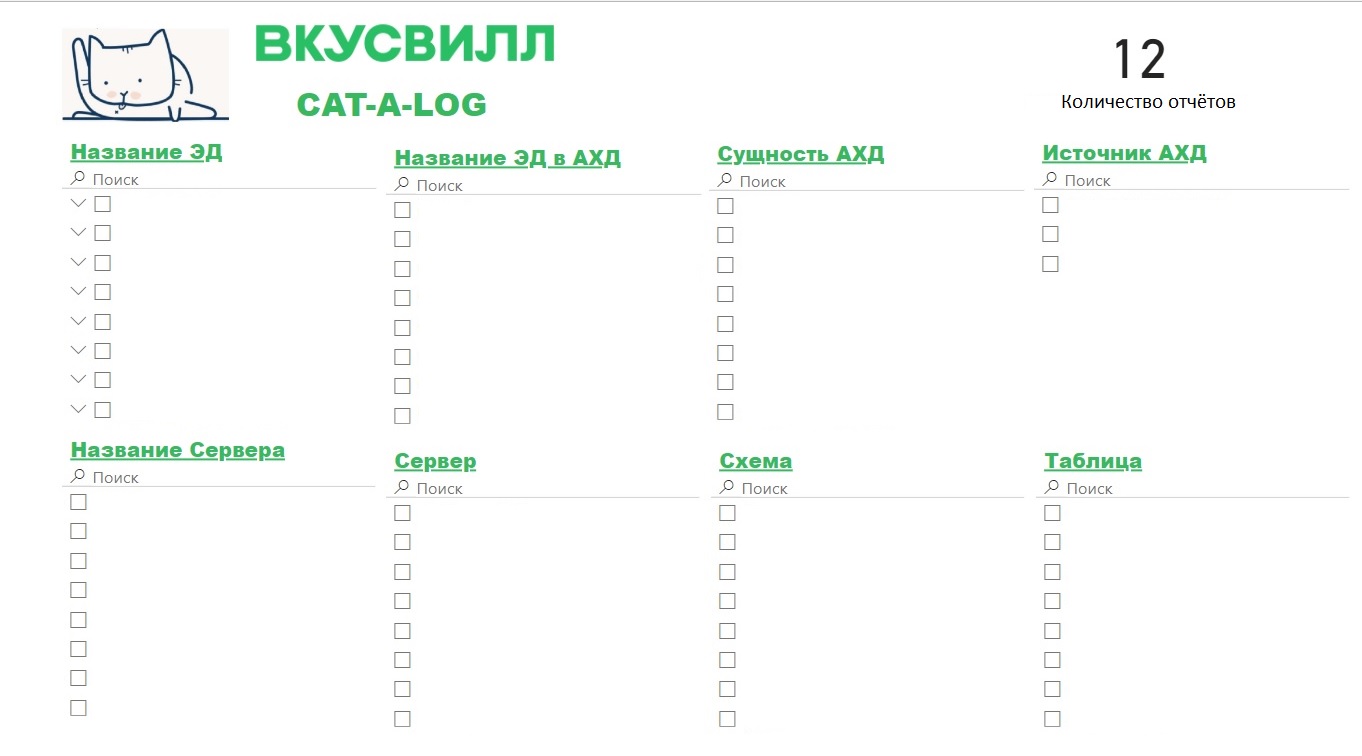
Декомпозиция технических компонентов и их взаимодействие
Декомпозиция технических компонентов каталога данных выражается в чёткой схеме взаимодействий между источниками, хранением, обработкой и представлением данных. Главные компоненты включают:
- Источники и инжиниринг данных. Включают формальные источники описаний (Google Sheets, формируемые в рамках внедрения), а также скрипты и конфигурации, формирующие правила расчётов и метаданные. Формы для заполнения, доступные аналитикам, должны позволять единообразно задавать параметры и описания.
- Интеграционный и загрузочный уровень. Этот уровень включает загрузчики, извлекающие данные из форм, осуществляющие валидацию корректности заполнения (на соответствие нормальным формам, уникальность имен и т. п.) и загружающие данные в хранилище каталога. Логика реджектов выделяет и отделяет некорректные или нерелевантные записи для последующей доработки.
- Хранилище данных каталога. В начальном варианте в качестве хранилища использовалась система, основанная на Greenplum — распределённой СУБД, которая обеспечивает хранение описаний, метаданных и глоссария с высоким уровнем параллелизма и скоростью записи/чтения. Архитектура Star Schema поддерживает быстрый доступ к отчётам и полям, обеспечивая необходимую эластичность для большого числа запросов.
- Мета‑слой и бизнес‑глоссарий. Этот компонент объединяет техническую метадану и бизнес‑термины, устанавливая терминологическую связность между ними и поддерживая родительско‑детерминированные структуры. С учётом объёмов в тысячах терминов и таблиц, эффективная индексация и кэширование становятся критическими для производительности.
- Фронтенд и аналитический интерфейс. Для отображения каталога использовался Power BI, который обеспечивает гибкость визуализации и возможности расширения за счёт нескольких страниц и элементов управления. В будущем планируется интеграция с OpenMetadata, которая предложит более естественную поддержку управляемой среды и совместную работу между инструментами.
- Поисковая и навигационная подсистема. Для обеспечения глобального поиска в рамках текстовой метаинформации реализованы дополнительные таблицы, аккумулирующие значения из полей БД каталога и их контекст (таблица, колонка, описание). Это обеспечивает поиск по сути как в Elastic, но в среде Power BI, приближая функциональность к инкрементному индексу.
- Линия данных и трансформации. Линия данных охватывает пути преобразований, которые проходят данные от источников до отчетов. В частности, они включают алгоритмы вычисления метрик в отчетах и описание методов, через которые данные превращаются в значения, используемые в аналитике.
Чтобы обеспечить надёжность взаимодействий между компонентами, была выстроена процедура документирования изменений, регламент версионирования и процедуры аудита. Важно отметить, что миграционный путь к OpenMetadata потребовал адаптации взаимодействий: OpenMetadata обеспечивает единый интерфейс для описаний и линейности, but в первоначальной реализации взаимодействие было больше ориентировано на загрузку через формы и локальные таблицы. В дальнейшей стадии миграции было принято решение о постепенной замене отдельных компонентов и сохранении совместимости с существующей логикой.
Хранилище данных и механизмы загрузки: Greenplum, загрузчики из Google Sheets, качества заполнения и реджекты
Хранилище каталога данных изначально опиралось на Greenplum как базу данных для хранения описаний и метаданных. Greenplum обеспечивает масштабируемость за счёт параллелизма и ориентированности на аналитические нагрузки, что соответствует требованиям большого объема описаний и сложной связности терминов. В рамках проекта хранилище служит не только как место сохранения регистров технической и бизнес‑метадной информации, но и как основа для быстрого доступа из BI‑инструментов к описаниям, полям и вычислениям.
Механизм загрузкиDescription-метаданных реализован через формовые источники, которые отправляют данные из Google Sheets в базу. Это позволяло быстро собрать данные от аналитиков, вначале — через локальные формы и таблицы. Однако данная архитектура имела существенные недостатки. В частности, взаимодействие было односторонним: загрузчик выгружал данные из Google Sheets в базу, но не возвращал обновления в форме обратно. Это означало ограничение цикла онбординга и внесения изменений пользователями, что снизило скорость обновления и удобство работы.
Качество заполнения и реджекты — важная часть контроля данных. В загрузчике были встроены механизмы проверки: одинаковые имена элементов данных, соблюдение нормальных форм (нормализация, непротиворечивость форматов) и другие базовые правила верификации. Реджектовная система обеспечивала устойчивый отбор описаний, не связанные с технической целью БД и отчетов, в отдельный файл с ошибками, что позволило сосредоточиться на технической заданной метаинформации и доработке тех элементов, которые действительно подлежали описанию в контексте базы. Такой подход позволял сохранять фокус на качестве описаний и постепенно исправлять несоответствия.
В процессе загрузки мы осуществляли сканирование технической метаинформации DWH, включая имена таблиц, списки полей, типы данных и т. п. Это дало возможность быстро оценивать покрытие и качество описания, а также понять, какие области требуют дополнительных усилий по заполнению и верификации. Основные требования к фронту каталога включали возможность описания полей в базах данных и отчётах, поддержку lineage и скриптов расчета показателей.
Первые усилия во фронтенде были сосредоточены на Power BI. Хотя Power BI хорошо подходит для визуализации числовых данных, работа с текстовым содержимым, характерным для метаданных и глоссариев, требовала дополнительных решений. В частности, для реализации глобального поиска была создана структура, которая обогащала поиск за счёт таблиц с информацией по всем полям, таблицам и их мещениям. Такой подход позволил приблизиться к функциональности Elastic Search непосредственно внутри среды Power BI, хотя это не было идеальным решением и требовало дополнительных усилий.
Ключевые выводы по загрузке и хранению: на старте целесообразно использовать гибкую схему хранения и одиннадцатистовую загрузку, на которую можно опирается все дальнейшее развитие, включая миграцию на OpenMetadata. В итоге, в контексте достижения целей управления данными, OpenMetadata стал логичным шагом вперёд — как средство унифицированного управления метаданными, которое обеспечивает более тесное взаимодействие между компонентами и позволяет проводить миграцию без потери функциональности.
Модели данных, метаданные и бизнес‑глоссарий: дата-мета, терминология и родительско‑детерминированные связи
Модель данных каталога отражает понимание того, как описания разделяются на технические и бизнес‑уровни. В рамках проекта выделены два основных слоя: дата‑мета (technical metadata) и бизнес‑глоссарий (business glossary). Эти слои взаимосвязаны и обеспечивают целостность объяснений и трактовок.
- Техническая мета, или дата‑мета, охватывает элементы, касающиеся структуры данных: схемы и базы данных, таблицы и их поля, типы данных, зависимости, правила загрузки и трансформаций. В начальной конфигурации мы ожидали ~1 млн строк технической метыинформации DWH, что требовало высокой производительности запросов и надёжной индексации.
- Бизнес‑глоссарий содержит термины и понятия, которые используются в аналитической среде. В процессе работы формировался массив приблизительно 10 тысяч строк глоссария, и к концу промежуточного этапа ожидания расширились до более объёмного набора терминов. Важной задачей стало объединение синонимов и формирование устойчивых связей между терминами. При обработке мы столкнулись с ситуациями, когда один и тот же показатель называли по-разному в различных отчетах (например, «маржа» и «рентабельность»). Для решения была реализована концепция облака синонимов, которые затем приводились к единообразному бизнес‑описанию через модель родительской и дочерней сущностей. Это позволило корректно интерпретировать значения и обеспечить согласованность в расчётах.
Связи между двумя слоями становятся критически важными для поддержки аналитического процесса. Родительская сущность в этом контексте несёт корректное и точное бизнес‑описание, а дочерние сущности иллюстрируют различные разновидности терминов, которых иногда существует несколько в отчетах. Такая структура позволяет адаптировать глоссарий под потребности бизнеса, не нарушая целостности сохранённых технических метаданных. В рамках дальнейшей эволюции каталога важно рассмотреть возможности интеграции с OpenMetadata, которая имеет развитые механизмы для управления терминами и связями, а также возможность учётаmulti‑lingual терминологии и версионирования.
Информация о lineage, включая алгоритмы преобразования, добавляет ещё одну важную грань: она позволяет понять, как именно формируются данные показатели и какие шаги преобразования выполняются на пути от источника к финальной метрике, используемой в отчетах. Логика lineage становится основой для аудита, объяснения бизнес‑пользователям и обеспечения прозрачности для регуляторных требований.
Описание отчетов Power BI: сбор требований, структура описания, поля и расчеты, согласование терминов
Power BI выступал в качестве MVP‑платформы для фронтэнд‑презентации каталога, так как он обеспечивает быструю визуализацию и гибкость в создании страниц. Однако этот выбор принёс и определённые вызовы. Важной частью проекта стало формирование описания отчетов, включая технические и бизнес‑аспекты, что потребовало последовательной обработки по нескольким направлениям:
- Сбор требований. Основной поток требований проходил через Управление Аналитики. В ходе этого этапа формировались ожидания относительно объема и состава метаданных, необходимых для описания и поддержки поиска. Пользователи запрашивали такие элементы, как расположение данных в БД/схемах/таблицах, возможность фильтрации по контексту (схемам, БД и т. п.), а также требования к отслеживанию lineage и формул расчета KPI.
- Структура описания. Для каждого отчета создавался набор базовых атрибутов: число пользователей, заказчик, основная цель и краткое резюме. Далее шёл детальный разбор полей, включающий их названия, типы данных, возможные значения и связь с бизнес‑терминами. В процессе работы возникали случаи несовпадения названий полей и их бизнес‑смыслов, что требовало проведения синхронизации терминологии и уточнений в глоссарии.
- Поля и расчеты. Рассмотрение скриптов формирования расчетов, которые применяются в отчетах, часто выявляло различия между названием показателя и его смыслом. Этот процесс требовал фиксации точной трактовки и гармонизации именования на уровне глоссария и дата‑меты для обеспечения согласованности в отчётности.
- Согласование терминов. В целях единообразия терминологии применялось ведение облака синонимов и привязка между терминами. Это делалось посредством родительской и дочерних сущностей, где родителем выступал корректный и передающий бизнес‑смысл термин.
- Визуализация и поиск. Реализация глобального поиска в Power BI потребовала разработки дополнительных таблиц, которые агрегировали значения из всех полей каталога и их контекст. В итоге получился аналог Elastic Search внутри Power BI, что позволило осуществлять поиск по текстовой информации, но потребовало дополнительных усилий по поддержке и интеграции с графовыми структурными данными (lineage).
Достоинства подхода к фронтенду на Power BI включают гибкость и возможность добавления новых страниц в существующий отчет, что позволяет оперативно расширять функционал. Однако ограничения, связанные с работой с большими объёмами текстовой информации и необходимостью объединения различных источников метаданных, требовали дополнительной архитектурной работы. В целом, этап описания отчетов стал основой для формализации требований, академического подхода к терминологии и начала формирования устойчивого процесса управления метаданными.
Data lineage и алгоритмы преобразования: трассировка данных, вычисления и сложности визуализации
Lineage представляет собой критически важный компонент каталога, обеспечивающий прослеживаемость происхождения данных и их преобразований на всех этапах жизненного цикла. Для нашей реализации lineage включал:
- Трассировку источников и преобразований. В рамках проекта lineage отражал последовательность шагов преобразования от исходных таблиц к итоговым значениям в отчетах. Это включает использование скриптов расчета и формул, применяемых в аналитическом процессе.
- Алгоритмы вычислений. Алгоритмы рассчитывали основные показатели и метрики, на которых базировались отчеты. В процессе анализа обнаруживались несоответствия между названием показателя в отчете и реальным смыслом, что требовало приведения к единому термину в глоссарии и корректной настройке lineage.
- Визуализация графовых структур. В связи с особенностями BI‑платформ, визуализация графов lineage требовала дополнительной настройки графических элементов (ребра, вершины, направления). В частности, некоторые средства для графов требовали адаптации для отображения на ребрах и узлах и одновременной совместимости с глобальным поиском.
Систематизация lineage в рамках каталога обеспечивает прозрачность для бизнес‑пользователей и упрощает аудит данных. В условиях миграции к OpenMetadata lineage дополняется механизмами, предоставляемыми данной платформой, что повышает устойчивость и совместимость с внешними инструментами. В реальных условиях это особенно важно при контроле версий, аудите и объяснении источников данных для регуляторной поддержки.
Фронтенд и пользовательский интерфейс: формы загрузки и отображение, глобальный поиск, ограничение экранной площади
Фронтенд каталога состоит из двух основных элементов: форм загрузки и отображения информации. В первоначальной реализации пользовательский интерфейс был построен на двух каналах:
- Формы загрузки и описания через Google Sheets. Этот канал стал узким местом в цепочке обеспечения, так как он позволял описывать данные, но не давал обратной связи или автоматического синхронного обновления информации в БД каталога. Это ограничивало онбординг и приводило к изоляции пользователей от централизованной базы знаний.
- Визуализация в Power BI. Фронтенд на Power BI предоставлял динамическую и гибкую модель отображения. Однако для текстового содержания каталога и операции по глобальному поиску потребовались доработки: был реализован «Elastic‑like» поиск посредством специализированных таблиц, которые агрегировали данные по всем полям и контексту, что позволило осуществлять поиск по терминам, схемам и таблицам.
Преимущества подхода на Power BI включают: возможность быстрой адаптации интерфейса, добавление новых страниц и визуализаций, создание интерактивных представлений. Сильные стороны включают в себя мощную аналитическую среду и широкий набор встроенных возможностей для моделирования расчетов и визуализации. Однако основные ограничения связаны с текстовой насыщенностью каталога, ограничениями по экрану и сложностью поддержания глобального поиска в рамках единого отчета.
Для решения этих ограничений был рекомендован переход к OpenMetadata в качестве основного инфраструктурного элемента управления метаданными и сценариями обработки. Это позволяет снять часть ограничений Power BI и перенести значительную часть функциональности в специализированную систему управления метаданными, сохранив при этом возможность отображения и использования данных через BI‑инструменты, которые остаются важной частью экосистемы.
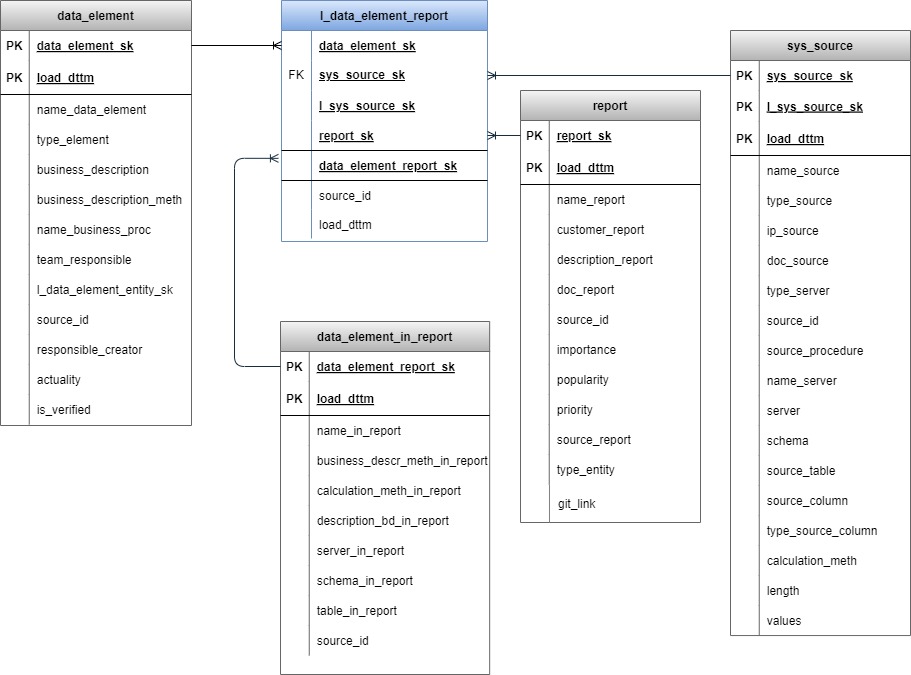
Интеграция технологических стеков и миграция к Open Metadata: выбор инструментов, путь перехода и синергия
Миграция к OpenMetadata выстраивалась поэтапно и с учётом требований к совместимости с существующими элементами архитектуры. Основные причины миграции:
- Необходимость перехода на открытые стандарты и управление метаданными в единой системе. OpenMetadata обеспечивает единый слой управления, включая technical metadata, business glossary, lineage и контроль версий, что упрощает масштабирование и интеграцию с другими инструментами.
- Улучшение совместной работы между командами. OpenMetadata способствует лучшей координации между аналитиками, инженерами данных и бизнес‑пользователями через общее хранилище терминов и связанных объектов.
- Поддержка миграций и расширяемости. Переход к OpenMetadata позволяет плавно расширять функционал и мигрировать существующие процессы с меньшими рисками.
Путь перехода включал следующие шаги:
- Сбор требований к OpenMetadata и сопоставление с текущими данными (data vault/star, глоссарий, lineage, загрузчики).
- Поэтапная миграция компонентов: сначала перенос описаний технической меты и базовых записей глоссария, затем расширение функциональности и выравнивание терминов в рамках OpenMetadata.
- Обеспечение совместимости с существующими инструментами анализа, включая Power BI, через интеграцию с OpenMetadata и, при необходимости, промежуточные адаптеры.
- Оценка и корректировка процессов миграции, включая регламент обновления и синергии в рамках новой платформы.
- Непрерывное обучение пользователей и администраторов по новым возможностям и процесcам.
С точки зрения дифференциации и конкурентного анализа, OpenMetadata предлагает крупный набор преимуществ: открытая архитектура, поддержка нескольких источников метаданных, расширяемый словарь терминов и возможность более тесной интеграции с стадиями жизненного цикла данных. В сочетании с DataHub и Amundsen, OpenMetadata представляет собой современную платформу управления метаданными, где важным аспектом является возможность консолидированной работы над линейной информацией и терминологией. В контексте стратегического внедрения каталога данных, миграция к OpenMetadata с сохранением совместимости с существующими данными обеспечивает устойчивость к изменениям и гибкость в развитии.
Этапы реализации и релизная стратегия: сроки MVP и полного релиза, развитие функционала
Этапы реализации и релизная стратегия формировались на основе достижений и уроков MVP, а также на планах масштабирования. Этапы включали:
- MVP‑уровень (первый месяц): запуск описания отчетов Power BI, формирование базовых метаданных и глоссария, сбор требований и возвратная связь от пользователей.
- Полноценный релиз через два месяца: формальные описания для ключевых наборов источников и прототипы линейности, расширение глоссария и добавление большей части описаний таблиц и полей.
- Этап наращивания объёмов (после 6 месяцев): расширение количества описаний и терминов, внедрение полифункционального поиска и улучшение визуализации, формирование стратегий массового заполнения и обновления.
- Миграция к OpenMetadata (после 9–12 месяцев): постепенная замена существующих загрузчиков, согласование структуры и позиций в OpenMetadata, упрощение управления изменениями и поддержка новых сфер применения.
Концепция релизной стратегии основывается на итерациях с целью своевременного предоставления ценности бизнес‑пользователям и минимизации рисков. Важной частью является сбор обратной связи через регулярные опросы и формирование бэклога, что позволяет определить приоритеты и направления дальнейшего развития каталога.
Метрики использования и восприятия: охват 80% аналитиков, опросы, формирование бэклога
Измерение эффективности каталога и его восприятия пользователями требует комплексного набора метрик, учитывающего как поведение пользователей, так и качество наполнения. В начале проекта не удалось полноценно измерить продуктовые метрики, такие как DAU/MAU или длительность сессий в Power BI из‑за ограничений платформы. Однако были проведены систематические опросы, которые позволили получить ценные идеи и на их основе сформировать бэклог. В ходе опросов выявлено, что:
- Охват каталога среди аналитиков достиг порядка 80%, что указывает на существенную вовлечённость и полезность продукта.
- Основной источник ценности — возможность быстрого описания и понимания источников для аналитических задач.
- Основной путь для роста вовлечённости — улучшение формы заполнения и автоматизация некоторых шагов заполнения, что потенциально позволит увеличить долю пользователей, занимающихся заполнением каталога.
Наряду с опросами, формировался бэклог на основе требований пользователей и анализа функционала. В связи с этим, ключевым направлением становится внедрение автоматизированных механизмов интеграции и улучшение пользовательской настраиваемой логики загрузки метаданных, чтобы снизить административную нагрузку на аналитиков и повысить темп заполнения каталога. В рамках миграции на OpenMetadata и интеграции с более расширенными механизмами управления метаданными возникает возможность получения новых метрик по использованию и восприятию каталога, в том числе через API и интеграционные слои.
Реальные сценарии применения и кейсы
Каталог данных применяется в реальных сценариях, где требуется систематизация и прозрачность описаний источников и метаданных для аналитической деятельности. Некоторые характерные сценарии включают:
- Быстрый доступ к информации о происхождении данных. Аналитик может найти, где и как конкретные поля формируются, каковы расчеты и какие источники данных приводят к конкретной метрике.
- Поддержка единого языка терминов между аналитиками и бизнес‑пользователями. Бизнес‑глоссарий позволяет согласовать терминологию, уменьшить двусмысленность и повысить доверие к показателям.
- Контроль качества и исправления. Реджекты указывают на записи, требующие доработки, что упрощает процесс исправления ошибок и повышения надёжности данных.
- Трассировка развёрток и линейности. Возможность отслеживать путь данных от источника к отчету обеспечивает аудит и регуляторную совместимость.
Эти кейсы демонстрируют ценность каталога как инструмента управления данными и как средство поддержки процессов governance в рамках корпоративной инфраструктуры. Реальный эффект выражается в сокращении времени на поиск данных, уменьшении ошибок трактовки метрик и повышении прозрачности для бизнеса и IT‑команды.
Возможности применения каталога в различных экономических секторах
Модель каталога данных и сопровождающих её процессов может быть применена в разных секторах экономики, включая розничную торговлю, производство, финансы, здравоохранение и муниципальные структуры. Применение зависит от специфики бизнес‑терминологии, регуляторных требований и структуры данных. Ниже приведены ориентиры для адаптации:
- Розничная торговля. В этом секторе каталожная структура особенно полезна для описания источников продаж, цепочки поставок, складских запасов и поведения потребителей. Бизнес‑глоссарий может включать термины по продажам, скидкам, акционным предложениям и KPI ритейла.
- Производство. Включает описание цепочек поставок, производственных процессов, качества продукции и регламентов контроля. В этом контексте линейность и доступность описаний критичны для аудита качества и регуляторного соответствия.
- Финансы. Включает требования к прозрачности расчета рисков, финансовой отчетности и соответствие стандартам учета. Каталог служит единым хранилищем терминологии и источников, помогая управлять консолидированной финансовой аналитикой.
- Здравоохранение. Здесь важна точная трактовка терминов, связанных с медицинскими данными, клиническими показателями и регуляторными требованиями. Каталог обеспечивает единообразное описание и соблюдение стандартов.
- Государственные и муниципальные структуры. Включает управление данными о населении, финансовых потоках и мероприятиях, где необходима прослеживаемость данных и соблюдение политик прозрачности.
Эти направления демонстрируют потенциал каталога как универсального инструмента управления данными, пригодного для интеграции в различные контексты, где требуется прозрачность, единая терминология и управляемый процесс обработки данных.
Анализ рисков, уязвимостей и ограничений с метриками эффективности
Любая система управления метаданными сталкивается с рядом рисков и ограничений. В нашем контексте можно выделить следующие:
- Риск несогласованности терминологии. В условиях роста глоссария возможно появления противоречивых определений. Решение: формализация дизайн‑правил, поддержка единой версии терминов, использование облака синонимов и строгие процедуры утверждения.
- Риск устаревания описаний. При отсутствии регулярного обновления данные могут устаревать и терять ценность. Решение: внедрение процессов обновления и уведомления об изменениях, интеграция с источниками обновления и регламентами по согласованию.
- Риск зависимости от выбранной платформы фронтенда. В случае сильной привязки к конкретной BI‑платформы, риск технологической «слепоты» может расти. Решение: переход к OpenMetadata в качестве центральной платформы управления метаданными и поддержка разных инструментов визуализации.
- Риск качества данных и реджектов. Неправильные данные в загрузчиках усложняют процесс. Решение: усиление проверок заполнения и стратегии по управлению реджектами, обеспечение всесторонней проверки перед загрузкой.
- Риск масштабирования и производительности. Объём описаний и линейности может расти, что требует архитектуры, ориентированной на масштабируемость. Решение: выбор технологий и моделей хранения, способных поддерживать рост в объёме и скорости доступа, включая OpenMetadata и соответствующие интеграционные слои.
Метрики эффективности для контроля рисков и качества включают:
- Доля заполненных элементов в глоссарии и метаданных (процент заполненности);
- Скорость закрытия бэклога (количество задач, закрытых в спринтах);
- Время отклика на запросы поиска и lineage;
- Уровень соответствия между техническими и бизнес‑терминами (уровень согласования);
- Частота обновления и полнота исторических изменений для аудита.
Эти показатели позволяют оценивать устойчивость каталога, управлять рисками и направлять дальнейшие инвестиции в развитие.
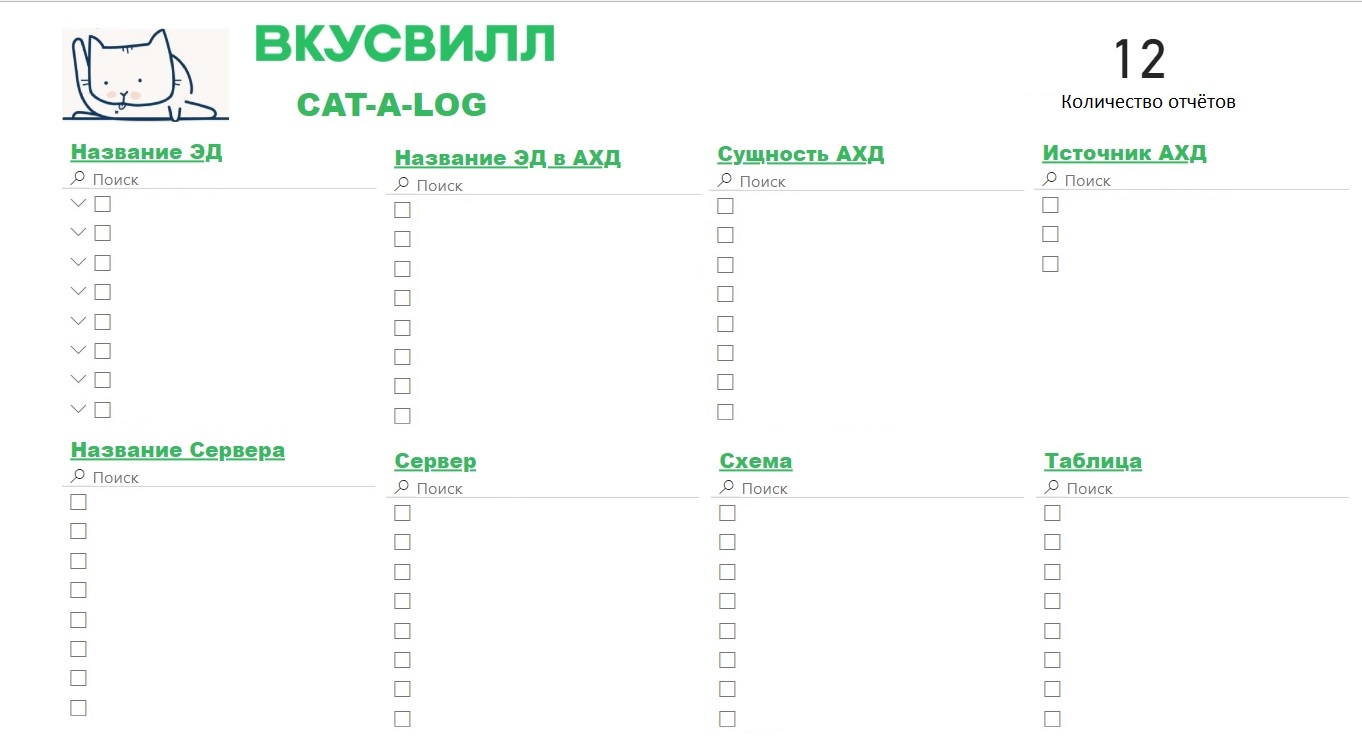
Конкурентный анализ и дифференциация: сравнение с DataHub, OpenMetadata и Amundsen
Сравнительный анализ современных решений в области каталогов данных и управления метаданными показывает, что каждый инструмент имеет свои преимущества и ограничения. Ниже представлены ключевые аспекты сравнения, которые помогают определить стратегическую позицию и дифференциацию:
- DataHub. DataHub — это платформа с открытым исходным кодом, ориентированная на централизованное хранение и управление метаданными, включая способность управления lineage, схемами и т.д. Преимущества: активное сообщество, гибкость интеграции и детальная поддержка lineage. Ограничения: иногда потребность в настройке и адаптации может оказаться нестандартной для конкретной организации, а также некоторый уровень сложности в освоении и развёртывании для непрофессиональных пользователей.
- OpenMetadata. OpenMetadata — платформа, ориентированная на открытые стандарты и совместную работу над метаданными. Преимущества: комплексная поддержка терминологии, связи между бизнес‑терминами и техническими метаданными, лёгкая интеграция с несколькими источниками метаданных, активная экосистема. Ограничения: переход к OpenMetadata требует изменения архитектурных подходов и процессов, а нередко требует вложений в миграцию и адаптацию процессов.
- Amundsen. Amundsen — фокусируется на каталогизации и поиске, с акцентом на простоту использования и впечатляющую навигацию. Преимущества: удобство поиска и доступности данных, хорошая интеграция с инструментами аналитики. Ограничения: может требоваться более глубокая настройка для аспектов управления терминологией и lineage в масштабах крупной организации, где важна формальная регламентация и управление изменениями.
На фоне данного анализа наш подход предлагает сочетание стратегий, ориентированных на практическое применение в рамках конкретной организации. Основными дифференциациями нашего решения являются:
- Комбинация гибридной архитектуры и эволюционного подхода к моделям хранения (Data Vault → Star Schema) с последующим переходом на OpenMetadata, что позволяет быстро начать работу и затем обеспечить устойчивость и масштабируемость.
- Внедрение бизнес‑глоссария и связанных терминов с использованием облака синонимов и связей родительской/детерминированной структуры, что упрощает унификацию трактовки показателей и обеспечивает консистентность на протяжении всего цикла жизни данных.
- Интеграция с OpenMetadata как единая платформа управления метаданными, позволяющая синергировать между источниками, терминологией и lineage и обеспечивать расширяемость в будущих проектах.
- Реализация «Elastic‑like» глобального поиска внутри BI‑инструмента в рамках текущего интерфейса, что обеспечивает оперативную доступность к информационной массе и позволяет плавно адаптироваться к переходу на OpenMetadata без резких изменений в пользовательском опыте.
Эти аспекты образуют уникальное предложение для корпоративного управления данными и дают возможность адаптировать стратегию каталога под конкретные требования бизнеса, а также обеспечить плавный переход к более совершенным инструментам на базе открытой платформы OpenMetadata и связанных инструментов.
В заключение к статье стоит подчеркнуть, что создание каталога данных — это не только техническая задача, но и организационная и стратегическая. Важно формировать команду и процессы так, чтобы каталог стал живым и полезным инструментом governance: он должен постоянно развиваться в соответствии с потребностями пользователей, внедряться в практику принятия решений и служить основой для регуляторной и бизнес‑аналитики. Наш путь демонстрирует, что найти баланс между скоростью реализации и долговременной устойчивостью возможно, если вы выстраиваете архитектуру вокруг открытых стандартов, прагматичной модели хранения и рационального управления терминами, а также позволяете бизнесу и ИТ работать в связке, используя современные инструменты для метаданных и анализа данных.
В конце статьи приведён блок вопросов и ответов, который подытоживает ключевые тезисы и позволяет быстро вспомнить важные аспекты статьи.
Вопрос-Ответ
1. Вопрос: Какова основная задача каталога данных в рамках корпоративной трансформации?
Ответ: Основная задача — создать единый источник правды и понятную структуру метаданных, чтобы обеспечить эффективный поиск, единообразие трактовки терминов, прозрачность lineage и управляемость качеством описаний.
2. Вопрос: Какова роль MVP и почему именно Power BI стал выбранным инструментом на этапе внедрения?
Ответ: MVP позволял быстро запустить процесс описания и получить раннюю обратную связь. Power BI был выбран как фронтенд за счёт гибкости визуализации и быстрого прототипирования, но затем выявил ограничения в текстовой работе и потребовал перехода к более гибкой платформе управления метаданными.
3. Вопрос: Почему переход к OpenMetadata рассматривается как целесообразная стратегия?
Ответ: OpenMetadata обеспечивает открытые стандарты, единый слой управления метаданными, поддержку lineage и бизнес‑терминов, и позволяет масштабировать каталог, а также облегчает миграцию и интеграцию с внешними инструментами.
4. Вопрос: Какова роль глоссария и как решалась проблема с синонимами?
Ответ: Глоссарий обеспечивает унификацию терминологии и устранение двусмысленностей. Проблема с синонимами решалась через облако синонимов и связь родительской/детерминированной сущностей, что приводило к единообразному описанию и совместимости в вычислениях.
5. Вопрос: Какие ключевые риски сопровождения каталога и как их mitigировать?
Ответ: Основные риски включают расхождения терминологии, устаревание описаний, зависимость от конкретной BI‑платформы и рост объёма метаданных. mitigations: регламенты обновления, миграция к OpenMetadata, комплексные процессы QA и интеграции, а также регулярный сбор обратной связи и формирование бэклога.
6. Вопрос: Какие шаги необходимы для применения каталога в других секторах?
Ответ: Необходимо адаптировать терминологию в глоссарии под специфическую отрасль, описать источники и правила расчётов в контексте регуляторных требований, обеспечить интеграцию с существующими системами и настроить соответствующие политики управления данными.
7. Вопрос: Каковы преимущества и недостатки архитектуры Star Schema в контексте каталога?
Ответ: Преимущества — быстрая реализация и простота взаимодействия с BI, хорошие скорости запросов. Недостатки — ограниченная масштабируемость и необходимость дальнейшей переработки при росте объёма и потребностей.
8. Вопрос: Какие показатели показывают успешность каталога на этапе внедрения?
Ответ: Охват пользователей (примерно 80%), наличие и полнота бизнес‑глоссария, описание отчетов и полей, наличие lineage и прозрачности источников, а также способность формировать бэклог по итогам опросов и требований пользователей.
Эта статья представляет собой структурированное исследование по созданию и развитию каталога данных в контексте сравнения и миграции к OpenMetadata. Она демонстрирует, как сочетание архитектурной эволюции, качественного наполнения метаданными и внимательного взаимодействия с пользователями может привести к устойчивой и полезной системе управления данными, способной служить основой для стратегий цифровой трансформации и регуляторной устойчивости бизнеса.


