

DataHub как комплексное решение по управлению данными: архитектура, внедрение, управление метаданными, безопасность и применение в бизнес-секторах
Введение: мотивация внедрения дата-каталога и баланс BI, DWH и ИБ
Современные корпорации сталкиваются с необходимостью синхронизировать три ключевых аспекта работы с данными: оперативную аналитику и бизнес-информацию (BI), полноту и управляемость хранилищ данных (Data Warehouse, DWH), а также требования информационной безопасности (ИБ) и соответствие регуляторным нормам. В условиях роста объема данных, числа источников и разнообразия потребителей становится очевидной необходимость единого слоя описания и управления данными — дата-каталога. Его роль состоит не только в ускорении поиска и повышения доступности описаний данных, но и в обеспечении видимости маршрутов данных (lineage), прозрачности правил обработки ПДН и поддержке целостности метаданных на протяжении всей цепочки преобразований.
История внедрения дата-каталога может служить наглядным примером. В рамках практики крупной розничной сети, обозначенной в примере как СберМаркет, был выбран путь создания единого, удобного каталога описаний данных, который заменил разрозненные локальные вики-страницы и разрозненные документы. Такой подход позволил не только ускорить поиск и заполнение описаний, но и развил data-driven культуру, расширил вовлеченность сотрудников из различных команд и стал стержнем для реализации целей информационной безопасности и соблюдения регламентов. В результате MAU (ежемесячно активных пользователей) превысил количество аналитиков в два раза, а круг пользователей расширился до дата-инженеров, менеджеров и специалистов ИБ. Этот кейс иллюстрирует, как дата-каталог может стать не просто инструментом, а платформой для устойчивой модернизации управления данными в организации.
Разворачивание DataHub в подобном контексте требует глубокого понимания баланса между удобством использования, полнотой описаний, возможностями интеграций и требованиями безопасности. Архитектура должна поддерживать как автоматическую загрузку метаданных из множества источников, так и совместное редактирование описаний, чтобы снизить риск устаревания документации и обеспечить согласованность. Важным становится создание сквозной линейки данных (lineage) — от источника до потребителя, включая промежуточные этапы обработки и транспортировки данных. Не менее значимым является обеспечение контроля доступа и фильтрации персональных данных, чтобы не допускать неконтролируемого распространения чувствительных сведений.
Данная статья рассматривает DataHub как комплексное решение, охватывающее не только техническую реализацию, но и стратегии внедрения, управления метаданными, безопасность и применение в реальном бизнесе. В ней описаны принципы архитектуры, этапы внедрения, методологии заполнения и мониторинга метаданных, а также примеры сценариев использования в различных экономических секторах. Целью является представить целостную картину: как сформировать устойчивый дата-каталог, который поддерживает требования бизнеса и регуляторов, интегрируется с существующим технологическим стеком и масштабируется по мере роста данных и пользователей.
Формулирование требований: бизнес- и инженерные требования к дата-каталогу
Эффективный дата-каталог начинается с четко сформулированных требований, которые согласованы между бизнес-подразделениями и командой инженерии данных. В кейсе СберМаркета была проведена детальная работа по сбору требований, результатом которой стали две группы критериев: бизнес-требования и инженерные требования.
Бизнес-требования охватывали:
- возможность быстрого поиска описаний данных и дашбордов, связанных с ними, через интуитивно понятный интерфейс;
- наличие полноты описаний для критически важных источников и витрин;
- возможность совместной редактуры описаний и ведения ответственности за их заполнение;
- прозрачность и управляемость линий данных (lineage) для целей аудита и регуляторного контроля;
- потребности подразделений в доступности документации для повышения скорости принятия решений и снижения операционных рисков.
Инженерные требования включали:
- возможность программного обновления и экспорта метаданных (bulk-export и bulk-import);
- поддержка интеграций на уровне минимального набора технологий: Kafka Connect, DBT, Airflow, Spark;
- наличие механизма тегирования на уровне таблиц и атрибутов;
- обеспечение сквозной линии данных между системами (например, от источника к BI-инструментам);
- поддержка безопасности и RBAC (роль-based access control) для раздельного доступа к данным и описаниям;
- возможность автоматического извлечения описаний изDDL и одновременного сохранения пользовательских правок.
В процессе формулирования требований стала очевидна необходимость компромисса между двумя лагерями: обеспечить богатый функционал и гибкость DataHub при сохранении реалистичных сроков внедрения и устойчивости к изменениям регуляторной среды. В итоге был сформирован документ-техническое задание, который стал основой для годовой дорожной карты внедрения.
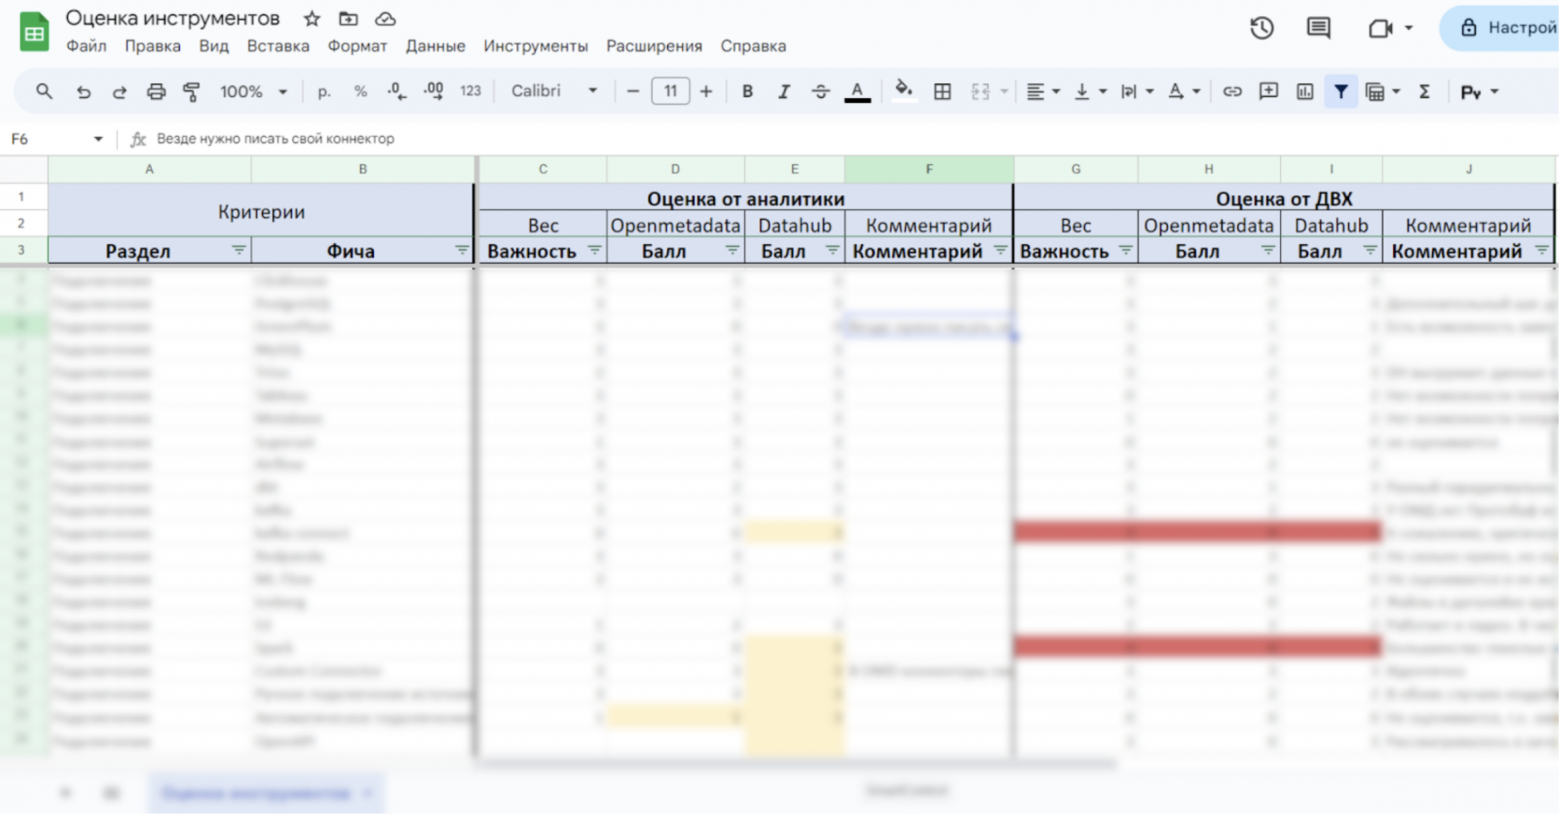
Важно отметить методологическую сторону: приоритеты распределялись через весовую систему, где каждому критерию присваивался вес, а затем разыгрывался раунд голосований между командами аналитиков и DWH-инженеров. Такой подход позволил учесть разные точки зрения и обеспечить обоснованное решение, минимизировав риск поздних изменений архитектуры в процессе реализации.
Ключевые принципы требований можно резюмировать так:
- единая точка описания данных и единство терминологии;
- поддержка полноты описаний (Description), возможностей редактирования и загрузки изDDL;
- наличие уровней важности (Tier) для классификации сущностей в зависимости от их бизнес-значимости;
- программируемость управления метаданными и поддержка обмена данными с внешними системами;
- возможность атрибутивного и табличного тегирования;
- интеграции и совместная работа в рамках одного технологического стека;
- контроль доступа и защита данных с учетом регуляторных требований.
Эти принципы явились опорой для выбора и внедрения DataHub как основной платформы для управления метаданными и(Lineage).
Анализ альтернатив и выбор решения: шорт-лист, критерии, метод оценки и итоговый выбор DataHub
Переход от идеи к конкретному инструменту требует сравнения альтернатив с учетом специфики инфраструктуры и бизнес-целей. В процессе анализа были рассмотрены два известных открытых решения: OpenMetadata и DataHub. Выбор был основан на функциональной полноте, способности масштабироваться под множество хранилищ данных и потребности в сквозной линейности, совместимости с существующим стеком и требованиям ИБ.
OpenMetadata.
- Преимущества: дружелюбный пользовательский интерфейс, богатый набор возможностей для работы с метаданными, удобство использования. Для команды аналитиков это выглядело особенно привлекательно, так как упрощал поиск и описание данных.
- Ограничения: функционал и интеграционные возможности для инженерной команды и ИБ не покрывали все потребности, особенно в части глубокой интеграции с несколькими источниками и технологическими стеками, а также в реализации полного lineage по всем конвейерам.
DataHub.
- Преимущества: широкий набор интеграций «из коробки», поддержка масштабирования и гибкая модель управления метаданными, богатый функционал для RBAC, тегирования и поддержка линейности через несколько систем (например, слоев каналов Kafka, Spark и др.). В условиях сложной экосистемы и регуляторной нагрузки DataHub выглядел как более пригодное решение для реализации сквозной lineage и комплексного управления персональными данными.
- Ограничения: требовал большего участия инженеров в настройке и доработке, особенно в части автоматизации заполнения метаданных и реализации управляемых процессов заполнения.
Для сравнения применялись стандартные методики оценки по критериям: подключения и интеграции, работа с метаданными, UX/UI, функционал, сущности, резервное копирование и автоматизация, аутентификация и безопасность, рольная модель и управление доступом. Каждому критерию присваивался вес, затем командам предлагались очки по шкале от 0 до 3. Итоговый вывод: DataHub удовлетворял критически важным требованиям обеих сторон и предлагал более богатый набор интеграций и готовых сценариев для сложной инфраструктуры. В то же время OpenMetadata остаётся ценным инструментом в контексте менее комплексных сред, где ограниченность интеграций и одной архитектурной схемы может быть приемлемой.
Стратегическим выводом стало решение выбрать DataHub в качестве основного решения для дата-каталога, с сохранением возможности адаптации и доработок под уникальные требования организации. Впрочем, принятое решение сопровождалось планом по настройке инфраструктуры безопасности и RBAC, чтобы обеспечить соответствие требованиям ИБ и регуляторным нормам.
После выбора начался этап развертывания. Важной особенностью стало то, что коробочные Helm-чарты DataHub позволяют достаточно быстро развернуть инфраструктуру на Kubernetes, что значительно снижает временные затраты и упрощает администрирование в плоско- и многоуровневых организациях. В рамках деплоя были согласованы роли и политики доступа и запущены пилотные подключения к основным источникам данных и BI-инструментам.
Ключевые выводы по анализу альтернатив:
- DataHub предлагает более широкие интеграционные возможности «из коробки», что критично в масштабных организациях с разнородной экосистемой источников и сервисов.
- OpenMetadata может оказаться предпочтительным в средах с сосредоточенной архитектурой и меньшими требованиями к автоматизации заполнения и линейности.
- В условиях необходимости сквозного lineage и усиленной поддержки ИБ DataHub предоставляет более сильную платформу, особенно при грамотной настройке RBAC и политики заполнения метаданных.
Архитектура решения: компоненты, источники данных, хранение метаданных, интеграции
Архитектура дата-каталога должна обеспечивать модульность, масштабируемость и устойчивость к изменяющимся бизнес-условиям. В контексте внедрения DataHub архитектура строилась по принципу «многоступенчатой интеграции» с акцентом на количественную полноту описаний и возможность синхронного обновления через импорты и интеграционные коннекторы.
Компоненты базовой архитектуры:
- центральный реестр метаданных DataHub, который выступает как единая точка истинности по описаниям таблиц, колонок, сервисов, схем и бизнес-объектов;
- источник данных — базы данных, витрины данных, файлы схем, конвейеры обработки и BI-инструменты, включая ClickHouse и Metabase;
- коннекторы для ingest (инпрут) и синхронизации метаданных, такие как Kafka Connect и соответствующие адаптеры к DBT, Airflow, Spark;
- интерфейс UI/административная панель для редактирования описаний и управления метаданными;
- механизмы безопасности и RBAC, обеспечивающие разделение доступа по ролям и уровням ответственности;
- биллинг и мониторинг, обеспечивающие видимость статусов загрузок метаданных, изменений и ошибок.
Источники данных и интеграционные узлы:
- базы данных и витрины данных (например, ClickHouse) как источник метаданных и конфигураций;
- конвейеры обработки данных (ETL/ELT) и оркестрационные системы (Airflow) для экспорта и обновления линейности;
- модели данных и преобразования в DBT, которые могут проставлять зависимости и описания на уровне таблиц и столбцов;
- BI-инструменты (Metabase) как источник описаний и как потребители контента, где линейность может формироваться через отчеты и дашборды.
Хранение метаданных:
- данные метаданных хранятся в DataHub как централизованный слой управления, обеспечивающий доступ к описаниям и связям между объектами данных;
- загрузка новых элементов в систему сопровождается обновлениями описаний и метаданных, которые сохраняются в согласованной модели.
Интеграции и взаимосвязи:
- интеграционные коннекторы обеспечивают автоматическую загрузку метаданных с минимальными задержками;
- формальные линейки (lineage) поддерживаются на уровне источников, конвейеров и потребителей, например, через цепочку: BI-инструменты → DBT (ClickHouse) → Spark → Kafka → Kafka Connect → Source Database;
- механизм тегирования, поддерживаемый на уровне таблиц и полей, позволяет задавать сценарии разделения внутри каталога и упрощает поиск и фильтрацию; теги распространяются на верхний уровень и поддерживают автоматическую идентификацию топ-таблиц и уровней Tier.
В рамках внедрения особое внимание уделялось синхронизации между бизнес-требованиями и инженерной реализацией. Был разработан план интеграции с существующим стеком и настройка постоянного обмена данными о новых сущностях, изменениях в схемах и обновлениях в источниках. Важной является часть, связанная с безопасностью и соответствием требованиям: RBAC и фильтрация ПДН должны быть встроены в архитектуру на ранних стадиях проекта, чтобы предотвратить утечки и обеспечить корректность использования каталога как в рамках бизнес-потребностей, так и в целях регулации и аудита.
Декомпозиция технических компонентов и их взаимодействие: модули DataHub, ingestion, UI, RBAC, теги, lineage, мониторинг
Переход к детальному описанию технической декомпозиции позволяет увидеть, как архитектура превращается в рабочую систему. Основу составляют модули DataHub и смежные компоненты, которые осуществляют ingestion, управление пользователями, визуализацию и мониторинг.
Модуль ingestion и интеграции:
- набор коннекторов для загрузки метаданных из источников: базы данных, DWH, витрины и инструменты обработки;
- поддержка автоматических обновлений на уровне схем и таблиц, чтобы актуализировать Description и атрибуты;
- возможность programmatic updates, включая bulk-import и bulk-export через внешние системы, например iHub.
UI-модуль и управление метаданными:
- доступный интерфейс редактирования Description, включая форматирование, структурированные поля и вложения;
- поддержка загрузки Description как изDDL, так и через пользовательское редактирование;
- возможности совместного редактирования и ведения истории изменений.
RBAC и безопасность:
- базовая модель ролей, соответствующая структуре организации;
- механизмы аутентификации и доменные политики для обеспечения согласованности с корпоративной инфраструктурой;
- фильтрация ПДН и персональных данных, включая правила маскирования и автоматическую фильтрацию на уровне потребителей.
Теги и уровни важности (Tier):
- поддержка тегирования на уровне таблиц и полей;
- определение уровней важности (Tier) для сущностей: 1 — критически важные, 2 — бизнес-важные, 3 — важные для департамента, 5 — личные или неиспользуемые;
- автоматическое тегирование новых объектов как топ-таблицы при их создании в продакшене, и удержание тегов при изменении.
Линейность (Lineage) и мониторинг:
- реализация сквозной линейности через компоненты конвейеров и внешние источники;
- мониторинг изменений в структуре таблиц и уведомления по событиям в рамках обеспечения безопасности;
- инструменты мониторинга для состояния загрузки метаданных, ценность которых определяется в рамках KPI проекта.
Мониторинг и управление изменениями:
- аудит изменений в метаданных и поддержка журналирования;
- уведомления о расхождениях между описанием и фактической структурой объектов;
- интеграция с системами DevOps и CI/CD для автоматизации повторяемых процессов.
Данная декомпозиция подчеркивает важность разделения обязанностей и упрощает адаптацию DataHub под конкретные требования отдельной организации. В реальной практике особенно значима роль сквозной автоматизации заполнения и синхронизации, а также обеспечение непрерывной видимости линейности данных на всех уровнях.
Интеграция технологических стеков и их синергия: Kafka Connect, DBT, Airflow, Spark, iHub, Metabase, ClickHouse
Эффективное применение DataHub во многом зависит от того, как он интегрируется с существующим технологическим стеком. В кейсе внедрения выделяются ключевые интеграционные точки и взаимные преимущества между компонентами.
Kafka Connect:
- обеспечивает связку между источниками данных и DataHub, позволяя транслировать метаданные и контекст изменений;
- поддерживает масштабируемость и устойчивость к сбоям за счет распределенной архитектуры.
DBT (Data Build Tool):
- служит источником правд для описаний и зависимостей в DataHub; описания и взаимосвязи между моделями можно экспонировать в каталоге;
- при интеграции DBT в DataHub улучшается видимость lineage и управление изменениями в моделях данных.
Airflow:
- оркестрационная система, обеспечивающая планирование и мониторинг конвейеров обработки;
- через коннекторы позволяет автоматически обновлять метаданные и связи на основе изменений в DAG-файлах и шагах конвейеров.
Spark:
- платформа обработки больших данных, которая может служить источником данных об обработке и трансформациях, информацию о которых можно загрузить в DataHub;
- поддерживает линейность на уровне этапов обработки.
iHub:
- централизованное место обмена данными, куда можно экспортировать и импортировать большие объемы метаданных;
- поддерживаетbulk-export и bulk-import операций, упрощая миграцию и миграцию между средами.
Metabase и ClickHouse:
- Metabase выступает как BI-инструмент и источник описаний в рамках каталога, а также как потребитель контента, позволяя видеть взаимосвязи между отчетами и исходными данными;
- ClickHouse как источник данных и витрина, с которой DataHub синхронизирует метаданные и обеспечивает lineage к дашбордам и моделям.
Синергия между этими элементами достигается через унифицированный подход к управлению метаданными: каждый коннектор и интеграция дополняет другой компонент, образуя единый поток информации, где данные и их описание проходят через конвейеры, а линейность и контекст сохраняются и доступны для пользователей. В результате достигается единая точка входа для поиска, анализа и аудита описаний данных и их использования в рамках бизнес-процессов.
Этап внедрения и управление изменениями: план, ответственности, DevOps, Helm, Kubernetes
Успешное внедрение дата-каталога требует системного подхода к управлению изменениями, распределению ответственности, а также согласованности процессов DevOps и инфраструктуры.
План внедрения:
- формирование дорожной карты на квартал и год, с четким распределением задач между аналитикой, DWH, ИБ и DevOps;
- поэтапное развертывание: сначала пилот, затем масштабирование на продакшн-окружение;
- внедрение поэтапной регуляции и контроля изменений в схеме и описаниях.
Ответственности и роли:
- выделение ответственных за заполнение описаний на уровне таблиц и атрибутов, а также за поддержку линейности и тегирования;
- определение ролей для администраторов, аналитиков и пользователей, которые будут работать с DataHub;
- создание процессов согласования и верификации изменений.
DevOps-подход и Helm/Kubernetes:
- использование Helm-чартов для управляемого развёртывания DataHub поверх Kubernetes;
- автоматизация деплоймента, отката и масштабирования через CI/CD;
- мониторинг производительности и ресурсов и адаптация под требования регулятора.
Управление изменениями:
- обеспечение прозрачности изменений через журналирование и аудит;
- строгий контроль версий метаданных и описаний;
- внедрение процессов обучения и подготовки пользователей, чтобы повысить вовлеченность и качество заполнения.
Этап внедрения в целом должен сочетать техническую часть с изменением организационных процессов. В кейсе СберМаркета упор делался на создание обучающих материалов, инструкций по заполнению и модульных подходов, позволяющих постепенно расширять охват и качество описаний. Важной частью стало вовлечение IB-специалистов и обеспечение того, чтобы линейность была не просто теоретической концепцией, а реальным инструментом аудита и контроля.
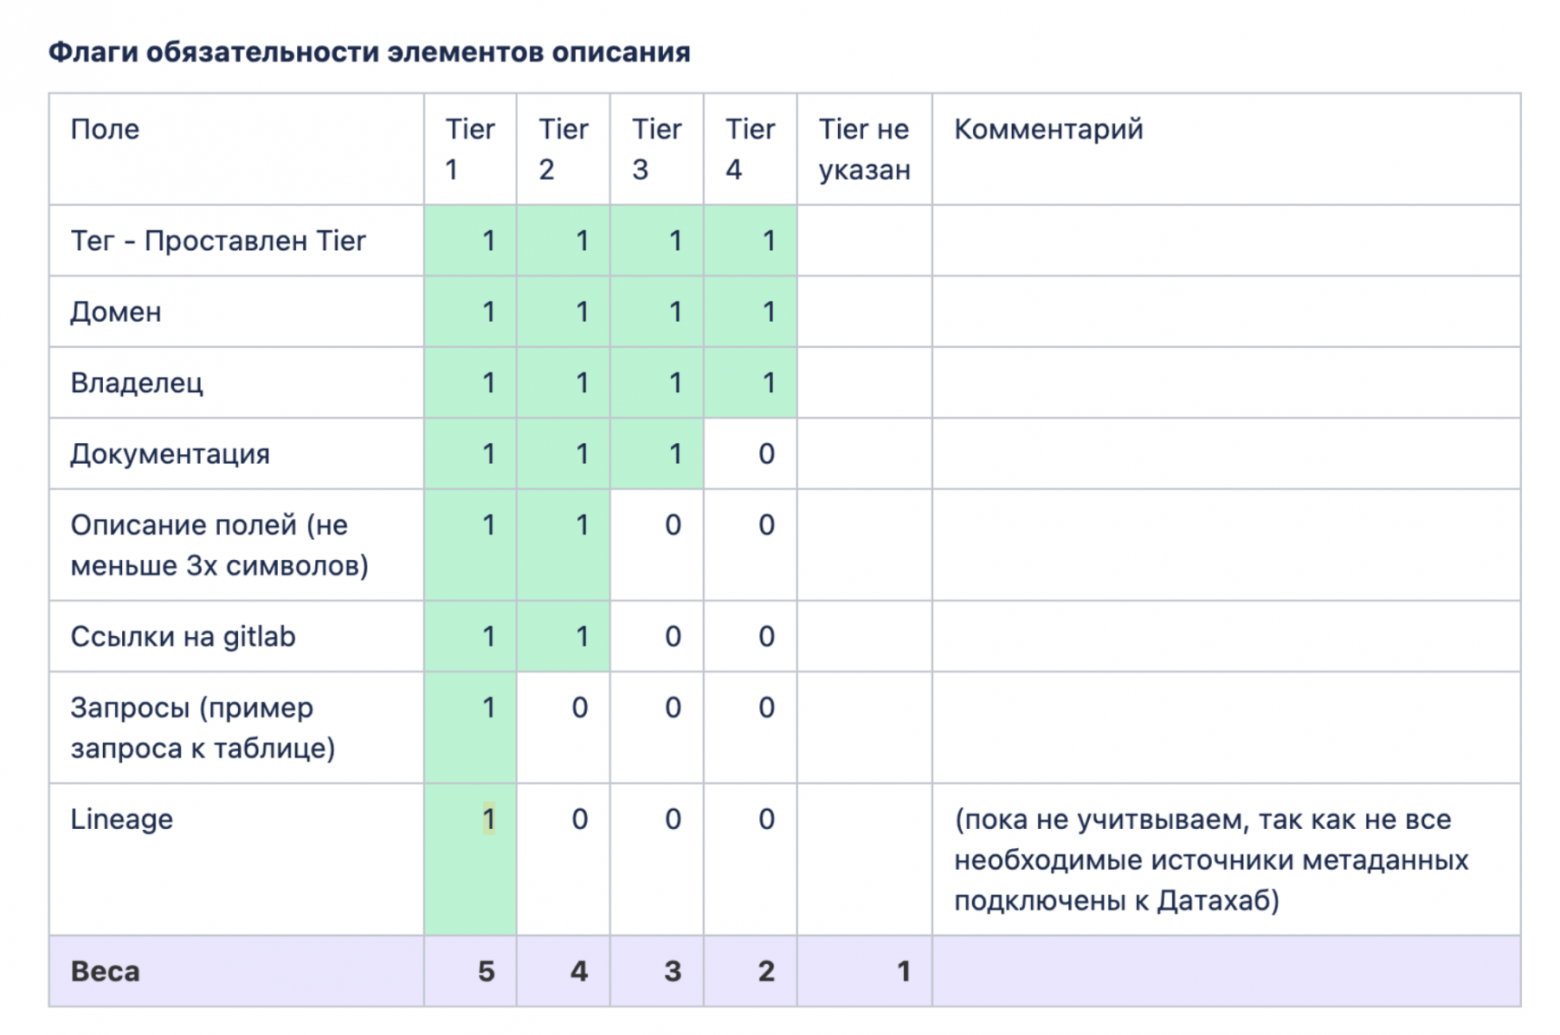
Управление метаданными: сущности, уровни важности (Tier), правила заполнения и совместное редактирование
Управление метаданными подразумевает не только хранение описаний, но и структурированное управление сущностями, их уровнем важности и правилами заполнения. В рамках архитектуры дата-каталога следует определить, как именно будут применяться правила и как будет осуществляться совместное редактирование.
Сущности и их уровни важности (Tier):
- Tier 1 — критически важные таблицы и источники правды; они являются основой бизнес-процессов и требуют безусловной полноты и актуальности описаний;
- Tier 2 — важные таблицы для бизнеса всей компании; требуют полного заполнения по основным атрибутам и поддержания линейности;
- Tier 3 — важные для конкретного департамента; описание может быть частично ориентировано на отраслевые потребности;
- Tier 4/5 — менее критичные или неиспользуемые таблицы; заполнение может быть облегченным и ограниченным.
Правила заполнения и совместное редактирование:
- введение флагов “обязательное заполнение” для полей, необходимых в рамках Tier;
- совместное редактирование с аудитом изменений и контролем версий;
- автоматическое обновление описаний из источников (DDL/DDL-генерация) с возможностью ручной коррекции;
- поддержка процесса рецензирования и утверждения изменений в описаниях.
Совместное редактирование и ответственное владение:
- закрепление ответственности за топ-таблицы и наиболее критические источники;
- создание инструкций и руководств по заполнению описаний для каждого домена;
- обеспечение постоянной коммуникации между аналитическим, DWH и ИБ подразделениями для поддержания консистентности.
Эта часть архитектуры служит основой для устойчивой политики управления данными, которая обеспечивает прозрачность, ответственность и согласованность в описании данных внутри организации.
Заполнение и автоматизация метаданных: методология заполнения, метрика заполненности, роли, политики
Заполнение метаданных — это ключевой процесс, который определяет качество и надёжность дата-каталога. Опыт внедрения DataHub на примере СберМаркет показал, что для достижения высокой заполняемости необходимы методология, инструменты автоматизации и управляемые процессы.
Методология заполнения:
- формирование списка топ-таблиц и витрин на основе частоты запросов и бизнес-значимости;
- оформление Description для таблиц и атрибутов через UI или автоматическую загрузку из DDL;
- заполнение полей с учетом Tier и требований к полноте;
- автоматическая выдача тегов и уровней важности в рамках продакшн-окружения.
Метрика заполненности:
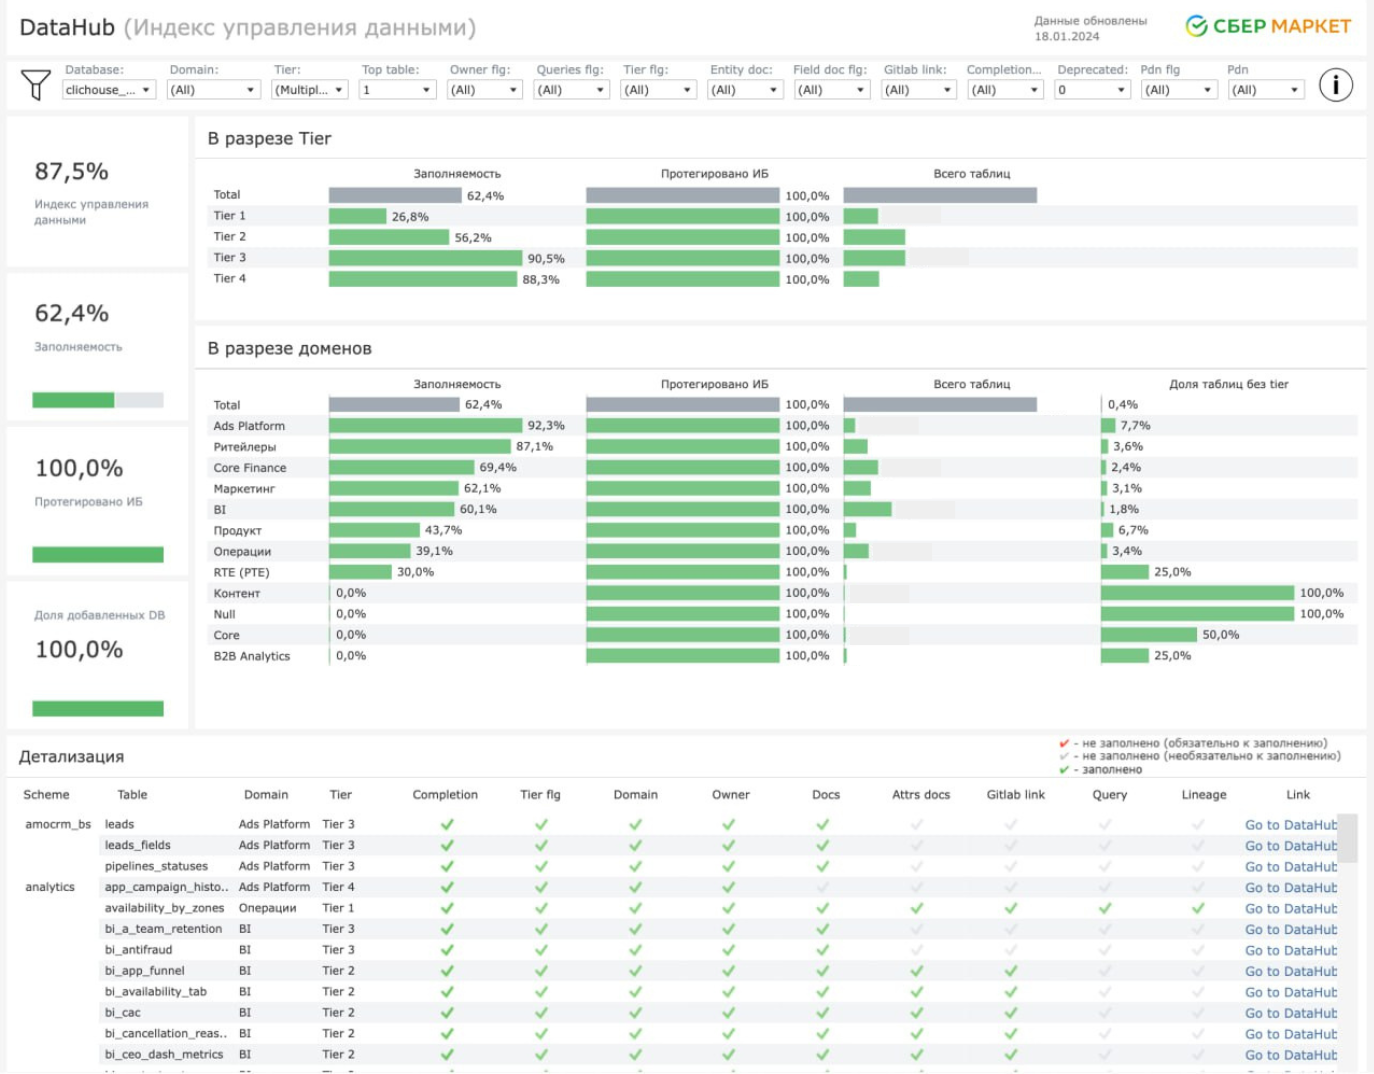
- разработана метрика «заполняемость» для оценки полноты описания на уровне сущности и уровня Tier;
- флаги «обязательного заполнения» позволяют определить, какие элементы должны быть заполнены для соответствия требованиям;
- мониторинг прогресса в выполнении целей по заполнению на уровне доменов: операции, продукт, BI, финансы, маркетинг.
Роли и политики:
- определение ролей, например аналитики, дата-инженеры, менеджеры и ИБ-специалисты, ответственные за заполнение и проверку;
- политики доступа к редактированию и просмотру метаданных в зависимости от роли;
- процедуры обеспечения консистентности и согласования изменений;
Автоматизация:
- создание ETL-процессов для получения данных о заполняемости и систематического обновления метрик;
- разработка скриптов, которые автоматически копируют описания таблиц из Sandbox в продовую среду;
- интеграция с GitLab и CI/CD для автоматического обновления линейности и метаданных по изменившимся конвейерам.
Внедрение подхода к заполнению и автоматизации позволило достигнуть значимого прогресса: за счет обучения и мотивации сотрудников, а также инициирования инициатив по расширению источников, была достигнута заметная динамика в заполнении топ-таблиц; прогресс и реальная ценность состояли в создании единообразного и управляемого процесса заполнения, который продолжает развиваться.
Линейность и система lineage: сквозной lineage и пути автоматизации
Линейность (lineage) — это одна из важнейших составных частей DataHub, которая обеспечивает видимость потоков данных от источников до потребителей и поведение трансформаций на каждом этапе. Сквозной lineage позволяет не только определить происхождение данных, но и сопоставлять его с бизнес-метриками и дашбордами, что критично для аудита и контроля.
Сквозной lineage:
- описывает связи между источниками и потребителями в рамках всей экосистемы: источники данных, ETL/ELT-процессы, конвейеры обработки и BI-слои;
- позволяет проследить, как данные преобразуются на каждом шаге и какие системы задействованы в преобразовании.
Пути автоматизации:
- интеграция с GitLab и скрипты, которые автоматически формируют lineage из изменений в коде конвейеров;
- автоматическое извлечение зависимостей из DBT-моделей и связей с источниками;
- поддержка динамического обновления lineage по мере изменения архитектуры данных.
Ограничения и вызовы:
- в рамках больших инфраструктур часто встречаются множество промежуточных узлов и транспортов, что затрудняет поддержание полной линейности;
- требуется активное участие команд ИБ и DWH для согласования изменений и верификации lineage на всех этапах.
Влияние на бизнес:
- наличие сквозного lineage повышает доверие к данным и упрощает аудит;
- позволяет понимать влияние изменений в конвейерах на отчеты и показатели, что важно в ситуациях регуляторного контроля.
Реализация сквозной линейности в кейсе СберМаркет была достигнута через частичную автоматизацию и интеграцию с текущими инструментами, но требует дальнейшего углубления и расширения покрытия, чтобы охватить весь спектр промежуточной обработки и трансформаций.
Безопасность и ответственность: фильтрация ПДН, управление персональными данными, соответствие требованиям
Безопасность и ответственность за обработку персональных данных (ПДН) являются неотъемлемой частью архитектуры дата-каталога в условиях регуляторной среды. В реальном внедрении необходимо не только хранить и описывать данные, но и защищать их от несанкционированного доступа и неконтролируемого распространения.
Фильтрация и маскирование ПДН:
- инструменты и методики, позволяющие автоматически фильтровать и маскировать ПДН при переходе между уровнями доступа и при экспорте описаний;
- автоматическое удаление или маскирование ПДН на уровне верхних слоев, когда данные в нижних слоях подвергаются автоматической фильтрации.
Управление персональными данными:
- классификация данных по чувствительности и применяемым политикам доступа;
- организация процессов сертификации доступа к данным с учетом ограничений и правил.
Соответствие требованиям:
- поддержка регуляторных норм, таких как требования к хранению, обработке и аудиту данных;
- ведение журналов доступа, изменений и использования метаданных для аудитов и проверок.
Масштабирование безопасности:
- планы масштабирования механизмов защиты и фильтрации при росте числа пользователей и источников;
- обеспечение совместимости с политиками безопасности и соответствием регуляторным требованиям.
В кейсе внедрения DataHub в СберМаркет безопасности уделялось особое внимание и было принято решение о включении в план автоматических инструментов для фильтрации ПДН, массовой маркировки и контроля доступа. В дальнейшем планируется усиливать автоматизацию, чтобы обеспечивать максимальное соответствие требованиям и минимальные риски при эксплуатации каталога.
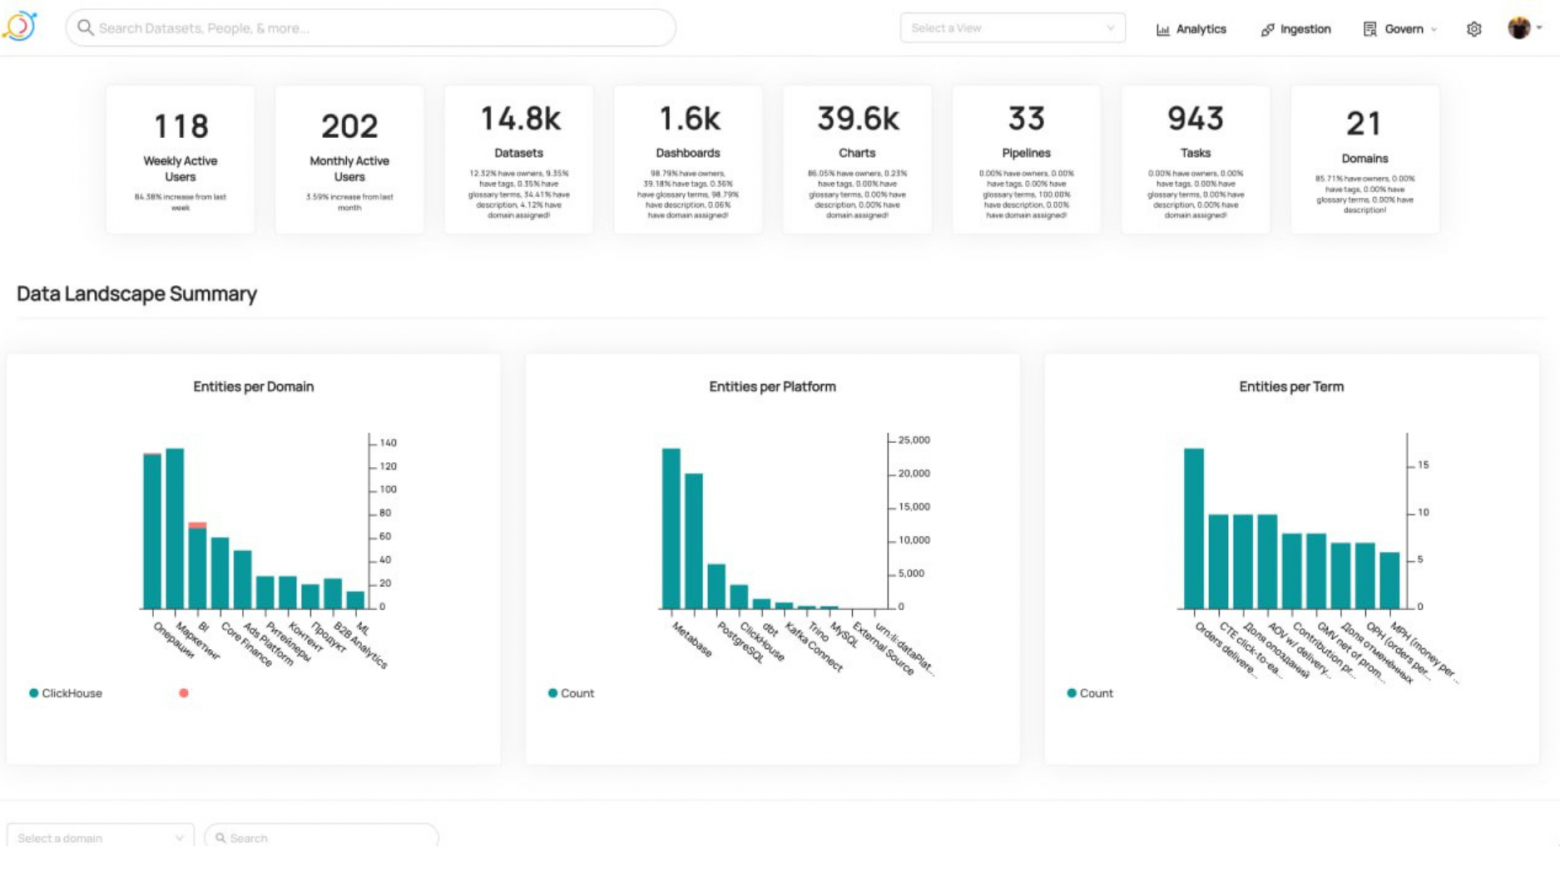
Внедрение и масштабы: загрузка метаданных из источников, 3500 таблиц, топ-500
Практика внедрения дата-каталога следовала этапам, ориентированным на достижение конкретных масштабов и насыщение каталога критически важными данными. В кейсе СберМаркет был реализован следующий набор действий и достигнуты следующие результаты.
Масштаб источников и загрузки:
- загрузка метаданных из нескольких источников: ClickHouse, Metabase и другие примеры источников данных;
- первая волна загрузки включала около 3500 таблиц из ClickHouse, что позволило дать старт процессам заполнения и анализа;
Этапы наполнения:
- формирование списка топ-500 таблиц на основе частоты запросов за последние три месяца;
- подготовка обучения и инструкции по заполнению и описанию, чтобы ускорить внедрение;
- создание и внедрение метрики заполняемости, с указанием минимальных уровней заполнения для Tier-представления.
Продуктивность и участие пользователей:
- текущие показатели WAU (weekly active users) и MAU (monthly active users) демонстрируют давление спроса на каталога и активное использование;
- рост числа пользователей до порядка 200 человек в течение первого этапа внедрения.
Внедренческие меры:
- настройка ETL-процессов для получения нужных данных и заполнения;
- автоматизация копирования описаний между средами, чтобы ускорить миграции и включение новых источников;
- анонс и внедрение мер по защите и филтрации ПДН в контексте DataHub.
В итоге DataHub стал единым входом для описаний и линейности, обеспечивая простоту поиска и доступность для широкого круга сотрудников, включая аналитиков, дата-инженеров, менеджеров и специалистов по ИБ. Важной частью было развитие культуры заполнения метаданных и создание механизмов поддержки и обучения пользователей.
Эффективность и использование: WAU/MAU, рост пользователей, примеры использования
Достижения по архитектуре и внедрению демонстрируют, как дата-каталог может стать платформой для повышения эффективности использования данных и расширения круга пользователей. В кейсе СберМаркет эффективность выражалась в нескольких аспектах.
Активность пользователей:
- WAU и MAU показывают устойчивый рост интереса к каталогу;
- число пользователей приблизилось к двумстам, включая аналитиков, дата-инженеров, менеджеров и специалистов по ИБ.
Применение:
- DataHub стал единым входом для поиска и описания данных, что снизило зависимость от отдельных экспертов и усталость от поиска по разрозненным источникам;
- линейность позволила видеть зависимости и влияния изменений в конвейерах на отчеты и бизнес-метрики;
- фильтрация ПДН и автоматизация маскирования повысили доверие и снижали риски.
Реализация и планы на будущее:
- продолжение наполнения описаний и расширение источников;
- автоматизация полного lineage и более широкое применение защитных механизмов;
- сертификация дашбордов второго уровня через раздел Глоссарий, чтобы закрепить фундаментальные метрики.
Эффективность, таким образом, не ограничивается количеством заполненных объектов, но также выражается в улучшении качества обслуживания потребителей данных и снижении операционных рисков за счет прозрачности и аудита. Это подтверждает ценность дата-каталога как части цифровой трансформации и обеспечения устойчивого роста бизнес-процессов.
Практические кейсы и сценарии применения: роли аналитиков, дата-инженеров, менеджеров, ИБ
Дата-каталог становится инструментом, который поддерживает разнообразные роли и сценарии использования. Рассмотрим несколько типичных кейсов:
Аналитики:
- быстрый доступ к описаниям данных и связанных источников;
- возможность видеть lineage и влияние изменений на метрики;
- использование топ-таблиц и витрин для оптимизации запросов и формулирования гипотез.
Дата-инженеры:
- автоматическое обновление описаний изDDL и поддержка совместной редактуры;
- мониторинг изменений структур и уведомления о добавлении новых столбцов или таблиц;
- обеспечение сквозной линейности и корректности связей между конвейерами и источниками.
Менеджеры:
- доступ к описаниям и метрикам, которые помогают оценивать риски и управлять данными на уровне бизнес-подразделения;
- использование описаний и метаданных для принятия решений о данных в рамках стратегий и регуляторных требований.
ИБ (информационная безопасность):
- фильтрация ПДН и автоматическое управление доступами;
- контроль соответствия требованиям и журналирование изменений;
- мониторинг использования и выявление рисков через линейность и описания.
Эти кейсы показывают, что DataHub может выступать как единая платформа для разных ролей, где каждый пользователь получает доступ к нужной информации и может сотрудничать с другими участниками процесса.
Ограничения, риски и метрики эффективности: риски внедрения, уязвимости, ограничения и метрики
Любой масштабный проект внедрения дата-каталога сопровождается ограничениями и рисками. В кейсе СберМаркет были выделены следующие ключевые моменты:
Риски внедрения:
- сложности в убеждении сотрудников заполнять описания и следовать принятым правилам;
- необходимость согласования и соблюдения регламентов внутри ИБ и других специализированных подразделений;
- вызовы в достижении полного lineage из-за большого количества промежуточных узлов и трансформаций.
Уязвимости и ограничения:
- ограниченная встроенная аналитика внутри DataHub — возможна потребность в сторонних аналитических инструментах;
- необходимость разработки локальных ETL-решений для достижения полной заполняемости и соответствия требованиям;
- потребность в усилении автоматизации и расширении coverage по всем источникам данных.
Метрики эффективности:
- заполняемость — доля сущностей с заполненными описаниями и атрибутами;
- охват линейности — доля объектов с зафиксированной линейностью;
- WAU/MAU — активность пользователей, приоритетные показатели успешности внедрения;
- рост вовлеченности и скорости заполнения для топ-таблиц.
Эти параметры позволяют оценивать прогресс и корректировать стратегию внедрения. В сочетании с инициативами по обучению и расширению источников, они помогают превратить дата-каталог из «приключения» в устойчивую платформу цифровой трансформации.
Конкурентный анализ решений: DataHub vs OpenMetadata, дифференциация и выбор подходящего решения
Рассматривая разные подходы к управлению метаданными, важно понять, как DataHub и OpenMetadata отличаются в контексте задач и инфраструктуры.
DataHub:
- обладает обширной интеграционной «пачкой» и поддержкой сквозной линейности;
- лучше подходит для крупных и сложных сред с несколькими источниками и конвейерами;
- обеспечивает более гибкую модель RBAC и расширенные возможности по тегированию и управлению Tier.
OpenMetadata:
- часто предлагает удобный UX и может быть более простым в рамках ограниченной инфраструктуры;
- в некоторых случаях лучше работает с ограниченными хранилищами и менее сложными сценариями.
Итоговый вывод, как и в кейсе внедрения, состоит в том, что выбор решения следует осуществлять на основании детального сопоставления требований и текущей инфраструктуры. Метод приоритизации с весами, который применялся в процессе оценки, помогает увидеть «слабые места» и определить решение, которое обеспечивает наилучшее соответствие критериям.
Применение в разных экономических секторах: финансовый сектор, розничная торговля, маркетинг и пр.
Архитектура и подход к управлению данными с DataHub применимы в широком диапазоне экономических сфер. Ниже приведены примеры областей применения:
Финансовый сектор:
- строгие требования к защите данных и прозрачности обработок;
- необходимость в сквозной линейности для аудитов и регуляторных проверок;
- актуализация метаданных в рамках изменения регуляторных норм и бизнес-процессов.
Розничная торговля:
- ускорение доступа к описаниям данных для маркетинга, продаж и операций;
- обеспечение единой классификации и описания витрин данных и источников;
- поддержка топ-таблиц и Tier-уровней для ключевых бизнес-подразделений.
Маркетинг и аналитика:
- возможность быстрого поиска и сопоставления метаданных с дашбордами и аналитикой;
- обеспечение согласованности между данными и показателями в рамках бизнес-целей;
- обмен данными между BI-инструментами и источниками через единый каталог.
Производство и отраслевые сервисы:
- поддержка совместной работы разных команд и создание управляемой экосистемы данных;
- контроль доступа и защита конфиденциальной информации.
Эти примеры демонстрируют гибкость и универсальность DataHub в контексте разных бизнес-моделей и отраслевых регуляций.
Дорожная карта и будущее развитие: планы по расширению источников, автоматизации, сертификации и масштабированию
Будущее развитие дата-каталога предполагает продолжение расширения источников, углубление автоматизации и усиление гарантий качества управления данными. В рамках дорожной карты можно выделить следующие направления:
Расширение источников:
- добавление новых баз данных, витрин и инструментов для загрузки метаданных на уровне enterprise;
- поддержка дополнительных форматов и стандартов описания данных.
Автоматизация и линейность:
- углубление автоматизации заполнения метаданных на основе изменений в конвейерах, DDL и скриптах;
- расширение автоматических моделей линейности на все важные узлы обработки и транспортировки данных;
- дальнейшая интеграция с системами мониторинга и оповещений.
Сертификация и управление качеством:
- внедрение сертификатов по описаниям и метаданным на уровне ключевых сервисов;
- формализация руководств и глоссариев, которые помогут сотрудникам быстро оценивать фундаментальные метрики и показатели.
Масштабирование:
- обеспечение масштабируемости архитектуры за счет совершенствования стратегий хранения и обновления метаданных;
- поддержка расширяемой RBAC и политики безопасности, адаптируемые под рост объемов данных и число пользователей.
Эти направления отражают стремление создать устойчивую и масштабируемую платформу для управления данными, которая может адаптироваться к меняющимся потребностям бизнеса и регуляторным требованиям, при этом сохраняя качество описаний, линейности и безопасности.
В завершение можно отметить, что DataHub стал не simply инструментом, а платформой, объединяющей данные и людей вокруг единого смыслового ядра: метаданных. Этот подход позволяет развивать data-driven культуру в организации, обеспечивая доступ к описаниям, прозрачность и безопасность на всех уровнях. Важно продолжать работу по обучению пользователей, расширению источников и автоматизации процессов, чтобы дата-каталог стал неотъемлемым элементом цифровой стратегии компании.
Вопрос-Ответ:
1. Вопрос: Что такое дата-каталог и зачем он нужен бизнесу?
Ответ: Дата-каталог — единая платформа описаний данных, которая повышает доступность, прозрачность и управляемость данных, обеспечивает линейность и безопасность, сокращает время на поиск информации и снижает операционные риски.
2. Вопрос: Какие ключевые требования важно учесть при внедрении дата-каталога?
Ответ: Важны бизнес-цели, полнота и актуальность описаний, поддержка совместного редактирования, возможность загрузки метаданных изDDL, RBAC, поддержка линейности и тегирования, а также интеграции с существующим стеком.
3. Вопрос: Почему выбран DataHub в кейсе внедрения?
Ответ: DataHub обеспечивает больше интеграций «из коробки», поддерживает сквозной lineage и предлагает устойчивую модель безопасности, что критично для крупных и многоуровневых инфраструктур.
4. Вопрос: Как достигается полнота заполнения метаданных?
Ответ: Через методологию заполнения, метрику заполняемости, роли ответственных и автоматизации загрузки, включая копирование описаний между средами и автоматическую обработку изменений.
5. Вопрос: Какие риски сопровождают внедрение и как их минимизировать?
Ответ: Риски включают сопротивление сотрудников заполнять описания, сложности с согласованием изменений и обеспечение линейности; минимизируют их через обучение, четкие процессы, RBAC, аудит и поэтапное внедрение.
6. Вопрос: Что значит сквозной lineage и зачем он нужен?
Ответ: Сквозной lineage — видимость путей данных от источников до потребителей через все этапы обработки; он необходим для аудита, регуляторного соответствия и понимания влияния изменений на бизнес-метрики.
7. Вопрос: Какие перспективы развития у дата-каталога?
Ответ: Расширение источников, углубление автоматизации заполнения и lineage, сертификация и масштабирование инфраструктуры, усиление защиты ПДН и расширение ролей управления доступом.
8. Вопрос: Как DataHub взаимодействует с DBT и Airflow?
Ответ: DBT используется как источник зависимостей и описаний моделей, а Airflow — как оркестратор конвейеров; интеграции позволяют обновлять метаданные и поддерживать линейность в рамках конвейеров.


