

Каталог данных как единый источник достоверности: архитектура, управление качеством и внедрение OpenMetadata в финансовом секторе
Современные финансовые организации работают с массивами данных, чьи источники, форматы и контексты распространены по множеству систем: реляционных БД, потоковых сервисов, BI-платформ и внешних дата-ринков. В таких условиях надежная карта данных, единый источник достоверности и прозрачная управляемость становятся не роскошью, а критической необходимостью. В условиях высокой стоимости ошибок в принятии решений, просроченных данных и нарушений регуляторных требований даже незначительная задержка в обнаружении источника проблемы оборачивается материальными рисками и репутационными издержками.
Переход к концепции каталога данных — это не просто добавление нового инструмента: это переход к управляемому окружению, где каждая единица информации имеет описание, владение, происхождение и версию. Подобный подход поддерживает три ключевых эффекта: 1) повышение доверия к данным за счет повышения прозрачности и контроля качества; 2) ускорение поиска и воспроизводимости расчетов за счет единого словаря и связей; 3) снижение операционных рисков через возможность оперативной идентификации источников нарушений целостности данных и оперативного отката к качественным состояниям.
Опыт функционирования каталогов в крупных финансовых организациях подтверждает тезис DAMA DMBOK: управление данными — это системная практика, охватывающая людей, процессы и технологии. Однако внедрение открытых решений как OpenMetadata требует внимательного подхода к архитектуре, конфигурации и эксплуатации. В условиях ограничений на внешние вендорские решения и повышенного спроса на безопасные и контролируемые среда, выборOpenMetadata как основы каталога данных на практике обретает конкурентные преимущества: открытость к интеграциям, гибкость в развертывании и возможность прозрачной миграции между версиями и окружениями.
В рамках этой статьи мы рассмотрим как архитектуру каталога, так и практические аспекты внедрения OpenMetadata в финансовом секторе на примере реального кейса Московского кредитного банка (МКБ). Мы обсудим теоретические основы, принципы качества данных, вопросы безопасности, конфигурацию и операционные режимы, пути интеграции источников данных и управление изменениями. В конце будут приведены практические рекомендации и дорожная карта внедрения, подкрепленные конкретными примерами и выводами по эффективности.
Теоретическая база управления данными: DAMA DMBOK и принципы каталогизации
Для обеспечения системного подхода к управлению данными применяются проверенные рамки и методологии. Одной из наиболее влиятельных является DAMA DMBOK — Data Management Body of Knowledge. Этот свод знаний, принятый сообществом DAMA International, систематизирует практики управления данными через последовательность взаимосвязанных областей: управление данными, качество данных, метаданные, архитектуру данных, безопасность данных, управление активами, риск и соответствие, а также организационные роли и процессы. В контексте каталога данных работа строится вокруг единого словаря метаданных, прозрачных владений и ответственных лиц, механизма контроля версий и регулятивной endured. Важно подчеркнуть, что DMBOK не предоставляет готового продукта, а задаёт стратегию и набор практик, которые адаптируются под конкретную организацию, отраслевые регуляторные требования и технологические ограничения.
Ключевые выводы из теоретического блока:
- Каталог данных — это часть спектра управления данными, ориентированная на сбор, хранение и распространение описательной информации о самих данных (метаданные), их источниках, контекстах использования и качестве.
- Успех достигается не только за счет технологий, но и за счет согласованных процессов, прав владения, прозрачности происхождения данных и устойчивой инфраструктуры аудита.
- В качестве базовой методологии целесообразно использовать принципы DAMA DMBOK для выработки единых стандартов описания активов, процессов их обновления и согласования владений.
При реализации каталога в финансовом секторе особое внимание уделяется требованиям регуляторов по прослеживаемости, аудиту и защите персональных данных. В рамках DMBOK формируются понятия данных как продукта, управления их качеством, а также роли данных в бизнес-процессе и риск-менеджменте. Эта база служит опорой для разработки архитектуры каталога, определения ключевых сущностей и взаимосвязей, а также для формирования методологий тестирования и верификации данных.
Каталог данных как единый источник достоверности: роль, цели и ожидания
Интеграционная роль каталога данных состоит в том, чтобы стать единой точкой доступа к описанию всех информационных активов и их характеристик, таким образом минимизируя дублирование и противоречия в описании данных. Основной смысл единичного источника достоверности выражается через несколько взаимосвязанных целей:
- Обеспечение прозрачности контекста: что это за данные, откуда они пришли, какие бизнес-правила применяются, какие версии существуют.
- Повышение воспроизводимости: наличие детальных описаний, происхождения и версии позволяет повторно определить расчеты и проверки без неопределённости.
- Улучшение доверия к данным: пользователи видят, кто владеет активами, какие политики качества применяются, какие ограничения доступа действуют.
- Поддержка соответствия и аудита: регуляторные требования требуют достоверной прослеживаемости и документирования изменений.
- Ускорение исследования и инноваций: новый сотрудник может за минимальное время найти нужные данные и понять их контекст.
Для достижения этих целей каталог должен обеспечивать структуру данных, которая поддерживает поиск, фильтрацию и связывание активов между собой. В практическом измерении это означает наличие унифицированного словаря и согласованных схем, а также механизмов автоматического считывания метаданных из источников данных, включая базы данных, потоковые системы, брокеры сообщений и BI-инструменты. В тоже время каталог не должен заменять существующие хранилища, он становится «мостом» и средством контроля качества и доступа к данным. В условиях финансового сектора особое значение приобретает управляемость и аудит, которые позволяют оперативно идентифицировать источник проблемы и восстановить корректное состояние бизнес-процессов.
Сами пользователи каталога — аналитики, архитекторы, руководители data-направлений и ИТ-директора — получают удобный инструмент для обнаружения активов и их контекста. Что особенно важно, каталог должен обеспечивать «пользовательский опыт» на уровне поиска и навигации, чтобы даже новые сотрудники могли в течение рабочего дня начать работать с каталогом и пользоваться его преимуществами. В этом контексте технические решения, такие как OpenMetadata, предоставляют необходимый набор функциональных модулей: API для работы с сущностями, веб-интерфейс для обнаружения активов, механизм интеграции метаданных через ingestion-потоки и мощную поисковую подсистему.
Наконец, роль каталога в процессе ответственности за данные (data ownership) является одним из ключевых бонусов. Наличие четко зафиксированных владельцев, ответственность которых за активы закреплена в политике и реестре, позволяет эффективнее управлять изменениями, разрешениями и аудиторскими мероприятиями. Это особенно критично в финансовом секторе, где нарушение регуляторных требований может повлечь значительные последствия.
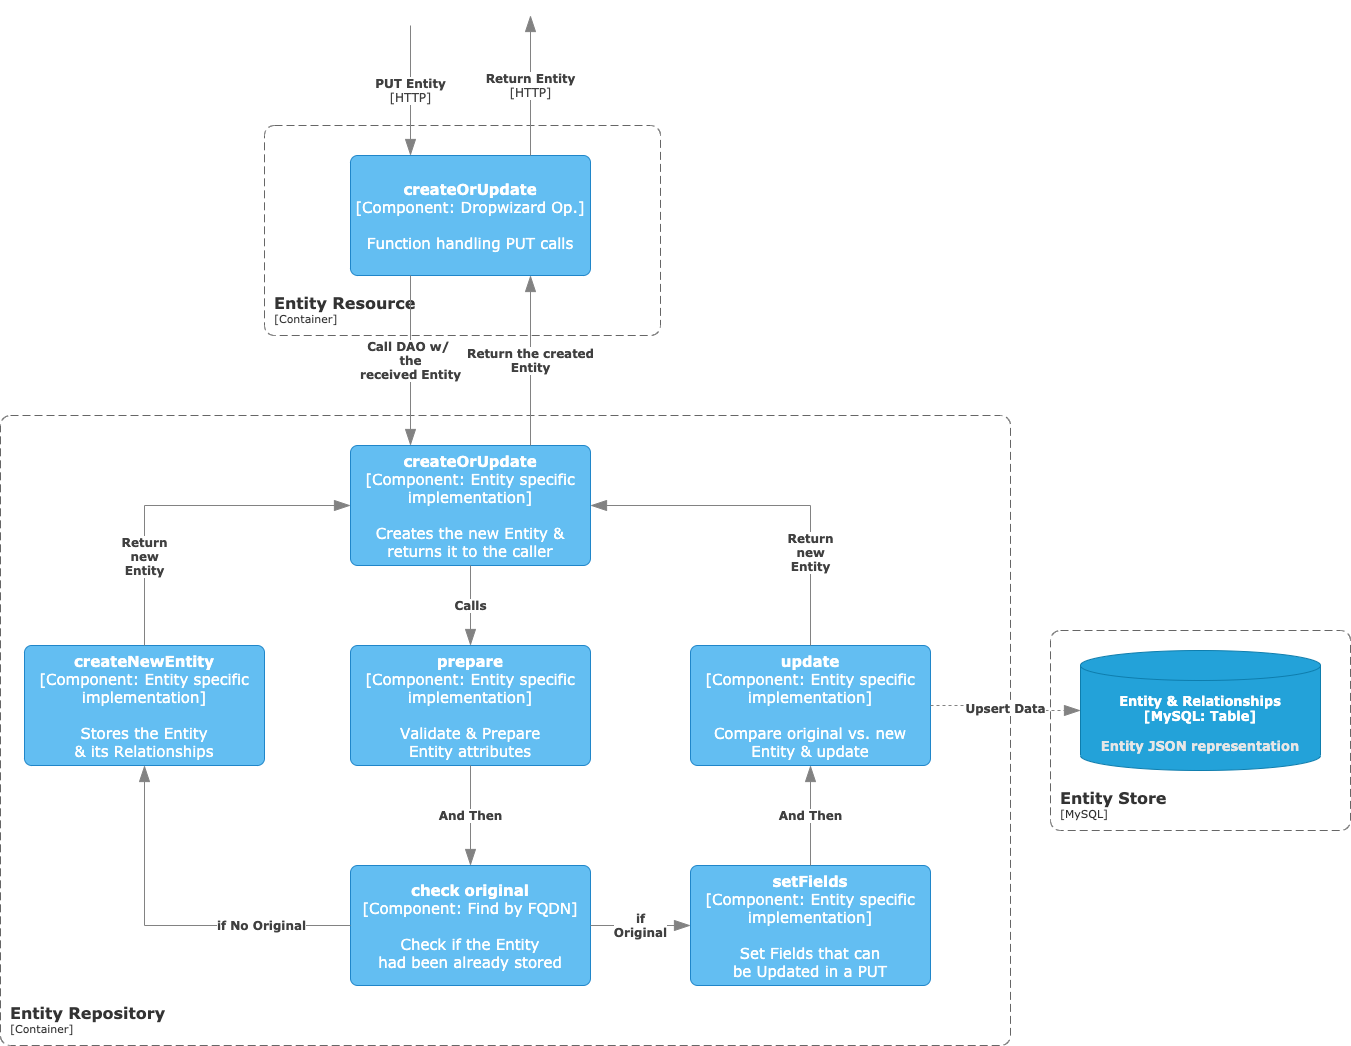
Архитектура каталога данных: сущности, словарь метаданных и взаимосвязи
Архитектура каталога данных строится вокруг нескольких уровней и взаимосвязанных сущностей, которые формируют единый словарь и единую модель. В базовом виде можно выделить следующие ключевые сущности и их взаимосвязи:
- Data Source (источник данных): абстракция источника данных, например база данных, поток Kafka, внешний репозиторий, BI-система. Источник определяет контекст, принадлежность и правила доступа.
- Data Asset (актив данных): конкретный набор данных, который может включать в себя одну таблицу, набор таблиц или логически связанный набор данных, который имеет бизнес-значение.
- Data Set / Table Column (набор данных / колонка): элементы структуры, которые содержат физическую реализацию и описание столбцов, их типов, ограничений и бизнес-контекста.
- Business Term / Glossary Term (бизнес-термин): лексикон организации, обеспечивающий единообразие терминологии и возможность сопоставления бизнес-значений к техническим сущностям.
- Lineage (происхождение/линию данных): связи, показывающие путь данных через системы и преобразования, что позволяет проследить цепочку влияния и анализировать воздействие изменений.
- Data Quality Rule (правило качества данных): набор проверок, метрик и пороговых значений, используемых для контроля корректности и полноты данных.
- Ownership / Steward (владельцы и ответственные): лица или команды, ответственные за конкретные активы, их актуализацию и соответствие требованиям.
- Provenance (происхождение и контекст): источники происхождения, даты извлечения, версии схемы и ретроспективы изменений.
- Version / Revision (версия): механизм отслеживания изменений в описаниях активов, схем и правил качества.
- Tag / Classification (метка): метаданные для быстрого категорирования активов по бизнес-контексту, регуляторным требованиям, чувствительности и т. п.
- Metadata Repository (хранилище метаданных): база, где хранится текущее состояние сущностей, их связи и актуальные версии.
Эти сущности формируют схему словаря, который является языком коммуникации между бизнесом и ИТ. С точки зрения реализации важно определить общий формат описания (например, JSON-схема) и обеспечить единообразие SDK-уровня для разных языков клиентских компонентов: Java-API для серверной части, Python-клиент для консьюмеров и JavaScript-модели для пользовательского интерфейса. Такой подход обеспечивает единый источник истины независимо от того, в какой момент системы разворачиваются и масштабируются.
Ключевые принципы проектирования словаря включают:
- Универсальность: словарь должен охватывать все основные активы и их контексты, с возможностью расширения под новые форматы.
- Однозначность: каждое понятие имеет четкое определение, а связи между сущностями — ясны и не противоречат друг другу.
- Версионирование: каждое изменение описания активов фиксируется и может быть восстанавлено.
- Прослеживаемость: поддержка lineage и provenance для аудита и регуляторного соответствия.
- Безопасность и доступ: владение и доступ к метаданным управляются отдельно от бизнес-данных.
Технические компоненты и их взаимодействие: OpenMetadata, Airflow, базы данных и поисковые системы
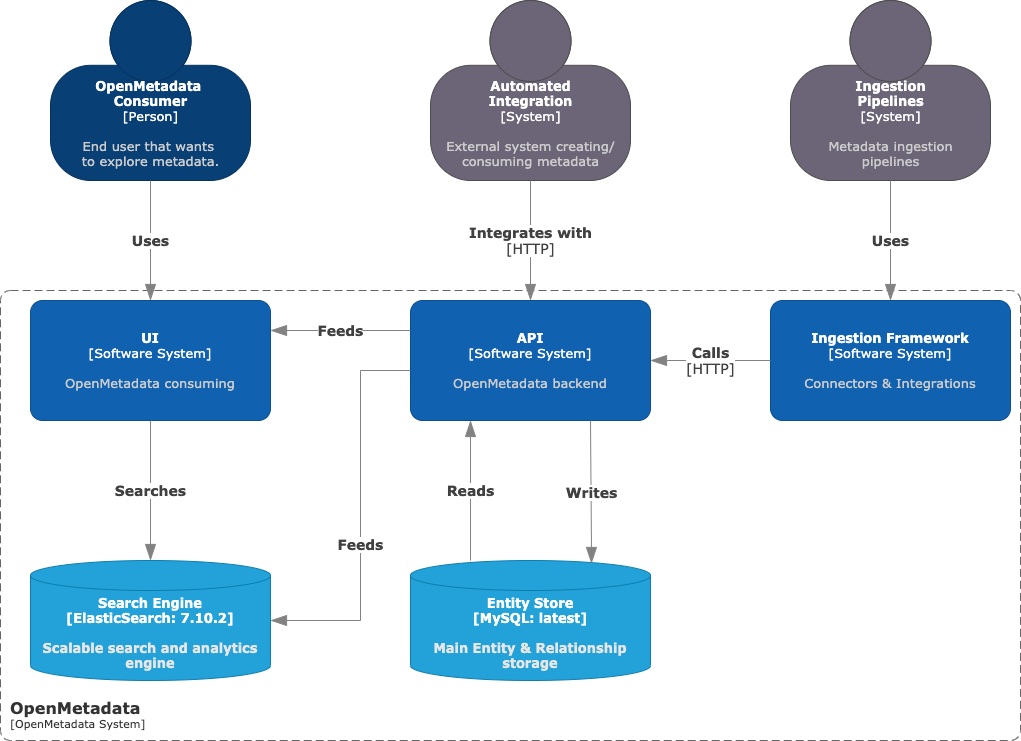
Архитектура каталога в рамках финансового сектора опирается на сочетание модульных компонентов, каждый из которых выполняет конкретную роль в потоке сбора, хранения, индексации и доступа к метаданным. Основные блоки включают:
- OpenMetadata server: центральная платформа, обеспечивающая REST/GraphQL API, управление сущностями метаданных и настройку политик доступа, а также веб-интерфейс для пользователей. Это ядро, которое синтезирует данные из разных источников и предоставляют унифицированный слой для потребителей.
- Ingestion framework (Airflow): механизм подключения к системам источников и считывания метаданных. Через конфигурацию ingestion создаются DAG-процессы, которые по расписанию извлекают структуры баз данных, схемы, комментарии, зависимости и т. п. Роль Airflow — обеспечить надёжность выполнения, мониторинг статусов и повторные запуски в случае ошибок.
- Search/storage: Elasticsearch (или OpenSearch) в качестве индексной подсистемы, а также традиционная база хранения сущностей (например, PostgreSQL) — для актуального состояния и истории изменений. Поисковая система обеспечивает быстрый и полнофункциональный поиск в словаре, фильтры по контексту, авто-дополнение и релевантность.
- Хранилище сущностей: база данных, которая хранит актуальное состояние всех сущностей, их взаимосвязи и текущие значения. Чтение и запись идёт через OpenMetadata API и ingestion-потоки.
- Поисковая система и интеграции: OpenMetadata может подключаться к источникам помимо баз данных — к Kafka, Airflow и BI-инструментам. Это обеспечивает полноту фигуры: не только структуры, но и текущие контексты использования и мониторинг.
- Аутентификация и авторизация: интеграция с управляющими системами безопасности. В рамках типичной архитектуры используется внешняя система аутентификации (например, Keycloak) для единой системы входа, роли и прав доступа.
- Обратная связь и управление качеством: функциональность Data Quality (DQ) внутри OpenMetadata, а иногда — внешние сервисы для расширенных проверок (например, проверка данных через внешние пайплайны или правила контроля на уровне БД).
Важно понимать, что архитектура OpenMetadata строится вокруг парадигмы «единого словаря» и «единого API». Это обеспечивает единое описание активов и единообразный доступ к ним независимо от того, откуда происхождение данных. Правильная настройка взаимодействий между этими компонентами позволяет обеспечить устойчивый цикл обновления метаданных и их своевременное использование в бизнес-аналитике и регуляторном учёте.
Интеграция технологических стеков и их синергия: сбор, хранение, индексация и доступ
Эффективная интеграция технологических стеков в каталоге требует целостного подхода к сбору, хранению, индексации и доступу к метаданным. Основные принципы синергии следующие:
- Сбор данных: это не только синхронная загрузка схем и структур, но и сбор контекстной информации — комментариев, бизнес-терминов, владения и политики. В идеале сбор должен работать в режиме near-real-time или по расписанию, чтобы отражать актуальные изменения и минимизировать задержки между изменением в источнике и обновлением в каталоге.
- Хранение: актуальное состояние метаданных хранится в централизованной базе данных, позволяющей с лёгкостью выполнять консистентные запросы и обеспечивать версионирование. Архитектура должна поддерживать параллельные обновления и управляемую конкуренцию доступов.
- Индексация: Elasticsearch/OpenSearch обеспечивают быстрый поиск по множеству параметров: имени активов, контексту источников, бизнес-терминам и признакам чувствительности. Важно продумать схему индексации и оптимизировать запросы для типичных рабочих сценариев — поиск по названию, по владельцу, по происхождению и по линии данных.
- Доступ: интерфейс пользователя через OpenMetadata UI, API для автоматизации и интеграций, а также роль-определённая авторизация. В рамках финансового сектора критически важны аудит и аудит безопасности: журналирование действий пользователей, история изменений и возможность отката к предшествующим версиям.
- Контекст и зависимость от бизнес-облаков: метаданные должны быть связаны с бизнес-контекстами, чтобы аналитики могли сопоставлять техническую структуру с бизнес-терминами и кейсами.
С точки зрения практики важна последовательная реализация слоёв: сбор метаданных во внешних системах, консолидация изменений через ingestion-процессы, сохранение в центральном репозитории, индексация в поиске и предоставление доступа через интерфейс и API. В условиях регуляторной среды особенно важны возможности аудита, отслеживания изменений, а также управление доступом на уровне объектов.
Инструменты развертывания: версии, требования к инфраструктуре, Kubernetes/Helm
Развертывание каталога данных в финансовом учреждении требует тщательного планирования инфраструктуры и последовательности действий. Рассматривая OpenMetadata как ядро каталога, необходимо учитывать несколько аспектов:
- Версии и совместимость: выбор стабильной версии OpenMetadata и совместимых зависимостей (Airflow, БД, поисковая система). Оптимальная практика — избегать обязательной установки последней версии на проде без тестирования; для MVP можно начать с "проверенных" релизов. Внимание к обратной совместимости и к миграциям схем обязательно.
- Инфраструктурная база: OpenMetadata требует продуманной инфраструктуры, включая выделенную БД (PostgreSQL/MySQL) для хранения сущностей, Elasticsearch/OpenSearch для индексации, а также окружение для ingestion-процессов. В случаях эксплуатации в кластере Kubernetes можно использовать Helm charts для управления компонентами и их версиями.
- Kubernetes/Helm: создание кластера Kubernetes и применение Helm Charts — один из наиболее распространённых подходов к развёртыванию. Использование Helm позволяет управлять зависимостями, параметрами конфигурации, обновлениями и откатами. Важной частью является создание и настройка секретов, ролей и сетевых политик.
- Архитектурные параметры: рекомендуется наличие Dev и Prod окружений с чётким процессом миграции и развёртывания. Нормативно-правовые требования в финсекторе диктуют необходимость ретельно объяснять процедуры резервного копирования и восстановления.
- Хранение образов и реестры: для контейнеров в продакшене стоит использовать защищённые реестры и политики доступа. В отдельных случаях образы для некоторых компонентов могут храниться вне кластера, и это требует дополнительных мер безопасности и согласования.
- Мониторинг и резервное копирование: обязательны мониторинг состояния сервисов, журналов, а также регулярные бэкапы базы данных и индексов Elasticsearch. В случае OpenMetadata критично вести процедуры отката и восстановления.
Практический совет: документируйте требования к инфраструктуре, версии окружений, порядок обновлений и инструкции по откатам. Такой подход повышает предсказуемость и снижает риск сбоев.
Развертывание OpenMetadata: архитектурные решения, создание окружений и миграции
Развертывание OpenMetadata требует последовательного и контролируемого процесса. Практический набор шагов включает:
- Определение архитектуры: выбор архитектуры «core OpenMetadata + ingestion + хранилище + поиск» и решение, какие внешние компоненты будут подключены (PostgreSQL или MySQL как источники данных, Elasticsearch как индексатор).
- Выбор версий: использовать стабильные релизы, например 0.13.3 в случае OpenMetadata как база, с учётом того, что новые версии могут включать важные изменения, но требуют тестирования и резервного копирования. Не рекомендуется разворачивать самую последнюю версию на проде без детального тестирования.
- Развертывание в Kubernetes: Helm Charts как основной инструмент. В процессе важны зависимости, создание «openmetadata-dependencies» и отдельных чартов для сервера OpenMetadata, ingestion и вспомогательных сервисов. В начале следует поднять тестовую/dev-окружение, затем провести аудит безопасности и миграции.
- Подключение внешних компонентов: настройка Postgres/MySQL и Elasticsearch, создание секретов для баз данных, учетных данных и ключей. В случае использования аутентификации через внешний IdP (например Keycloak) следует заранее подготовить клиентские конфигурации.
- Настройки аутентификации: в конфигурации openmetadata.yaml указать параметры аутентификации, включая provider, publicKeys, authority и т. д. В зависимости от требований можно начать с упрощённых сценариев и постепенно переходить к более сложной схеме.
- Миграции и реиндексация: после развёртывания или обновления слоя OpenMetadata выполняется реиндексация Elasticsearch. В зависимости от критичности обновления, может применяться пересоздание индексов (Re Create) и последующая реиндексация.
- Оповещения и оперативная поддержка: после развёртывания необходима налаженная система оповещений о сбоях процессов ingestion, ошибок доступа и изменений в конфигурации.
Личный опыт подсказывает: творчески подходить к миграциям и обновлениям, сохранять версии конфигураций и тестировать на dev-окружении перед выходом в prod. Такой подход снижает риск накопления технического долга и позволяет своевременно реагировать на изменения в требовании безопасности.
Интеграция источников данных: подключение к БД, Kafka, BI и другим системам
Интеграционные сценарии формирования каталога требуют поддержки разнообразных источников. При этом важно выстроить механизм, который обеспечивает корректное считывание метаданных, их сопоставление и обновление в словаре. Рассматриваемые источники включают:
- Базы данных (реляционные и нереляционные): подключение к PostgreSQL, MySQL или другим СУБД для автоматического считывания схем, комментариев и таблиц. Важен контроль прав чтения и соответствие политике безопасности, чтобы не нарушить принципы минимальных привилегий.
- Kafka и другие потоковые сервисы: чтение потоковой метадаты, инференс по топикам и потребителям, а также отслеживание изменений потоков и ключевых параметров данных.
- BI-системы: интеграция с BI-инструментами (например, Tableau, Power BI) через механизм считывания метаданных об источниках и зависимостях, чтобы обеспечить полную картины использования активов.
- Другие системы: в зависимости от инфраструктуры — файлохранилища, хранилища метаданных, ETL/ELT-платформы и т. п.
При внедрении следует:
- Определить набор критичных источников и разработать план по их подключению с учётом периодов обновлений и прав доступа.
- Рассчитать требования к пропускной способности ingestion и объёму памяти для кэширования и индексации.
- Протестировать все коннекторы на dev-окружении с использованием тестовых данных, чтобы минимизировать риски на проде.
- Обеспечить контроль версий и документирование изменений в конфигурациях интеграции.
- Настроить политики аудита и мониторинга для каждого источника, особенно для источников с чувствительными данными.
Эти принципы позволяют формировать целостную и точную картину данных, доступную для бизнес-пользователей и аналитиков, а также обеспечивают прозрачность источников и динамику изменений.
Управление качеством данных: Data Quality внутри и вокруг OpenMetadata
Ключевая задача каталога — не просто описывать данные, но и поддерживать их качество. В OpenMetadata заложена базовая функциональность Data Quality (DQ), однако опыт практической эксплуатации показывает, что для финансового сектора требуется двойной подход: встроенная DQ в каталоге и внешние, независимые проверки качества.
- Встроенная DQ в OpenMetadata: позволяет определить базовые правила и проверки на уровне метаданных (например, соответствие типов данных, полнота, уникальность). Но в некоторых случаях этот функционал оказывается менее гибким или требует высоких привилегий доступа к источникам для выполнения проверок напрямую в БД.
- Внешние подходы к DQ: целесообразно использовать внешние инструменты для лётной сквозной проверки качества данных (например, запросы в БД, ETL/ELT-процессы, фреймворки контроля качества). Эти проверки можно запускать и на стадии ingestion, и как отдельные задачи в конвейерах данных.
- Управление порогами и дефектами: в рамках политики качества данных следует определить пороги отклонений и процессы эскалаций на бизнес-уровнях. В случае обнаружения аномалий важно иметь автоматизированные уведомления и план действий.
- Взаимосвязь с каталогом: DQ-результаты и правила могут быть привязаны к конкретным активам и отображаться в карточках активов, а также использоваться в качестве факторов для фильтрации и сегментации.
Практическое руководство по DQ в рамках каталога:
- Определение ключевых Q-показателей для бизнес-кольз: полнота заполнения, корректность бизнес-атрибутов, согласованность между источниками.
- Разработка пороговых правил и ошибок, с которыми сталкиваются потребители данных, и определение процедур исправления.
- Интеграция с процессами мониторинга и аудита, чтобы обеспечить прослеживаемость действий по качеству данных.
- Регулярная аттестация и обновление политик качества в связи с изменениями регуляторных требований.
В итоге, сочетание встроенной DQ и внешних проверок обеспечивает устойчивый контроль над качеством данных в рамках каталога и поддерживает доверие бизнес-пользователей к данным.
Безопасность, доступ и соответствие: аутентификация, авторизация, аудит, SLA
Безопасность и соответствие требованиям регуляторов — центральные требования к любому решению в финансовой среде. Каталог данных должен поддерживать:
- Аутентификацию и авторизацию: интеграция с IdP (Identity Provider), например Keycloak, для единого входа, управления ролями и доступами на уровне активов и метаданных. Важно обеспечить принцип минимальных привилегий и сегрегацию доступа к различным контекстам данных.
- Аудит и трассируемость: детальная запись действий пользователей, изменений в описаниях активов, выпусков и миграций схем. Наличие журнала аудита позволяет проводить расследования инцидентов и соответствовать регуляторным требованиям.
- Контроль доступа к данным: поддержка ограничений на уровне сущностей (DW), атрибутов и контекстов, а также возможность применения правил маскирования и безопасной выдачи доступа к конкретным активам.
- SLA и оперативная поддержка: устанавливаются критерии качества обслуживания, временные рамки реагирования на инциденты и сроки восстановления. Каталог должен поддерживать демонстрацию SLA на уровне процессов выдачи метаданных и обновления в реальном времени.
- Защита данных и криптография: при необходимости обеспечение хранения секретов и ключей в безопасном хранилище, поддержка шифрования на уровне данных и коммуникаций.
Практические рекомендации:
- Настроить Keycloak (или аналогичный IdP) и определить роли администратора, аналитика, владельца актива и аудитора.
- Включить аудит действий пользователя, хранить журналы в отдельном репозитории и обеспечить контроль целостности журналов.
- Развернуть процедуру инцидент-менеджмента и планы реагирования на утечки данных, включая план отката.
- Регулярно проводить аудиты доступа и тестирования уязвимостей, чтобы минимизировать риски эксплуатации.
Конфигурация и операционная практика: dev → prod, бэкапы, миграции и обновления
Эффективная операционная практика является критическим элементом устойчивости каталога данных. В рамках DevOps-подхода рекомендуется выстроить:
- Разделение окружений: dev, тест, staging, prod с чёткими политиками выпуска и обновления. Это позволяет тестировать миграции и обновления без риска для продакшена.
- Управление конфигурациями: хранение конфигураций как кода, применение версионирования и прослеживаемость изменений. Важно избегать «магических» значений и хранить чувствительную информацию в секретах.
- Бэкапы и восстановление: регулярные бэкапы базы данных и индексов, процедуры тестирования восстановления и документированные инструкции по восстановлению.
- Миграции и обновления: последовательность миграций схем и описаний активов при обновлениях OpenMetadata, включая тестовую миграцию на dev и стадиях, затем безопасную миграцию на prod.
- Контроль качества развёртываний: автоматизированные проверки после развертывания, включая проверки индексов, целостности ссылок и доступности API.
- Мониторинг: централизованный мониторинг процессов ingestion, индексации и доступа, с предупреждениями на случай отклонений от нормального поведения.
Эти практики позволяют обеспечить предсказуемость, уменьшить риск сбоев и ускорить внедрение новых функций.
Контентная модель каталога: метаданные, описание, происхождение и версии
Контентная модель каталога определяет, какие именно данные и как описываются. В типичной реализации следует учитывать:
- Метаданные об активе: название, описание, владелец, бизнес-термин, контекст использования.
- Происхождение и версия: источник данных, дата извлечения, версия схемы и изменения во времени.
- Описание структуры: таблицы, колонки, их типы и актуальные ограничения.
- Связи и зависимости: lineage, связи между данными, зависимости от источников и процессов обработки.
- Политики качества: правила, параметры проверки, пороги и ответственные лица.
- Метаданные об доступе: кто имеет доступ к активу и при каких условиях.
- Метаданные об аудитах и изменениях: журнал изменений и дата обновления.
Эта модель должна быть достаточно гибкой для адаптации под различные отраслевые требования и регуляторные правила. Важно обеспечить версионирование описаний активов и поддерживать историю изменений для аудита и регуляторной поддержки.
Реальные кейсы применения в финансовом секторе: примеры МКБ и пользы каталога
Опыт Московского кредитного банка демонстрирует практически значимые преимущества применения каталога данных:
- Ускорение доступа к данным для аналитиков: единый интерфейс позволяет быстро находить источники данных, связанные с конкретными бизнес-областями (кредитование, трансграничные операции, KYC/AML), что снижает время, затрачиваемое на поиск данных.
- Повышение точности и прозрачности расчетов: благодаря прослеживаемости lineage и описаниям, возникают меньше артефактов в анализах, риск ошибок снижается.
- Улучшение управления качеством: наличие политики качества и системы уведомлений позволяет оперативно выявлять и исправлять несоответствия.
- Усиление контроля доступа и регуляторного соответствия: централизованный аудит, роли и политики доступа упрощают соблюдение требований по защите данных и отчетности.
- Поддержка инцидентов и SLA: прозрачность владения активами и их контекст упрощает быстрое обнаружение источника и реагирование, что в итоге снижает время реакции на инциденты и улучшает соблюдение SLA.
Эти кейсы демонстрируют, что каталог данных становится не только инструментом обнаружения активов, но и элементом устойчивости бизнес-процессов, ответственностью за данные и фактором конкурентного преимущества.
Эффективность и показатели: метрики качества данных, SLA, скорость поиска
Оценка эффективности каталога данных проводится по нескольким направлениям:
- Метрики качества данных: полнота заполнения атрибутов, точность описания, соответствие бизнес-терминам, частота обновления и количество предупреждений по качеству.
- SLA по доступу к данным: время отклика API, доступность веб-интерфейса, время на выдачу результатов поиска.
- Скорость поиска: latency по среднему времени поиска, количество найденных активов, полнота релевантности.
- Уровень доверия: индекс удовлетворенности пользователей, доля узлов в каталоге, привязка активов к бизнес-облакам.
- Уровень владения и ответственности: доля активов с назначенными владельцами и обновлениями в реестре.
- Регуляторная готовность: число регуляторных проверок, в которых данные и их контекст будут доступны и достоверны.
Эти показатели позволяют управлять инвестициями в каталог, корректировать архитектуру и приоритезировать развитие функций для повышения эффективности и качества данных.
Риски, уязвимости и ограничения: угрозы, меры минимизации и мониторинг
Внедрение каталога данных не освобождает от рисков. Основные угрозы включают:
- Неправильная конфигурация доступа: риск утечки и непреднамеренного предоставления доступа. Меры — строгие политики RBAC, аудит и тестирование прав.
- Инженерная сложность миграций: риск потери данных или несовместимости версий. Меры — миграции по окружениям, резервные копии и тестирование.
- Зависимость от внешних компонентов: риск потери совместимости между версии инструментов (OpenMetadata, Airflow, ES). Меры — тестирование в dev и staging, план откатов.
- Уязвимости в инфраструктуре: риск атак на IdP, базы данных, кластеры Kubernetes. Меры — обновления, мониторинг уязвимостей и безопасная конфигурация.
- Проблемы с регуляторными требованиями: риск несоответствия и аудита. Меры — документирование политик, аудит операций и консолидация регуляторной информации.
- Ограничения функциональности: ограничение встроенного DQ в OpenMetadata. Меры — комбинированный подход с внешними DQ-инструментами.
Мониторинг риска, реактивные и проактивные меры безопасности и регулярные аудиты — ключевые элементы устойчивого управления данными.
Конкурентный анализ решений: OpenMetadata и альтернативы, дифференциация
На рынке присутствуют как коммерческие, так и открытые решения для каталогов метаданных. К основным конкурентам OpenMetadata относятся Alation, Collibra, Amundsen и другие. Различия между ними включают:
- Стоимость и лицензирование: коммерческие решения обычно требуют лицензий и сопровождения, в то время как OpenMetadata — открытый исходный код, что снижает барьеры входа, но требует внутренней экспертизы для поддержки.
- Гибкость и интеграции: OpenMetadata часто предлагает широкие возможности интеграции через connectors и API, что позволяет адаптировать под требования конкретной организации. Коммерческие решения иногда обладают более формализованными процессами и готовыми контурами для регуляторного соответствия.
- Обновления и поддержку: коммерческие продукты могут предлагать строгие SLA и централизованную поддержку, тогда как у open-source решений поддержка зависит от внутренней команды и сообщества.
- Архитектура и безопасность: в финансовом секторе часто требуется четкий контроль над безопасностью, а также интеграция с IdP и регуляторными требованиями. В некоторых случаях коммерческие решения предлагают встроенные модули для аудита и регуляторной готовности, тогда как у OpenMetadata приходится реализовывать подобные функции в рамках собственной инфраструктуры.
- Масштабируемость и производительность: выбор зависит от контекста использования, объема активов и требований к скорости поиска. Открытые решения позволяют гибко масштабировать и адаптировать архитектуру, но требуют устойчивой инженерной поддержки.
Убедительная дифференциация OpenMetadata в рамках финансового сектора состоит в его открытости, гибкости и возможности тесной адаптации под регуляторные требования, при условии наличия компетентной команды и чётко выстроенной дорожной карты внедрения.
Практические рекомендации и дорожная карта внедрения: выбор подхода и этапы
Путь внедрения каталога данных в финансовом учреждении состоит из нескольких взаимосвязанных шагов:
- Этап 0: стратегическое выравнивание. Определить цели бизнеса, требования регуляторов и KPI. Установить рамочные правила владения, ответственности и CSF (critical success factors).
- Этап 1: фундаментальная архитектура. Выбрать архитектуру каталога, определить сущности, словарь и правила версионирования. Определить архитектуру хранения и индексации, выбрать подходящие версии OpenMetadata, Airflow и сопутствующих компонентов.
- Этап 2: инфраструктура и безопасность. Развернуть Dev окружение Kubernetes, Helm charts, конфигурации секретов, IdP (Keycloak) и политики доступа. Обеспечить конфигурацию логирования и аудита.
- Этап 3: интеграция источников. Подключить ключевые БД и BI-источники, настроить ingestion-процессы и создать каркас lineage/происхождения. Осуществить начальную загрузку и верификацию описаний активов.
- Этап 4: управление качеством. Встроенная DQ в OpenMetadata — начать с базовых правил и затем дополнять внешними проверками. Определить политики качественных порогов и процессы реагирования.
- Этап 5: безопасность и соответствие. Установить RBAC, аудит, политики доступа к активам, интеграцию IdP и план реагирования на инциденты. Определить SLA и синхронизацию регуляторных требований.
- Этап 6: операционная практика. Развернуть dev → prod режим, миграции, бэкапы и откаты; настроить мониторинг и оповещения; подготовить документацию.
- Этап 7: визуализация и эксплуатация. Определить набор KPI, предоставить обучение пользователям и обеспечить поддержку на старте.
- Этап 8: масштабирование и устойчивость. Планировать расширение каталога, новые источники, улучшение DQ и обслуживания. Регулярно проводить ревизии архитектуры и обновления.
Дорожная карта должна быть гибкой и этапной, с обратной связью от бизнес-подразделений. Введение каталога в финансовом секторе — это не одноразовый проект, а стратегический переход к data-driven организации, где данные становятся управляемым активом и источником устойчивого конкурентного преимущества.
В завершение статьи следует отметить, что формирование каталога данных как единого источника достоверности требует системного подхода, соответствия отраслевым требованиям, а также устойчивой команды и инфраструктуры. Применение OpenMetadata в сочетании с проверенными практиками DAMA DMBOK, корректной настройкой процессов и дисциплины позволит вам выстроить надежный, прозрачный и адаптивный инструмент поддержки бизнес-решений в финансовом секторе.
Вопрос-Ответ
1. Вопрос: Что такое единый источник достоверности в контексте каталога данных?
Ответ: Это централизованная система описания и управления метаданными, которая обеспечивает прозрачность происхождения, контекста и качества активов, упрощает поиск и обеспечивает аудируемый след изменений.
2. Вопрос: Какие ключевые сущности формируют словарь каталога?
Ответ: Data Source, Data Asset, Table/Column, Business Term, Lineage, Data Quality Rule, Ownership, Provenance, Version, Tag и связанные элементы, образующие единую модель.
3. Вопрос: Какие преимущества даёт интеграция OpenMetadata в банковской среде?
Ответ: Повышенная прослеживаемость активов, ускорение поиска и анализа, улучшение управления доступом и соответствием регуляторным требованиям, а также возможность гибко масштабировать инфраструктуру.
4. Вопрос: Какой подход к миграциям примыкает к финансовому сектору?
Ответ: Стратегия «dev → test → prod» с детальным планом миграций, резервными копиями и тестированием на dev/staging перед выпуском в prod.
5. Вопрос: Какие риски связаны с внедрением каталога и как их минимизировать?
Ответ: Риски включают неправильные настройки доступа, миграционные сбои, зависимость от сторонних компонентов и регуляторные требования; минимизация достигается через RBAC, аудит, тестирование миграций, резервные копии и документацию.
6. Вопрос: Что важнее — встроенный DQ в OpenMetadata или внешние проверки и почему?
Ответ: Оба подхода важны. Встроенный DQ обеспечивает оперативность и единообразие, внешние проверки дополняют функциональность гибкостью и глубиной проверки, особенно для специфических регуляторных требований.
7. Вопрос: Какие этапы стоит включить в дорожную карту внедрения?
Ответ: Стратегическое выравнивание, архитектура и безопасность, интеграция источников, управление качеством, операционная практика, обучение и масштабирование.
8. Вопрос: Какие метрики эффективности каталога наиболее значимы?
Ответ: Полнота и точность описания активов, скорость поиска, доступность API, соблюдение SLA, число активов с владельцами и готовность к аудиту.


