

Apache Atlas в управлении данными: архитектура, моделирование метаданных и путь данных в контексте Data Governance и Hadoop-экосистемы
Управление данными в крупных организациях представляет собой системную задачу, выходящую за рамки технических реализаций и затрагивающую управленческие, юридические и бизнес-аспекты. Data Governance (DG) — это совокупность процессов, ролей, политики и метрик, обеспечивающих надлежащее использование, качество, доступность и защиту данных. Эффективная DG требует не только технического каталога метаданных, но и связки между бизнес-терминами, техническими сущностями и механизмами контроля доступа.
В контексте Hadoop-экосистемы управление данными приобретает особую сложность: данные распределены по различным хранилищам (HDFS, HBase, Hive, Kafka и т. д.), существует множество источников данных и процессов (ETL/ELT, потоковые обработки, аналитические слои), а требования к соответствию регуляторным нормам и качеству данных — выше. В таких условиях открытые инструменты класса Data Catalog становятся стратегическим элементом архитектуры данных: они позволяют создать единый каталог, обеспечить поиск и исследование данных, задать контекст через бизнес-термины и классификации, а также построить графовую модель связей между объектами данных. Одним из зрелых и широко используемых решений в открытом доступе является Apache Atlas.
Apache Atlas выступает не только как реестр объектов и элементов метаданных. Это платформа, которая поддерживает формирование моделей данных, управление наследованием характеристик между типами, сбор Data Lineage и интеграцию с механизмами безопасности. В совокупности эти возможности образуют фундамент для построения жизненного цикла данных: от появления данных в источнике до их использования в аналитических и управленческих процессах, с учетом требований регуляторов, аудита и контроля качества.
В данной статье мы систематически рассмотрим концепции и практики, лежащие в основе Atlas, связав теоретическую базу с архитектурой, моделированием, эксплуатацией и кейсами применения в рамках DG и Hadoop-экосистемы. Мы будем опираться на ключевые принципы графовой моделизации, наследования типов, гибких схем метаданных и возможностей интеграции с источниками данных и системами безопасности. Особое внимание уделяется пути данных — Data Lineage — как ядру аргументации в пользу внедрения Atlas для обеспечения прозрачности происхождения данных, влияний изменений и расширяемости контекста поиска.
Теоретическая основа: концепции метаданных, графовые модели и принципы наследования
Метаданные — это данные о данных: контекст, характеристики, источник, качество, связь с бизнес-терминами и техническими объектами. В DG они позволяют не только находить данные, но и понимать, что именно содержат данные, как они произошли, какие преобразования прошли и кто имеет к ним доступ. Различают несколько уровней метаданных: технические (таблицы, столбцы, ETL-процессы), бизнес-метаданные (термины, глоссарий, политики), операционные метаданные (профилирование, качество, события). Графовая модель становится естественным выбором для отображения взаимосвязей между этими сущностями: таблица — столбец, процесс — входы/выходы, источник — итоговый объект. В Atlas эта графовая модель реализуется через базовую концепцию «Типы» и «Сущности», объединяющую структуры, связи и наследование.
Наследование в контексте метаданных — принцип, заимствованный из объектно-ориентированного программирования: дочерние Типы наследуют свойства родительских, что позволяет единообразно задавать общие атрибуты и перекраивать контекст по мере необходимости. Такой подход упрощает масштабирование модели, облегчается повторное использование атрибутов и упорядочение сложных цепочек связей. В рамках Atlas наследование применяется как к техническим объектам (например, таблица и её столбец) так и к бизнес-терминам и классификациям, что позволяет комбинировать техническую и бизнес-логики в единой архитектуре каталога.
Теоретические принципы графовых моделей находят прямое приложение в Data Lineage — графическом представлении потоков данных, зависимостей между системами и этапами обработки. Графовая база данных служит естественным хранилищем для связей между сущностями, обеспечивая эффективный обход путей данных и анализ влияний. В Atlas, в сочетании с полнотекстовым поиском и индексацией, графовая модель становится мощным инструментом для быстрого понимания контекста данных, обнаружения источников ошибок, оценки рисков и планирования изменений.
Кроме того, концепции пространства имен, версий и конвенций именования оказывают влияние на устойчивость каталога к изменениям в инфраструктуре. Включение бизнес-глоссария и классификаций в модель метаданных позволяет расширить контекст поиска и усилить применение политики доступа, что особенно важно в условиях регуляторных требований. В целом, теория метаданных в Atlas опирается на принципы модульности, повторного использования и согласованности между техническими и бизнес-слоями информации.
Обзор Apache Atlas: назначение, открытое ПО и место в Hadoop-экосистеме
Apache Atlas — это открытое программное обеспечение (open source), предназначенное для управления метаданными, создания единого каталога данных, сегментации и классификации данных, а также обеспечения Data Lineage. Atlas выступает как связующее звено между источниками данных, процессами обработки и эксплуатационными системами, позволяя обеспечить прозрачность происхождения данных, контекст использования и контроль доступа.
В рамках Hadoop-экосистемы Atlas прочно занимает место как инструмент Data Catalog, который дополняет возможности хранения и обработки больших данных. Основные архитектурные принципы Atlas ориентированы на тесную интеграцию с компонентами Hadoop: HBase в качестве хранилища метаданных, JanusGraph как графовую базу данных для хранения связей, Solr как движок полнотекстового поиска и индексации, Zookeeper для координации кластеров, а также интеграцию с различными коннекторами и источниками через Ingest и Hooks. Atlas поддерживает REST API и систему обмена сообщениями через Apache Kafka, что обеспечивает гибкость при построении автоматизированных процессов захвата метаданных и реакцию на события изменений в каталоге в реальном времени.
Среди сильных сторон Atlas можно выделить:
- гибкость модели типов: Defining Types позволяет описывать как технические, так и бизнес-метаданные, включая расширяемые атрибуты и поддерживаемые связи;
- графовую природу хранения: связь объектов реализована через графовую модель, что существенно упрощает построение Data Lineage и анализ зависимостей;
- богатый REST API: поддерживает создание, поиск, обновление и удаление типов и сущностей, а также работу с классификациями и терминами;
- интеграцию с Hadoop: готовые коннекторы для HBase, Hive, Sqoop, Storm, Kafka и Falcon;
- связь с механизмами безопасности: через интеграцию с Ranger возможно привязывать политики к метаданным и управлять доступом на основе контекста.
Недостатки и ограничения, которые следует учитывать при планировании внедрения Atlas:
- интерфейс администратора и базовый GUI имеют ограниченный функционал по сравнению с коммерческими решениями, нуждаются в дополнительной кастомизации;
- отсутствие встроенного полноценного цикла релизов и управления версиями метаданных на уровне пользователя;
- риск нарушения целостности при ручных операциях через REST API и необходимость аккуратного контроля изменений;
- ограниченная семантика полнотекстового поиска без дополнительных инструментов семантики;
- зависимость от экосистемы Hadoop; в некоторых случаях потребуется адаптация к внешним источникам и облачным средам.
Экономически и управленчески Atlas служит достойной основой для старта внедрения DG: он бесплатен, зрелый, имеет готовые модели и коннекторы, и позволяет развивать компетенции в Data Governance через поэтапный путь “малых побед”.
Архитектура Atlas: обзор компонентов и их взаимодействия
Компоненты системы Atlas и их функциональные роли
- Atlas Server (ядро сервиса): реализует REST API, веб-интерфейс и логику управления метаданными, обеспечивает хранение и индексацию объектов, а также управление версиями и связями.
- JanusGraph: графовая база данных, используемая Atlas для хранения сущностей, связей и графовых структур Data Lineage. Она обеспечивает высокую производительность обхода путей и анализ зависимостей.
- HBase: хранилище метаданных; обеспечивает масштабируемое долговременное хранение самих объектов метаданных и связанных структур.
- Solr: движок полнотекстового поиска и индексации, который Atlas использует для быстрого поиска по метаданным и их атрибутам.
- Zookeeper: координация кластера, управление лидерством и конфигурациями сервисов.
- Ingest: компонент захвата метаданных из источников. Он реализует hooks и коннекторы, которые извлекают сведения об изменениях и создают/обновляют сущности в Atlas в режиме реального времени или пакетно.
- Export: механизм экспорта и регистрации изменений в виде событий, которые публикуются в Kafka и потребляются потребителями для интеграции с внешними системами и приложениями.
- Kafka: брокер сообщений, обеспечивающий передачу событий изменений метаданных и потоковых данных между Atlas и потребителями. Это позволяет синхронизировать данные в режиме реального времени и поддерживать реактивные сценарии.
- Роль в безопасности: через интеграцию с Apache Ranger Atlas обеспечивает тяготение политик к элементам каталога и контекстный доступ на уровне объектов.
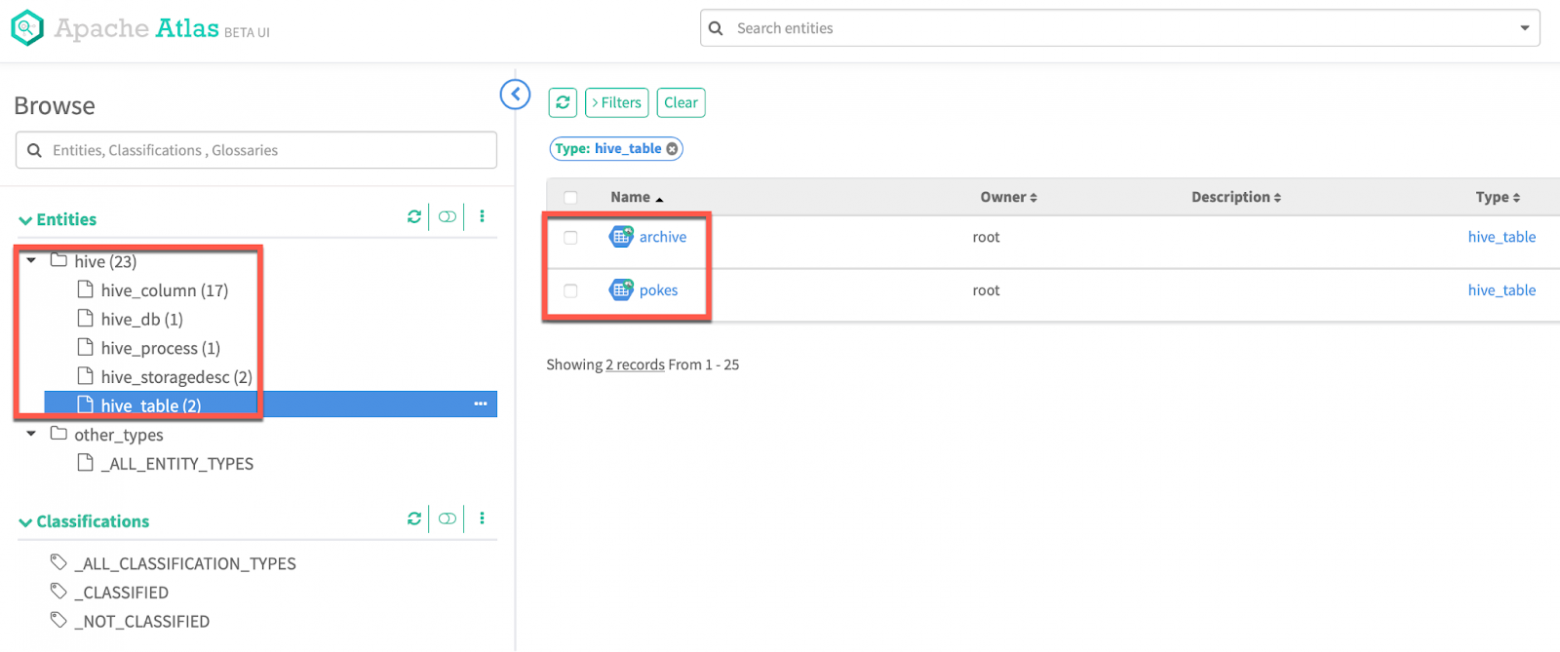
- Пользовательский интерфейс: графический интерфейс для администраторов и пользователей, позволяющий просматривать карточки метаданных, осуществлять поиск, просматривать Data Lineage и работать с бизнес-глоссарием.
- Бизнес-глоссарий и термины: поддержка бизнес-терминов, классификаций и их наследования, которые добавляют контекст к метаданным и позволяют улучшить поиск и влияние на доступ.
- Инструменты профилирования и качества данных: обеспечивают возможность хранения результатов профилирования, метрик качества и событий контроля для последующего анализа.
Взаимодействие компонентов: потоки данных, событий и консистентность
Потоки данных в Atlas описывают последовательность действий: из источника в Atlas, извлечение элементов через Ingest, создание или обновление сущностей и их атрибутов, построение связей и зависимостей. В процессе изменения Atlas инициирует экспорт событий, которые публикуются в Kafka и могут быть потреблены потребителями для синхронизации с другими системами или для триггеров автоматизации. Индексация объектов выполняется через Solr, обеспечивая быстрый поиск по атрибутам и текстовым полям.
Консистентность в Atlas реализуется через принципы eventual consistency и версионирование объектов. В реальном времени изменения могут быть задержаны на неопределённое время при large-scale операций, особенно в условиях высокой нагрузки. Важной частью архитектуры является корректная настройка мостов между источниками, агентами захвата и сервисами, чтобы изменения в бизнес-терминах, классификациях или связях отражались в каталоге своевременно и без потерь. Ranger обеспечивает возможность применения политик доступа на основе контекста метаданных, в то время как экспортные события позволяют потребителям реагировать на изменения, например, обновлять локальные каталоги или инициировать аудит и соответствие требованиям.
Модель метаданных Atlas: типы, сущности, связи и наследование
Сердце Atlas составляет модель типов (Type System), из которой формируется схема метаданных, определяемая через JSON-представление. Основные элементы модели:
- Типы (Types): описывают структуру данных и связи, которые могут включать базовые родительские типы и наследуемые атрибуты.
- Сущности (Entities): экземпляры типов, фактические элементы управления метаданными (например, конкретные таблицы, столбцы, ETL-процессы).
- Связи (Relationships): определения связей между сущностями, включая линейные зависимости, агрегации и другие контекстуальные связи.
- Наследование (Inheritance): позволяет дочерним типам принимать атрибуты родительских типов, упрощая повторное использование и консистентность.
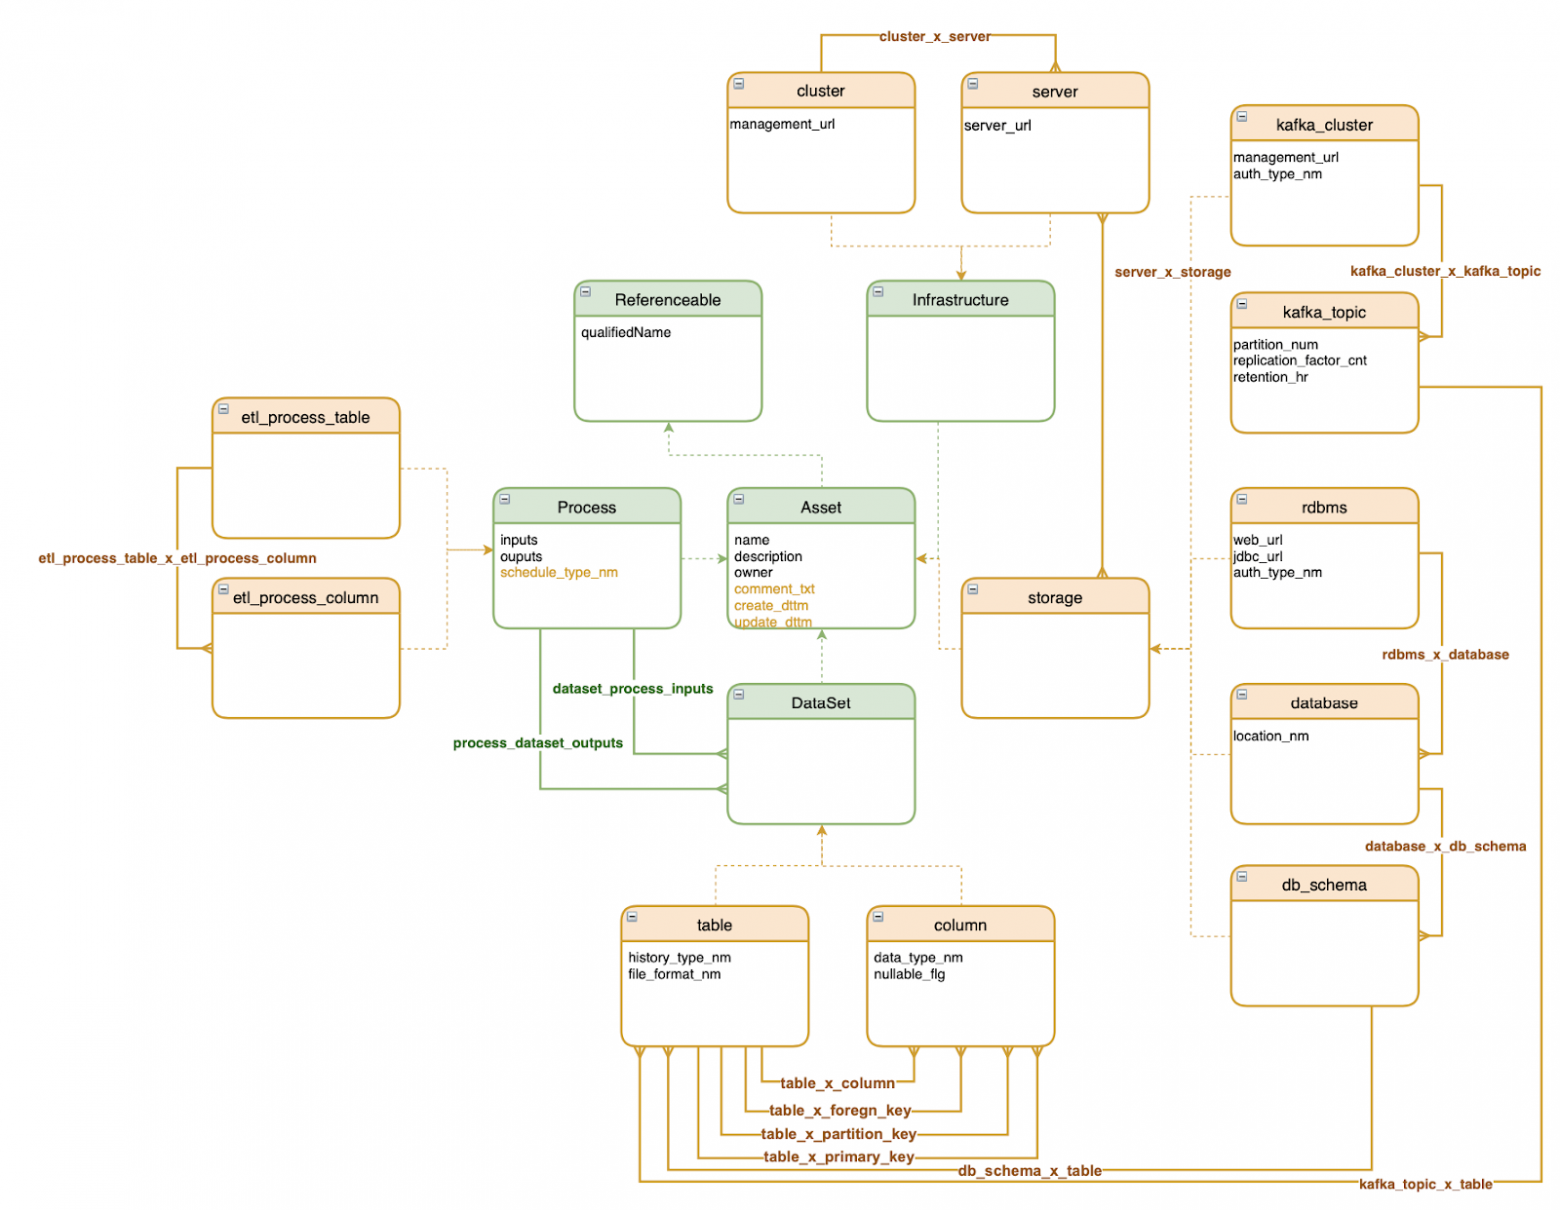
Пример типовой структуры (упрощённо) включает определения enumDefs, structDefs, classificationDefs и entityDefs. В качестве примера сущность Asset может наследовать свойства от Referenceable и включать атрибуты name, description, owner. Такие определения позволяют:
- строить иерархию объектов (например, таблица как контейнер данных, столбец как элемент этой таблицы);
- задавать связи между сущностями (например, столбец относится к таблице, таблица к источнику данных, первичный ключ к таблице);
- внедрять бизнес-глоссарий и классификации для расширения контекста и улучшения поиска в каталоге.
Система типов Atlas обеспечивает гибкость, которая является одним из главных достоинств. За счёт поддержки наследования и возможности расширения типов возможно одновременно моделировать технические и бизнес-метаданные, а также включать результаты профилирования, проверки качества данных и другие контекстуальные элементы.
Исторически Atlas сохраняет объекты метаданных в графовой модели (JanusGraph) и индексирует их с помощью Solr. Это сочетание обеспечивает высокую скорость поиска и эффективное построение Data Lineage в сложных графовых связях. В рамках модели типов Atlas активно применяет концепцию «наследования» для атрибутов и структур: например, сущности типа DataSet могут использовать родительские свойства и дополнять их атрибутами конкретного типа (таблица, столбец, ETL-процесс).
С точки зрения моделирования инфраструктуры, Atlas позволяет описывать как технические аспекты данных, такие как структура и атрибуты таблиц, так и бизнес-аспекты — термины, классификации и правила доступа — что обеспечивает единую среду для управления данными в рамках DG.
Определение схемы метаданных: форматы, JSON-структуры и расширяемость
Определение схемы метаданных в Atlas осуществляется через модель типов, которая задаётся в конфигурационных файлах и через REST API. Типы включают несколько составных элементов:
- enumDefs: перечисления значений атрибутов;
- structDefs: пользовательские структурированные типы;
- classificationDefs: определения классификаций, применяемых к сущностям или атрибутам;
- entityDefs: определения конкретных сущностей, включая их атрибуты и базовые типы;
- relationshipDefs: определения связей между сущностями.
Модель типов строится в формате JSON, который позволяет гибко описать структуру, атрибуты, их типы и ограничения. Пример фрагмента JSON, демонстрирующий создание сущности Asset, наследующейся от Referenceable, с атрибутами name, description, owner, иллюстрирует принципы построения схемы.
{
  "enumDefs": [],
  "structDefs": [],
  "classificationDefs": [],
  "entityDefs": [
    {
      "name": "Asset",
      "superTypes": ["Referenceable"],
      "serviceType": "atlas_core",
      "typeVersion": "1.1",
      "attributeDefs": [
        {
          "name": "name",
          "typeName": "string",
          "cardinality": "SINGLE",
          "isIndexable": true,
          "isOptional": false,
          "isUnique": false
        },
        {
          "name": "description",
          "typeName": "string",
          "cardinality": "SINGLE",
          "isIndexable": false,
          "isOptional": true,
          "isUnique": false
        },
        {
          "name": "owner",
          "typeName": "string",
          "cardinality": "SINGLE",
          "isIndexable": true,
          "isOptional": true,
          "isUnique": false
        }
      ]
    }
  ]
}
С учетом потребностей бизнеса и технических требований, можно расширять схему за счёт дополнительных атрибутов, включая метрики качества данных, результаты профилирования, проверки и т. д. Расширяемость достигается через добавление новых типов и атрибутов без нарушения существующих зависимостей.
Определение схемы метаданных в Atlas требует продуманного подхода к управлению версиями типов (typeVersion), координации изменений и совместимости между моделями. В процессе разработки схемы следует учитывать возможность использования и наследования для гибкой адаптации к новым источникам данных и требованиям бизнеса. JSON-структуры должны быть валидированы и документированы, чтобы обеспечить единообразное использование моделей в разных командах.
Управление метаданными: ввод, хранение, индексация и поддержка изменений
Управление метаданными в Atlas — это последовательность действий по вводу, хранению, индексации и отражению изменений. Ввод метаданных осуществляется двумя основными каналами:
- богатый REST API: позволяет создавать и обновлять Типы, Сущности, связи, классификации и термины. API поддерживает поиск, фильтрацию и управление структурой метаданных.
- обмен сообщениями через Kafka: Atlas публикует события изменений в топики Kafka и может потреблять события из соответствующих коннекторов, что обеспечивает синхронизацию каталога с внешними системами и приложениями.
Архитектурно Atlas использует следующие компоненты:
- Ingest (захват метаданных): синхронизирует внешние источники и системы с Atlas, поддерживает пакетный и потоковый режим захвата;
- Export (экспорт событий): регистрирует изменения и распространяет их потребителям через Kafka;
- Индексация и поиск: Solr индексирует объекты метаданных и их атрибуты, обеспечивая быстрый поиск по каталогу;
- Хранилище метаданных: HBase выступает в роли хранилища для объектов и структур данных Atlas;
- Графовая модель и графовый движок: JanusGraph обеспечивает эффективное представление связей между сущностями и построение Data Lineage.
Управление изменениями включает учёт версий и параметров при обновлениях типов и сущностей. В Atlas отсутствует полноценная встроенная функциональность "ревизий" и "сравнения версий" на уровне пользователей, однако можно реализовать внешнюю автоматизацию и процессы согласования изменений через REST API и интеграцию с системами уведомления. В целях аудита и соответствия регуляторным требованиям важно фиксировать время изменений, авторство и контекст изменений, что Atlas поддерживает через хранение истории изменений по каждому объекту.
После ввода и моделирования метаданных Atlаs позволяет быстро переходить к эксплуатации каталога: поиск, просмотр карточек объектов, анализ связей и Data Lineage. При этом поддержка классов и терминов вносит контекстную сгруппировку данных, что облегчает навигацию и управление доступом на основе бизнес-контекста.
Data Lineage: графовые представления, анализ влияний и экспорт данных
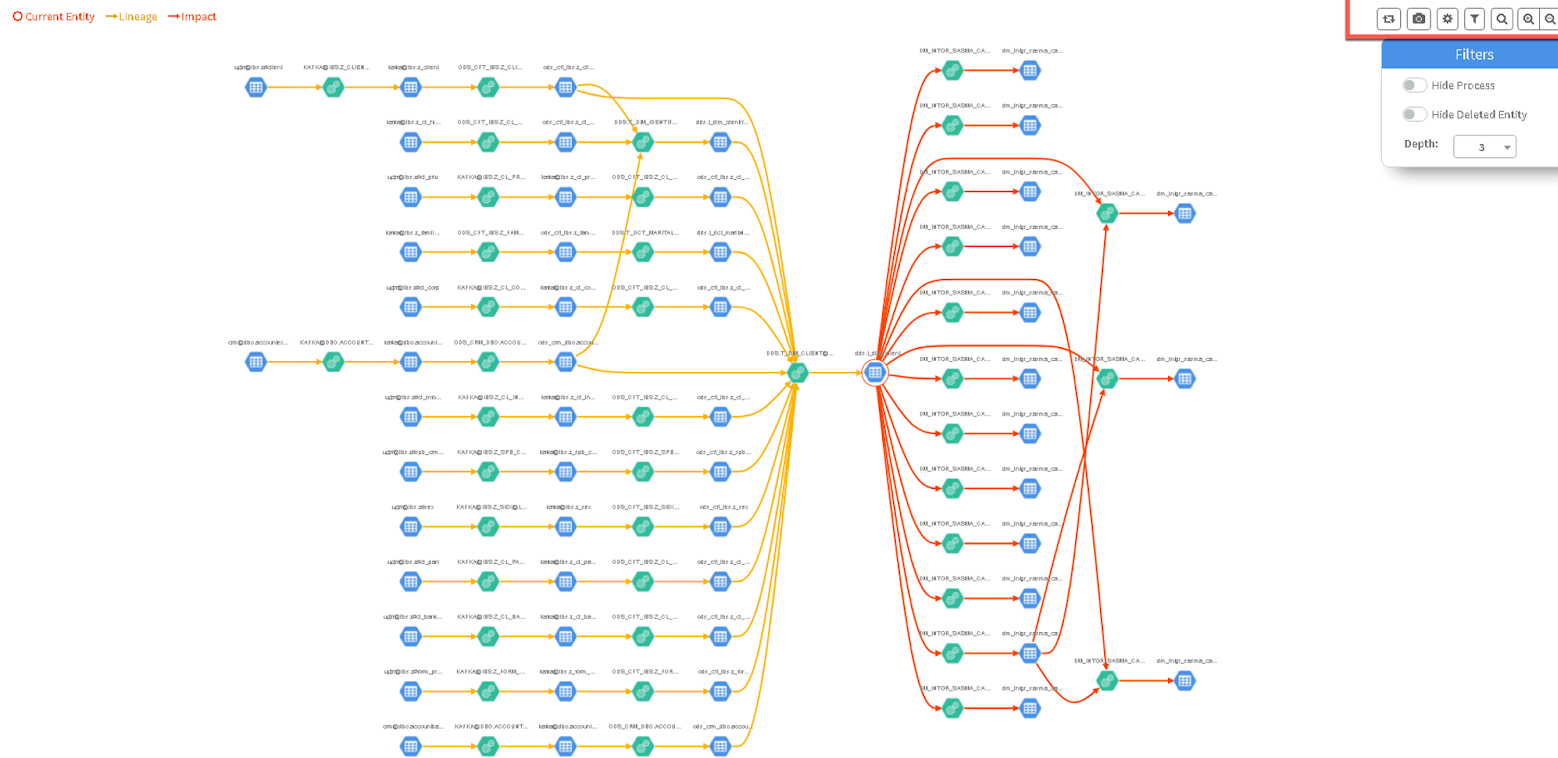
Data Lineage в Atlas — это графический и форматированный набор связей между источниками данных, преобразующими процессами и целевыми системами. Он строится на основе графовой модели Atlas, где сущности и их связи отражают пути данных через entire lineage. Data Lineage позволяет:
- понять происхождение данных: от источника до потребителя;
- увидеть цепочку преобразований и взаимосвязи между системами;
- определить влияние изменений: если изменяется атрибут, связанный с несколькими объектами, можно оценить, какие downstream-объекты будут затронуты;
- экспортировать lineage в формате JSON или в другие форматы для интеграции с внешними системами и задачами автоматизации.
Ключевая ценность lineage состоит в обеспечении прозрачности и управляемости данных в сложных сценариях ETL/ELT, когда данные проходят через множество процессов и систем. В Atlas lineage визуализируется через графовую диаграмму и поддерживает потенциал автоматического обновления в ответ на события изменения метаданных, что важно для регуляторных и аудиторских задач. В реальной практике lineage используется для:
- анализа влияние изменений на соответствие и качество;
- проведения impact analysis перед изменениями в схемах и процессах;
- планирования миграций и рефакторинга обработки данных;
- документирования цепочек происхождения данных в рамках бизнес-глоссария и терминологии.
Экспорт Data Lineage предоставляет JSON-формат, который можно использовать в автоматизированных сценариях, интегрировать в системы мониторинга качества данных, сценарии аудита и управления изменениями. В интеграционных сценариях данные lineage обычно связывается с мероприятиями в системах обработки и хранилищах, что позволяет держать в синхронном виде как каталог объектов, так и их временные изменения.
Классификации и бизнес-глоссарий: теги, наследование и контекст поиска
Классификации и бизнес-глоссарий являются важной частью контекстного обогащения данных. Atlas поддерживает следующий функционал:
- классификации: теги, которые можно назначать объектам метаданных и которым можно задавать дополнительные атрибуты;
- наследование: классификации могут наследоваться от родительских терминов, что позволяет цепочке терминов расширять контекст и обеспечивать консистентность в контекстах поиска;
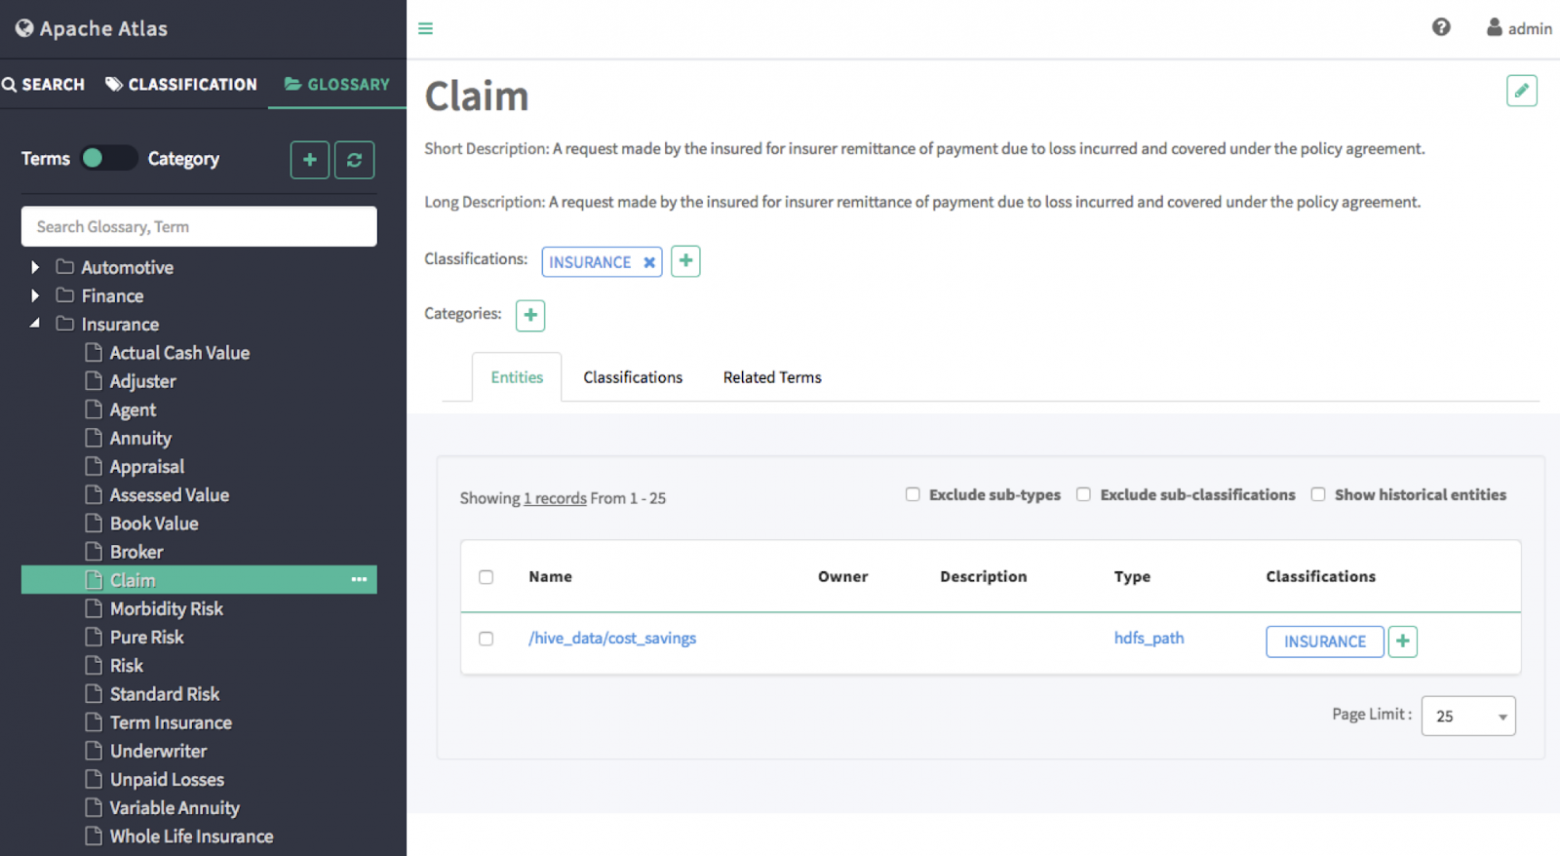
- связь с бизнес-терминами: термины могут быть связаны с объектами метаданных (например, таблицами, файлами, набором столбцов) и в дальнейшем использоваться для поиска и фильтрации;
- интеграция с бизнес-глоссарием: термины объединяются в иерархии, группируются по категориям и связаны с узлами данных.
Ключевые эффекты:
- улучшение поиска: пользователи могут находить данные не только по техническим атрибутам, но и по бизнес-терминам;
- расширение контекста: теги и термины позволяют описывать дополнительные свойства объектов, включая контекст использования, правовую принадлежность, чувствительность и требования к защите;
- наследование метаданных обеспечивает упрощение управления: новые объекты могут автоматически наследовать свойства, определённые на уровне терминов и категорий.
Классификации тесно связаны с механизмами безопасности. В связке Atlas + Apache Ranger политики безопасности могут применяться на основе классификаций и контекста термина, что позволяет реализовать гибкую и контекстную защиту данных. По мере расширения бизнес-глоссария и классификаций, контекст поиска и фильтрации становится более точным и полезным для пользователей.
Поиск и взаимодействие с данными: REST API, Kafka-архитектура и пользовательский интерфейс
Atlas предоставляет универсальный доступ к данным через REST API. Это позволяет:
- создавать и обновлять типы, сущности, связи, классификации и термины;
- осуществлять поиск по метаданным с фильтрами по атрибутам, типам и контексту;
- просматривать карточки метаданных, где отображаются технические свойства, бизнес-атрибуты, связь с lineage и классификациями.
Помимо REST API, Atlas поддерживает обмен сообщениями через Apache Kafka. События изменений метаданных публикуются в Kafka и могут потребляться внешними приложениями для синхронизации локальных каталогов, предупреждений, мониторинга и автоматизации процессов. В Atlas события генерируются и поступают в Kafka процессами захвата (hooks) и самим Atlas, что обеспечивает гибкость при интеграции с внешними системами.
Пользовательский интерфейс Atlas — это GUI, который позволяет:
- осуществлять поиск и навигацию по объектам метаданных;
- просматривать детальные карточки сущностей и связей;
- исследовать Data Lineage через графическую визуализацию;
- работать с бизнес-глоссарием и классификациями.
Интерфейс предоставляет удобство для технических специалистов и дата-стюардов, однако он может требовать дополнительных кастомизаций и сквозной автоматизации через REST API для бизнес-пользователей. Важной задачей является гармонизация возможностей API и GUI для обеспечения эффективной работы пользователей с каталогом.
Безопасность и доступ: политики Ranger, аутентификация и маскирование
Безопасность в Atlas достигается через интеграцию с механизмами контроля доступа и аутентификации. Apache Ranger выступает как потребитель изменений метаданных и как система управления политиками доступа, основанная на контексте метаданных. В связке Atlas + Ranger политики применяются к объектам метаданных на основе классификаций, типов и терминов. Это позволяет реализовать:
- моделирование доступа на основе роли, состава групп и контекста данных;
- маскирование чувствительных данных при доступе пользователей, чьи роли ограничены;
- аудит доступа и изменений в соответствии с регуляторными требованиями.
Аутентификация может быть реализована разными способами:
- File: локальные файловые учетные данные;
- Kerberos: служебная аутентификация на уровне Kerberos;
- LDAP: интеграция с корпоративной службой каталогов;
- Keycloak (OpenID Connect / OAuth 2.0): единая система аутентификации и авторизации;
- PAM: универсальная модульная подсистема аутентификации.
Данные маскируются по правилам доступа и политик Ranger, что обеспечивает соответствие требованиям к приватности и защите персональных данных. В рамках DG особенно важно обеспечить не только доступ к данным, но и аудит, версии изменений и возможность отслеживать, какие данные квалифицируются как конфиденциальные, и какие пользователи имеют доступ к ним.
Интеграции и коннекторы: поддерживаемые источники и механизмы расширения
Atlas имеет развитую экосистему интеграций и коннекторов, которые позволяют захватывать метаданные из множества источников, а также расширять возможности каталога за счёт внешних систем.
Интеграции с Hadoop-экосистемой: HBase, Hive, Sqoop, Storm, Kafka, Falcon
Atlas поставляется с поддержкой ключевых компонентов Hadoop и смежных инструментов. Обеспечиваются готовые коннекторы и hooks, которые:
- захватывают объекты метаданных из систем хранения и обработки (HBase, Hive);
- интегрируются со средствами миграции и управления данными (Sqoop);
- позволяют отслеживать состояния потоков и процессов (Storm, Kafka, Falcon).
Эти интеграции позволяют Atlas автоматически создавать и обновлять типы и сущности, а также устанавливать связи между системами и данными. В случаях, когда источники данных находятся в облаке или за пределами Hadoop-окружения, Atlas может быть расширен за счёт пользовательских коннекторов или через общие протоколы, например REST API или данные событий, публикуемые через Kafka.
Взаимодействие с внешними системами и облачными сервисами
Помимо Hadoop-экосистемы Atlas поддерживает интеграцию с внешними системами: облачными службами хранения данных, решениями бизнес-аналитики и другими каталогами. Это достигается через:
- REST API для загрузки и обновления метаданных из внешних систем;
- коннекторы и hooks, которые могут захватывать метаданные из внешних источников типов файлов, баз данных и потоковых сервисов;
- обмен сообщениями через Kafka для реактивной интеграции и передачи изменений в другие системы.
Эти возможности позволяют создать единую картину метаданных в межоблачной и гибридной среде, поддерживая DG на уровне всего предприятия.
Установка и развёртывание Atlas: требования, подходы и практические инструкции
Базовая установка Atlas требует наличия компонентов Hadoop-экосистемы: Solr как движок полнотекстового поиска, HBase как хранилище метаданных, Zookeeper для координации, и, при необходимости, другие сервисы. В практике развёртывания применяются разные подходы:
- Монолитное развёртывание в контейнеризованной среде: Atlas, Solr и HBase запускаются в контейнерах, что обеспечивает удобство тестирования и повторяемость;
- Интегрированное развёртывание в рамках дистрибутивов Hadoop-платформ (например, Cloudera, HortonWorks, ArenaData): Atlas входит в дистрибутив и настраивается совместно с остальными сервисами;
- Периферийные и песочничные варианты: для знакомства и экспериментов возможно использование минимального набора компонентов и упрощённой конфигурации.
Практические инструкции по развёртыванию обычно включают:
- подготовку кластера и настройку сетевых параметров;
- развёртывание Zookeeper, HBase и Solr;
- развёртывание Atlas Server и настройку его соединений с HBase и Solr;
- настройку Ingest и Hooks для интеграции с источниками;
- запуск и проверку статуса сервиса Atlas через REST API (проверка версии и доступности).
Пояснение: в реальных проектах применение Docker/ Kubernetes-окружения помогает автоматизировать развёртывание и управление конфигурациями, обеспечивает повторяемость и упрощает масштабирование.
Практические примеры моделирования: создание кастомных типов, сущностей и связей
Рассмотрим практические шаги по моделированию в Atlas:
- Создание кастомного типа: определение типа таблицы и столбца как наследуемых от родительских типов (DataSet, Attribute). Это позволяет описывать как сущности, так и их атрибуты в единой схеме.
- Определение сущностей: создание конкретной таблицы и её столбцов, наполнение атрибутов name, qualifiedName, description и др.
- Определение связей: создание отношений между таблицей и столбцом (например, table_x_column) и между таблицей и её первичным ключом (table_x_primary_key).
- Связывание с бизнес-глоссарием: привязка терминов к объектам метаданных для расширения контекста и усиления поиска.
- Загрузка изменений: использование REST API для создания сущностей и связей, а также публикации событий через Kafka для уведомления систем об изменениях.
- Визуализация lineage: построение графов, отображающих поток данных и зависимые элементы.
Пример последовательности действий в Atlas через REST API формирует новые типы и сущности, добавляет связи и формирует граф Data Lineage. Включение таких элементов в каталог обеспечивает единый контекст, что упрощает аудит, поиск и управление изменениями. Практические сценарии моделирования позволяют адаптировать Atlas под особенности конкретной предметной области и инфраструктуры.
Ниже приведён упрощённый пример как можно расширить типовую схему и создать связанные сущности через REST API (условные команды и структуру можно адаптировать под реальную среду):
- создаются новые типы table и column, наследующиеся от DataSet;
- добавляются свойства истории (history_type_nm) для таблицы;
- создаются сущности table и column;
- создаются связи table_x_column и table_x_primary_key между сущностями;
- обновляются связи, если требуется.
Эти шаги демонстрируют, как Atlas позволяет централизованно описывать реальный мир через типы и сущности, и как через эти модели можно управлять Data Lineage и контекстом поиска.
Реальные кейсы применения: управление данными, соответствие требованиям и качество
Применение Atlas в реальных проектах DG позволяет достичь ряда конкретных целей:
- централизованный каталог: единое место для поиска и исследования метаданных, упрощение доступа к данным;
- управляемый контекст: связка технических объектов и бизнес-глоссария позволяет бизнес-подразделениям понимать смысл данных;
- прозрачность происхождения данных: Data Lineage помогает аудиторам и аналитикам видеть путь данных, их источники и преобразования;
- соответствие требованиям: фиксация источников, обработок, классификаций и политик доступа обеспечивает аудит и контроль за соответствием регуляторным нормам (например, PII, PHI, чувствительные данные);
- усиление качества данных: хранение результатов профилирования, контроля качества, метрических показателей позволяет мониторить надежность и точность данных.
Ключевые элементы внедрения Atlas в кейсах DG включают в себя настройку бизнес-глоссария, внедрение готовых коннекторов для источников данных, определить политики доступа на основе классификаций и тегов, а также развёртывание механизмов уведомления и автоматизации на основе событий изменений.
Применение Atlas в экономических секторах: финансы, здравоохранение, телеком и т.д.
Atlas на практике применяется в нескольких отраслевых контекстах:
- финансы: контроль качества, соответствие требованиям, аудируемость и прозрачность источников данных для регуляторных органов; управление чувствительной информацией и маскирование;
- здравоохранение: работа с медицинскими данными, PHI/PII, глоссариями терминов, анализ lineage для аудита и соответствия требованиям к конфиденциальности;
- телеком: управление данными клиентов, аналитика по сетям, серии событий и потоковые данные; поддержка регуляторных требований к данным и к моделям данных;
- государственный сектор и другие отрасли: необходимость для DG, аудита и прозрачности источников данных, обеспечения соответствия.
Во всех случаях Atlas служит как связующее звено между техническими компонентами хранения и обработки данных и бизнес-логикой, определяя контекст использования, правила доступа и требования к аудиту.
Анализ рисков, уязвимостей и ограничений: риски внедрения, меры контроля, метрики
Внедрение Atlas связано с рядом рисков и ограничений:
- риск разрушения целостности данных при манипулировании метаданными через REST API без надлежащего контроля;
- зависимость от отдельных компонентов Hadoop-окружения (HBase, Solr, JanusGraph, Zookeeper) и потенциальная сложность обновлений;
- потребность в квалифицированном персонале: эффективное использование Atlas требует знаний в DG, метаданных, графовых моделях и интеграциях;
- ограниченная функциональность GUI и отсутствие встроенного полноценного цикла релизов;
- сложность масштабирования в очень больших кластерах, требующая продуманной архитектуры кластера и мониторинга;
- риск несогласованности между источниками и Atlas при отсутствии надлежащих процессов согласования изменений.
Меры контроля:
- проектирование архитектуры вокруг устойчивых коннекторов и четкого процесса управления изменениями;
- настройка политик доступа (Ranger) и аудита для соответствия требованиям;
- обеспечение консистентности между источниками и Atlas через синхронизацию изменений и мониторинг;
- использование CI/CD-процессов и автоматизированной валидации изменений схем метаданных;
- мониторинг производительности и индексации, оптимизация конфигураций Solr и JanusGraph.
Метрики риска включают долю объектов, находящихся в статусе устаревших изменений, время задержки обновления lineage, долю неиндексированных объектов, частоту обновления политик доступа и т.п. Контроль через регулярный аудит и отчеты по безопасности и соответствию помогает поддерживать DG.
Метрики эффективности и мониторинг: охват каталога, точность lineage, задержки
Эффективность Atlas можно оценивать по нескольким ключевым метрикам:
- охват каталога: доля активных объектов в каталоге относительно общего объема источников данных;
- точность Data Lineage: соответствие между операций и фактическим поведением систем; сравнение lineage с реальными путями данных;
- задержки синхронизации изменений: времени между изменением метаданных и их отражением в каталоге;
- качество поиска: полнота и релевантность результатов поиска, время отклика;
- регуляторные события и аудит: полнота и своевременность фиксации изменений и политик доступа;
- устойчивость к отказам и восстановление: время восстановления после сбоев, надежность процессов захвата и экспорта.
Эти метрики позволяют руководителям DG и ИТ-директорам оценивать прогресс внедрения Atlas, а также оперативно выявлять узкие места и перераспределять ресурсы.
Производительность, масштабируемость и устойчивость: рекомендации по настройке
Для обеспечения производительности Atlas при больших нагрузках рекомендуется:
- архитектура кластера: распределённое развёртывание Atlas с резервированием слоёв ingest/export, настройка репликаций;
- оптимизация графовой базы JanusGraph и хранилища: выбор подходящей конфигурации для HBase; мониторинг индексирования в Solr и Tune;
- балансировка нагрузки на REST API и очередь событий через Kafka: настройка параллелизма и лимитов;
- настройка кэширования и индексов для ускорения поиска;
- планирование миграций и обновлений: тестирование в песочнице, продвинутые стратегии миграций метаданных;
- безопасность и доступ: настройка политики Ranger без снижения производительности;
- мониторинг: интеграция со сторонними системами мониторинга; сбор статистики по задержкам и нагрузкам.
Устойчивость достигается через резервирование, мониторинг, резервное копирование и процедуры восстановления после сбоев, чтобы обеспечить непрерывную работу DG и сохранность метаданных.
Конкурентный анализ и дифференциация: Atlas vs Amundsen, DataHub, Alation, Collibra
Atlas конкурирует на рынке как доступный open-source инструмент Data Catalog, но имеет свои уникальные черты и ограничения по сравнению с коммерческими решениями и альтернативами:
- Amundsen (Open Source) — фокус на поиск и каталог, сильная интеграция с Apache Hadoop-стеком, хорошо работает с метаданными, ориентирован на данные инженеров; Atlas предлагает более широкую модель метаданных, включая бизнес-глоссарий и Data Lineage.
- DataHub (Open Source) — платформа, ориентированная на метаданные и линейку, включает современные механизмы индексации и графовую модель; Atlas обеспечивает большую глубину наследования и гибкость в моделировании.
- Alation, Collibra (Коммерческие) — сильные UI, бизнес-приоритет, поддержка рабочих процессов согласования изменений, нотификации и продвинутые функции управления контекстом; Atlas может не иметь такой полноты для бизнес-процессов по умолчанию, однако легко расширяется через REST API и интеграцию с сторонними инструментами.
- Архитектура vs потребности: Atlas лучше подходит для организаций, которые хотят начать с открытого инструмента и развивать DG поэтапно с возможностью расширения и доработки под свои нужды; коммерческие решения часто предоставляют более зрелые функции управления изменениями, нотификаций, управления жизненным циклом и готовые процессы.
Ключевое отличие Atlas — это открытое ядро, которое можно адаптировать под конкретную инфраструктуру и источники данных, тогда как конкуренты часто ориентируются на готовые бизнес-процессы и расширенную поддержку, но требуют лицензирования и внедрения.
Рекомендации по стратегии внедрения: этапы, миграции и управление изменениями
Стратегия внедрения Atlas в DG должна быть поэтапной и ориентированной на достижение быстрых побед и устойчивого роста компетенций:
- Этап 1. Оценка и проектирование: определить источники данных, бизнес-термины, требования к lineage и секторные регуляторные требования; сформировать команду, роли и ответственность.
- Этап 2. Пилотный каталог: развернуть Atlas в песочнице, определить базовую модель типов, заполнить минимальный набор сущностей и классификаций; реализовать простые сценарии захвата.
- Этап 3. Расширение моделей: внедрить дополнительные типы, связи и бизнес-термины; настроить политки доступа через Ranger; внедрить механизмы встраивания и нотификаций.
- Этап 4. Интеграции и автоматизация: подключить источники данных по зависимым коннекторам, настроить потоки ingest/export, реализовать автоматические обновления и синхронизацию.
- Этап 5. Глобальная экспансия: расширить охват каталогом на другие бизнес-единицы, отраслевые решения, миграции и рефакторинг моделей.
- Этап 6. Управление изменениями и устойчивость: внедрить процессы согласования изменений, моделирование версий и контекстного аудита, автоматизацию уведомлений.
- Этап 7. Мониторинг и оптимизация: контроль метрик эффективности, производительности, удовлетворения бизнес-потребностей, настройка параметров кластера и индексации.
Каждый этап требует четкого управления изменениями, документирования и обучения пользователей. Важной частью стратегии является постепенное внедрение, чтобы выдержать требования бизнеса и сохранить устойчивость инфраструктуры.
Выводы и направления развития: сводка результатов и перспективы будущего развития
Apache Atlas является зрелой, гибкой и расширяемой платформой для управления метаданными и Data Governance в контексте Hadoop-экосистемы. Его графовая модель метаданных, наследование типов, поддержка Data Lineage, бизнес-глоссарий и интеграции с системами безопасности делают Atlas мощным инструментом для построения единого каталога, контроля доступа и аудита. Atlas предоставляет фундамент для формализации процессов DG, поддержки соответствия и улучшения качества данных. Однако реализация требует продуманной архитектуры, квалифицированной команды и стратегического подхода к миграции и расширению моделей.
Перспективы развития Atlas включают:
- более тесную интеграцию с облачными платформами и гибридными архитектурами;
- усиление управления версиями и жизненным циклом метаданных;
- развитие инструментов нотификаций, подписок и автоматизации процессов согласования изменений;
- улучшение семантического поиска и возможностей для расширенной аналитики метаданных;
- усиление экосистемы коннекторов и расширение шаблонов для бизнес-глоссариев и терминов.
В целом Atlas предлагает прочную основу для внедрения DG и управления данными в рамках Hadoop-экосистемы. Он позволяет идти путем постепенных побед, накапливая опыт, расширяя контекст данных и углубляя понимание связей между данными, процессами и их пользователями. В сочетании с грамотной стратегией внедрения, командой вопросов к данным и структурой управления изменениями Atlas становится эффективным инструментом в арсенале корпоративной Data Platform.
В конце статьи следует отметить, что успех внедрения Atlas требует не только технической реализации, но и управленческих практик: формирование процессов согласования изменений, развития бизнес-глоссария, расширение полномочий по доступу и выстраивание компетенций дата-стюардов, дата-инженеров и аналитиков. Только в сочетании методологической подготовки и технической силы Atlas способен обеспечить устойчивую стратегию управления данными в рамках DG и Hadoop-экосистемы.
Вопрос-Ответ:
Вопрос: Какие ключевые компоненты Atlas обеспечивают хранение и безопасный доступ к метаданным?
Ответ: Основные компоненты — JanusGraph (графовая база для сущностей и связей), HBase (хранилище метаданных), Solr (поиск и индексация), Atlas Server (REST API и UI) и Ranger (полиcy доступа; интеграция для контекста доступа).
Вопрос: Что такое Data Lineage в Atlas и зачем он нужен?
Ответ: Data Lineage — графическое и формализованное представление путей данных от источников к потребителям и через трансформации; он нужен для аудита, анализа влияния изменений и обеспечения прозрачности происхождения данных.
Вопрос: Как осуществляется захват метаданных из внешних источников?
Ответ: Через компонент Ingest и hooks, которые подключаются к системам (например, Hive, HBase, Sqoop) и создают/обновляют сущности в Atlas; изменения публикуются Export через Kafka.
Вопрос: Какие форматы определяют схему метаданных Atlas?
Ответ: Формат определяется через Typedefs: enumDefs, structDefs, classificationDefs, entityDefs и relationshipDefs; типы и сущности описываются в JSON.
Вопрос: Какие ограничения существуют в Atlas в части версионности и изменений?
Ответ: Atlas не всегда имеет встроенный полноценный механизм версионирования на уровне UI; управление изменениями требует внешних процессов и аккуратности при редактировании через REST API; некоторые операции требуют предварительной подготовки GUID-элементов.
Вопрос: Какие шаги рекомендуются для внедрения Atlas в организации?
Ответ: Этапы: планирование и проектирование, пилотный каталог, расширение моделей и интеграции, внедрение политик доступа, мониторинг и оптимизация; следует акцентировать внимание на управление изменениями, обучении и документировании.


