

Управление метаданными в CDP/SDX: архитектура Atlas и Ranger, модели данных и практики внедрения, расширение активов за пределы CDP и полноценная прослеживаемость
Управление данными в современных корпоративных условиях требует комплексного подхода к описанию, защите и прослеживаемости активов данных. Платформа Cloudera Data Platform (CDP) обеспечивает полный жизненный цикл данных — от их ingestion до аналитических выводов и искусственного интеллекта. Однако реальная ценность достигается не только за счет технической функциональности, но и через единый слой управления метаданными, который связывает разрозненные источники и инструменты в единое целое. В этом контексте роль Apache Atlas как базового компонента SDX (Shared Data Experience) становится ключевой. Atlas предоставляет унифицированный каталог метаданных, поддержку классификаций и механизмов прослеживаемости, что позволяет выстроить согласованное управление данными во всей гибридной архитектуре CDP и вне её пределов.
Роль Atlas в SDX не ограничивается внутренними активами CDP: он способен подключать внешние активы из не-CDP источников, расширяя горизонты управления и обеспечивая сквозную видимость на уровне предприятия. В связке с Apache Ranger Atlas формирует прочную основу политики доступа и аудита, позволяя не просто хранить метаданные, но и гарантировать соответствие регулятивным требованиям, управлять ролями и правами доступа, а также проводить аудит изменений. Итогом становится единый, доступный и управляемый каталог, который поддерживает не только стандартный аналитический стек CDP, но и сторонние системы, находящиеся в ИТ-ландшафте организации.
Цель данной статьи — рассмотреть архитектурные принципы SDX, формальные модели метаданных Atlas, механизмы расширения управляющего контекста за пределы CDP, а также практические сценарии внедрения и применения в реальных проектах. Мы будем рассуждать от концепции к реализации, от общих принципов к конкретным шагам развёртывания и эксплуатации. В основе изложенного лежит практический опыт применения Atlas и Ranger как двух взаимодополняющих компонентов, а также обобщённый набор подходов к интеграции различных технологических стеков: Hadoop/Hive, Kafka и REST API.
Управление метаданными — это не только каталогизация активов, но и создание контекста для принятия решений, снижения операционных рисков, повышения прозрачности процессов и ускорения внедрения изменений. В рамках SDX Atlas выступает как центральный репозиторий, где типы и сущности становятся строительными блоками экосистемы данных, а классификации — как средства описания политик, требований к конфиденциальности и характеристик объектов. В следующих разделах мы подробно разберём архитектуру, концептуальные основы и практическую реализацию такого управления.
Архитектура SDX: Atlas, Ranger и интеграционные механизмы
Архитектура SDX формируется вокруг тройственного ядра: Atlas как управляемый каталог метаданных, Ranger как система контроля доступа и аудита, и интеграционные механизмы, связывающие их с инструментами CDP и внешними источниками. В рамках гибридной среды SDX обеспечивает единый доступ к данным, единые правила безопасности и единое представление о прослеживаемости потока данных.
Главные принципы архитектуры можно сформулировать так:
- Единый каталог метаданных как источник истины. Atlas хранит определения типов (typedefs), объекты (entities) и классификации, а также атрибуты и связи между активами. Эта точка собирает данные о структурах и зависимостях, которые необходимы для прозрачности анализа и управления рисками.
- Централизованная политика безопасности и аудит. Ranger обеспечивает контроль доступа к данным на уровне сервисов и ресурсов. Он применяет политики, связывая требования к безопасности с конкретными активами метаданных, что позволяет реализовать регуляторные и внутренние требования по сохранности данных.
- Интеграционные механизмы как механизм согласованности. Atlas поддерживает множество транспортных протоколов и механизмов интеграции: REST API, события через Apache Kafka и коннекторы к различным хранилищам. Это позволяет Atlas синхронизировать метаданные между CDP и внешними системами, обеспечивая устойчивость к изменению инфраструктуры и расширяемость платформы.
- Расширяемость за счёт внешних активов. Atlas содержит предопределённые typedefs для активов, используемых внутри CDP (например, таблицы Hive). Но благодаря открытости и гибкости Atlas может быть расширен внешними определениями для активов сторонних источников, подключаемых к корпоративному каталогу.
С практической точки зрения SDX обеспечивает следующие эксплуатационные сценарии:
- Прослеживаемость lineage в гибридном ландшафте: благодаря связям между сущностями и классификациями можно отслеживать цепочку происхождения данных через несколько инструментов и систем.
- Единый подход к классификациям: централизованные определения классификаций позволяют унифицировать подход к идентификации чувствительных данных, соответствия требованиям и управления качеством.
- Прозрачность и аудит: интеграция Atlas с Ranger обеспечивает формальное аудируемое представление о том, какие активы были запрошены пользователями, какие политики применяются, и какие изменения происходят в метаданных.
Технически SDX базируется на проектах с открытым исходным кодом. Apache Atlas выполняет роль каталога метаданных и предоставляет REST API для управления типами (typedefs), сущностями и классификациями. Apache Ranger обеспечивает политики доступа к данным и инструменты аудита. Архитектура в CDP благодаря SDX становится сквозной и согласованной: активы, созданные внутри CDP, автоматически попадают в Atlas, а политики доступа — в Ranger. Такой подход упрощает управление данными на широком диапазоне потребителей аналитических инструментов и сценариев использования.
Говоря о моделях взаимодействий, стоит отметить, что Atlas и Ranger не работают в изоляции. Atlas задаёт структуру и контекст, а Ranger обеспечивает реализацию политики доступа к этим данным. Взаимодействие между ними осуществляется через интеграционные точки SDX и транспортные каналы, обеспечивающие надёжную доставку изменений и уведомлений. Итогом является единая, согласованная система управления и контроля над данными, которая легко адаптируется под расширение и эволюцию технологических стеков предприятия.
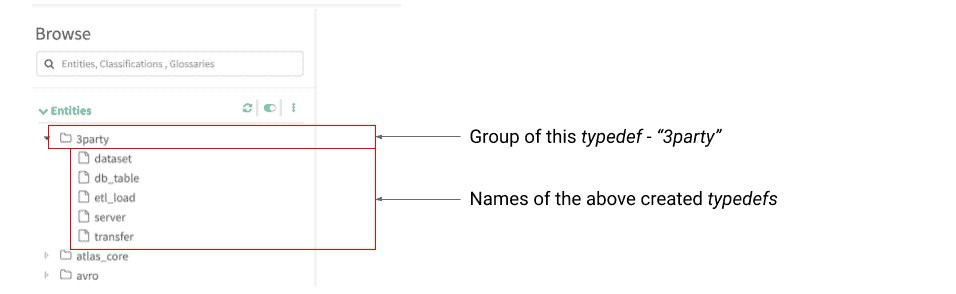
Модель метаданных Atlas: typedefs, сущности, классификации и атрибуты
Ключевая концепция Atlas состоит в разделении управляемости данных на четыре основных элемента: определения типов (typedefs), объекты-сущности (entities), классификации и атрибуты. Эти элементы образуют иерархическую и расширяемую модель, позволяющую описывать широкий спектр активов данных.
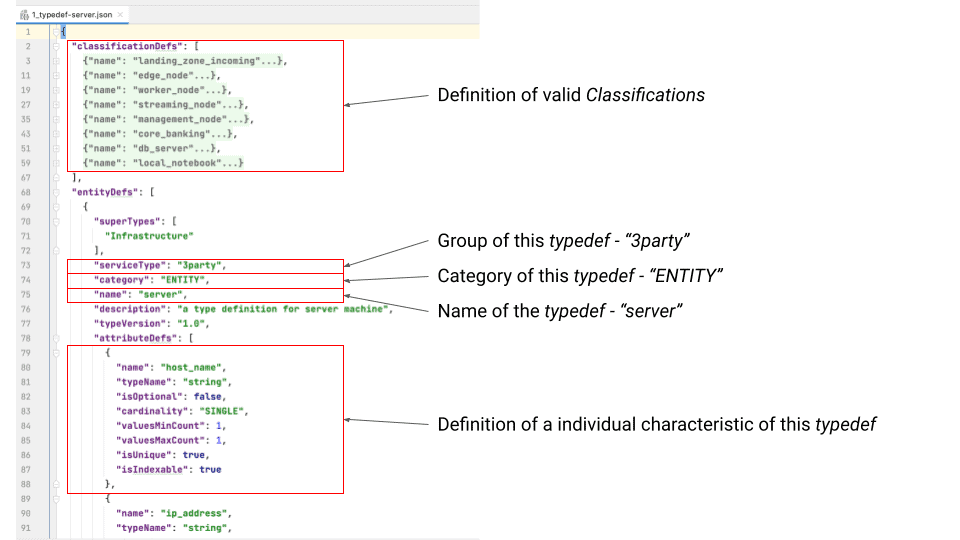
- Определения типов (typedefs) — это схемы, которые задают структуру описания активов. Каждое определение типа может наследовать свойства от супертойпа и быть частью более высокого класса. Это даёт возможность строить древовидное, структурированное хранилище активов данных, где каждый typedef задаёт набор характеристик и зависимостей.
- Объекты (entities) — конкретные экземпляры typedef. Они являются реальными активами внутри каталога: серверы, таблицы, наборы данных, файлы и прочие артефакты. Сущности несут набор атрибутов и могут иметь привязанные классификации.
- Классификации — это метаданные, которые налагают дополнительный контекст на объекты. Например, классификация может указывать, содержит ли таблица персональные данные, относится ли актив к конкретному приложению или проекту. Классификации позволяют быстро фильтровать и категоризировать активы в рамках управляемости и обеспечения соответствия.
- Атрибуты — это свойства, которые описывают каждый актив в рамках typedef. Атрибуты позволяют хранить всю необходимую информацию об объекте: описание, владелец, путь к директории, частота обновления, формат данных, сетевые параметры и многое другое. Атрибуты формируют полноту описания и позволяют осуществлять поиск, фильтрацию и сопоставления между активами.
Для иллюстрации приведём упрощённый, но наглядный пример, описанный в источнике:
- typedef для сервера (server). Он может включать супертипы и атрибуты, например: description, owner, qualifiedName, name, host_name, ip_address, zone, platform, rack_id. Эти поля позволяют задать уникальную идентификацию сервера и описать его параметры на уровне инфраструктуры.
- классификации, связанных с серверами, могут быть привязаны к конкретным активам и служат механизмом добавления контекста: например, классификация landing_zone_incoming может сигнализировать о том, что данный сервер базируется как точка входа в landing zone.
- typedef для набора данных (dataset) и для таблиц Hive — такие типы являются неотъемлемой частью CDP и включены в предопределённый набор Atlas. Однако Atlas поддерживает расширение и настройку новых typedef'ов для активов вне CDP, что является основой сквозной прослеживаемости.
- примеры атрибутов набора данных могут включать description, qualifiedName, name, file_directory, frequency, owner, group, format, server (ссылка на сервер-entity), col_schema (массив структур, описывающих колонки и их типы), и другие атрибуты, которые необходимы для детального описания и последующего анализа.
Ключевым понятием является возможность связывать сущности через классификации и между собой через атрибуты. Связь между, к примеру, сервером и набором данных, или между набором данных и целевой таблицей — формирует инфраструктуру для прослеживаемости, а также для управления зависимостями и изменений. География, окружение и контекст среды — prod/pre-prod/test — добавляются через атрибуты и классифицируемые поля, что облегчает управление инфраструктурными изменениями и регуляторные проверки.
Atlas предоставляет богатый REST API, позволяющий создавать typedefs, сущности и классификации. Документация по REST API Atlas v2 описывает пути работы с typedefs, сущностями и классификациями, что позволяет автоматизировать внедрение и масштабирование управления метаданными. В контексте CDP эта API становится основой для построения сквозных конвейеров, где внешние источники и внутренние активы приводятся к единому базовому словарю понятий и модели данных.
Важной особенностью является предустановленный набор typedef для активов, используемых в CDP (например, таблицы Hive). Это даёт возможность оперативно подключать новые внешние активы к существующим элементам CDP и строить сквозную линию данных. Но гибкость Atlas остаётся критически важной: можно расширять существующие или добавлять новые typedef'ы для сторонних источников, обеспечивая согласованность и единое описание по всей организации. В практике это означает, что каждое новое внешнее источники данных может быть быстро интегрировано в каталог Atlas при сохранении единообразной структуры и совместимости с существующими механизмами фиксации и контроля.
Помимо структурирования, Atlas поддерживает методы валидации: уникальность значений в определённых полях, создание объектов через bulk-операции и возвращение GUID-идентификаторов создаваемых артефактов. Это позволяет не только описать активы, но и программно управлять их жизненным циклом через API, а также обеспечивать консистентность между различными частями конвейера данных.
Расширение метаданных за пределами CDP: подключение внешних активов
Одной из ключевых целей SDX является возможность расширения метаданных так, чтобы охватить активы вне CDP. В реальных корпоративных ландшафтах данные разбросаны по множеству систем — транзакционные приложения, файлы в некодированном хранилище, внешние базы данных и сервисы. Atlas допускает интеграцию таких активов через настройку новых typedef'ов и сущностей, что позволяет строить сквозную картину «от источника до потребителя».
Реализация данного расширения строится на нескольких известных подходах:
- Определение внешних typedef. Если необходим актив, которого нет в предопределённом наборе, создаётся новый typedef, определяющий структуру и атрибуты внешнего актива. Такой подход позволяет привести к единой схеме описание активов, даже если они происходят из разных технологических стеков.
- Интеграция через REST API. Atlas предоставляет endpoints v2 для создания typedefs и сущностей, что позволяет автоматизировать импорт метаданных из внешних систем. В рамках проекта можно автоматизировать процесс синхронизации при помощи скриптов и конвейеров CI/CD.
- Асинхронная доставка через Apache Kafka. Для обеспечения устойчивости и масштабируемости Atlas может принимать события через Kafka, что особенно полезно при частых изменениях метаданных и необходимости синхронно обновлять каталоги.
- Использование существующих конвенций. При подключении внешних активов критично сохранить согласованность: единые ключевые поля, такие как qualifiedName, доступ к атрибутам, связи между сущностями и классификациями должны сохраняться. Это обеспечивает корректную привязку внешних активов к внутренним и позволяет прослеживать влияние изменений на весь конвейер данных.
Расширение за пределы CDP особенно ценное, когда предприятие стремится к единым стандартам управления данными в условиях растущего числа источников. Atlas как гибкий и настраиваемый фреймворк обеспечивает такую расширяемость без жёсткой привязки к конкретной конфигурации CDP, поддерживая эволюцию архитектуры управления данными на протяжении времени.
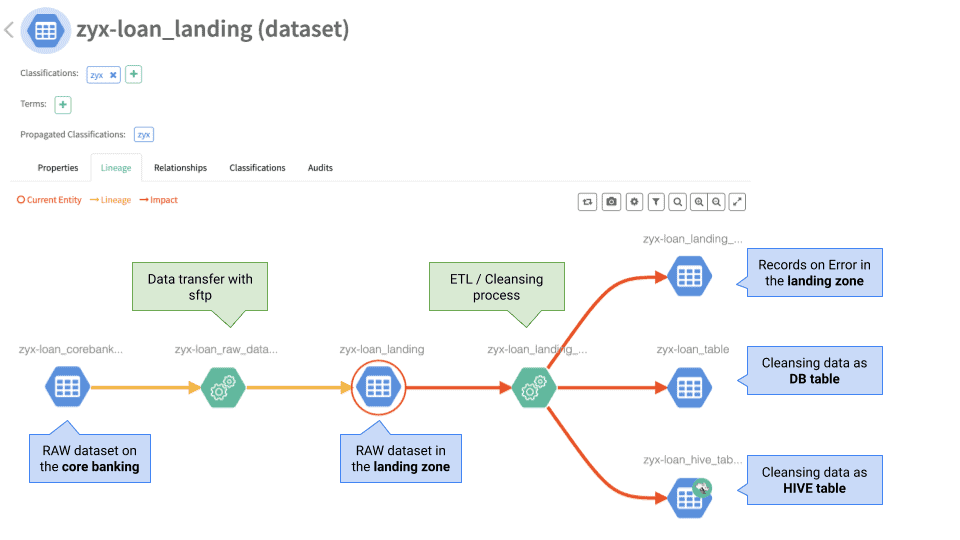
Декомпозиция технических компонентов: взаимодействие типов, сущностей и классификаций
Чтобы полноценно воспользоваться преимуществами Atlas, полезно разложить архитектуру на взаимодействующие слои и понять, как типы, сущности и классификации связаны между собой.
- Типы (typedefs) — шаблоны, определяющие структуру и поведение активов. Каждый typedef может наследоваться от супертайпа, формируя иерархическую модель. В результате получаем древовидную схему, которая упрощает управление и поиск активов.
- Сущности (entities) — конкретные экземпляры typedef. Они относятся к артефактам инфраструктуры и данных: серверы, базы данных, таблицы, файлы, наборы данных и т. д. Каждый объект имеет набор атрибутов и может связываться с классификациями.
- Классификации — семантические ярлыки, применяемые к сущностям. Это инструмент для описания контекста и требований к данным: например, указывает, что актив может содержать PII (персональные данные, personally identifiable information) или относится к конкретному приложению. Классификации позволяют быстро агрегировать активы по смысловым признакам и поддерживают управление политиками.
- Взаимодействия и связи — сущности могут быть связаны между собой через атрибуты и через классификации. Пример: сервер связан с набором данных, набор данных — с таблицей Hive, а в рамках процессов ETL между этими активами возникают связи, которые отражают поток данных.
Взаимосвязи междуtypes, entities и classifications создают сетку зависимостей и контекст, необходимый для анализа влияния изменений в конвейерах. Например, изменение версии сервера может повлиять на любой шаг, который зависит от данного сервера в пайплайне данных. Отчёт о воздействии изменений, регуляторный аудит и анализ последствий — все эти сценарии становятся выполнимыми благодаря связностям между типами, сущностями и классификациями.
Ключевым элементом в работе является идентификация уникальных ключей. Atlas опирается на уникальность значений атрибутов в рамках typedef: при попытке вставки элемента с уже существующим значением, происходят обновления существующего объекта. Это поведение обеспечивает целостность идентификаторов и упрощает миграцию данных, а также позволяет восстанавливать цепочки изменений в случае отклонений.
В рамках реализации примеров с ETL-пайплайнами мы часто сталкиваемся с необходимостью привязать к классификации активы, относящиеся к одному приложению, что позволяет видеть полный набор артефактов, связанных с конкретным бизнес-кейсом. Эти связи служат фундаментом для анализа последствий изменений, планирования технического обслуживания и аудита в рамках корпоративной политики управления данными.
Теоретическая база управления метаданными: модели данных, онтологии и стандарты
Управление метаданными опирается на сложную теоретическую базу, включающую модели данных, онтологию и международные стандарты. В этом разделе рассмотрим общие концепции и принципы, которые лежат в основе практик Atlas и SDX, с акцентом на связь между концепциями и практическими механизмами реализации.
- Модели данных. Существуют различные парадигмы описания информации: реляционные модели, графовые модели, документы и ключ-значение, которые применяются в зависимости от типа активов. Atlas формирует модель на основе объектов (entities) и атрибутов с иерархической структурой typedefs, что позволяет моделировать сложные зависимости и иерархии объектов. В реальном сценарии это означает, что можно описать инфраструктурные элементы, данные, процессы и события в единой системе, организовав их иерархически и через связи.
- Онтологии и семантика. Для повышения уровня интероперабельности и использования семантики в управлении данными применяются подходы онтологий: формализация понятий и их отношений, способность выводить новые знания из имеющихся данных. В контексте Atlas онтологический подход проявляется через иерархию typedefs, типизацию объектов и классификаций, которые дают смысл активам и их связи.
-
Стандарты. Существуют международные и отраслевые стандарты управления метаданными, которые полезно учитывать при формализации требований:
- ISO/IEC 11179 — общепринятый стандарт для реестров метаданных, определяющий форматы описаний и управление словарём данных.
- DCAT (Data Catalog Vocabulary) — спецификация для описания наборов данных в каталогах, обеспечивающая совместимость между системами каталогов.
- W3C PROV — модель для описания происхождения данных, которая помогает формализовать lineage и traceability в рамках графовых зависимостей.
- Другие отраслевые регионы и нормы могут предлагать дополнительные требования к описанию активов, прослеживаемости и безопасности.
Эти концепции позволяют выстраивать теоретическую основу, на которой строится практическая реализация в Atlas и SDX. В частности, сочетание онтологического подхода и формального управления метаданными обеспечивает устойчивость к изменениям архитектуры и требованиям к достоверности данных, что особенно важно в регламентируемых секторах, таких как финансы и здравоохранение. В контексте CDP/SDX эти концепты применяются через унифицированную модель метаданных, которой соответствуют реальный набор активов, их атрибуты, связи и политики доступа.
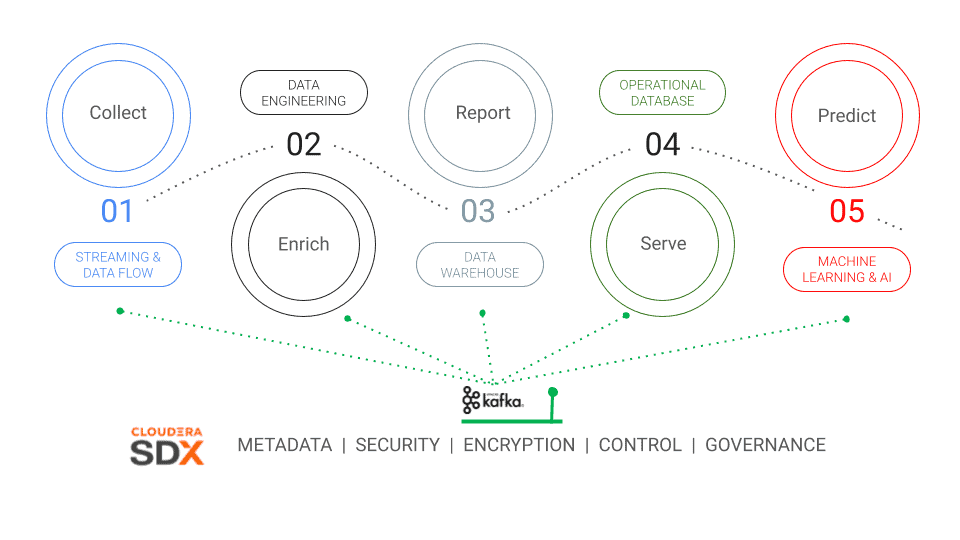
Кейсы применения: сквозная прослеживаемость и сценарии ETL пайплайна
Одной из ключевых практических задач является построение сквозной прослеживаемости по данным — «lineage» — и корреляции между активами на разных этапах ETL-пайплайна. Рассмотрим распространённый сценарий, типичный для финансового и банковского контекста, где необходимость прослеживаемости особенно критична.
Исходная система генерирует данные в виде CSV-файлов и помещает их в хранилище вне Hadoop (например, локальные файловые системы или облачные хранилища). Затем ETL-процесс читает файл, выполняет проверки качества данных и загружает валидные записи в СУБД и в Hive. Ошибочные записи сохраняются в отдельной очереди или файле ошибок.
Чтобы запечатлеть сквозной поток данных в Atlas, необходимы следующие элементы метаданных:
- typedef для Hive-таблиц (table-like активы уже присутствуют в CDP через предустановленный набор Atlas).
- typedef для серверов и наборов данных (server datasets) — это позволяет моделировать инфраструктуру и пути передачи данных.
- typedef для набора колонок (col_schema) — описание структуры данных внутри таблиц.
- классификации — для привязки к приложениям и сценариям использования, например, классификация xyz для артефактов, связанных с конкретным приложением.
Определение и создание самих сущностей:
- Создать субъект сервера (server) с атрибутами: описание, владелец, qualifiedName, имя, host_name, ip_address, zone, platform, rack_id.
- Создать сущность dataset для конкретного набора данных с атрибутами: описание, qualifiedName, имя, директория файла, частота обновления, владелец, формат, ссылка на сервер, схема колонок (col_schema).
- Привязать к классификации (например, xyz), которая будет относиться к соответствующему приложению.
Примерные операции по созданию и связыванию:
- Через REST API Atlas v2 доступны endpoints для создания typedefs, сущностей и классификаций.
- После создания сервера и набора данных можно создавать связи между ними и между процессами передачи данных (transfer) и загрузки данных (etl_load).
- Процессы передачи данных и загрузки данных описываются как отдельные сущности типа data flow, которые связывают исходные и целевые активы. Это обеспечивает прозрачность и позволяет проследить, как данные перемещаются через конвейер: от источника к целевой таблице в Hive или базе данных.
В частности, описанный сценарий демонстрирует возможность построения сквозной линии: от транзакционного приложения в банковской системе до Hive-таблиц и дальнейшего использования в аналитических пайплайнах, с учётом обработки ошибок и отслеживания зависимостей между активами. Важной частью такого подхода является использование классификаций, которые позволяют связать активы с конкретным приложением или бизнес-процессом. Классификации дают возможность оперативно фильтровать активы по бизнес-контексту и использовать их в рамках политики безопасности и аудита.
Таким образом, Atlas даёт методическую основу для описания и связывания активов, а также предоставляет средства для реализации сквозной прослеживаемости и управления активами в рамках ETL пайплайна. Этот подход позволяет организациям более точно отслеживать последствия изменений, быстро выявлять потенциальные точки отказа и улучшать качество данных на каждом этапе конвейера.
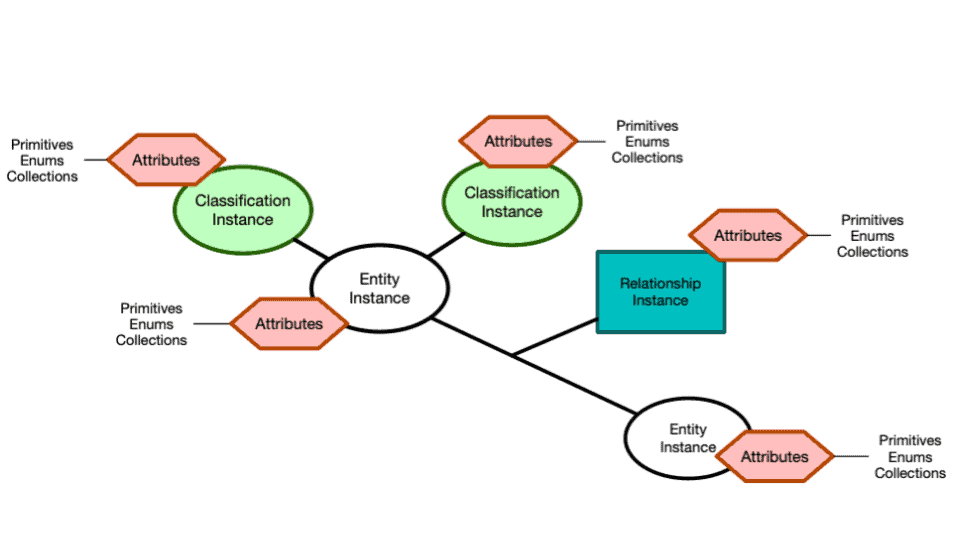
Интеграция технологических стеков: синергия CDP, Hadoop/Hive, Kafka и REST API
Универсальность Atlas и Ranger в контексте CDP заключается в способности работать с различными технологическими стеком и обеспечивать единые принципы управления и защиты данных. В рамках интеграции CDP с Hadoop/Hive, Apache Kafka и REST API можно выстраивать следующие механизмы:
- Связанные сервисы и хранилища. CDP включает в себя компоненты Hadoop/Hive, которые являются ключевыми хранилищами для больших объёмов данных. Atlas позволяет описать и каталогизировать эти активы на основе предопределённых typedefs, обеспечивая единый доступ к метаданным и прослеживаемость.
- Асинхронная интеграция через Apache Kafka. Для надёжной передачи изменений и уведомлений между Atlas и другими компонентами SDX могут использоваться таск-слоты через Kafka. Atlas предоставляет хук‑интерфейсы и сценарии, которые опираются на Kafka как транспортный уровень. Это обеспечивает устойчивость к сбоям и масштабируемость управления метаданными.
- REST API Atlas v2. Взаимодействие с Atlas может осуществляться через REST API, что упрощает интеграцию с внешними системами и автоматизацию процессов управления метаданными. Документация по REST API позволяет создавать typedefs, сущности и классификации, обновлять и удалять их, а также выполнять поиск и извлечение информации.
- Docker-окружение для быстрого старта. В целях быстрой апробации и начального обучения можно развернуть Atlas в локальном окружении через Docker. Примеры образов и команд, упомянутые в руководствах, позволяют быстро получить рабочее окружение для тестирования сценариев и в дальнейшем перенести их в продакшн.
Эта интеграционная связка обеспечивает не только единое отображение активов, но и единый контекст для анализа и управления рисками на фоне растущей сложности инфраструктуры. Важным является понимание того, что Atlas не заменяет существующие системы, но служит центральной локацией для их описания и синхронизации, а Ranger обеспечивает единый механизм контроля доступа и аудита в рамках этого контекста.
Управление классификациями: создание классификаций, привязка к активам и приложениям
Классификации служат для добавления смыслового контекста к активам и позволяют гибко организовывать сведения о данных и их использования. В Atlas классификации могут создаватьcя на основе предопределённых и пользовательских типов, а привязка к активам осуществляется через связки с сущностями.
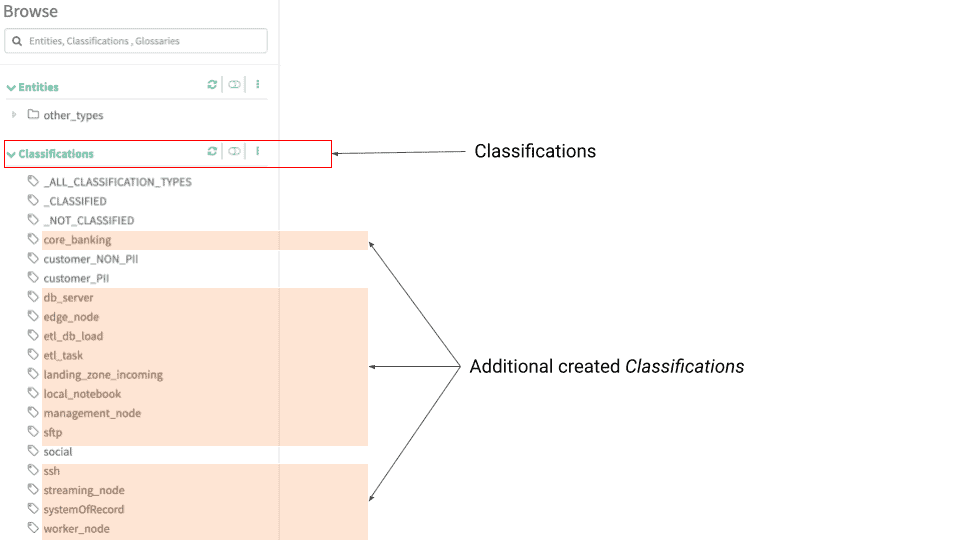
- Создание классификаций. В практических сценариях часто требуется определить уникальные классификации для отдельных приложений или проектов. Например, можно определить классификацию xyz как метку для активов, связанных с конкретным приложением, и указать её через соответствующий typedef. Так же может быть создана классификация для пометки процессов, связанных с передачей данных и загрузкой в целевые хранилища.
- Привязка к активам. После создания классификации можно привязать её к соответствующим сущностям: серверам, наборам данных, таблицам и прочим активам. Это позволяет быстро представить, какие активы относятся к конкретному приложению, бизнес-процессу или среде, что существенно облегчает аудит и управление рисками.
- Расширение контекста через классификации. Классификации могут быть использованы не только для пометки активов, но и для описания параметров процессов, характеристик таблиц, уровней доступа и ответственных лиц. Такие расширения контекста позволяют строить более точные политики и проводить регуляторные проверки с минимальными затратами времени.
- Пример. В рамках ETL пайплайна можно создать классификацию, такой как xyz, и привязать её к всем активам, которые относятся к конкретному приложению. Это обеспечивает единый контекст и упрощает поиск и анализ активов в рамках проекта.
Создание и привязка классификаций осуществляются через API Atlas и поддерживают интеграцию их в сценарии конвейера данных. В реальном мире грамотное управление классификациями существенно повышает прозрачность данных, улучшает соответствие требованиям и облегчает общую операционную эффективность.
Анализ рисков и ограничений: метрики эффективности, полнота охвата, безопасность
Построение эффективной стратегии управления метаданными требует не только реализации архитектурных решений, но и системного подхода к оценке рисков, полноты охвата и безопасности. В этом разделе рассмотрим базовые принципы и демонстрируем, какие метрики и практики используются для контроля качества и устойчивости.
- Метрики эффективности. Ключевые индикаторы включают скорость обновления метаданных, точность классификаций, консистентность данных между источниками и уровень прослеживаемости. Эффективная система управления метаданными должна минимизировать временной разрыв между изменениями и их отражением в Atlas, обеспечивая оперативное обновление в рамках конвейеров.
- Полнота охвата. Важной характеристикой является охват активов в каталоге. В контексте CDP и SDX необходимо стремиться к максимальному покрытию как внутренних активов (Hive-таблицы, сервера, процессы), так и внешних активов за пределами CDP. Оценка полноты позволяет определить «слепые зоны» в управлении данными и определить план расширения набора typedef и конфигураций для внешних источников.
- Безопасность и соответствие. Atlas и Ranger работают в связке для обеспечения безопасности управления данными. Важно обеспечить наличие политики соответствия, включая защиту PII, управление доступом на основе ролей и аудит изменений. Безопасность должна учитываться не только в плане доступа к данным, но и в плане изменений в описаниях и структурах метаданных.
- Риск лицензирования и совместимости. При интеграции внешних активов следует учитывать совместимость форматов метаданных, требования к версии API, совместимость версий Atlas и Ranger, а также возможные зависимости от внешних систем и обновлений.
Эти аспекты требуют систематического подхода к мониторингу и управлению, а также включения метрик в процессы управления изменениями. В рамках проекта по внедрению Atlas и Ranger рекомендуется внедрить набор KPI для мониторинга эффективности SDX и обеспечения устойчивой поддержки бизнес-процессов.
Практика развертывания: Docker-окружение, шаги внедрения typedefs и entities
Практическая реализация управления метаданными в Atlas начинается с развёртывания окружения и поэтапного внедрения typedefs, сущностей и классификаций. Ниже приведены общие принципы и шаги, которые применяются на практике. Описанные в источнике шаги можно адаптировать под конкретную среду и требования.
-
Развёртывание Atlas. Для быстрой апробации можно использовать докер-образ Atlasa. Примерная последовательность:
- выполнить команду docker pull sburn/apache-atlas:latest
- запустить контейнер с настройками и портом доступа (обычно 21000)
- проверить работоспособность REST API Atlas через соответствующую точку доступа.
-
Создание typedef (типов). Предположительно используются предопределённые typedefы внутренне CDP, но можно создать внешние typedefs через JSON-запросы к API Atlas. В простом JSON-файле задаётся определение типа, например server, и на следующем шаге создаются сами типы через REST API v2: POST /api/atlas/v2/types/typedefs
-
Внесение typedefs через скрипты. Для ускорения внедрения применяется набор скриптов (например, create_typedef.sh), которые загружают typedefs в Atlas из файлов JSON и выполняют необходимые вызовы REST API. Это обеспечивает консистентность и ускоряет развёртывание для больших пайплайнов.
-
Создание сущностей (entities). После определения typedef'ов можно создавать сущности через API Atlas. Пример включает создание сервера (server) и набора данных (dataset) с соответствующими атрибутами. В случаях, когда уникальность полей поддерживается, Atlas возвращает GUID созданной сущности. Скрипты вроде create_entities_server.sh и create_entities_file.sh демонстрируют создание сущностей с привязкой к серверу и файлу/набору данных.
-
Проверка и валидация. После добавления типов и классификаций стоит проверить, что новые сущности доступны через API и корректно привязаны к классификациям. Это можно сделать через вызовы bulk-entity endpoints и просмотр возвращённых GUID-идентификаторов.
-
Поддержка классификаций. Для управления связями между активами и их контекстом можно создавать дополнительные классификации и привязывать их к сущностям. В качестве примера приводится создание классификации xyz, которая может быть связана с приложениями и активами конвейера данных.
-
Пример end-to-end. В одном из примеров приводится последовательность действий, где создаются уникальные классификации, сущности серверов, сущности датасетов, затем формируются процессы передачи данных и загрузки, которые образуют сквозную линию данных. Такой подход демонстрирует, как можно на практике выстроить прослеживаемость и управление потоками данных.
-
Верификация. На выходе развёртывания Atlas следует получать идентификаторы созданных объектов (GUID), которые можно использовать как входные данные для последующих операций и связей в конвейере.
Практика развёртывания требует аккуратности в настройке семантики typedef, обеспечении целостности атрибутов и корректной привязки к классификациям. Наличие зрелого набора скриптов и автоматизированных процедур существенно снижает риск ошибок и ускоряет внедрение. Важно помнить, что Atlas и Ranger функционируют как интегрированная система, где корректность определения типов и сущностей непосредственно влияет на качество lineage и на способность управлять политиками доступа по данным.
Влияние на экономические сектора: применение в финансах, здравоохранении, промышленности
Унифицированный подход к управлению метаданными в CDP/SDX имеет значимые практические последствия для нескольких ключевых отраслей, среди которых финансы, здравоохранение и промышленность.
- Финансы. В банковском и финансовом секторе требования к прослеживаемости, аудиту и безопасности данных особенно жесткие. Использование Atlas и Ranger позволяет построить полный путь происхождения данных, регуляторную прослеживаемость и контроль доступа к конфиденциальной информации. Применение классификаций, например для PII, позволяет быстро выявлять и защищать чувствительные данные, а также обеспечивать соответствие требованиям нормативно-правовой базы.
- Здравоохранение. В медико-биологических данных критично соблюдать требования к конфиденциальности и хранению персональной информации. С использованием Atlas можно описать структуру медицинских наборов данных, определить ответственных за данные и применить политики доступа на уровне ролей и проектов, что поддерживает требования к защите и регуляторность медицинской информации.
- Промышленность. В производственных и индустриальных организациях прослеживаемость производственных данных и связанных процессов становится критически важной для обеспечения качества, операционной эффективности и регуляторной совместимости. Atlas может описывать активы на уровне процессов, наборов данных, файлов, серверов и их связи, что позволяет строить глубокую картину потоков данных и анализировать влияние изменений на производственные линии.
Расширение охвата метаданными за пределы CDP помогает организациям обеспечить единый взгляд на корпоративные данные, повысить управляемость и ускорить принятие решений. Это особенно важно для компаний, которые работают в условиях многообразия источников и инструментов, а также под требования регуляторов. В таком контексте архитектура Atlas и Ranger становится необходимой частью стратегии цифровой трансформации, обеспечивая не только техническую реализацию, но и управляемый подход к данным как стратегическому ресурсу.
Конкурентный анализ решений: сравнение Atlas и аналогов, уникальные преимущества
При выборе инструментов и подходов к управлению метаданными предприятиям полезно сопоставлять Atlas с альтернативами и аналогами на рынке. Atlas — это открытая платформа, тесно интегрированная с экосистемой CDP и Ranger, что предоставляет ряд уникальных преимуществ:
- Гибкость и расширяемость. Atlas поддерживает добавление внешних активов и создание пользовательских typedef и сущностей, что позволяет подстроить каталог под конкретные бизнес-потребности и интегрировать сторонние источники.
- Глубокая интеграция с политиками безопасности. Совместная работа Atlas и Ranger обеспечивает единое место для описания метаданных и их защитных политик, что упрощает регуляторные проверки и аудит.
- Прозрачность lineage и контекста. Atlas обеспечивает полную сквозную прослеживаемость данных по конвейеру, включая источники, трансформации и потребителей. Это позволяет анализировать влияние изменений и управлять рисками на протяжении всего жизненного цикла данных.
- Поддержка открытых стандартов и активная экосистема. В рамках Atlas реализована поддержка REST API, что упрощает интеграцию с внешними системами и инструментами, а также существует обширное сообщество и документация, помогающая разворачивать решения и быстро настраивать новые активы.
- Соответствие стандартам и регуляторным требованиям. Atlas и Ranger позволяют реализовать политики контроля доступа, аудит и соответствия требованиям к данным, что особенно ценно для отраслевых кейсов, где регуляторные требования играют центральную роль.
В сравнении с аналогами, такими как отдельные каталоги данных или проприетарные решения управления метаданными, Atlas отличается открытостью, гибкостью и тесной интеграцией с экосистемой CDP. Это позволяет организациям реализовать единый подход к управлению данными на уровне предприятия, адаптируя решения к требованиям конкретного бизнеса и технологического стека.
Однако следует помнить, что выбор решения должен учитывать контекст организации, существующие системы, требования к безопасности и регуляторные ограничения. В некоторых случаях может быть целесообразно сочетать Atlas с дополнительными инструментами управления метаданными для обеспечения специфичных сценариев, требований к совместимости или специфических отраслевых стандартов.
Выводы и рекомендации: дорожная карта внедрения и будущие направления
Интеграция Atlas и Ranger в рамках SDX в CDP открывает широкие возможности для эффективного управления метаданными и обеспечения прослеживаемости во всей корпоративной экосистеме. В качестве итоговых рекомендаций по внедрению можно предложить следующие практические шаги:
- Начать с ядра CDP. Фокусироваться на управлении метаданными активов внутри CDP: Hive-тables, серверы CDP, предопределённые typedefы. Это создаёт базовую прочную основу и позволяет постепенно расширять охват на внешние активы.
- Построение единого набораtypedef и классификаций. Определить ключевые типы, атрибуты и поля, которые будут использоваться в рамках проекта. Создать классификации для приложений, рабочих процессов и чувствительных данных, чтобы обеспечить единый контекст.
- Интеграция внешних активов. Постепенно подключать внешние активы за пределами CDP, создавая соответствующие typedefs и сущности, поддерживая согласованность и структуру метаданных.
- Разработка стратегии lineage. Определить наиболее критичные сценарии прослеживаемости и обеспечить сбор и хранение необходимых связей между активами и процессами. Реализовать сценарии ETL и dataflow для сквозной прослеживаемости.
- Автоматизация и инструменты CI/CD. Внедрить скрипты и конвейеры для автоматического развёртывания typedefs, сущностей и классификаций, а также для проверки консистентности метаданных. Использовать REST API как основное средство интеграции.
- Метрики и мониторинг. Установить набор KPI для оценки полноты охвата, качества описания активов, времени реакции на изменения и эффективности контроля доступа. Регулярно проводить аудит и обновление политик доступа.
- Образование и компетенции. Разворачивать обучающие программы и методические материалы для аналитиков, архитекторов, руководителей data-направлений и ИТ-директоров, чтобы обеспечить единое понимание концепций метаданных, роли Atlas и Ranger, а также практик внедрения и эксплуатации.
- Постоянное развитие архитектуры. Рассматривать направления развития, например, углубление интеграции с Open Metadata инициативами, расширение поддержки дополнительных стандартов, учет регуляторных изменений и новые требования к безопасности.
- Экономическая состоятельность. Внедрять решения в рамках дорожной карты, которая учитывает бюджет, сроки и риски. Формировать планы миграции и апгрейдов, оптимизируя стоимость владения и поддерживая устойчивость через повторное использование активов и стандартов.
Дорожная карта внедрения должна быть выстроена пошагово и рассчитана на устойчивое развитие. Рекомендации включают: начать с CDP-активов, затем расширить охват на внешние активы, внедрить классификации и политики, а затем — развёртывание полного сценария прослеживаемости. Благодаря такому подходу можно достичь единой картины данных в организации, повысить качество данных, усилить безопасность и обеспечить соответствие регулятивным требованиям. В процессе следует уделять внимание взаимодействию архитекторов, аналитиков и ИТ-директоров, чтобы обеспечить согласование целей, бюджета и технической реализации.
Вопрос-Ответ
1. Вопрос: Что такое SDX и какая роль Atlas в SDX?
Ответ: SDX (Shared Data Experience) — это концепция унифицированного доступа к данным во всей экосистеме организации, объединяющая метаданные, управление и безопасность. Atlas в SDX выступает как центральный каталог метаданных, который хранит typedefs, entities и классификации, обеспечивает прослеживаемость и единый контекст для активов данных, а также служит точкой синхронизации между CDP и внешними источниками. Ranger дополняет Atlas, реализуя политики доступа и аудит, что позволяет организовать согласованное управление данными и защиту.
2. Вопрос: Какие элементы составляют модель Atlas?
Ответ: Основными элементами являются typedefs (определения типов), entities (сущности), classifications (классификации) и атрибуты. typedefs задают структуры активов, entities — конкретные объекты, classifications — дополнительные контекстуальные ярлыки, а атрибуты содержат детальное описание каждого актива.
3. Вопрос: Как Atlas поддерживает расширение за пределами CDP?
Ответ: Atlas поддерживает добавление внешних активов за пределами CDP через создание новых typedefs и сущностей, integration через REST API и, при необходимости, обмен сообщениями через Apache Kafka. Это позволяет строить сквозную карту данных, включающую активы из корпоративной ИТ-инфраструктуры, обеспечивая единый словарь понятий и сопоставимости.
4. Вопрос: Какие преимущества Atlas перед конкурентами?
Ответ: Основные преимущества включают гибкость и расширяемость, глубокую интеграцию с политиками безопасности через Ranger, обширную прослеживаемость lineage, поддержку открытых стандартов и REST API, а также возможность интеграции внешних активов в единый каталог, что облегчает регуляторный контроль и управляемость.
5. Вопрос: Какие шаги необходимы для внедрения typedefs и сущностей в Atlas?
Ответ: Необходимо начать с развёртывания Atlas, затем создать typedefs (для примера server и dataset), загрузить их через REST API, создать сущности и привязать их к классификациям, далее протестировать API и верифицировать созданные артефакты. После этого можно расширять набор typedefs и добавлять внешние активы, поддерживая синхронизацию с CDP.
6. Вопрос: Каковы ключевые шаги для построения сквозной проследуемости в ETL-пайплайне?
Ответ: Определить typedefs для серверов и датасетов, создать сущности и атрибуты, определить и привязать классификации, зафиксировать связь между источником и целевым активом через процессы передачи и загрузки (data transfer и etl_load), затем документировать lineage через Atlas и обеспечивать его актуальность через REST API и события Kafka.
7. Вопрос: Какие принципы следует учитывать при интеграции внешних активов?
Ответ: Важно обеспечить единый синтаксис и структуру метаданных, использование общих ключей (qualifiedName), сохранение совместимости атрибутов и типов, настройку корректных связей между внешними активами и внутренними, а также обеспечение безопасного обмена данными и политик доступа.
8. Вопрос: Какие отраслевые сценарии демонстрируют ценность управления метаданными Atlas и Ranger?
Ответ: Финансы, здравоохранение и промышленность — суть вопросов прослеживаемости, аудита и защиты конфиденциальной информации. Atlas и Ranger помогают обеспечивать соответствие регуляторным требованиям, управлять доступом к данным и организовывать единый контекст вокруг активов, процессов и приложений.


