

Хранение и поиск метаданных: база метаданных, индексация, поиск
OpenMetadata как платформа для управления метаданными строится на четком разделении слоев хранения и слоев индексации, что обеспечивает устойчивость к росту объёма данных и скорость доступа к информации. В рамках данной главы рассматриваются принципы хранения базы метаданных, архитектура индексирования и механизмы поиска, а также практики эксплуатации и интеграции в реальных условиях цифровой трансформации. Фокус — на том, как организовать единое корпоративное хранилище метаданных, как поддерживать эффективный поиск по этому хранилищу и как проектировать инфраструктуру так, чтобы она выдерживала требования к масштабируемости, согласованности и безопасности.
В рамках курса речь идёт о ключевых концепциях: от сущностей метаданных и их связей до механизмов индексации и запросов, которые позволяют быстро находить нужные активы, контекст и эволюцию данных. Понимание архитектуры хранения и подходов к индексации обеспечивает основу для построения устойчивой и прозрачной экосистемы данных, где метаданные являются активом предприятия, а не merely сопровождающим атрибутом процессов.
- Архитектура хранения и индексации: как организована база метаданных, где хранятся связи между активами и как организован индекс для быстрого поиска.
- Модель данных и эволюция схем: какие сущности существуют, как они связаны и как отслеживается изменения версий.
- Механизмы индексации и поиск: какие данные индексаируются, как устроены схемы индекса, какие алгоритмы ранжирования применяются.
- Интеграции и эксплуатационные сценарии: коннекторы к источникам, конвейеры инференса и обновления индекса.
- Практические паттерны эксплуатации: мониторинг, безопасность, бэкапы и управление изменениями.
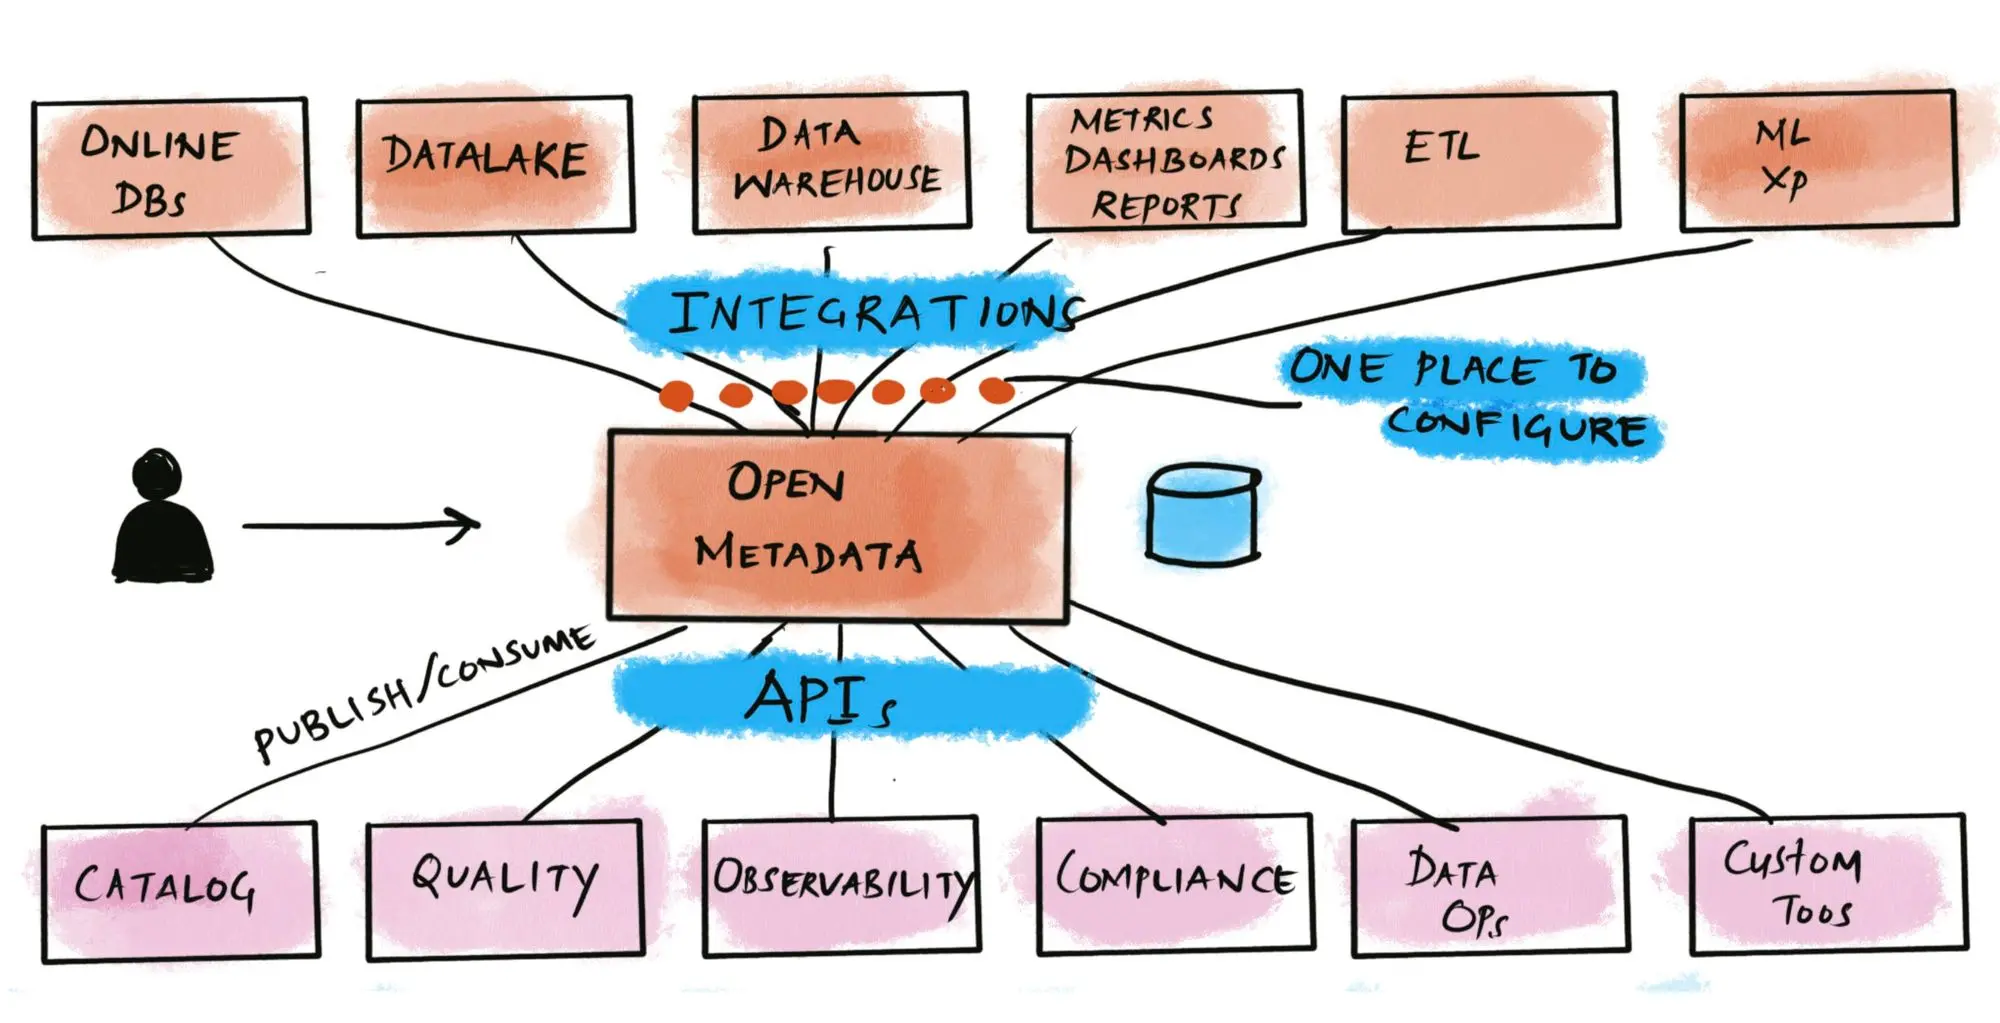
Архитектура хранения и индексации
У современного дата-каталога цель хранения метаданных — обеспечить единое источник истины для различных типов активов: баз данных, таблиц, столбцов, пайплайнов, дашбордов, моделей и словарей терминов. Архитектура опирается на разделение ответственности между тремя основными компонентами:
- базой метаданных как системой хранения сущностей, связей и истории;
- индексным слоем для быстрого полнотекстового и структурированного поиска;
- службой событий и конвейерами инференса, которые поддерживают синхронизацию между источниками и индексом.
Традиционная архитектура выглядит так: транзакционная база данных служит устойчивым источником истины, затем через механизм изменения данных (CDC, очереди сообщений) обновляется индекс. В игровых словах это сочетание обеспечивает две важные свойства: целостность данных и скорость доступа к ним через поиск.
Для хранения метаданных OpenMetadata часто применяет реляционную базу данных (PostgreSQL) как основной источник фактов и историю изменений. В качестве индекса используется поисковый слой на базе Elasticsearch/OpenSearch, который обеспечивает масштабируемый полнотекстовый поиск и фильтрацию. В дополнение к этим слоям применяются кэш-решения (например Redis) для снижения задержек на часто запрашиваемых полях и для ускорения операций автодополнения и подсветки результатов.
- Транзакционная база данных: обеспечивает согласованность сущностей, версий и отношений между ними. В ней хранятся данные о активах, их атрибуты, владельцах, тегах, отношениях зависимостей и истории изменений. Важной характеристикой здесь является поддержка версий объектов и аудита.
- Индексный слой: поддерживает быстрый поиск по именам, описаниям, тегам и другим текстовым полям, а также фильтры по метаданным свойствам (источник данных, тип актива, стадия обработки и т.д.). Индекс поддерживает агрегационные запросы и фасеты, что критично для пользовательских дашбордов и управления по категориям.
- Сервис интеграции и конвейеры: CDC-каналы, коннекторы к источникам, события об изменении метаданных и очереди, которые обеспечивают асинхронность между базой и индексом, минимизируя блокировки транзакций и задержки до фактического поиска.
Почему так нужно проектировать? Потому что хранение метаданных — это не одноразовое заполнение каталога, а постоянная эволюция. Табличная модель должна поддерживать версионирование, а поиск — обеспечивать своевременный доступ к актуальным данным, включая исторические варианты. Разделение слоев позволяет масштабировать и модернизировать каждый компонент независимо: обновлять схему базы, расширять индекс или менять конфигурацию коннекторов без нарушения общей функциональности.
- Соглашения об именовании и версиях: единая схема идентификаторов, поддержка версий и миграций схем. Это снижает риск конфликтов между различными источниками и конфигурациями.
- Согласованность и лимит времени обновления: чаще всего применяется eventual consistency между базой и индексом с разумно выставленными лимитами задержки, чтобы обеспечить высокую доступность поиска.
- Безопасность и доступ: в архитектуре должны быть чёткие механизмы аутентификации и авторизации на уровне API, а также политики доступа к данным и метаданным, чтобы индекс не раскрывал чувствительную информацию.
- Мониторинг и наблюдаемость: метрики задержек между источниками и индексом, частота обновления индекса, количество ошибок коннекторов и доля непроиндексированных объектов.
Модель базы метаданных и эволюция схем
База метаданных служит «сенд-волнением» для всего набора активов и их контекста. В рамках OpenMetadata ключевые сущности обычно включают: DataAsset (или Asset), Dataset/Table/Column, Pipeline/Job, Dashboard, GlossaryTerm, Tag, User, Team, Source и Relationship. Основной фокус — на связях между активами и контекстах их использования: provenance, lineage и ownership. Эволюция схемы — это ответ на рост различий между источниками и рост требований к контексту данных: новые типы активов, новые атрибуты, новые типы зависимостей.
- DataAsset и его подтипы: база метаданных должна поддерживать множество типов активов, включая базы данных, наборы данных, таблицы, представления и файлы. Атрибуты включают имя, описание, схему, кодировку, форматы, владельца, теговую структуру и метаданные об источнике.
- Схема и столбцы: каждый актив может иметь иерархическую структуру, где Dataset содержит Tables, Tables — Columns, а Columns — свойства типа данных, нестандартных ограничений и бизнес-атрибутов. Важна поддержка версий столбцов, чтобы отражать изменения во внешнем мире.
- Линейность и происхождение: lineage связывает активы в граф, показывая, как данные перемещаются от источника через пайплайны к потребителям. Этапы вычислительных пайплайнов и их параметры должны быть отражены в истории, чтобы можно было реконструировать цепочку трансформаций.
- Контекст и семантика: GlossaryTerm, Tags и Attributes создают слой смысла, который облегчает поиск и стандартизацию терминологии. Нормализация терминологии критична для масштабируемости и согласованности в больших организациях.
- Версионирование и аудит: каждое изменение в метаданных должно оставаться следом в истории. Это включает версии активов, изменений владения, модификаций схем, обновления линейности и обновления концепций.
- Безопасность и владение: в модели учитываются роли, подразделения и команды, чтобы определить доступ к активам и их контексту. Это особенно важно для чувствительных данных и проектов с регуляторными требованиями.
Эта модель поддерживает практику конфигурации и миграций: когда у источника появляются новые поля или меняется структура, соответствующая запись обновляется в базе метаданных, а индекс отражает эти изменения через конвейер обновления. Чем более структурированная и согласованная модель, тем проще осуществлять миграции, сравнивать версии и строить отчеты по эволюции данных.
- Уровень нормализации: баланс между нормализацией и денормализацией. В базе метаданных предпочтительно сохранять нормализованные данные, чтобы избегать дублирования и облегчать консистентность, но в индексе допускается денормализация для ускорения запросов к поисковым полям.
- Эволюционные паттерны: поддержка миграций схем, историй изменений и версий объектов. Важно обеспечить обратную совместимость и откат изменений в случае некорректной миграции.
- Аудит и прозрачность: каждое изменение должно сопровождаться записью об авторе, времени и причине, что позволяет аудит и соблюдение внутренних и внешних требований.
Индексация и поиск: архитектура, схемы, конфигурация
Индексный слой в OpenMetadata предназначен для быстрого и гибкого поиска по большому объёму метаданных. Это достигается за счёт сочетания полнотекстового поиска и структурированных фильтров, которые отражают бизнес-вопросы пользователей: «найди все датасеты, которые относятся к отделу продаж и подключены к определённой системе источника», или «помоги найти все таблицы, у которых чувствительные данные помечены тегом PII».
- Модель индекса: каждый актив базы метаданных приводится к документу в индексе, где текстовые поля (имя, описание, комментарии) индексируются как полнотекстовый контент, а структурированные свойства (тип актива, владелец, источник, теги, лицензии) индексируются как поля для фильтрации и агрегаций. Связи lineage могут индексироваться как графовые признаки или через повторное связывание документов.
- Аналайзеры и нормализация: для русского и английского текстов применяются анализаторы, лемматизация и стемминг, что увеличивает полноту поиска и устойчивость к различным формам слов. В рамках бизнес-систем возможно добавление синонимов и кастомных списков терминов.
- Фасеты и фильтры: поиск поддерживает расширенные фильтры по атрибутам: источник данных, тип актива, стадия пайплайна, теги, владелец, проект и т. д. Это позволяет быстро сузить круг результатов и построить дашборды по активности и качеству данных.
- Обновление индекса: обновление индекса выполняется через конвейеры событий, которые подписаны на изменения в базе метаданных. Это обеспечивает согласованность между источником и индексом и позволяетbackfill-процессам догнать пропущенные обновления.
- Ранжирование и релевантность: алгоритмы ранжирования учитывают релевантность по текстовым полям, популярность (количество упоминаний) и контекстуальную близость к поисковому запросу. Поддерживаются настройки административного уровня, позволяющие формировать поведение ранжирования под доменные задачи.
- Мониторинг индекса: критично monitorить задержки между изменениями в базе и обновлениями индекса, размеры индекса и частоту переполнения памяти. Нелинейные задержки приводят к несвоевременным результатам поиска, что негативно сказывается на продуктивности пользователей.
- Эффективность хранения: хранение индексированных данных должно быть экономичным и масштабируемым. Асинхронность обновления индекса и частоты обновлений позволяют уменьшать нагрузку на транзакционную базу данных и избегать блокировок.
Как готовить эффективные индексы? Правильная настройка маппинга и анализаторов определяет точность поиска. В крупных организациях целесообразно иметь разные индексы по доменным зонам (например, один индекс для активов, второй для пайплайнов и третий для словарей терминов) и механизм объединения результатов. Важно также предусмотреть резервное копирование индекса и стратегию тестирования изменений в конфигурации индекса, чтобы не ухудшать доступность поиска в продакшене.
- Пример конфигурации (на концептуальном уровне): индекс для активов может иметь поля id, name, description, type, source, owner, tags, created_at, updated_at, lineage. Другой индекс может включать поля для семантического поиска по терминологии и конфигурацию фасетов, например по проектам и отделам.
- Управление версиями индекса: когда структура индекса обновляется, следует поддерживать миграции индекса с минимальным downtime. Это достигается через временные индексы и плавную миграцию полей.
Интеграции и эксплуатационные сценарии
OpenMetadata рассчитан на широкую интеграцию с источниками метаданных и бизнес-процессами. Интеграционные конвейеры обеспечивают сбор и нормализацию метаданных из множества систем: баз данных, хранилищ, пайплайнов данных, BI-систем, инструментов визуализации и словарей терминов. Основные принципы интеграции и эксплуатации следующие:
- Коннекторы и источники: каждый источник определяется как сущность Source, с набором конфигураций подключения, расписания и набора метрик. Коннекторы покрывают работу с различными СУБД, файловыми системами, инструментами ETL/ELT, платформами визуализации и BI-инструментами. При проектировании следует учитывать совместимость версий, параметры безопасности и ограничения по API.
- Ингесторы и пайплайны: данные о метаданной инженерии поступают в систему через ingestion pipelines. Они могут быть реализованы через готовые коннекторы, расписания, обработку событий и обработку ошибок. Важной частью являются проверки качества данных в процессе инференса и механизм отката при выявлении ошибок.
- Управление качеством данных в метаданных: помимо технического соответствия источнику, важно отслеживать качество метаданных через правила валидации, полноту описаний, корректность линейности и актуальность терминологии. Это позволяет поддерживать уровень доверия к каталогу и упрощает эксплутацию.
- API и контрактные интерфейсы: OpenMetadata предоставляет REST API и, в ряде случаев, GraphQL-фасад для удобной интеграции с внешними системами и внутренними сервисами. Контракты API следует проектировать так, чтобы они оставались стабильными при обновлениях инфраструктуры и изменений в схемах данных.
- Безопасность и соответствие: для корпоративного использования критично внедрить RBAC/ABAC, управление секретами и сетевые политики. Метаданные часто включают чувствительные данные, поэтому важно отделять доступ к самим данным от доступа к описаниям и атрибутам, чтобы не нарушать принципы least privilege.
- Мониторинг и операционная устойчивость: наблюдение за состоянием коннекторов, производительностью индекса, задержками синхронизации и качеством данных в источниках. Логирование ошибок, алертинг и ретрай-политики являются неотъемлемой частью надёжной эксплуатации.
- Миграции и обновления: при эволюции схем и добавлении новых типов активов следует планировать миграции базы метаданных и индекса, тестировать их на стендах и вводить поэтапно в продакшн, чтобы минимизировать риск отключения функциональности.
Практические сценарии внедрения включают создание единого реестра активов для отдела, который объединяет данные из нескольких систем: СУБД корпоративного уровня, пайплайнов и дашбордов. Такая интеграция облегчает поиск, управление изменениями и повышение ответственности за качество данных. В процессе эксплуатации важно поддерживать баланс между скоростью обновления индекса и точностью представления информации в каталоге, чтобы пользователи не сталкивались с несоответствиями в реальном времени.
- Управление источниками: рекомендуется начать с набора критических источников и постепенно расширять их, чтобы минимизировать риск перегрузки инфраструктуры и усложнения конфигураций.
- Этапы внедрения: сначала определить базовую модель активов и линейности, затем настроить индекс и конфигурацию поиска, после чего внедрить конвейеры инференса и проверки качества, и только затем расширять набор источников и терминологий.
- Управление конфигурациями: хранение конфигураций коннекторов и правил обработки в управляемой системе конфигураций, чтобы обеспечить повторяемость развёртываний и упрощение восстановления после сбоев.
Практические паттерны эксплуатации и паттерны разработки
В эксплуатации и внедрении стоит придерживаться практических паттернов, которые обеспечивают надёжность, масштабируемость и управляемость:
- Разделение окружений: dev, test, prod — с синхронизированными версиями конфигураций и схем. Это позволяет тестировать изменения на непродукционных данных и снижает риски при развёртывании.
- Поддержка резервного копирования и восстановления: регулярно выполнять резервное копирование базы метаданных и индекса, а также тестировать процедуры восстановления. В диаграмме архитектуры важно иметь экосистему репликации и точку восстановления для индекса.
- Мониторинг согласованности: метрики задержек между изменениями в базе и состоянием индекса, процент обновлений, ошибки миграций и частота отклонений. Важно быстро выявлять проблемы и автоматически откатывать некорректные обновления.
- Безопасность и комплаенс: определение политик доступа, аудит действий и контроль за тем, какие данные могут быть индексаированы и индексированы в определенных контекстах. В условиях регуляторных требований это критично для соответствия законам и внутренним политикам.
- Миграции и обратная совместимость: при изменении структуры объектов следует планировать миграции и обеспечивать обратную совместимость, чтобы существующие потребности пользователей не подвергались риску.
- Архитектурная эволюция: по мере роста объёмов метаданных и числа источников может потребоваться переход к горизонтальному масштабированию индекса, оптимизация конвейеров обработки и внедрение дополнительных слоёв кэшей. В отдельных случаях возможно введение параллельной архитектуры для обработки тяжёлых нагрузок.
Key takeaways
- Базовый принцип: хранение метаданных разделено на транзакционную базу и индекс, что обеспечивает целостность фактов и быструю навигацию по ним.
- Модель данных должна поддерживать версионирование и линейность, чтобы можно было реконструировать цепочки трансформаций и отследить эволюцию бизнес-терминологии.
- Индексный слой обеспечивает полнотекстовый поиск и структурированную фильтрацию, что позволяет пользователям быстро находить активы и контекст по бизнес-задачам.
- Интеграции и конвейеры инференса должны быть построены как повторяемые и управляемые процессы, способные покрывать новые источники и изменяющиеся требования.
- Безопасность, аудит и мониторинг являются краеугольными камнями устойчивого использования каталога метаданных в больших организациях.
- Эволюцию схем следует сопровождать миграциями, тестированием и откатами, чтобы сохранить надёжность среды людей и процессов.
- Планирование окружений, резервирования и управление изменениями помогает снизить риски внедрения и повысить общую устойчивость архитектуры.
FAQ
1) Что такое базовый функционал OpenMetadata в контексте хранения метаданных?
- В базовом функционале OpenMetadata реализуется единое хранилище метаданных, где сохраняются сущности активов, их атрибуты, владение и связи. Дополнительно существует индексный слой для быстрого поиска и фильтрации по этим данным. Архитектура строится так, чтобы данные можно было легко масштабировать как по объёмам, так и по количеству источников, а поиск — оставался быстрым и точным в любых условиях.
2) Как обеспечивается согласованность между базой метаданных и индексом?
- Согласованность достигается через асинхронные, но надёжные конвейеры изменений: события об изменении в базе отправляются в очередь, из которой индексу поступает обновление. Это обеспечивает высокую доступность базы и гибкость индекса, минимизируя риски блокировок транзакций. При необходимости возможны периодические батчи для окончательного выравнивания состояний.
3) Какие типы активов поддерживаются и как обрабатываются их связи?
- Поддерживаются базы данных, таблицы, столбцы, пайплайны и дашборды, словари терминов, теги и роли. Связи, такие как lineage между источниками и потребителями данных, владелец/группа и зависимости между пайплайнами, моделируются как графовые связи в метаданных и отражаются в индексе для быстрого вывода контекста и зависимости.
4) Как устроен поиск и какие методы ранжирования применяются?
- Поиск строится на полнотекстовом анализе текстовых полей и структурированных фильтрах. Ранжирование учитывает релевантность текста, частоту появления терминов и доверие к источнику. Фасеты и агрегации позволяют строить фильтры по проекту, источнику, тегам и другим атрибутам, что упрощает навигацию по большому набору активов.
5) Какие практики эксплуатации особенно важны на больших организациях?
- Важны дисциплины управления конфигурацией и миграций, мониторинг задержек инактивации обновлений, тестирование изменений в стенде перед развёртыванием в продакшн, аудит действий и управление доступом, а также планирование резервирования и восстановления. Эти практики обеспечивают устойчивость и безопасность каталога.
6) Как OpenMetadata интегрирует новые источники данных?
- Интеграция новых источников реализуется через коннекторы и ingestion-пайплайны. Источник определяется как сущность Source с параметрами подключения, расписанием и правилами обработки. Новые источники проходят через конвейеры инференса, где данные нормализуются и индексируются, после чего становятся доступны в поиске и API.
7) Какие риски следует учитывать при проектировании архитектуры хранения и индексации?
- Основные риски — задержки обновлений между базой и индексом, несогласованность между источниками, перегрузка индекса и сложность миграций схем. Их минимизируют через горизонтальную масштабируемость, стратегию backfill, тестирование в стендовой среде, чёткие политики доступа и резервирования, а также мониторинг ключевых метрик производительности.
8) Может ли архитектура поддерживать регуляторные требования и аудит?
- Да. В архитектуре предусмотрено хранение аудита изменений, версий активов и ролей. Это позволяет проводить аудиты по времени, отследить, кто и какие изменений внес, и обеспечить соответствие требованиям к прозрачности процессов и управлению данными.
9) Какую роль играет кеширование в архитектуре хранения и поиска?
- Кеширование снижает задержки на часто запрашиваемых полях и ускоряет ответы на запросы, особенно для повторяющихся сценариев поиска. Однако кеши должны быть согласованы с источниками, чтобы не допускать устаревания данных. Правильная политика времени жизни кеша и инвалидации критична для обеспечения консистентности.
10) Какие практики рекомендуется применить при масштабировании индекса?
- При росте объёма данных и числа источников следует рассмотреть горизонтальное масштабирование индекса, разделение индекса по доменным зонам и использование кластерных решений Elasticsearch/OpenSearch с репликациями. В дополнение — оптимизация маппинга, настройка analyzers и регулярная чистка устаревших данных, чтобы сохранить производительность и управляемость.
Глава охватывает критические аспекты хранения и поиска метаданных в контексте OpenMetadata: от физической архитектуры и моделей данных до реализаций индексации и эксплуатационных практик. Правильная реализация этих принципов обеспечивает единое пространство для хранения контекста данных, ускоряет поиск и упрощает управление данными на уровне предприятия, что особенно важно в условиях растущих объемов данных, множества источников и требований к прозрачности и ответственности.


