

Конкурентность и управление транзакциями: optimistic concurrency и блокировки
Iceberg проектирует транзакции на уровне таблицы так, чтобы поддерживать консистентность данных в условиях параллельных записей и множественных источников изменений. В этой главе рассматриваются основы конкурентности в Data Lake на базе Iceberg, механизмы оптимистической конкуренции, а также подходы к блокировкам и координации записей в распределённых окружениях. Рассматриваются архитектурные принципы, алгоритмы контроля версий метаданных, а также практические сценарии интеграции в потоковую и пакетную аналитику.
В условиях больших команд и разнообразных пайплайнов данных важна предсказуемость поведения систем при конфликтах и четкость механизмов восстановления после ошибок. Именно здесь Iceberg предлагает целостный подход: транзакции основаны на снимках таблицы и списках манифестов, проверки конфликтов выполняются на этапе commit, а повторные попытки и координация записей позволяют сохранить высокую пропускную способность без ущерба для консистентности.
- Краткое содержание главы
- Архитектура транзакций Iceberg и концепции версионирования метаданных
- Модель optimistic concurrency control и процедура commit
- Блокировки и координация записей: когда они нужны и как реализуются
- Применение на практике: интеграции с Spark, Flink, и стратеги обработки конфликтов
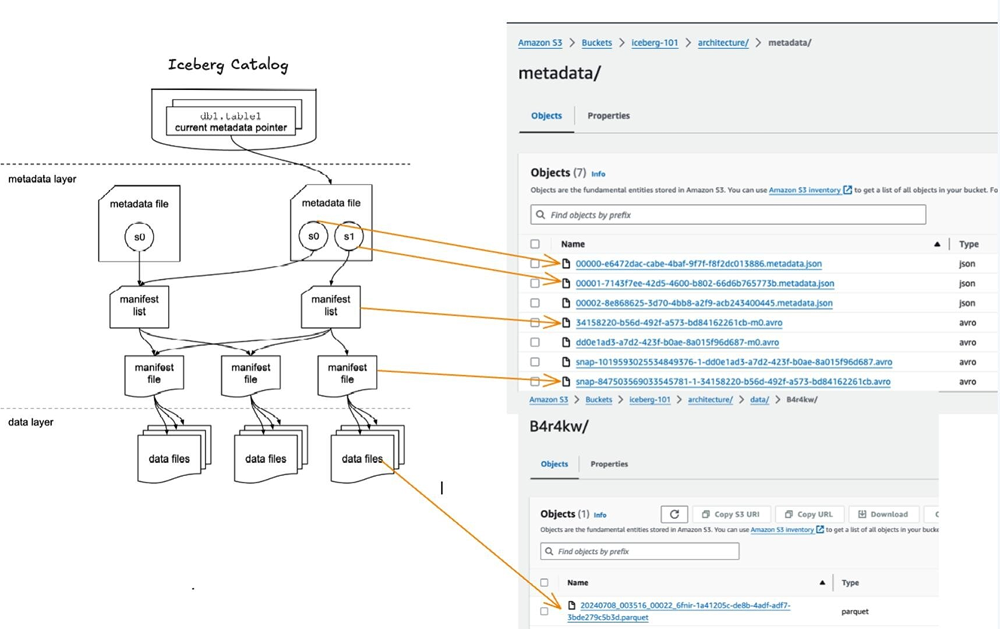
Архитектура транзакций Iceberg
Архитектура транзакций Iceberg строится вокруг версионирования метаданных таблицы и управления наборами данных через снимки и манифесты. Каждый commit приводит к созданию нового снимка, который ссылается на обновлённые данные и новые manifest-файлы. В основе лежит принцип Snapshot Isolation: чтение данных одной транзакцией не требует блокировок на чтение, в то время как записи — через протокол согласования — достигают атомарности на уровне таблицы.
Ключевые элементы:
- metadata.json: версия метаданных таблицы, которая фиксирует состояние после каждого commit.
- manifest-файлы: списки файлов данных и их статистики, используемые для построения снимков.
- snapshot: изображение состояния таблицы после конкретного commit, связывающее данные и манифесты.
- transaction log (метаданные транзакций): служит источником правдоподобной истории изменений для восстановлений и аудита.
Эти компоненты позволяют поддерживать целостность в условиях параллельной загрузки данных, когда несколько потребителей или производителей пытаются обновить таблицу практически одновременно. В Iceberg обработка изменений идет через атомарную операцию commit: набор файлов и метаданных, составляющих новый снимок, пишется в устойчивое хранилище, и только затем становится доступным всем читателям.
Важно отметить, что прозрачность метаданных и неизменяемость файлов данных позволяют разделить функции чтения и записи. Читатели продолжают видеть консистентный снимок таблицы, пока обновления записываются и становятся видимыми лишь после завершения commit. Такая схема снижает вероятность частичных изменений и упрощает ретроспективную реконструкцию состояния данных.
- В контексте реализации важно понимать роль внешних хранилищ метаданных и способ их устойчивого обновления: запись новых metadata.json и связанных с ним файлов выполняется в атомарном формате, чтобы прервать возможность частичного состояния.
Модель оптимистичной конкуренции (OCC)
Оптимистичная конкуренция отражает парадигму, при которой транзакции предполагают отсутствие конфликтов до момента commit. В Iceberg OCC реализуется через проверку целостности базового снимка во время операции commit и повторное применение изменений только при отсутствии изменений, которые могли бы повлиять на результаты планирования.
Основные принципы OCC в Iceberg:
- Чтение: клиент загружает текущий снимок таблицы и планирует изменения на его основе.
- Планирование: изменённые данные и обновления манифестов формируются в локальном контексте.
- Commit: клиент пытается записать новые metadata и обновления в хранилище, используя базовый снимок, полученный на этапе чтения.
- Конфликт: если базовый снимок или связанные метаданные изменились с момента чтения, commit завершается ошибкой конфликтной ситуации.
- Повторная попытка: после обновления локального состояния клиент повторяет процесс с учётом последних изменений.
Механизм проверки конфликта обычно реализуется через сравнение идентификатора базового снимка (baseSnapshotId) или версии metadаta с тем, что уже зафиксировано в хранилище. Если они не совпадают, система сообщает об ошибке CommitFailedException, и процесс повторяется после перезагрузки актуального состояния таблицы. Такой подход обеспечивает высокий уровень параллелизма в сценариях многократной записи и минимизирует задержки, когда конфликты редки.
Псевдокод процесса commit в OCC:
- считать текущий снимок таблицы: currentSnapshotId
- вычислить новый снимок и манифесты на основе изменений: newSnapshotId
- попытаться записать новый metadata.json и манифесты параллельно
- если во время записи обнаруживается, что currentSnapshotId изменился на другой процессом записи, откатить и повторить процесс после refresh
Эта модель удобна в сценариях, когда множество writers работают параллельно и конфликты возникают нечасто. Однако в условиях высокой конкуренции и узких конкурентных участков данных можно столкнуться с повторными конфликтами, что требует политики ограничений частоты повторных попыток, стратегий backoff и наблюдения за уровнем конфликтности.
- Для реализации OCC важно минимизировать вероятность ложного конфликта: аккуратно моделируйте reads-before-writes, избегайте длинных транзакций и держите план изменений как можно более локальным и детализированным.
Пример протокола commit с OCC
1. writer читает таблицу и получает baseSnapshotId и текущие метаданные.
2. writer строит план изменений: какие файлы добавить, какие удалить, какие манифесты обновить.
3. writer пытается записать новую metadata.json и связанные файлы в стабильное хранилище.
4. База данных/хранилище проверяет: текущий baseSnapshotId совпадает с тем, что было прочитано на шаге 1.
5. Если совпадает, commit завершается успешно; создаётся новый снимок и новые манифесты.
6. Если не совпадает, commit отклоняется с кодом конфликта; writer должен refresh state и повторить процесс.
Этот протокол демонстрирует базовую логику OCC: предотвращение непоследовательных изменений посредством проверки на этапе commit. Реальная реализация в Iceberg включает механизмы сериализации манифестов, эффективное обновление metadata и обработку ошибок сетевых или временных сбоев, но общая идея одна: не допускаем скрытых противоречий в состоянии таблицы.
- Важное замечание: OCC хорошо работает в сценариях с несколькими параллельными записями, но при крайне высокой степe конфликтности может потребоваться дополнительная координация через блокировки для Serialize Writes, чтобы избежать лавины конфликтов и лишних повторных попыток.
Блокировки и координация изменений
Хотя OCC обеспечивает высокий уровень параллелизма, в реальных системах нередко встречаются сценарии, требующие явной координации записей: когда несколько процессов должны строго последовательно обновлять одну и ту же таблицу или когда организация требует гарантии атомарного выполнения нескольких связанных операций.
В Iceberg существует разумная компромиссная палитра подходов:
- Стандартная схема: OCC как базовый механизм без внешних блокировок, подходящий для большинства ETL-пайплайнов и многопоточными приложениями.
- Расширенная координация через внешний lock-сервис: при необходимости serialized writes в условиях высокой конкуренции или для операций, которые требуют полной атомарности нескольких действий, можно применить внешний механизм блокировок. В качестве примеров часто используются ZooKeeper, Consul, Redis или облачные сервисы блокировок в рамках конкретной облачной инфраструктуры.
- Табличные блокировки как концепт: можно внедрять «TableLock»-образную абстракцию, которая обеспечивает эксклюзивный доступ к таблице на время выполнения критических секций commit-процедур. В сочетании с OCC это позволяет избежать конфликтов при сериальном выполнении нескольких сложных операций, например, объединений таблиц, секционирования или миграций.
Практические рекомендации:
- Оцените требования к пропускной способности и частоту конфликтов в вашем пайплайне. Если конфликты редки, опирайтесь на OCC и автоматические повторные попытки.
- Для критически важных операций, требующих строгой сериализации, рассмотрите внедрение внешнего locking сервиса и аккуратно ограничьте длительность блокировок, чтобы избежать заторов.
- Всегда мониторьте показатели конфликтности и времени ожидания блокировок, чтобы корректировать настройки backoff и параметры повторной попытки.
Если вы используете внешнюю систему блокировок, архитектура будет выглядеть примерно так:
- producer/consumer получает лок на таблицу на время выполнения commit-плана.
- на этапе commit блокировка остается активной, пока новая версия metadata.json не будет опубликована.
- при любом сбое блокировку необходимо корректно освободить, чтобы не блокировать другие процессы.
Применение на практике: интеграции и протоколы
Iceberg активно интегрируется с популярными движками обработки данных: Spark и Flink являются основными исполнителями запросов и трансформаций над Iceberg-таблицами. В этих интеграциях транзакции оформляются через API Iceberg, где операции по чтению таблицы возвращают текущий снимок, а операции записи создают новые снимки и манифесты. В большинстве сценариев developers применяют OCC по умолчанию и полагаются на обработку конфликтов через повторные попытки на уровнях клиента.
Ключевые моменты интеграции:
- Обновление схемы и эволюции данных: Iceberg поддерживает эволюцию схем без потери консистентности. Однако при изменениях, затрагивающих структуру столбцов, необходимо учитывать совместимость версий и корректность реализации commit-процедур.
- Чтение и запись из разных источников: параллельные записи в разных процессах (Spark, Flink) должны согласовать базовую копию снимка перед выполнением изменений. В идеале каждый writer использует OCC и повторно пытается commit при конфликте.
- Мониторинг и аудит: благодаря концепции версионности метаданных и снимков легко строить аудит истории изменений, миграций и откатов.
Интеграции часто используют вспомогательные инструменты и практики:
- Встроенная поддержка транзакций Spark Iceberg обеспечивает совместимость с Spark SQL, DataFrame API и каталожными сервисами, которые позволяют автоматически управлять версиями метаданных.
- В средах Flink Iceberg может обрабатывать потоковые источники и конвейеры изменений, сохраняя консистентность через встроенный протокол commit и проверку снимков.
Для демонстрации концепций можно привести упрощённый сценарий: параллельные записывают данные в одну Iceberg-таблицу; каждый writer читает текущий снимок, формирует свой план изменений, затем пытается commit; при конфликте повторно считывает обновлённый снимок и повторяет попытку. При этом блокировки применяются только в сценариях, где ожидается длительная или критическая секция работы, а в большинстве случаев достаточно OCC без блокировок.
class CommitFailedException(Exception): passdef try_commit(table, base_snapshot_id, changes):
changes: новый набор файлов и манифестов
new_snapshot_id = table.prepare_commit(base_snapshot_id, changes) try: table.commit(base_snapshot_id, new_snapshot_id, changes) return True except ConflictError: # конфликт: требуется повторно прочитать актуальное состояние и повторить raise CommitFailedException("Conflict during commit")
Такой подход наглядно демонстрирует логику: прочитал состояние, подготовил изменения, попытался зафиксировать их на основе того же состояния, которое было прочитано. Если состояние изменилось, конфликт фиксируется и повторная попытка необходима.
В контексте практики нельзя недооценивать роль мониторинга, логирования и ретрансляций. Успешное внедрение OCC и блокировок требует:
- Стратегии backoff и ограничение числа повторных попыток, чтобы избежать лавин от конфликтов;
- Включения трассировки commit-процессов и детальной телеметрии: время ожидания, количество конфликтов, доля успешных commits;
- Обеспечения устойчивости к сбоям: повторные попытки после сбоев сети, обработка временных ошибок хранения.
Рассмотрение инфраструктурных особенностей также важно. В облачных средах часто применяют нативные механизмы локирования на уровне объекта хранилища или сервисов координации. В случаях корпоративной архитектуры выбирают внешние lock-сервисы, которые обеспечивают единый источник истины для блокировок на уровне таблиц.
Принятые практики включают настройку стратегии повторной попытки на уровне клиента, корректное использование параллелизма и учёт межпайплайновых зависимостей при работе с одинаковыми Iceberg-таблицами. Эффективное сочетание OCC и при необходимой координации через внешние блокировки позволяет достичь баланса между пропускной способностью и гарантией консистентности данных.
Практические сценарии внедрения
- Реализация многопоточной загрузки: множество источников данных параллельно пишут в одну Iceberg-таблицу, используя OCC. Конфликты возникают редко и обходятся повторными попытками.
- Инкрементальная загрузка в реальном времени: обработчик потоков фиксирует небольшие изменения и обновляет таблицу, избегая доли длительных транзакций, что минимизирует вероятность конфликтов.
- Эволюция схемы и миграции данных: при изменении структуры таблицы OCC продолжают обеспечивать согласованность совместно со схемными изменениями, но следует планировать совместимость версий и аккуратно управлять миграциями.
Key takeaways
- Iceberg обеспечивает транзакционность на уровне таблицы через снимки, манифесты и версионирование metadata.json, что позволяет читать консистентные снимки независимо от параллельных записей.
- Оптимистичная конкуренция (OCC) — основной механизм в Iceberg: проверка базового состояния на commit и повторная попытка в случае конфликта.
- В сценариях высокой конкуренции можно внедрять внешние блокировки для сериализации критических операций и упрощения управления конфликтами, но это требует грамотной координации и мониторинга.
- Практическая реализация включает интеграцию с Spark и Flink, эффективное управление конфликтами, мониторинг показателей и продуманную стратегию повторных попыток.
- Для успешного внедрения важны архитектурные решения, связанные с обработкой ошибок, аудита изменений и согласованностью между пайплайнами.
- В scenариях миграции схемы и одновременной эволюции данных следует сочетать OCC с планированием изменений и тестированием совместимости.
- Технологическая гибкость Iceberg позволяет адаптировать модель транзакций под требования конкретной инфраструктуры и бизнес-процессов.
FAQ
- Что такое транзакции в Iceberg и чем они отличаются от традиционных баз данных?
- В Iceberg транзакции реализованы через снимки и версии метаданных. Это обеспечивает атомарность и консистентность на уровне всей таблицы, но без блокировок на уровне отдельных строк, как в row-level базах данных. Главная цель — гарантировать, что читатели видят целостный снимок, а писатели — корректно фиксируют изменения в рамках одной версии, даже при параллельных записях.
- Как Iceberg обеспечивает целостность данных при нескольких параллельных записях?
- Через OCC: читательская часть получает базовый снимок, затем запись формирует новый снимок и пытается commit. Если базовый снимок не изменился, commit завершается успешно; иначе — конфликт и повторная попытка после обновления состояния таблицы.
- Когда целесообразно использовать внешние блокировки?
- При крайне высокой конкуренции, когда вероятность конфликта слишком велика или когда бизнес-тотребования требуют сериализации отдельных операций (например, миграции схем или консолидации данных). В этом случае внешний lock-сервис обеспечивает эксклюзивный доступ к таблице на время критических операций.
- Какие типичные ошибки встречаются в процессе commit и как их обойти?
- Наиболее частая ошибка — конфликт при commit. Решение: повторить commit после refresh состояния таблицы и упрощать план изменений, чтобы повысить вероятность успешного commit. Важно настроить разумный backoff и ограничение числа повторных попыток.
- Как архитектура Iceberg влияет на производительность?
- Архитектура на снимках и манифестах позволяет масштабировать чтение и запись независимо. OCC позволяет многим writers работать параллельно, минимизируя блокировки и позволяя эффективно извлекать данные. В то же время конфликты и повторные попытки могут в некоторых сценариях потребовать дополнительных затрат времени.
- Какие инструменты интеграции чаще всего применяются с Iceberg для транзакций?
- Spark и Flink — наиболее часто используемые фреймворки. Они поддерживают стандартные API Iceberg для чтения и записи, включая механизм commit и обработку конфликтов. В дополнение могут использоваться внешние сервисы координации и мониторинга для улучшения надежности.
- Как осуществляется мониторинг транзакций в Iceberg?
- Мониторинг включает отслеживание числа успешных commits, количества конфликтов, времени выполнения commit, задержек между чтением и commit, а также метрик блокировок при использовании внешних lock-сервисов. Этот набор данных позволяет адаптировать backoff, размер батча и уровень параллелизма.
- Может ли эволюция схемы повлиять на транзакции?
- Да. Эволюция схемы может влиять на совместимость и потребовать специальных процедур миграции. Iceberg поддерживает безболезненную эволюцию схемы, но в условиях OCC необходимо аккуратно планировать изменения и тестировать на тестовых данных.
- Какие ограничения у OCC в Iceberg?
- OCC предполагает, что нечастые конфликты оборачиваются в повторные попытки. При частых конфликтах может потребоваться добавление блокировок или переработка пайплайна. Также сложной становится координация между несколькими внешними системами, если применяется глобальная координация файловой системы.
- Как выбрать стратегию для конкретной организации?
- Оцените требования к задержкам, пропускной способности и риску конфликта. Если нужно быстрое внесение изменений в множество источников — задержка на повторные попытки acceptable. Если же требуется строгий порядок и сериализация операций — используйте внешнюю блокировку и тщательно спланированную архитектуру координации.
Эта глава охватывает принципы конкуренции и управления транзакциями в Apache Iceberg с акцентом на архитектурную логику, алгоритмы OCC, подходы к блокировкам и практические аспекты внедрения в современных обработчиках данных. В сочетании с детальным пониманием концепций, описанных здесь, вы сможете проектировать устойчивые конвейеры данных, сохраняющие консистентность и высокую пропускную способность в условиях реальных требований бизнеса.
Современный Data Lake должен поддерживать ACID-транзакции, time travel и эволюцию схем. Посмотрите, как архитектура на базе Apache Iceberg превращает Data Lake в надежный фундамент для аналитики и AI.


